Curso
Introdução à estatística em Python
4 h
197.1K
Se você já explorou nosso tutorial sobre covariância, sabe que ele trata de como duas variáveis variam juntas. A correlação vai um passo além ao padronizar essa medida, permitindo comparar relacionamentos entre diferentes conjuntos de dados.
Neste guia, você vai aprender o que é correlação (com foco na mais comum, a correlação de Pearson), como ela difere da covariância e como calculá-la e interpretá-la usando Python e R. Ao final, também veremos diferentes tipos de correlação para cenários distintos.
Para continuar fortalecendo suas habilidades em estatística, não perca nossa trilha de Fundamentos de estatística em Python ou o curso Introdução à estatística em R.
Correlação mede a força e a direção de uma relação linear entre duas variáveis quantitativas. Ela ajuda você a entender como mudanças em uma variável estão associadas a mudanças em outra.
Correlação positiva significa que, à medida que uma variável aumenta, a outra tende a aumentar também. Correlação negativa significa que, à medida que uma variável aumenta, a outra tende a diminuir.
Vamos aos pontos principais:
Como mencionei, o coeficiente de correlação de Pearson mede a relação linear entre duas variáveis contínuas. O que ainda não disse: ele assume dados normalmente distribuídos (na verdade, mais precisamente, assume distribuição normal conjunta das variáveis, conhecida como normalidade bivariada — há nuances aqui) e é sensível a outliers. O coeficiente de correlação de Pearson é denotado por r.
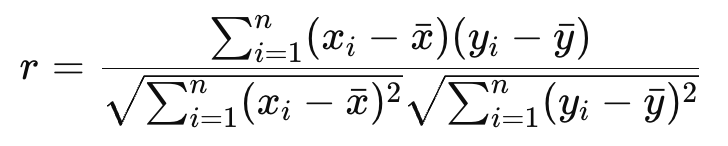
onde xi e yi são pontos de dados, e x e y são suas respectivas médias.
Vamos ver como calcular em Python e R.
Você pode calcular o coeficiente de correlação de Pearson em Python usando a função pearsonr() do módulo scipy.stats:
import numpy as np
from scipy.stats import pearsonr

# Temperature data in Celsius and corresponding Fahrenheit
temperature_celsius = np.array([0, 10, 20, 30, 40])
temperature_fahrenheit = np.array([32, 50, 68, 86, 104])  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient, p_value = pearsonr(temperature_celsius, temperature_fahrenheit)
print("Pearson correlation coefficient:", correlation_coefficient)
Pearson correlation coefficient: 1.0
p-value: 0.0A saída mostra uma relação linear positiva perfeita entre x_values e y_values (já que definimos y como 2x).
Em R, você pode usar a função cor():
temperature_celsius <- c(0, 10, 20, 30, 40)
temperature_fahrenheit <- c(32, 50, 68, 86, 104)  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient <- cor(temperature_celsius, temperature_fahrenheit, method = "pearson")
print(correlation_coefficient)
[1] 1Esse resultado também indica uma relação linear positiva perfeita, como antes.
Uma matriz de correlação exibe os coeficientes de correlação entre vários pares de variáveis em um conjunto de dados. É útil para explorar relacionamentos em dados multivariados.
É comum representar variáveis em formato matricial, como um DataFrame do pandas, e calcular a matriz de correlação diretamente:
import pandas as pd

# Create a DataFrame with two perfectly correlated variables and one that isn't
data = pd.DataFrame({
    'temperature_celsius': [0, 10, 20, 30, 40],
    'temperature_fahrenheit': [32, 50, 68, 86, 104],  # Perfect linear transformation
    'ice_cream_sales': [100, 150, 200, 220, 230]      # Roughly increasing, not perfectly
})

# Calculate the Pearson correlation matrix
correlation_matrix = data.corr(method='pearson')
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.000000 1.000000 0.993858
temperature_fahrenheit 1.000000 1.000000 0.993858
ice_cream_sales 0.993858 0.993858 1.000000Essa saída mostra:
Correlação positiva perfeita entre temperature_celsius e temperature_fahrenheit (como esperado, igual antes).
Correlação forte, mas não perfeita, entre ice_cream_sales e tanto temperature_celsius quanto temperature_fahrenheit.
Em R, você consegue o mesmo com a função cor() que usamos antes, aplicada a um data frame ou matriz:
# Create a data frame with two perfectly correlated variables and one unrelated
data <- data.frame(
  temperature_celsius = c(0, 10, 20, 30, 40),
  temperature_fahrenheit = c(32, 50, 68, 86, 104),  # Perfect conversion from Celsius
  ice_cream_sales = c(100, 150, 200, 220, 230)      # Generally increases, but not perfectly
)

# Calculate the correlation matrix
correlation_matrix <- cor(data, method = "pearson")
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.00 1.00 0.99
temperature_fahrenheit 1.00 1.00 0.99
ice_cream_sales 0.99 0.99 1.00Essa saída em R espelha o exemplo em Python, com:
Correlação positiva perfeita entre temperature_celsius e temperature_fahrenheit.
Correlação forte positiva entre ice_cream_sales e temperature_celsius ou temperature_fahrenheit.
Esse tipo de visualização em matriz é especialmente útil para identificar multicolinearidade em regressão ou escolher variáveis para técnicas de redução de dimensionalidade como PCA.
Vimos que a correlação captura associações lineares. Agora, vale esclarecer bem a diferença para ideias que soam parecidas.
Correlação e covariância medem como duas variáveis variam juntas, mas diferem em dois aspectos: escala e interpretabilidade.
Covariância indica a direção de uma relação linear, mas não sua força de forma padronizada. Seu valor depende das unidades das variáveis, o que dificulta a comparação entre conjuntos de dados.
Correlação padroniza a covariância dividindo pelos desvios padrão das variáveis, produzindo um valor adimensional entre -1 e 1.
R-squared (R²), ou coeficiente de determinação, também pode ser confundido com correlação. Vejo isso principalmente quando analistas tentam interpretar o desempenho de modelos.
Correlação (r de Pearson) mede a força e a direção de uma relação linear entre duas variáveis.
R-squared representa a proporção da variância em uma variável que é previsível a partir de outra em um modelo de regressão linear. Na prática, em regressão linear simples, é o quadrado do r de Pearson.
Não confunda correlação com causalidade! Esse é um erro comum.
Correlação apenas mostra que duas variáveis se movem juntas. Não explica o porquê. Ou seja, é descritiva, não explicativa. Correlação pode ser resultado de coincidência, variáveis de confusão ou causalidade reversa.
Causalidade implica que uma mudança em uma variável causa diretamente uma mudança em outra. Deixe a conversa sobre causalidade para experimentos controlados ou técnicas de inferência causal.
É importante ficar atento aos deslizes mais comuns que analistas podem cometer:
Neste artigo, cobrimos o coeficiente de correlação de Pearson, já que é a versão construída diretamente sobre o conceito de covariância e a mais usada na prática. Mas vamos ver outros tipos.
A correlação de Spearman avalia a força e a direção de uma relação monotônica usando valores ranqueados. É não paramétrica e funciona bem para dados ordinais ou tendências não lineares porém consistentes.
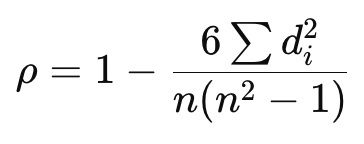
Onde:
O coeficiente tau de Kendall também mede relações monotônicas usando ranks, mas é baseado no número de pares concordantes e discordantes. É mais robusto na presença de empates e amostras pequenas.
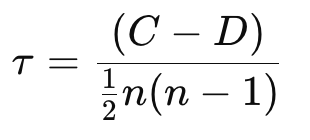
Onde:
Espero que este artigo tenha sido útil. Como você viu, a correlação é uma ferramenta fundamental de análise de dados para entender relacionamentos entre variáveis.
Aproveite nossos cursos para continuar aprendendo. Recomendo a trilha de Fundamentos de estatística em Python ou o curso Introdução à estatística em R como ótimos próximos passos.
Aprenda com a DataCamp
Curso
Curso
Programa
blog
Javier Canales Luna
14 min
blog
Matt Crabtree
10 min
Tutorial
Somil Asthana
11 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Tutorial
Zoumana Keita
12 min