
Khóa học
Phát triển ứng dụng LLM với LangChain
3 giờ
51.9K
Chạy DeepSeek-R1 cục bộ giúp bạn kiểm soát hoàn toàn việc thực thi mô hình mà không phụ thuộc vào máy chủ bên ngoài. Dưới đây là một vài lợi ích khi chạy DeepSeek-R1 cục bộ:
Ollama đơn giản hóa việc chạy LLM cục bộ bằng cách xử lý liền mạch việc tải mô hình, lượng tử hóa và thực thi.
Trước tiên, tải và cài đặt Ollama từ trang web chính thức.
Sau khi tải xuống hoàn tất, hãy cài đặt ứng dụng Ollama như với các ứng dụng khác.
Hãy kiểm tra thiết lập và tải mô hình. Mở terminal và nhập lệnh sau.
ollama run deepseek-r1Ollama cung cấp nhiều phiên bản DeepSeek R1, từ 1.5B tham số đến bản đầy đủ 671B tham số. Mô hình 671B là DeepSeek-R1 gốc, còn các mô hình nhỏ hơn là các phiên bản distilled dựa trên kiến trúc Qwen và Llama. Nếu phần cứng của bạn không hỗ trợ mô hình 671B, bạn có thể dễ dàng chạy phiên bản nhỏ hơn bằng lệnh sau và thay X bên dưới bằng kích thước tham số bạn muốn (1.5b, 7b, 8b, 14b, 32b, 70b, 671b):
ollama run deepseek-r1:XbVới sự linh hoạt này, bạn vẫn có thể khai thác khả năng của DeepSeek-R1 ngay cả khi không có siêu máy tính.
Để chạy DeepSeek-R1 liên tục và phục vụ qua API, hãy khởi động máy chủ Ollama:
ollama serveĐiều này sẽ giúp mô hình sẵn sàng để tích hợp với các ứng dụng khác.
Sau khi mô hình được tải xuống, bạn có thể tương tác trực tiếp với DeepSeek-R1 trong terminal.
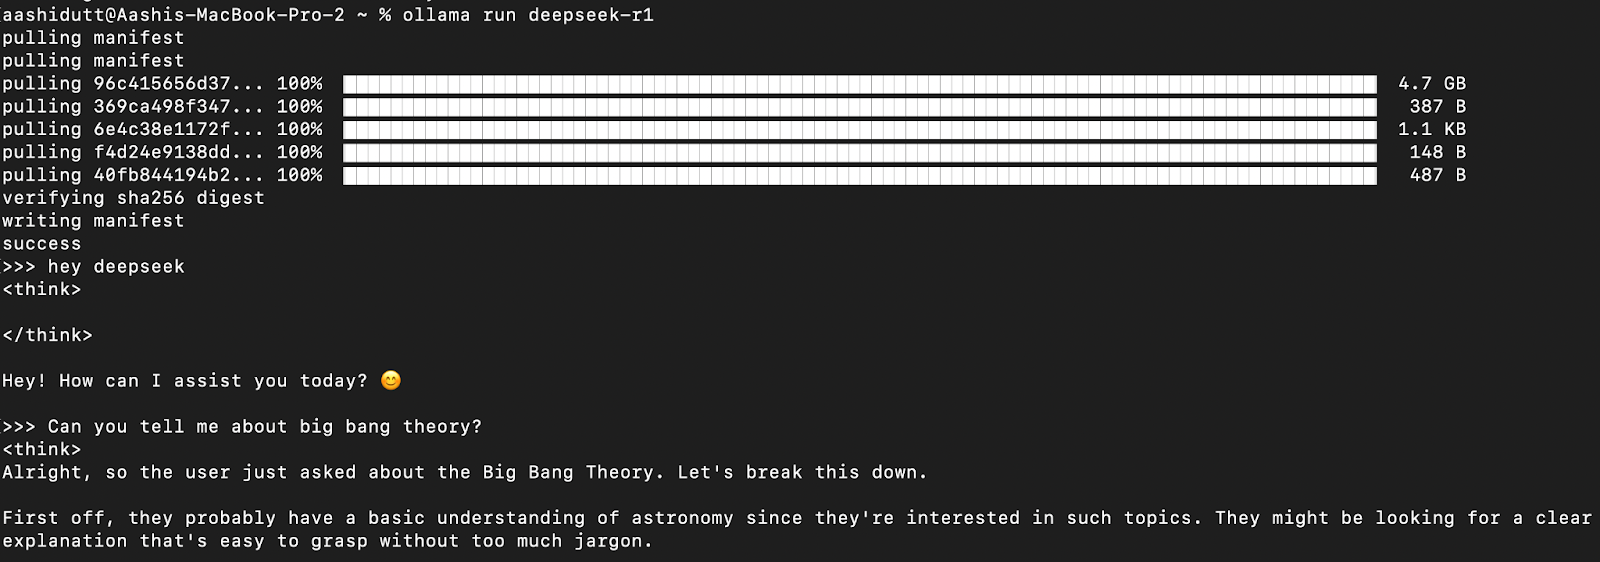
Để tích hợp DeepSeek-R1 vào ứng dụng, sử dụng API của Ollama với curl:
curl http://localhost:11434/api/chat -d '{
  "model": "deepseek-r1",
  "messages": [{ "role": "user", "content": "Solve: 25 * 25" }],
  "stream": false
}'
curl là công cụ dòng lệnh gốc trên Linux nhưng cũng hoạt động trên macOS. Nó cho phép người dùng gửi yêu cầu HTTP trực tiếp từ terminal, rất phù hợp để tương tác với API.
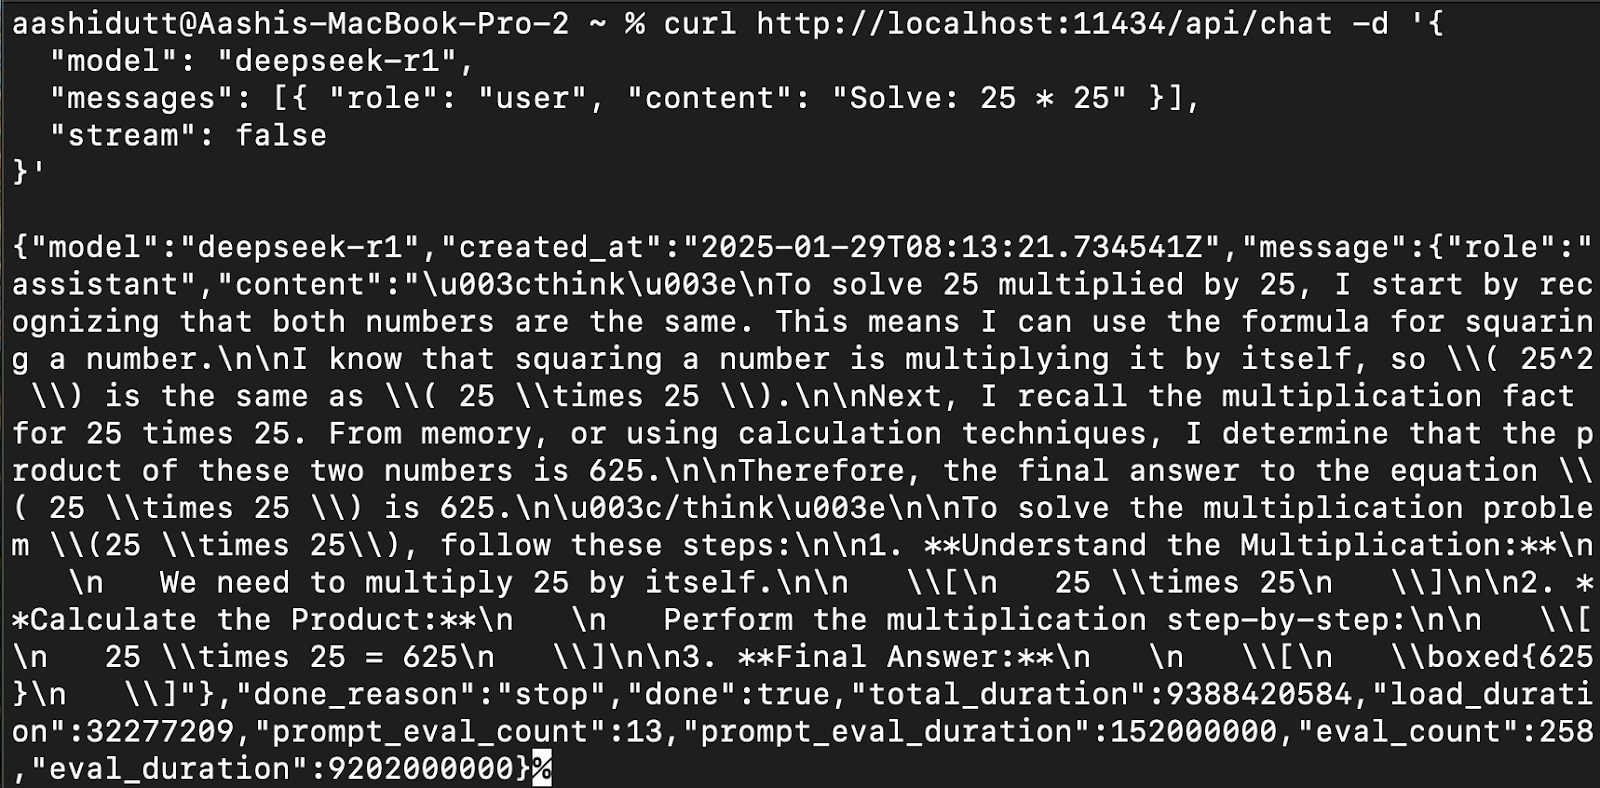
Chúng ta có thể chạy Ollama trong bất kỳ môi trường phát triển tích hợp (IDE) nào bạn chọn. Bạn có thể cài đặt gói Python Ollama bằng lệnh sau:
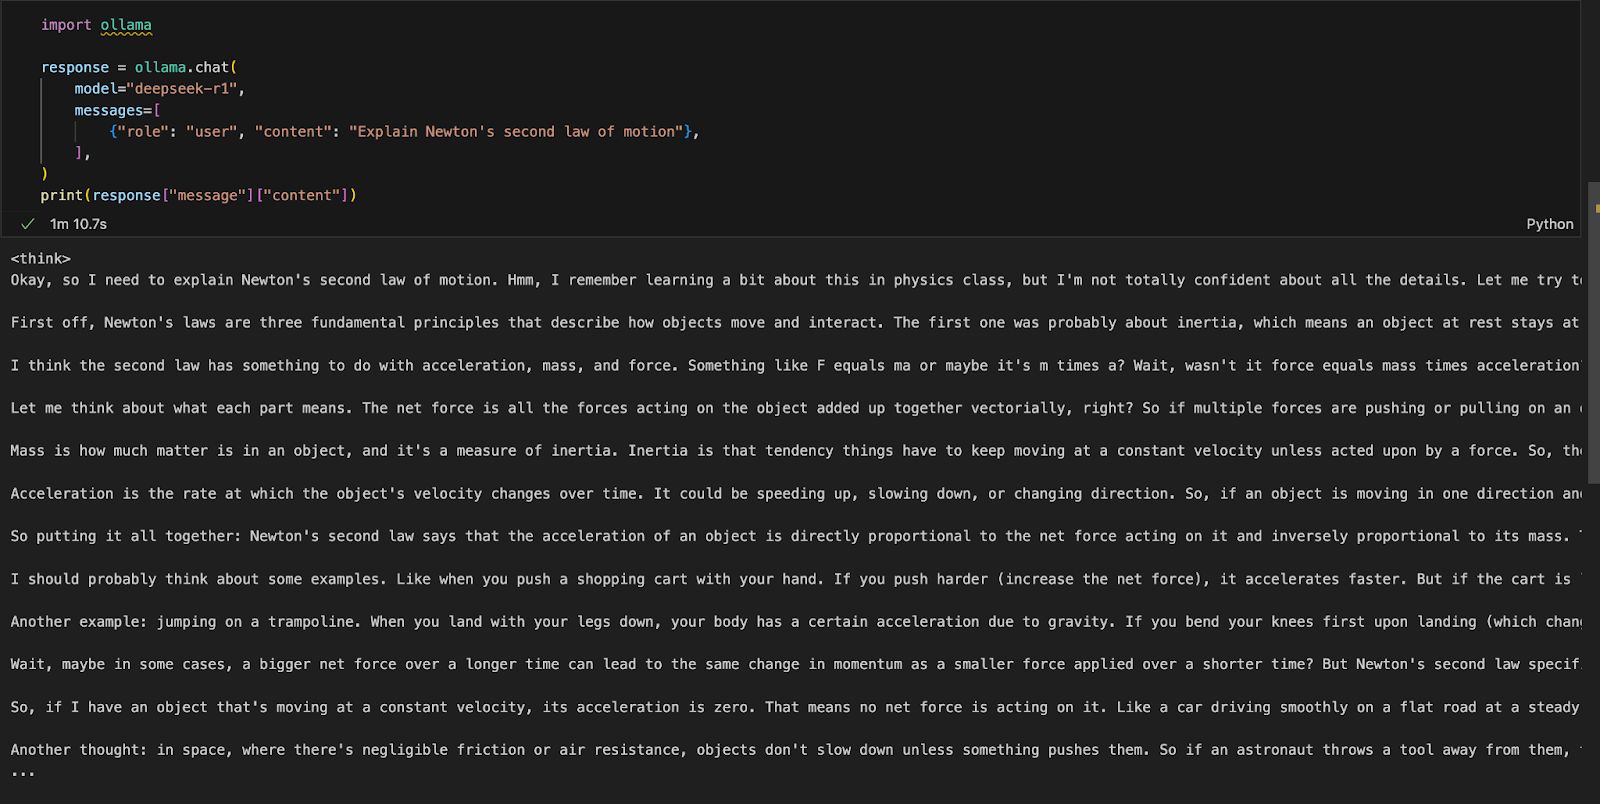
!pip install ollamaSau khi cài đặt Ollama, sử dụng đoạn mã sau để tương tác với mô hình:
import ollama
response = ollama.chat(
    model="deepseek-r1",
    messages=[
        {"role": "user", "content": "Explain Newton's second law of motion"},
    ],
)
print(response["message"]["content"])
Hàm ollama.chat() nhận tên mô hình và một lời nhắc của người dùng, xử lý như một cuộc hội thoại. Script sau đó trích xuất và in phản hồi của mô hình.
Hãy xây dựng một ứng dụng demo đơn giản bằng Gradio để truy vấn và phân tích tài liệu với DeepSeek-R1.
Trước khi bắt đầu triển khai, hãy đảm bảo bạn đã cài các công cụ và thư viện sau:
Chạy các lệnh sau để cài đặt các phụ thuộc cần thiết:
!pip install langchain chromadb gradio
!pip install -U langchain-community
Sau khi cài các phụ thuộc trên, chạy các lệnh import sau:
import gradio as gr
from langchain_community.document_loaders import PyMuPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.vectorstores import Chroma
from langchain_community.embeddings import OllamaEmbeddings
import ollamaSau khi import thư viện, chúng ta sẽ xử lý PDF đã tải lên.
def process_pdf(pdf_bytes):
    if pdf_bytes is None:
        return None, None, None

    loader = PyMuPDFLoader(pdf_bytes)
    data = loader.load()

    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=500, chunk_overlap=100
    )
    chunks = text_splitter.split_documents(data)

    embeddings = OllamaEmbeddings(model="deepseek-r1")
    vectorstore = Chroma.from_documents(
        documents=chunks, embedding=embeddings, persist_directory="./chroma_db"
    )
    retriever = vectorstore.as_retriever()

    return text_splitter, vectorstore, retriever
Hàm process_pdf sẽ:
PyMuPDFLoader.RecursiveCharacterTextSplitter.OllamaEmbeddings.Khi đã truy xuất embedding, bước tiếp theo là ghép chúng lại. Hàm combine_docs() hợp nhất nhiều đoạn tài liệu đã truy xuất thành một chuỗi duy nhất.
def combine_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)
Vì các mô hình dựa trên truy xuất kéo ra những đoạn liên quan thay vì toàn bộ tài liệu, hàm này đảm bảo nội dung được trích xuất vẫn dễ đọc và đúng định dạng trước khi gửi vào DeepSeek-R1.
Giờ thì đầu vào cho mô hình đã sẵn sàng. Hãy thiết lập DeepSeek R1 bằng Ollama.
import re

def ollama_llm(question, context):
    formatted_prompt = f"Question: {question}\n\nContext: {context}"

    response = ollama.chat(
        model="deepseek-r1",
        messages=[{"role": "user", "content": formatted_prompt}],
    )

    response_content = response["message"]["content"]

    # Remove content between <think> and </think> tags to remove thinking output
    final_answer = re.sub(r"<think>.*?</think>", "", response_content, flags=re.DOTALL).strip()

    return final_answer
Hàm ollama_llm() định dạng câu hỏi của người dùng và ngữ cảnh tài liệu đã truy xuất thành một prompt có cấu trúc. Đầu vào đã định dạng này được gửi tới DeepSeek-R1 qua ollama.chat(), mô hình sẽ xử lý câu hỏi trong ngữ cảnh đã cho và trả về câu trả lời phù hợp. Nếu bạn cần câu trả lời không kèm phần “suy nghĩ” của mô hình, hãy dùng hàm strip() để trả về kết quả cuối.
Giờ chúng ta đã có đủ các thành phần cần thiết, hãy xây dựng pipeline RAG cho bản demo.
def rag_chain(question, text_splitter, vectorstore, retriever):
    retrieved_docs = retriever.invoke(question)
    formatted_content = combine_docs(retrieved_docs)
    return ollama_llm(question, formatted_content)
Hàm trên đầu tiên tìm kiếm trong kho vector bằng retriever.invoke(question), trả về các đoạn tài liệu liên quan nhất. Những đoạn này được định dạng thành đầu vào có cấu trúc bằng hàm combine_docs và gửi tới ollama_llm, giúp DeepSeek-R1 tạo ra câu trả lời chính xác dựa trên nội dung đã truy xuất.
Chúng ta đã có pipeline RAG. Bây giờ, ta sẽ xây dựng giao diện Gradio cục bộ cùng với mô hình DeepSeek-R1 để xử lý PDF đầu vào và đặt câu hỏi liên quan.
def ask_question(pdf_bytes, question):
    text_splitter, vectorstore, retriever = process_pdf(pdf_bytes)

    if text_splitter is None:
        return None  # No PDF uploaded

    result = rag_chain(question, text_splitter, vectorstore, retriever)
    return {result}


interface = gr.Interface(
    fn=ask_question,
    inputs=[
        gr.File(label="Upload PDF (optional)"),
        gr.Textbox(label="Ask a question"),
    ],
    outputs="text",
    title="Ask questions about your PDF",
    description="Use DeepSeek-R1 to answer your questions about the uploaded PDF document.",
)

interface.launch()
Chúng ta thực hiện các bước sau:
process_pdf để trích xuất văn bản và tạo embedding tài liệu.rag_chain() để truy xuất thông tin liên quan và tạo phản hồi chính xác theo ngữ cảnh.gr.Interface(), nhận tệp PDF và truy vấn văn bản làm đầu vào.interface.launch() để kích hoạt tính năng Hỏi & Đáp dựa trên tài liệu một cách mượt mà qua trình duyệt web.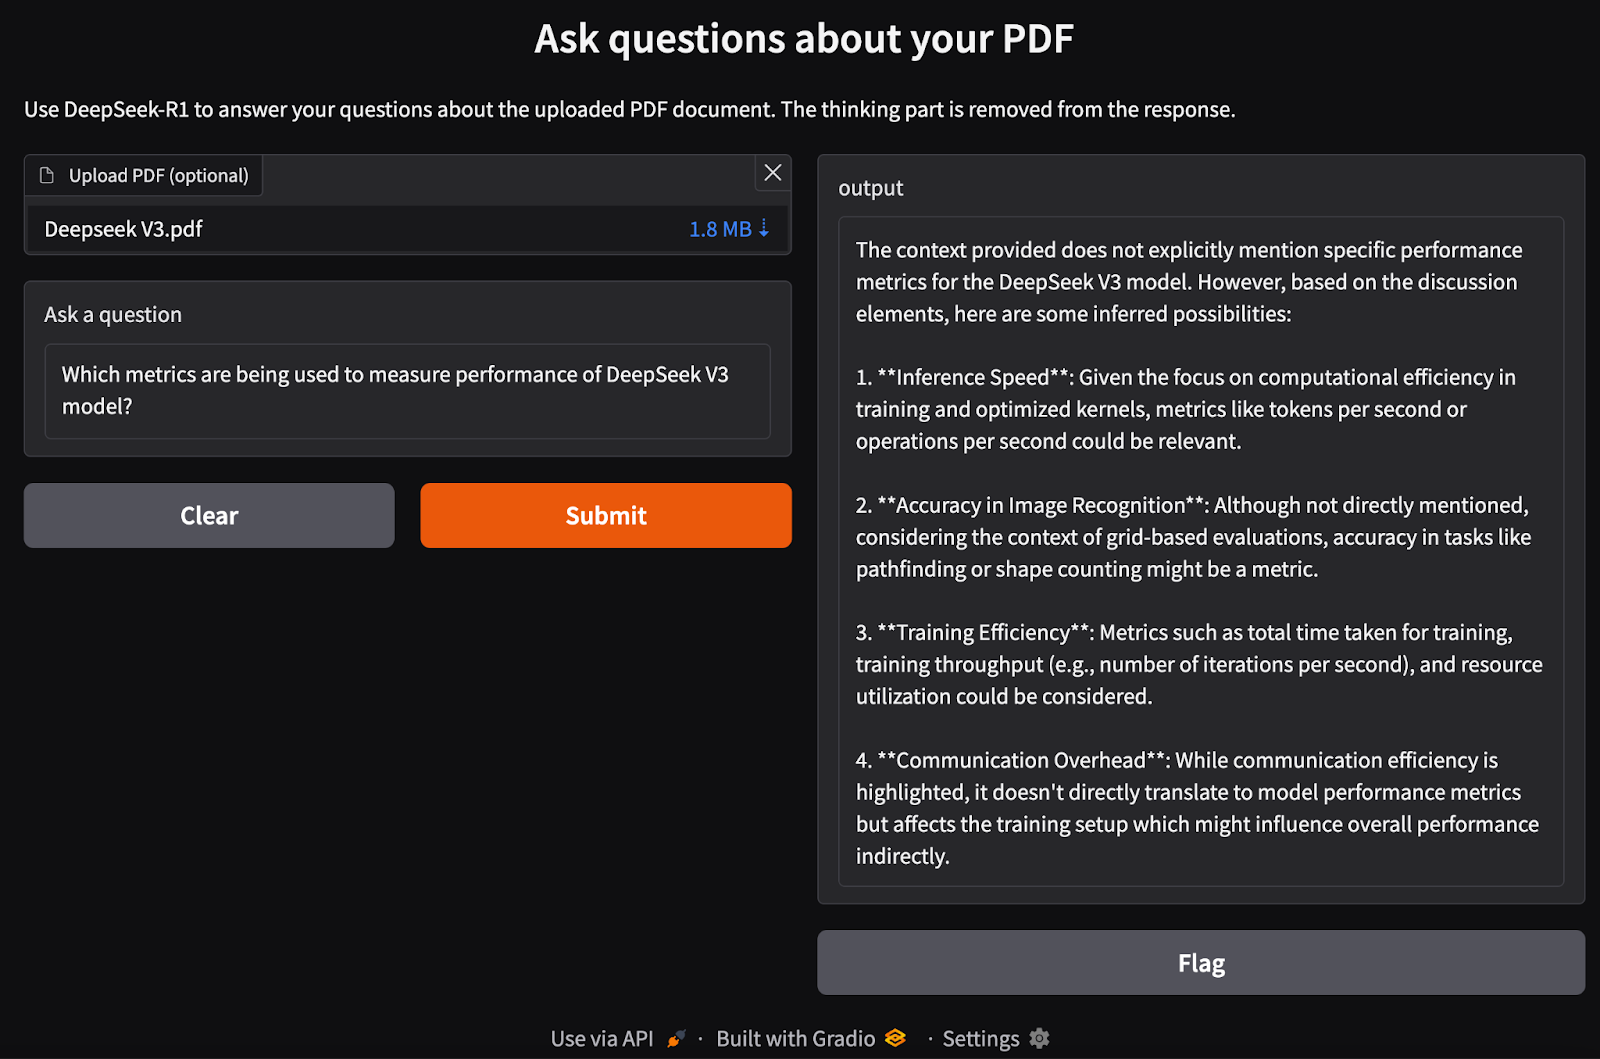
Chạy DeepSeek-R1 cục bộ với Ollama cho phép suy luận nhanh hơn, riêng tư và tiết kiệm chi phí. Với quy trình cài đặt đơn giản, tương tác qua CLI, hỗ trợ API và tích hợp Python, bạn có thể dùng DeepSeek-R1 cho nhiều ứng dụng AI, từ truy vấn chung đến các tác vụ dựa trên truy xuất phức tạp.
Để cập nhật những phát triển mới nhất trong AI, tôi gợi ý các blog sau:
Học AI với các khóa học này!
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
