

Traseu de învățare
Inginer AI asociat pentru dezvoltatori
26 ore
Practică și urmărește-ți progresul.
Continuă Cu GoogleMoonshot AI a lansat Kimi K3.1 Pro în octombrie 2026 cu o afirmație neobișnuit de specifică: pe Terminal-Bench 4.0, noul său model cu greutăți deschise se află la un punct de Claude Opus 5.5, flagship-ul lansat de Anthropic pe 22 septembrie. O face la jumătate din prețul per token al Anthropic, iar Moonshot promite greutăți descărcabile până pe 4 noiembrie.
În acest articol, voi compara Kimi K3.1 Pro și Claude Opus 5.5 la programare agentică, raționare, sarcini de agenți cu multe unelte, controale de siguranță și cât te costă efectiv să le rulezi.
Dacă te interesează noile lansări de modele, citește și ghidurile noastre despre flagship-urile recente de la Google, Gemini 4 Carbon și Genie 4. Pentru a rămâne la curent cu cele mai noi știri din AI, îți recomand și abonarea la newsletterul nostru săptămânal, The Median.
Kimi K3.1 Pro este modelul de vârf al Moonshot AI, lansat în octombrie 2026 ca versiune post-instruită a lui Kimi K3, cu greutăți deschise promise până pe 4 noiembrie.
Punctul său forte este învățarea prin întărire la scară: Moonshot a rulat RL comun pe sute de domenii din aval, ceea ce se vede mai ales la programare pe orizont lung, cercetare financiară și creație 3D.
Ghidul nostru Kimi K3.1 Pro acoperă lansarea în detaliu.
Claude Opus 5.5 este flagship-ul închis al Anthropic și primul model din familia Claude 5.5, lansat pe 22 septembrie 2026.
Anthropic îl poziționează ca având performanță la nivelul Claude Fable 5.1 pe majoritatea sarcinilor, la un preț mai mic decât Opus 5, cu cele mai bune scoruri măsurate pe auditul său automatizat de aliniere.
Ghidul nostru Claude Opus 5.5 acoperă lansarea; tutorialul API Opus 5.5 îți arată pas cu pas cum să construiești un investigator de incidente AI.
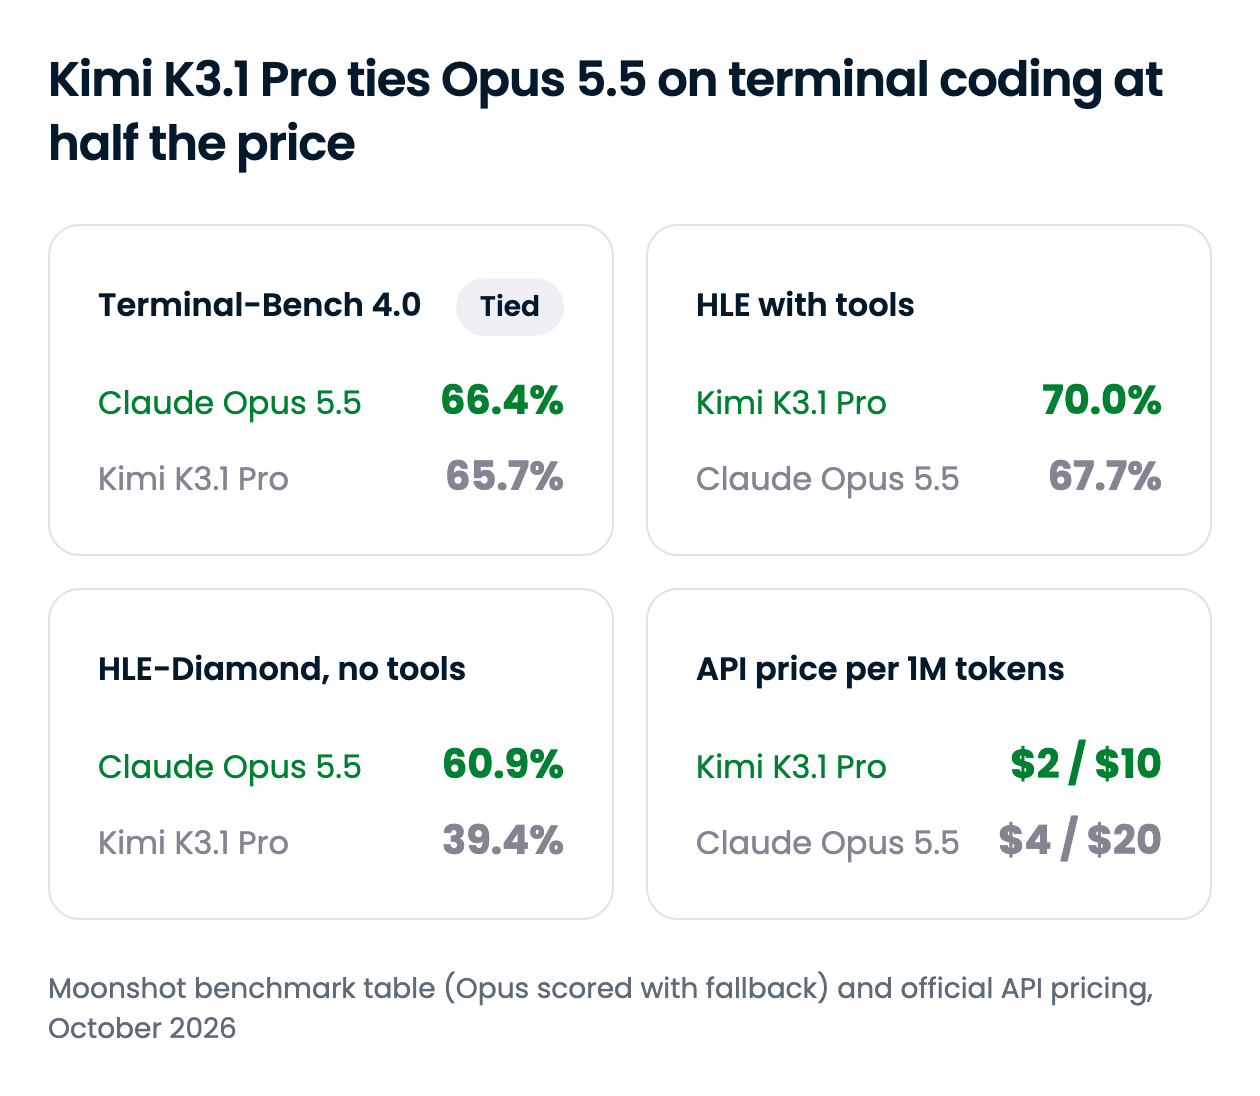
Kimi K3.1 Pro câștigă la preț și la munca de agenți care se bazează pe unelte; Opus 5.5 câștigă de fiecare dată când modelul trebuie să raționeze fără ajutor sau să rezolve o problemă sub-specificată. Rezumatul de mai jos acoperă fiecare dimensiune, iar secțiunile următoare detaliază acolo unde diferența schimbă decizia.
| Caracteristică | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Dezvoltator | Moonshot AI | Anthropic |
| Lansare | Octombrie 2026 | 22 septembrie 2026 |
| Greutăți | Greutăți deschise până pe 4 noiembrie 2026 (licență neanunțată) | Închise |
| Fereastră de context | 1M tokeni | 1M tokeni |
| Ieșire maximă | Până la 1.048.576 tokeni (131.072 implicit) | 128K tokeni (300K pe Batch API, beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Programare pe orizont lung (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Raționare fără resurse (HLE-Diamond) | 39,4% | 60,9% |
| Raționare asistată de unelte (HLE cu unelte) | 70,0% | 67,7% |
| Cyber ofensiv (ExploitBench) | 74,7 | 91,0 |
| Preț API | Jumătate din Opus 5.5 la input și output | Referință |
| Unde îl poți rula | API Kimi, aplicații Kimi, OpenRouter | API Claude, aplicații Claude, AWS, Google Cloud, Azure, agenți de codare majori |
O precizare se aplică fiecărui scor din această secțiune. Valorile head-to-head provin din tabelul de benchmark al Moonshot, care marchează fiecare rezultat Opus 5.5 „cu fallback”: măsurile de siguranță ale Anthropic trimit anumite sarcini de tip cyber și biologie către alte modele Claude (Opus 4.8 și Opus 5, respectiv), ceea ce probabil trage scorurile în jos.
Cele două modele sunt practic la același nivel pe Terminal-Bench 4.0, iar titlul ascunde o împărțire reală dedesubt. Kimi K3.1 Pro conduce liniile de orizont lung, în timp ce Opus 5.5 conduce, la mare distanță, oriunde sarcina este deschisă.
Cea mai mare diferență este ProgramBench, care cere modelului să reconstruiască un program din binarul și specificația sa. Opus 5.5 duce 65,0% dintre sarcini la cel puțin 95% teste trecute, în timp ce Kimi K3.1 Pro reușește 31,5%, mai puțin de jumătate.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Note |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi rulat în harness-ul Claude Code; Opus la efort xhigh conform Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Sarcini de inginerie de mai multe ore |
| DeepSWE v1.1 | 75,5% | 74,2% | Setup propriu fiecărui laborator, deci tratează ca egalitate |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | 58,5% | Benchmark intern Moonshot |
| ProgramBench (scor binar) | 31,5% | 65,0% | Ponderea sarcinilor cu scor de cel puțin 95% |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | Tabelul Anthropic raportează 58,7% pentru Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi rulat pe GPU-uri H20 în loc de H100 |
| BenchCAD cu unelte | 92,7% | 96,2% | Reconstrucție 3D prin cod CAD |
Tiparul e consecvent. Dă-i lui Kimi K3.1 Pro o sarcină de inginerie bine definită și mult timp și va continua: demonstrația Moonshot l-a arătat corectând 36 de erori în calculele mușchilor umărului într-un simulator de mers uman pe parcursul a 167 de misiuni. Povestea echivalentă a Anthropic este o traducere din C în Rust a HAProxy care a trecut aproape toate testele de regresie ale HAProxy.
Unde specificația e subțire, Opus se desprinde. ProgramBench, fluxurile de cercetare științifică și experimentele post-instruire cer toate să stabilești ce este de fapt sarcina, iar acolo rezistența pe termen lung a lui Kimi nu mai plătește.
Pentru agenți de codare lungi și bine specificați, Kimi K3.1 Pro este o alternativă reală; pentru reverse engineering, cod de cercetare și tichete vagi, Opus 5.5 e alegerea mai sigură.
Fără unelte, Opus 5.5 conduce clar. Cea mai mare diferență este HLE-Diamond, subsetul de 1.000 de întrebări cel mai dificil din Humanity's Last Exam, unde Opus obține 60,9% față de 39,4% pentru Kimi.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Note |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2.500 întrebări, fără unelte |
| HLE-Diamond | 39,4% | 60,9% | Cele mai dificile 1.000 întrebări |
| GPQA-Diamond | 94,2% | 93,9% | Aproape saturat; egalitate |
| MMMU-Pro | 84,1% | 87,7% | Întrebări cu imagini și text |
| Kimi Hallu Bench (mai mic e mai bun) | 5,4% | 6,8% | Intern Moonshot; rată de halucinație la nivel de afirmație |
Se egalează la GPQA-Diamond, care e prea aproape de plafon pentru a mai separa pe cineva. Rata mai mică de halucinație a lui Kimi vine din testul de stres propriu Moonshot, așa că aș trata-o mai degrabă ca pe un semn că munca pe acuratețe factuală a dat roade decât ca pe un verdict direct. Pentru raționare fără resurse, Opus 5.5 este modelul mai puternic.
Dă-le ambelor modele unelte și rezultatul la raționare se inversează. Pe Humanity's Last Exam cu unelte, Kimi K3.1 Pro obține 70,0% față de 67,7% pentru Opus, și conduce majoritatea liniilor Moonshot pe cercetare și documente.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Note |
|---|---|---|---|
| HLE-Full cu unelte | 70,0% | 67,7% | Aceleasi întrebări, unelte permise |
| BrowseComp | 92,1% | 90,8% | Informații web greu de găsit |
| OfficeQA Pro v2 | 64,4 | 62,2 | Analiză numerică pe PDF-uri financiare |
| Frontier Finance | 58,6 | 56,7 | Fluxuri de investiții, de la screening la profitabilitate |
| AutomationBench-AA | 73,3 | 69,5 | Versiunea Artificial Analysis, nu a Zapier |
| OSWorld V2.1 | 79,6% | 81,8% | Operarea unui computer desktop |
| APEX-Agents | 67,2 | 73,5 | Clasament Mercor |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Victoriile lui Kimi sunt mici, dar consecvente pe căutare și documente financiare. Opus păstrează avantajul la utilizarea computerului și pe clasamentele de agenți terți, astfel că Kimi K3.1 Pro este un agent de cercetare mai bun, iar Opus 5.5 un agent de desktop și birou mai bun.
Ambele modele citesc același context ca dimensiune și ambele „gândesc” mereu: nici Moonshot, nici Anthropic nu îți permit să oprești raționarea. Implicitele diferă, însă. Kimi K3.1 Pro rulează la efort max dacă nu setezi low sau high, în timp ce Opus 5.5 are implicit medium, deci un apel Kimi netunat consumă mai multă raționare per cerere.
Plafonul de ieșire este diferența practică mai mare. Kimi K3.1 Pro poate returna într-un singur apel cât o fereastră completă de context, aproximativ de opt ori plafonul lui Opus 5.5 în afara Batch API. Constructorii de agenți care migrează la Opus ar trebui să știe și că utilizarea forțată a uneltelor returnează acum o eroare 400.
Ambele laboratoare limitează capabilitatea de cyber ofensiv, dar în moduri opuse. Moonshot a eliminat datele legate de cyber din antrenamentul intermediar și RL pentru lansarea cu greutăți deschise, ceea ce a coborât benchmark-ul intern de exploatare de la 90,5% la 81,0%. Anthropic păstrează capabilitatea în Opus 5.5 și redirecționează majoritatea cererilor de securitate cibernetică către Opus 4.8 la timpul de servire.
Pe ExploitBench, Opus obține 91,0 față de 74,7 pentru Kimi, iar Moonshot spune clar că K3.1 Pro rămâne în urmă față de modelele proprietare de vârf la cyber, prin design. Compromisul este controlul: odată ce apar greutățile, poți rula Kimi pe propria infrastructură, lucru pe care Opus nu îl oferă.
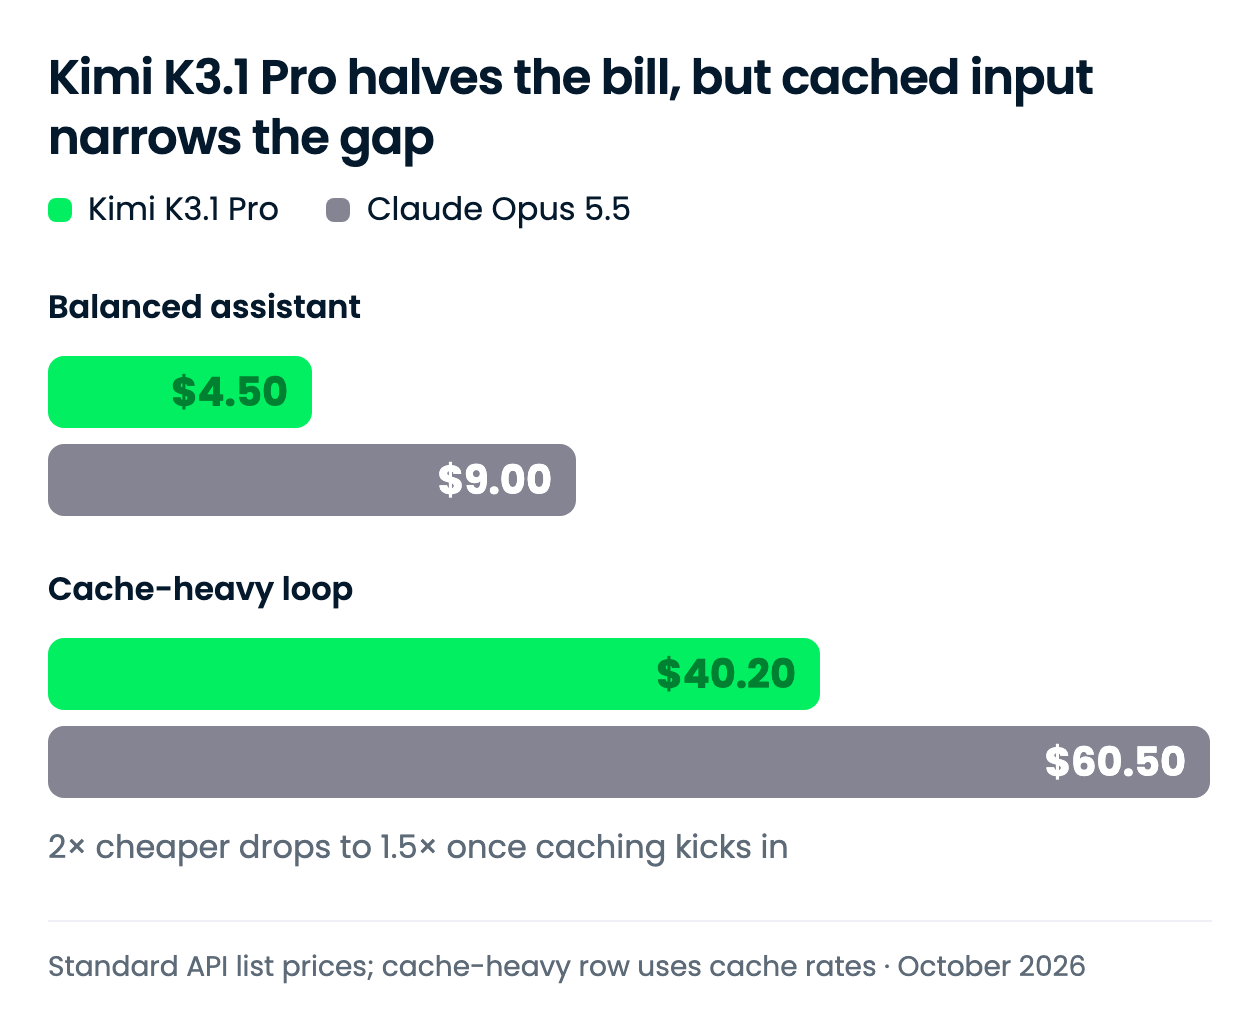
Kimi K3.1 Pro costă jumătate din Opus 5.5 pe tokeni proaspeți. Economia scade când un volum de lucru rulează pe context din cache, pentru că ambii furnizori taxează la fel pentru citirea din cache.
Toate tarifele sunt per 1M tokeni, din paginile oficiale de preț ale Moonshot și Anthropic.
| Tarif | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M tokeni | $2,00 | $4,00 |
| Output, per 1M tokeni | $10,00 | $20,00 |
| Citire input din cache, per 1M tokeni | $0,20 | $0,20 |
| Scriere în cache, TTL 5 minute | $2,00 | $5,00 |
| Scriere în cache, TTL 1 oră | $4,00 | $8,00 |
| Variantă mai rapidă | K3.1 Pro Highspeed, viteză 2–3x: $4,00 / $20,00 | Mod Fast, până la 2,5x viteză: $8,00 / $40,00 |
Multiplicatorul nu e uniform: 0,5x la input, output și scrieri în cache cu TTL 1 oră, 0,4x la scrieri în cache cu TTL 5 minute și 1,0x la citiri din cache. Niciun furnizor nu adaugă suprataxă pentru context lung.
Două particularități ies din tabel. Varianta Highspeed a lui Kimi costă exact cât Opus standard. Batch API al Anthropic înjumătățește tarifele Opus la $2 și $10, egalând tariful standard al lui Kimi, în timp ce pagina de preț a Moonshot nu listează discount pentru batch.
Am ales două forme lunare de lucru: un asistent echilibrat ca ancoră de scală și o buclă de agent intensă în cache, pentru că la prețurile cache-ului listele celor doi diferă.
| Volum de lucru | Kimi K3.1 Pro | Claude Opus 5.5 | Diferență |
|---|---|---|---|
| Asistent echilibrat: 1M in / 250K out | $4,50 | $9,00 | $4,50 (Kimi cu 50% mai ieftin) |
| Buclă intensă în cache: prefix de 100K scris o dată, 1.000 citiri din cache, plus 5K in proaspăt / 1K out per cerere | $40,20 | $60,50 | $20,30 (Kimi cu 34% mai ieftin) |
Fiecare total este (volum ÷ 1M) × tarif, însumat pe liniile de input, output și cache; rândul intens în cache folosește scrierea în cache cu TTL 5 minute. Rândul echilibrat reflectă pur și simplu diferența de 2x a tarifelor.
Rândul intens în cache este cel după care să te planifici. Cei 100M tokeni din cache costă $20 pe oricare model, deci doar tokenii proaspeți și scrierea în cache poartă discountul lui Kimi, iar economia scade la aproximativ o treime. Anthropic spune că citirile din cache compun majoritatea costurilor la programarea agentică, așa că agenții de lungă durată vor ajunge mai aproape de acest rând decât de primul.
Cele două modele folosesc tokenizatoare diferite, iar niciun furnizor nu a publicat conturi de tokeni pentru un volum comun, așa că tratează aceste totaluri ca o comparație de tarife, nu ca o factură.
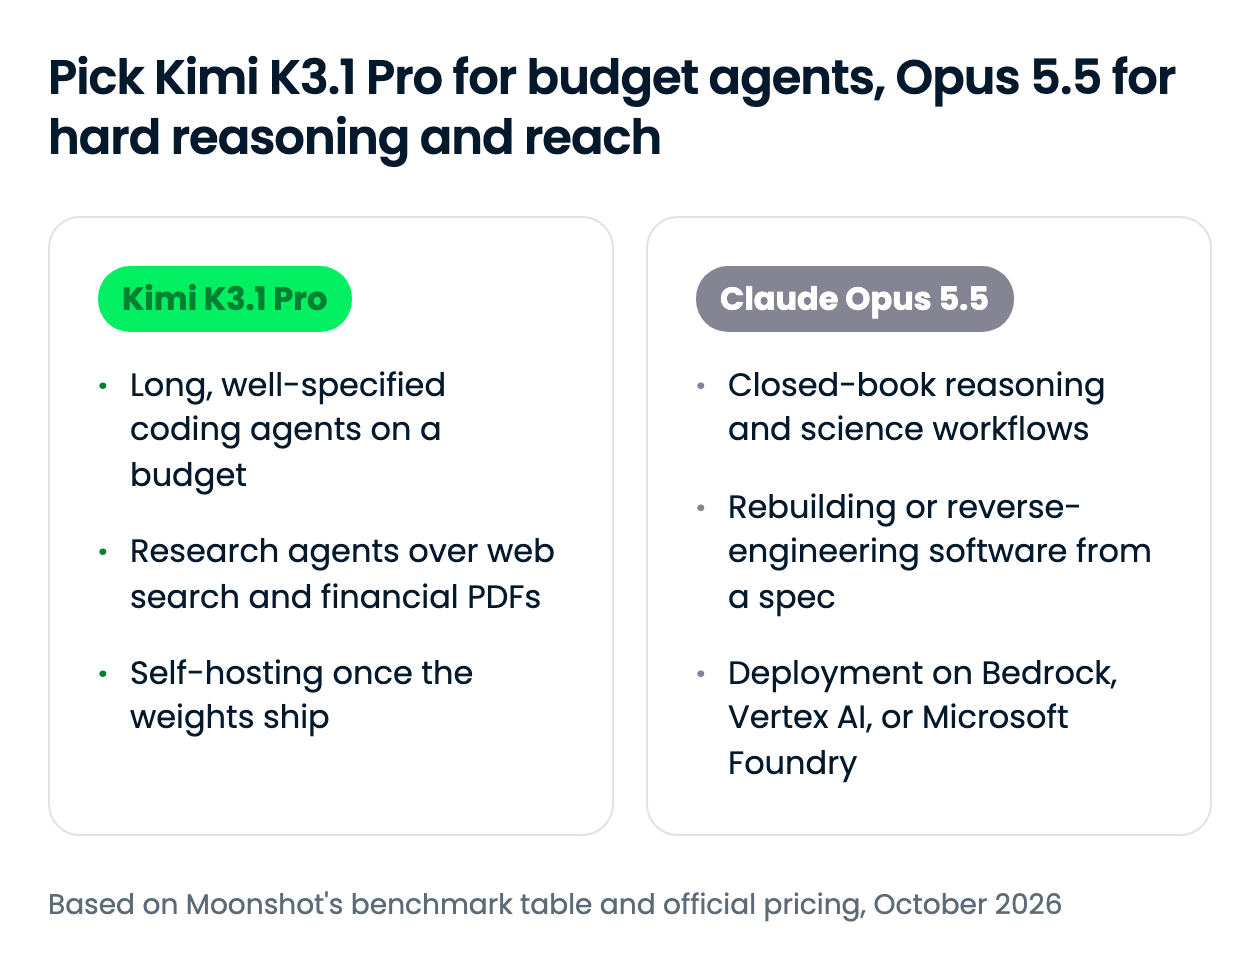
Răscrucea este prețul versus acoperirea: Kimi K3.1 Pro înjumătățește tariful per token, iar Opus 5.5 acoperă cazurile de raționare unde Kimi rămâne în urmă și platformele cloud unde Kimi nu este confirmat. Dacă agentul tău rulează mai ales pe context din cache, economia e mai aproape de o treime decât de jumătate.
Poți apela ambele modele astăzi prin API-urile lor sau prin OpenRouter, iar Opus 5.5 rulează și pe Amazon Bedrock, Vertex AI și Microsoft Foundry.
| Interfață | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Aplicație pentru consumatori | Kimi.com, aplicații mobile Kimi, aplicație desktop Kimi Work | Aplicații Claude (Pro, Max, Team, Enterprise) |
| API propriu | API Kimi (compatibil OpenAI) | API Claude |
| Platforme cloud | Încă indisponibil pe Azure AI Foundry sau Amazon Bedrock la 29 oct 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Agenți de codare | Kimi Code (încă indisponibil în GitHub Copilot și Cursor la 29 oct 2026) | Claude Code, Cursor, GitHub Copilot |
| Routere terțe | OpenRouter | OpenRouter |
| Greutăți deschise | Așteptate până pe 4 noiembrie 2026 | Nu |
| ID model API | kimi-k3.1-pro |
claude-opus-5-5 |
Diferența de acoperire este decisivă pentru multe echipe: Opus 5.5 este pe toate marile cloud-uri și în agenții de codare mainstream, în timp ce Kimi K3.1 Pro este confirmat doar pe platformele Moonshot și OpenRouter până apar greutățile. Pe API-urile proprii, ID-urile de model sunt kimi-k3.1-pro și claude-opus-5-5; pe OpenRouter sunt moonshotai/kimi-k3.1-pro și anthropic/claude-opus-5.5.
Endpoint-ul OpenAI-compatibil al OpenRouter face din cele două modele un schimb de șir, cea mai ușoară cale de a le testa A/B pe propriile tale prompturi.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Tutorialul API Opus 5.5 intră mai adânc în zona Claude, iar explicația noastră despre OpenCode arată cum să conectezi oricare dintre modele la un agent de codare open-source.
Kimi K3.1 Pro egalează Claude Opus 5.5 la programare în terminal și îl depășește pe rulări lungi de agenți cu multe unelte, la un discount semnificativ. Dacă agenții tăi rulează sarcini lungi, bine definite, cu unelte, folosește Kimi; dacă raționează fără ajutor, urmăresc specificații vagi sau trebuie să trăiască pe AWS, Google Cloud sau Azure, folosește Opus.
Ce mi se pare cel mai interesant este cât de diferit gestionează cele două laboratoare același risc: Moonshot taie capabilitățile de cyber din greutăți înainte să le publice, iar Anthropic le păstrează în model și le controlează la servire. Aș testa Kimi prin OpenRouter și aș reevalua self-hosting-ul odată ce apar greutățile și licența în noiembrie.
Dacă ești dornic să construiești cu astfel de modele, îți recomand să arunci o privire la traseul nostru Associate AI Engineer for Developers.
Învăță AI cu DataCamp!
Traseu de învățare
Curs
Practică și urmărește-ți progresul.
Continuă Cu Google