

Lộ trình
Kỹ sư Trợ lý Trí tuệ Nhân tạo (AI) cho Lập trình viên
26 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleMoonshot AI phát hành Kimi K3.1 Pro vào tháng 10/2026 với một tuyên bố hiếm khi cụ thể: trên Terminal-Bench 4.0, mẫu mở trọng số mới của họ chỉ kém Claude Opus 5.5 của Anthropic (ra mắt ngày 22/9) khoảng một điểm. Mẫu này đạt được điều đó với mức giá mỗi token chỉ bằng một nửa của Anthropic, và Moonshot hứa sẽ công bố trọng số để tải về trước ngày 4/11.
Trong bài viết này, tôi sẽ so sánh Kimi K3.1 Pro và Claude Opus 5.5 về lập trình hướng tác tử, lập luận, công việc tác tử nặng công cụ, kiểm soát an toàn và chi phí vận hành thực tế của mỗi mẫu.
Nếu bạn quan tâm đến các bản phát hành mẫu mới, hãy đọc thêm các hướng dẫn của chúng tôi về các mẫu đầu bảng mới nhất của Google, Gemini 4 Carbon và Genie 4. To keep up to date with the latest AI news, I also recommend subscribing to our weekly newsletter, The Median.
Kimi K3.1 Pro là mẫu đầu bảng của Moonshot AI, phát hành tháng 10/2026 như một phiên bản hậu huấn luyện của Kimi K3 với trọng số mở hứa hẹn trước ngày 4/11.
Điểm bán chính là học tăng cường ở quy mô lớn: Moonshot chạy RL kết hợp trên hàng trăm miền hạ nguồn, thể hiện rõ nhất ở lập trình đường dài, nghiên cứu tài chính và dựng hình 3D.
Hướng dẫn Kimi K3.1 Pro của chúng tôi bao quát đầy đủ buổi ra mắt.
Claude Opus 5.5 là mẫu đầu bảng đóng của Anthropic và là mẫu đầu tiên trong dòng Claude 5.5, phát hành ngày 22/9/2026.
Anthropic giới thiệu nó đạt hiệu năng mức Claude Fable 5.1 trên hầu hết công việc với giá thấp hơn Opus 5, cùng các điểm số tốt nhất họ đo được trên kiểm định căn chỉnh tự động.
Hướng dẫn Claude Opus 5.5 của chúng tôi trình bày buổi ra mắt; hướng dẫn API Opus 5.5 đi qua quy trình xây dựng một tác nhân điều tra sự cố AI.
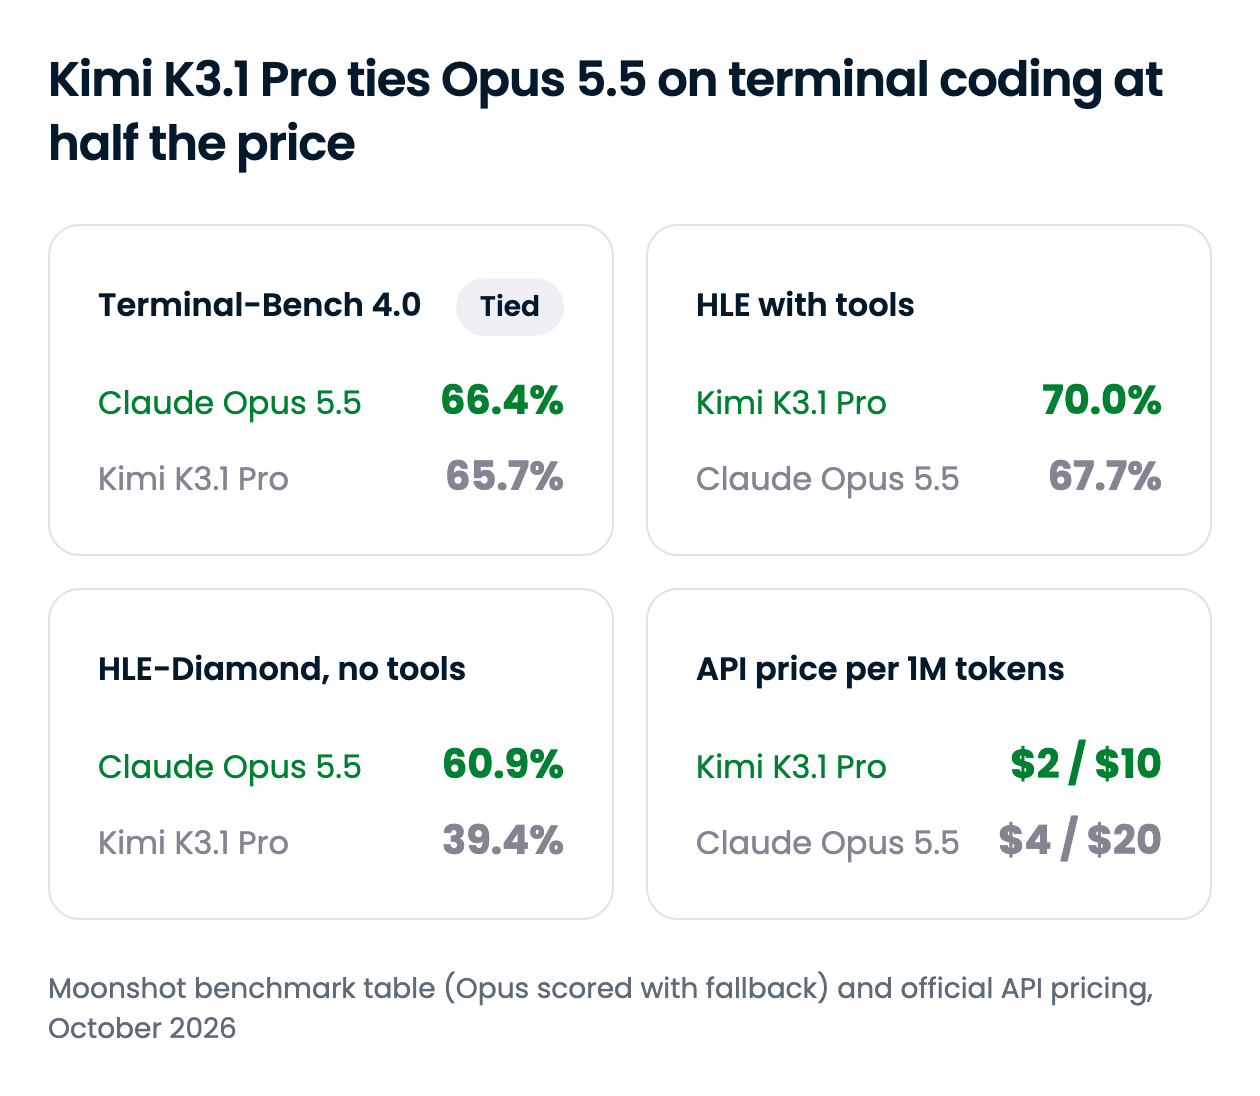
Kimi K3.1 Pro thắng về giá và ở các công việc tác tử dựa nhiều vào công cụ; Opus 5.5 thắng bất cứ khi nào mẫu phải tự lập luận không hỗ trợ hoặc giải quyết bài toán thiếu đặc tả. Tóm tắt dưới đây bao phủ mọi khía cạnh, và các phần sau đi sâu vào những điểm mà khoảng cách có thể thay đổi quyết định.
| Tính năng | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Nhà phát triển | Moonshot AI | Anthropic |
| Ngày phát hành | Tháng 10/2026 | 22/9/2026 |
| Trọng số | Trọng số mở dự kiến trước 4/11/2026 (chưa công bố giấy phép) | Đóng |
| Cửa sổ ngữ cảnh | 1M token | 1M token |
| Đầu ra tối đa | Tối đa 1.048.576 token (mặc định 131.072) | 128K token (300K trên Batch API, beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Lập trình đường dài (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Lập luận đóng (HLE-Diamond) | 39,4% | 60,9% |
| Lập luận có công cụ hỗ trợ (HLE with tools) | 70,0% | 67,7% |
| Tấn công mạng (ExploitBench) | 74,7 | 91,0 |
| Giá API | Bằng một nửa Opus 5.5 ở đầu vào và đầu ra | Mức cơ bản |
| Nền tảng chạy | Kimi API, ứng dụng Kimi, OpenRouter | Claude API, ứng dụng Claude, AWS, Google Cloud, Azure, các tác tử lập trình chính |
Một lưu ý áp dụng cho mọi điểm số trong phần này. Các con số đối đầu đến từ bảng điểm chuẩn của chính Moonshot, trong đó đánh dấu mỗi kết quả Opus 5.5 là "với dự phòng": cơ chế bảo vệ của Anthropic chuyển một số tác vụ an ninh mạng và sinh học sang các mẫu Claude khác (Opus 4.8 và Opus 5), điều này có thể kéo điểm xuống.
Hai mẫu gần như ngang nhau trên Terminal-Bench 4.0, nhưng tiêu đề đó che giấu một sự phân hóa thực sự. Kimi K3.1 Pro dẫn ở các hàng đường dài, trong khi Opus 5.5 dẫn, với biên rộng, ở nơi nhiệm vụ mở.
Khoảng cách lớn nhất là ProgramBench, yêu cầu mẫu tái dựng chương trình từ tệp nhị phân và đặc tả. Opus 5.5 đưa 65,0% tác vụ đạt ít nhất 95% bài kiểm thử, trong khi Kimi K3.1 Pro đạt 31,5%, chưa bằng một nửa.
| Điểm chuẩn | Kimi K3.1 Pro | Claude Opus 5.5 | Ghi chú |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi chạy trong bộ khung Claude Code; Opus ở mức nỗ lực xhigh theo Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Nhiệm vụ kỹ thuật nhiều giờ |
| DeepSWE v1.1 | 75,5% | 74,2% | Mỗi phòng lab có thiết lập riêng, nên coi như hòa |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | 58,5% | Điểm chuẩn nội bộ Moonshot |
| ProgramBench (điểm nhị phân) | 31,5% | 65,0% | Tỷ lệ tác vụ đạt ít nhất 95% |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | Bảng riêng của Anthropic báo 58,7% cho Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi chạy trên GPU H20 thay vì H100 |
| BenchCAD với công cụ | 92,7% | 96,2% | Tái dựng 3D qua mã CAD |
Mẫu hình nhất quán. Giao cho Kimi K3.1 Pro một nhiệm vụ kỹ thuật được đặc tả rõ và nhiều thời gian, nó sẽ bền bỉ: màn trình diễn của Moonshot cho thấy mẫu này sửa 36 lỗi trong tính toán cơ vai của mô phỏng người đi bộ qua 167 nhiệm vụ. Câu chuyện tương đương của Anthropic là dịch C sang Rust cho HAProxy và vượt qua gần như toàn bộ bộ kiểm thử hồi quy của chính HAProxy.
Khi đặc tả mỏng, Opus vượt lên. ProgramBench, quy trình nghiên cứu khoa học và các thử nghiệm hậu huấn luyện đều đòi hỏi phải tự xác định bài toán là gì, và đó là nơi sức bền đường dài của Kimi không còn trả công.
Với các tác tử lập trình dài, đặc tả tốt, Kimi K3.1 Pro là lựa chọn thay thế thực sự; với đảo ngược kỹ thuật, mã nghiên cứu và ticket mơ hồ, Opus 5.5 an toàn hơn.
Loại bỏ công cụ và Opus 5.5 dẫn rõ ràng. Khoảng cách lớn nhất là HLE-Diamond, 1.000 câu hỏi khó nhất của Humanity's Last Exam, nơi Opus đạt 60,9% còn Kimi đạt 39,4%.
| Điểm chuẩn | Kimi K3.1 Pro | Claude Opus 5.5 | Ghi chú |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2.500 câu hỏi, không công cụ |
| HLE-Diamond | 39,4% | 60,9% | 1.000 câu khó nhất |
| GPQA-Diamond | 94,2% | 93,9% | Gần chạm trần; coi như hòa |
| MMMU-Pro | 84,1% | 87,7% | Câu hỏi hình ảnh và văn bản |
| Kimi Hallu Bench (thấp hơn là tốt hơn) | 5,4% | 6,8% | Nội bộ Moonshot; tỷ lệ ảo tưởng ở mức mệnh đề |
Hai mẫu hòa ở GPQA-Diamond, bộ gần đạt trần nên khó phân định. Tỷ lệ ảo tưởng thấp hơn của Kimi đến từ stress test của Moonshot, nên nên xem như dấu hiệu công việc độ chính xác thực tế đạt kết quả hơn là phán quyết đối đầu. Với lập luận đóng, Opus 5.5 là mẫu mạnh hơn.
Trao công cụ cho cả hai thì kết quả lập luận đảo chiều. Trên Humanity's Last Exam có công cụ, Kimi K3.1 Pro đạt 70,0% so với 67,7% của Opus, và dẫn ở hầu hết các hàng nghiên cứu và tài liệu của Moonshot.
| Điểm chuẩn | Kimi K3.1 Pro | Claude Opus 5.5 | Ghi chú |
|---|---|---|---|
| HLE-Full có công cụ | 70,0% | 67,7% | Cùng câu hỏi, cho phép công cụ |
| BrowseComp | 92,1% | 90,8% | Thông tin web khó tìm |
| OfficeQA Pro v2 | 64,4 | 62,2 | Phân tích số liệu trên các PDF tài chính |
| Frontier Finance | 58,6 | 56,7 | Quy trình đầu tư, từ sàng lọc đến lợi nhuận |
| AutomationBench-AA | 73,3 | 69,5 | Bản Artificial Analysis, không phải của Zapier |
| OSWorld V2.1 | 79,6% | 81,8% | Vận hành máy tính để bàn |
| APEX-Agents | 67,2 | 73,5 | Bảng xếp hạng Mercor |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Các chiến thắng của Kimi nhỏ nhưng nhất quán ở tìm kiếm và tài liệu tài chính. Opus giữ lợi thế ở sử dụng máy tính và trên các bảng xếp hạng tác tử bên thứ ba, vì vậy Kimi K3.1 Pro là tác tử nghiên cứu tốt hơn và Opus 5.5 là tác tử máy tính để bàn và văn phòng tổng quát tốt hơn.
Cả hai mẫu đọc ngữ cảnh cùng kích thước, và cả hai luôn suy nghĩ: cả Moonshot lẫn Anthropic đều không cho tắt lập luận. Tuy nhiên mặc định khác nhau. Kimi K3.1 Pro chạy ở mức max trừ khi bạn đặt low hoặc high, trong khi Opus 5.5 mặc định medium, nên một cuộc gọi Kimi chưa điều chỉnh sẽ tiêu tốn suy luận nhiều hơn mỗi yêu cầu.
Trần đầu ra là khoảng cách thực tế lớn hơn. Kimi K3.1 Pro có thể trả về lượng đầu ra bằng toàn bộ cửa sổ ngữ cảnh trong một lần gọi, xấp xỉ gấp tám lần trần của Opus 5.5 ngoài Batch API. Các nhà xây dựng tác tử chuyển sang Opus cũng nên biết rằng ép buộc dùng công cụ giờ sẽ trả lỗi 400.
Cả hai phòng lab đều tiết chế năng lực tấn công mạng, theo hai cách trái ngược. Moonshot loại bỏ dữ liệu liên quan an ninh mạng khỏi giai đoạn giữa của huấn luyện và RL cho bản phát hành trọng số mở, khiến điểm thử nghiệm khai thác nội bộ giảm từ 90,5% xuống 81,0%. Anthropic giữ năng lực đó trong Opus 5.5 và chuyển hướng hầu hết yêu cầu an ninh mạng sang Opus 4.8 ở thời điểm phục vụ.
Trên ExploitBench, Opus đạt 91,0 so với 74,7 của Kimi, và Moonshot nói thẳng rằng K3.1 Pro cố tình đứng sau các mẫu độc quyền tuyến đầu về an ninh mạng. Đổi lại là quyền kiểm soát: khi trọng số được phát hành, bạn có thể chạy Kimi trên hạ tầng riêng của mình, điều mà Opus không cung cấp.
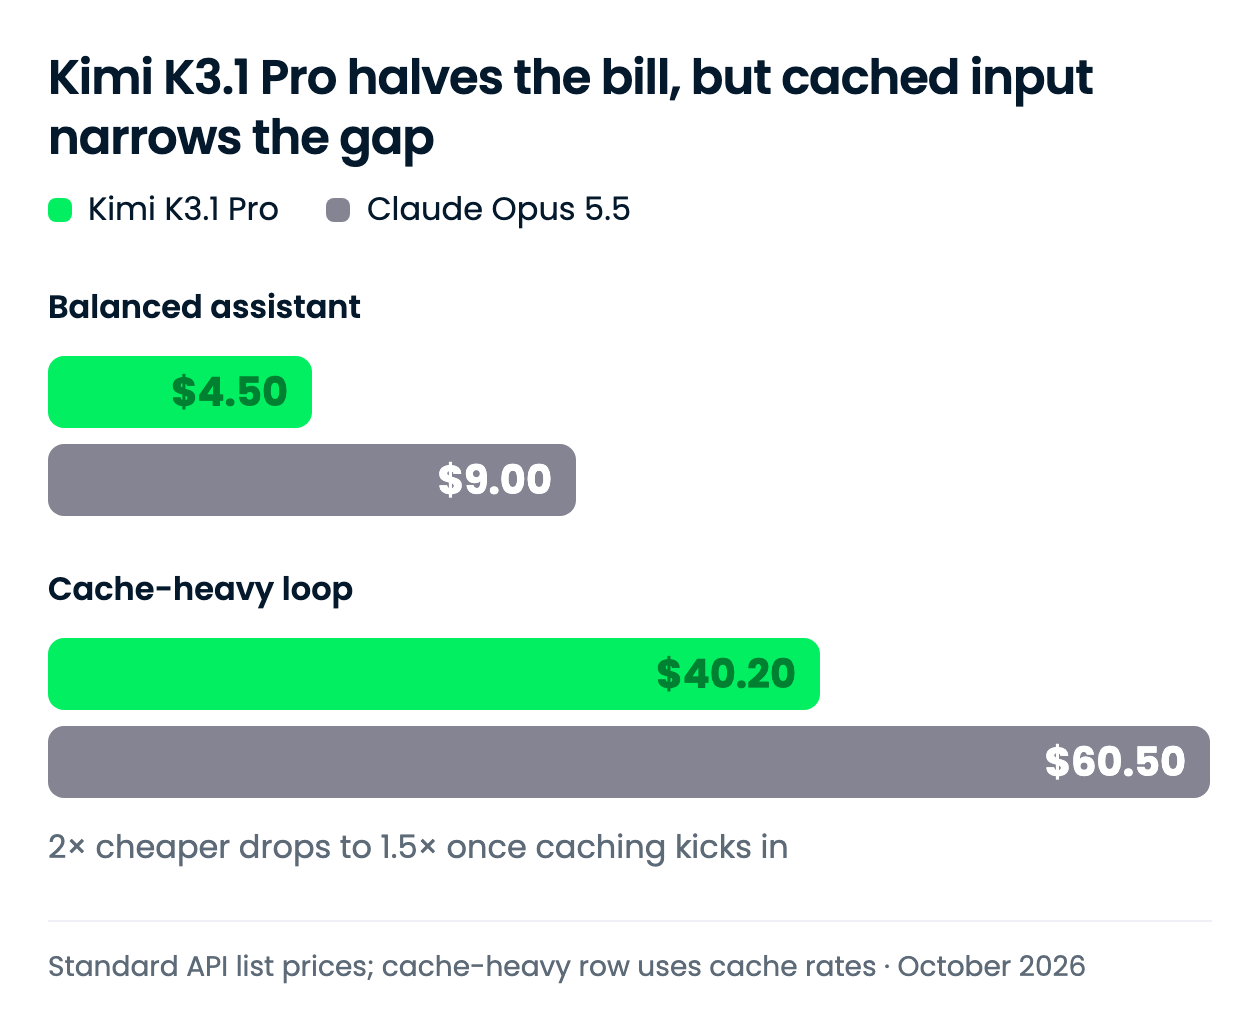
Kimi K3.1 Pro rẻ bằng một nửa Opus 5.5 trên token mới. Mức tiết kiệm thu hẹp khi khối lượng công việc chạy trên ngữ cảnh đã được đệm, vì cả hai nhà cung cấp đều tính phí đọc bộ nhớ đệm như nhau.
Tất cả mức giá tính trên mỗi 1M token, theo trang giá chính thức của Moonshot và Anthropic.
| Mức giá | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Đầu vào, mỗi 1M token | $2,00 | $4,00 |
| Đầu ra, mỗi 1M token | $10,00 | $20,00 |
| Đọc đầu vào đã đệm, mỗi 1M token | $0,20 | $0,20 |
| Ghi bộ đệm, TTL 5 phút | $2,00 | $5,00 |
| Ghi bộ đệm, TTL 1 giờ | $4,00 | $8,00 |
| Biến thể nhanh hơn | K3.1 Pro Highspeed, nhanh hơn 2–3x: $4,00 / $20,00 | Chế độ Fast, tới 2,5x: $8,00 / $40,00 |
Tỉ lệ không đồng nhất: 0,5x ở đầu vào, đầu ra và ghi bộ đệm 1 giờ; 0,4x ở ghi bộ đệm 5 phút; và 1,0x ở đọc bộ đệm. Không nhà cung cấp nào cộng phụ phí ngữ cảnh dài.
Có hai điểm đáng chú ý từ bảng. Biến thể Highspeed của Kimi có giá đúng bằng Opus tiêu chuẩn. Batch API của Anthropic giảm nửa chi phí Opus còn $2 và $10, khớp mức chuẩn của Kimi, trong khi trang giá của Moonshot không liệt kê ưu đãi batch.
Tôi chọn hai dạng khối lượng công việc hàng tháng: một trợ lý cân bằng làm mốc neo, và một vòng lặp tác tử nặng bộ đệm, vì giá bộ đệm là nơi hai biểu giá khác nhau.
| Khối lượng | Kimi K3.1 Pro | Claude Opus 5.5 | Chênh lệch |
|---|---|---|---|
| Trợ lý cân bằng: 1M vào / 250K ra | $4,50 | $9,00 | $4,50 (Kimi rẻ hơn 50%) |
| Vòng lặp nặng bộ đệm: tiền tố 100K ghi một lần, 1.000 lần đọc đệm, cộng 5K vào mới / 1K ra mỗi yêu cầu | $40,20 | $60,50 | $20,30 (Kimi rẻ hơn 34%) |
Mỗi tổng là (khối lượng ÷ 1M) × mức giá, cộng qua các dòng đầu vào, đầu ra và bộ đệm; hàng nặng bộ đệm dùng ghi bộ đệm 5 phút. Hàng cân bằng đơn giản là khoảng cách tỉ lệ 2x.
Hàng nặng bộ đệm là điều cần lên kế hoạch. 100M token đã đệm tốn $20 trên cả hai mẫu, nên chỉ token mới và ghi bộ đệm mới hưởng mức giảm của Kimi, và khoản tiết kiệm giảm còn khoảng một phần ba. Anthropic cho biết đọc bộ đệm chiếm đa số chi phí lập trình hướng tác tử, nên các tác tử chạy dài sẽ gần với hàng này hơn hàng đầu.
Hai mẫu dùng bộ tách token khác nhau, và không nhà cung cấp nào công bố số đếm token cho cùng một khối lượng công việc, nên coi các tổng này là so sánh mức giá chứ không phải hóa đơn.
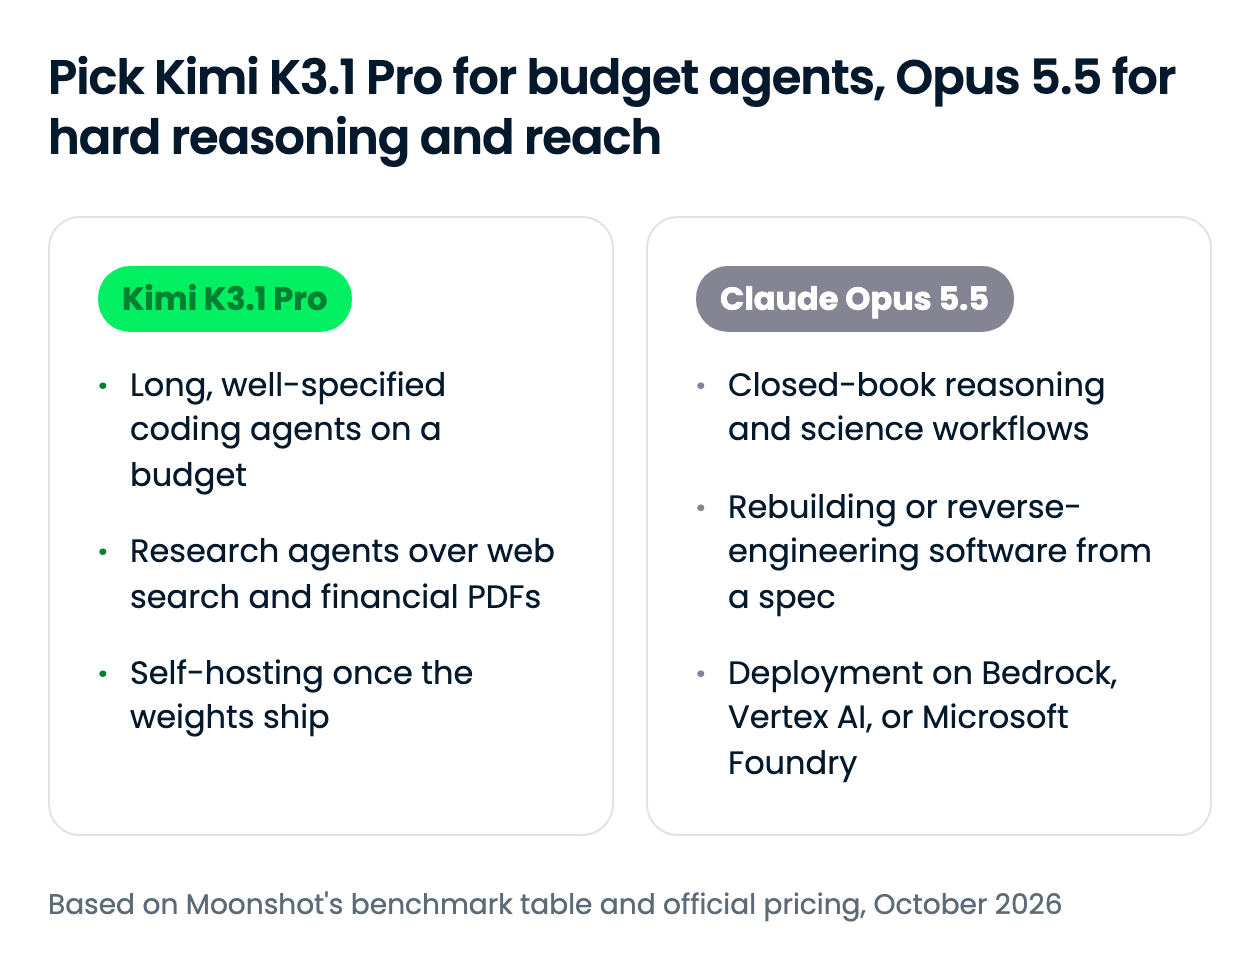
Sự lựa chọn là giá so với độ bao phủ: Kimi K3.1 Pro giảm một nửa mức giá mỗi token, còn Opus 5.5 bao trọn các trường hợp lập luận mà Kimi hụt hơi và các nền tảng đám mây Kimi chưa có. Nếu tác tử của bạn chủ yếu chạy trên ngữ cảnh đã đệm, khoản tiết kiệm gần một phần ba hơn là một nửa.
Bạn có thể gọi cả hai mẫu ngay hôm nay qua API riêng hoặc qua OpenRouter, và Opus 5.5 cũng chạy trên Amazon Bedrock, Vertex AI và Microsoft Foundry.
| Bề mặt | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Ứng dụng người dùng | Kimi.com, ứng dụng di động Kimi, ứng dụng desktop Kimi Work | Ứng dụng Claude (Pro, Max, Team, Enterprise) |
| API chính chủ | Kimi API (tương thích OpenAI) | Claude API |
| Nền tảng đám mây | Chưa có trên Azure AI Foundry hoặc Amazon Bedrock tính đến 29/10/2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Tác tử lập trình | Kimi Code (chưa có trên GitHub Copilot và Cursor tính đến 29/10/2026) | Claude Code, Cursor, GitHub Copilot |
| Bộ định tuyến bên thứ ba | OpenRouter | OpenRouter |
| Trọng số mở | Dự kiến trước 4/11/2026 | Không |
| ID mẫu API | kimi-k3.1-pro |
claude-opus-5-5 |
Khoảng cách về độ phủ là yếu tố quyết định với nhiều đội: Opus 5.5 có mặt trên mọi đám mây lớn và trong các tác tử lập trình phổ biến, trong khi Kimi K3.1 Pro mới chỉ xác nhận trên các bề mặt của Moonshot và OpenRouter cho đến khi có trọng số. Trên API chính chủ, ID mẫu là kimi-k3.1-pro và claude-opus-5-5; trên OpenRouter là moonshotai/kimi-k3.1-pro và anthropic/claude-opus-5.5.
Điểm cuối tương thích OpenAI của OpenRouter khiến hai mẫu chỉ khác nhau một chuỗi, là cách dễ nhất để A/B trên chính prompt của bạn.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Hướng dẫn API Opus 5.5 của chúng tôi đi sâu hơn ở phía Claude, và bài giải thích về OpenCode cho thấy cách cắm bất kỳ mẫu nào vào một tác tử lập trình mã nguồn mở.
Kimi K3.1 Pro ngang ngửa Claude Opus 5.5 ở lập trình terminal và vượt trội ở các phiên tác tử dài, nặng công cụ, với mức giá chiết khấu đáng kể. Nếu tác tử của bạn chạy các nhiệm vụ dài, đặc tả rõ và có công cụ, hãy dùng Kimi; nếu chúng phải tự lập luận, theo đuổi đặc tả mơ hồ hoặc cần sống trên AWS, Google Cloud hay Azure, hãy dùng Opus.
Điều tôi thấy thú vị nhất là cách hai phòng lab xử lý cùng một rủi ro theo hướng rất khác: Moonshot cắt năng lực an ninh mạng khỏi trọng số trước khi công bố, còn Anthropic giữ trong mẫu và chặn ở tầng phục vụ. Tôi sẽ thử Kimi qua OpenRouter và cân nhắc tự lưu trữ khi trọng số và giấy phép được công bố vào tháng 11.
Nếu bạn muốn xây dựng với các mẫu như thế này, tôi khuyến nghị xem lộ trình Associate AI Engineer for Developers của chúng tôi.
Học AI cùng DataCamp!
Lộ trình
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
