Programa
Associate AI Engineer para desarrolladores
26 h
Practica y programa tu progreso.
Continuar Con GoogleMoonshot AI lanzó Kimi K3.1 Pro en octubre de 2026 con una afirmación inusualmente concreta: en Terminal-Bench 4.0, su nuevo modelo de pesos abiertos queda a un punto de Claude Opus 5.5, el buque insignia que Anthropic publicó el 22 de septiembre. Lo hace a mitad de precio por token que Anthropic, y Moonshot promete publicar los pesos descargables antes del 4 de noviembre.
En este artículo, compararé Kimi K3.1 Pro y Claude Opus 5.5 en programación con agentes, razonamiento, trabajo de agentes con muchas herramientas, controles de seguridad y el coste real de ejecución.
Si te interesan los nuevos lanzamientos de modelos, no te pierdas también nuestras guías sobre los últimos buques insignia de Google, Gemini 4 Carbon y Genie 4. Para estar al día de las últimas noticias de IA, te recomiendo suscribirte a nuestra newsletter semanal, The Median.
Kimi K3.1 Pro es el modelo insignia de Moonshot AI, lanzado en octubre de 2026 como una versión post-entrenada de Kimi K3 con pesos abiertos prometidos para el 4 de noviembre.
Su baza es el aprendizaje por refuerzo a gran escala: Moonshot ejecutó RL conjunto en cientos de dominios, que se nota sobre todo en programación de largo recorrido, investigación financiera y creación 3D.
Nuestra guía de Kimi K3.1 Pro cubre el lanzamiento al detalle.
Claude Opus 5.5 es el modelo cerrado insignia de Anthropic y el primero de la familia Claude 5.5, publicado el 22 de septiembre de 2026.
Anthropic lo presenta como rendimiento del nivel Claude Fable 5.1 en la mayoría de tareas a un precio inferior a Opus 5, con sus mejores puntuaciones en su auditoría de alineamiento automatizada.
Nuestra guía de Claude Opus 5.5 repasa el lanzamiento; nuestro tutorial del API de Opus 5.5 te guía para construir un investigador de incidentes de IA.
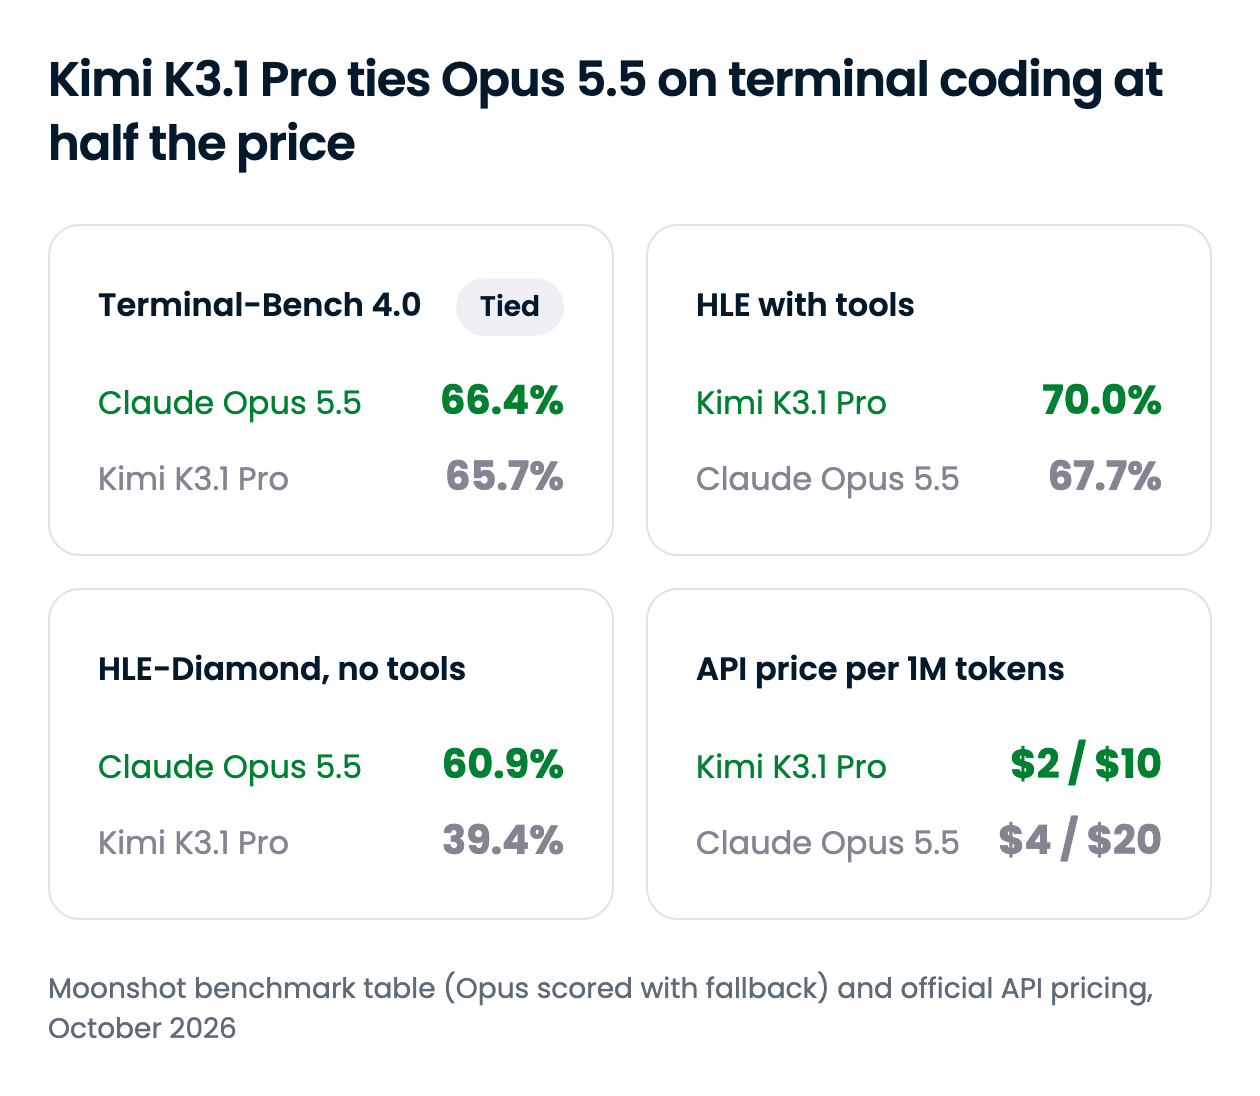
Kimi K3.1 Pro gana en precio y en trabajos de agentes que dependen de herramientas; Opus 5.5 gana cuando el modelo tiene que razonar sin apoyos o resolver un problema poco especificado. El resumen siguiente cubre cada dimensión, y las secciones posteriores profundizan en las que pueden cambiar tu decisión.
| Característica | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Desarrollador | Moonshot AI | Anthropic |
| Lanzamiento | Octubre de 2026 | 22 de septiembre de 2026 |
| Pesos | Pesos abiertos previstos para el 4 de noviembre de 2026 (licencia aún no anunciada) | Cerrado |
| Ventana de contexto | 1M tokens | 1M tokens |
| Salida máxima | Hasta 1.048.576 tokens (131.072 por defecto) | 128K tokens (300K en la Batch API, beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Programación de largo recorrido (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Razonamiento sin fuentes (HLE-Diamond) | 39,4% | 60,9% |
| Razonamiento con herramientas (HLE con herramientas) | 70,0% | 67,7% |
| Ciberofensiva (ExploitBench) | 74,7 | 91,0 |
| Precio del API | La mitad que Opus 5.5 en entrada y salida | Referencia |
| Dónde puedes ejecutarlo | Kimi API, apps de Kimi, OpenRouter | Claude API, apps de Claude, AWS, Google Cloud, Azure, agentes de código principales |
Un aviso que aplica a todas las puntuaciones de esta sección. Los números cara a cara vienen de la tabla de benchmarks de Moonshot, que marca cada resultado de Opus 5.5 como "con alternativa": las salvaguardas de Anthropic derivan algunas tareas de ciberseguridad y biología a otros modelos Claude (Opus 4.8 y Opus 5, respectivamente), lo que probablemente reduce esas puntuaciones.
Los dos modelos están prácticamente a la par en Terminal-Bench 4.0, pero ese titular oculta una división real. Kimi K3.1 Pro lidera en tareas de largo recorrido, mientras que Opus 5.5 saca ventaja, y holgada, cuando la tarea es abierta.
La mayor diferencia está en ProgramBench, que pide reconstruir un programa a partir de su binario y su especificación. Opus 5.5 lleva el 65,0% de las tareas al menos al 95% de tests superados, mientras que Kimi K3.1 Pro alcanza el 31,5%, menos de la mitad.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Notas |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi ejecutado en el arnés de Claude Code; Opus con esfuerzo xhigh según Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Tareas de ingeniería de varias horas |
| DeepSWE v1.1 | 75,5% | 74,2% | Configuración propia de cada laboratorio; trátalo como empate |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | 58,5% | Benchmark interno de Moonshot |
| ProgramBench (puntuación binaria) | 31,5% | 65,0% | Porcentaje de tareas con al menos 95% |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | La tabla de Anthropic reporta 58,7% para Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi ejecutado en GPUs H20 en lugar de H100 |
| BenchCAD con herramientas | 92,7% | 96,2% | Reconstrucción 3D mediante código CAD |
El patrón es coherente. Si le das a Kimi K3.1 Pro una tarea de ingeniería bien definida y mucho tiempo, no se cansa: la demo de Moonshot lo mostró corrigiendo 36 errores en los cálculos del músculo del hombro de un simulador de marcha humana a lo largo de 167 misiones. La historia equivalente de Anthropic es una traducción de C a Rust de HAProxy que pasó casi todas las pruebas de regresión del propio HAProxy.
Cuando la especificación es escasa, Opus toma la delantera. ProgramBench, los flujos de investigación científica y los experimentos de post-entrenamiento requieren averiguar primero qué hay que hacer, y ahí la resistencia de Kimi en carreras largas deja de rendir.
Para agentes de código largos y bien especificados, Kimi K3.1 Pro es una alternativa real; para ingeniería inversa, código de investigación y tickets difusos, Opus 5.5 es la apuesta más segura.
Si quitas las herramientas, Opus 5.5 lidera con claridad. La brecha más amplia está en HLE-Diamond, el subconjunto más difícil de 1.000 preguntas de Humanity's Last Exam, donde Opus logra un 60,9% frente al 39,4% de Kimi.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Notas |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2.500 preguntas, sin herramientas |
| HLE-Diamond | 39,4% | 60,9% | Las 1.000 preguntas más difíciles |
| GPQA-Diamond | 94,2% | 93,9% | Casi saturado; empate |
| MMMU-Pro | 84,1% | 87,7% | Preguntas con imagen y texto |
| Kimi Hallu Bench (menor es mejor) | 5,4% | 6,8% | Interno de Moonshot; tasa de alucinación a nivel de afirmación |
Empatan en GPQA-Diamond, que está demasiado cerca de su techo para separar a nadie. La menor tasa de alucinación de Kimi proviene de la prueba de estrés de Moonshot, así que la tomaría más como señal de que su trabajo en precisión factual ha cuajado que como un veredicto directo. En razonamiento sin fuentes, Opus 5.5 es el modelo más fuerte.
Si das herramientas a ambos modelos, el resultado en razonamiento se invierte. En Humanity's Last Exam con herramientas, Kimi K3.1 Pro obtiene un 70,0% frente al 67,7% de Opus, y lidera la mayoría de filas de investigación y documentos de Moonshot.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Notas |
|---|---|---|---|
| HLE-Full con herramientas | 70,0% | 67,7% | Las mismas preguntas, con herramientas permitidas |
| BrowseComp | 92,1% | 90,8% | Información web difícil de encontrar |
| OfficeQA Pro v2 | 64,4 | 62,2 | Análisis numérico en PDFs financieros |
| Frontier Finance | 58,6 | 56,7 | Flujos de inversión: cribado a rentabilidad |
| AutomationBench-AA | 73,3 | 69,5 | Versión de Artificial Analysis, no la de Zapier |
| OSWorld V2.1 | 79,6% | 81,8% | Manejo de un equipo de escritorio |
| APEX-Agents | 67,2 | 73,5 | Leaderboard de Mercor |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Las victorias de Kimi son pequeñas pero constantes en búsqueda y documentos financieros. Opus mantiene ventaja en uso de ordenador y en los rankings de agentes de terceros, así que Kimi K3.1 Pro es mejor como agente de investigación y Opus 5.5 como agente de escritorio y oficina general.
Ambos modelos leen el mismo tamaño de contexto y ambos razonan siempre: ni Moonshot ni Anthropic te permiten desactivar el razonamiento. Las configuraciones por defecto difieren. Kimi K3.1 Pro va con esfuerzo max salvo que establezcas low o high, mientras que Opus 5.5 parte de medium, así que una llamada a Kimi sin ajustar gasta más razonamiento por petición.
El techo de salida es la diferencia práctica mayor. Kimi K3.1 Pro puede devolver en una llamada una salida del tamaño completo de la ventana de contexto, aproximadamente ocho veces el tope de Opus 5.5 fuera de la Batch API. Quienes migren a Opus también deben saber que el uso forzado de herramientas ahora devuelve un error 400.
Ambos laboratorios limitan la capacidad ciberofensiva, pero de formas opuestas. Moonshot eliminó datos relacionados con ciberseguridad del entrenamiento intermedio y del RL para la versión de pesos abiertos, lo que redujo su benchmark interno de exploits del 90,5% al 81,0%. Anthropic mantiene la capacidad en Opus 5.5 y redirige la mayoría de peticiones de ciberseguridad a Opus 4.8 en tiempo de servicio.
En ExploitBench, Opus marca 91,0 frente a 74,7 de Kimi, y Moonshot afirma abiertamente que K3.1 Pro queda por detrás de los modelos propietarios de vanguardia en ciber por diseño. La contrapartida es el control: cuando salgan los pesos, podrás ejecutar Kimi en tu propia infraestructura, algo que Opus no ofrece.
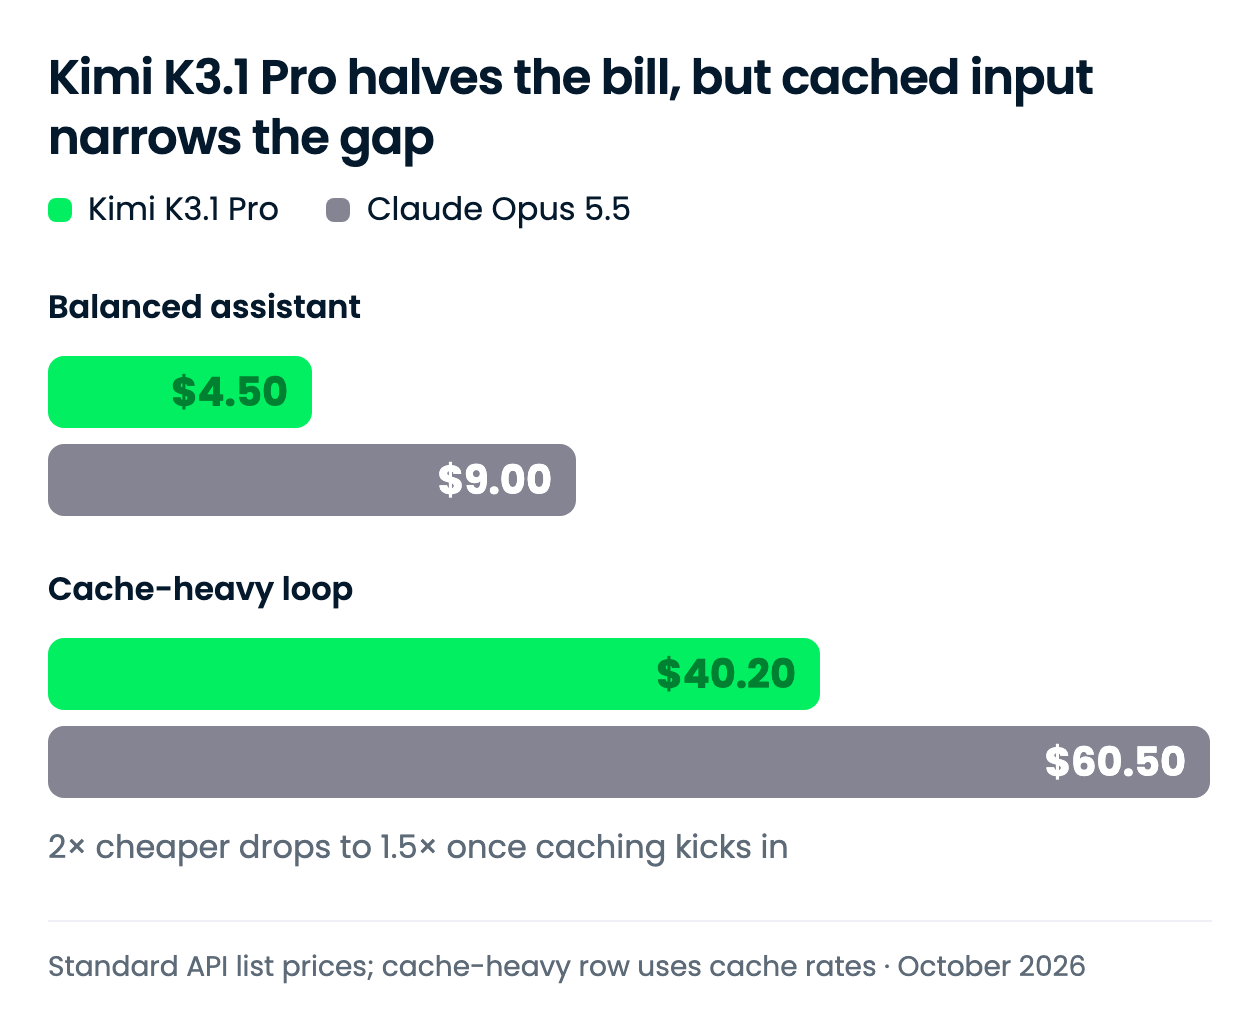
Kimi K3.1 Pro cuesta la mitad que Opus 5.5 en tokens nuevos. El ahorro se reduce cuando la carga usa contexto en caché, porque ambos cobran lo mismo por las lecturas de caché.
Todas las tarifas son por 1M de tokens, según las páginas oficiales de precios de Moonshot y Anthropic.
| Tarifa | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Entrada, por 1M de tokens | $2.00 | $4.00 |
| Salida, por 1M de tokens | $10.00 | $20.00 |
| Lectura de entrada en caché, por 1M de tokens | $0.20 | $0.20 |
| Escritura en caché, TTL 5 minutos | $2.00 | $5.00 |
| Escritura en caché, TTL 1 hora | $4.00 | $8.00 |
| Variante más rápida | K3.1 Pro Highspeed, 2–3x velocidad: $4.00 / $20.00 | Fast mode, hasta 2,5x velocidad: $8.00 / $40.00 |
El múltiplo no es uniforme: 0,5x en entrada, salida y escrituras de caché de 1 hora; 0,4x en escrituras de 5 minutos; y 1,0x en lecturas de caché. Ningún proveedor añade recargo por contexto largo.
Dos detalles que se desprenden de la tabla. La variante Highspeed de Kimi cuesta exactamente lo que cuesta el Opus estándar. La Batch API de Anthropic reduce a la mitad Opus hasta $2 y $10, igualando la tarifa estándar de Kimi, mientras que la página de precios de Moonshot no menciona descuentos por lotes.
Elegí dos perfiles mensuales: un asistente equilibrado como referencia de escala, y un bucle de agente con mucho caché, porque es en el caché donde divergen las listas de precios.
| Carga | Kimi K3.1 Pro | Claude Opus 5.5 | Diferencia |
|---|---|---|---|
| Asistente equilibrado: 1M entrada / 250K salida | $4.50 | $9.00 | $4.50 (Kimi 50% más barato) |
| Bucle con mucho caché: prefijo de 100K escrito una vez, 1.000 lecturas en caché, más 5K nuevos de entrada / 1K de salida por petición | $40.20 | $60.50 | $20.30 (Kimi 34% más barato) |
Cada total es (volumen ÷ 1M) × tarifa, sumado en entrada, salida y líneas de caché; la fila con mucho caché usa la escritura de 5 minutos. La fila equilibrada refleja simplemente la brecha de tarifas 2x.
La fila del caché es la que debes planificar. Los 100M de tokens en caché cuestan $20 en cualquiera de los modelos, así que solo los tokens nuevos y la escritura en caché arrastran el descuento de Kimi, y el ahorro baja a alrededor de un tercio. Anthropic dice que las lecturas de caché son la mayoría del coste en programación con agentes, por lo que los agentes de larga duración se acercarán más a esta fila que a la primera.
Los dos modelos usan tokenizadores distintos, y ningún proveedor ha publicado recuentos de tokens para una misma carga, así que toma estos totales como una comparación de tarifas, no como una factura.
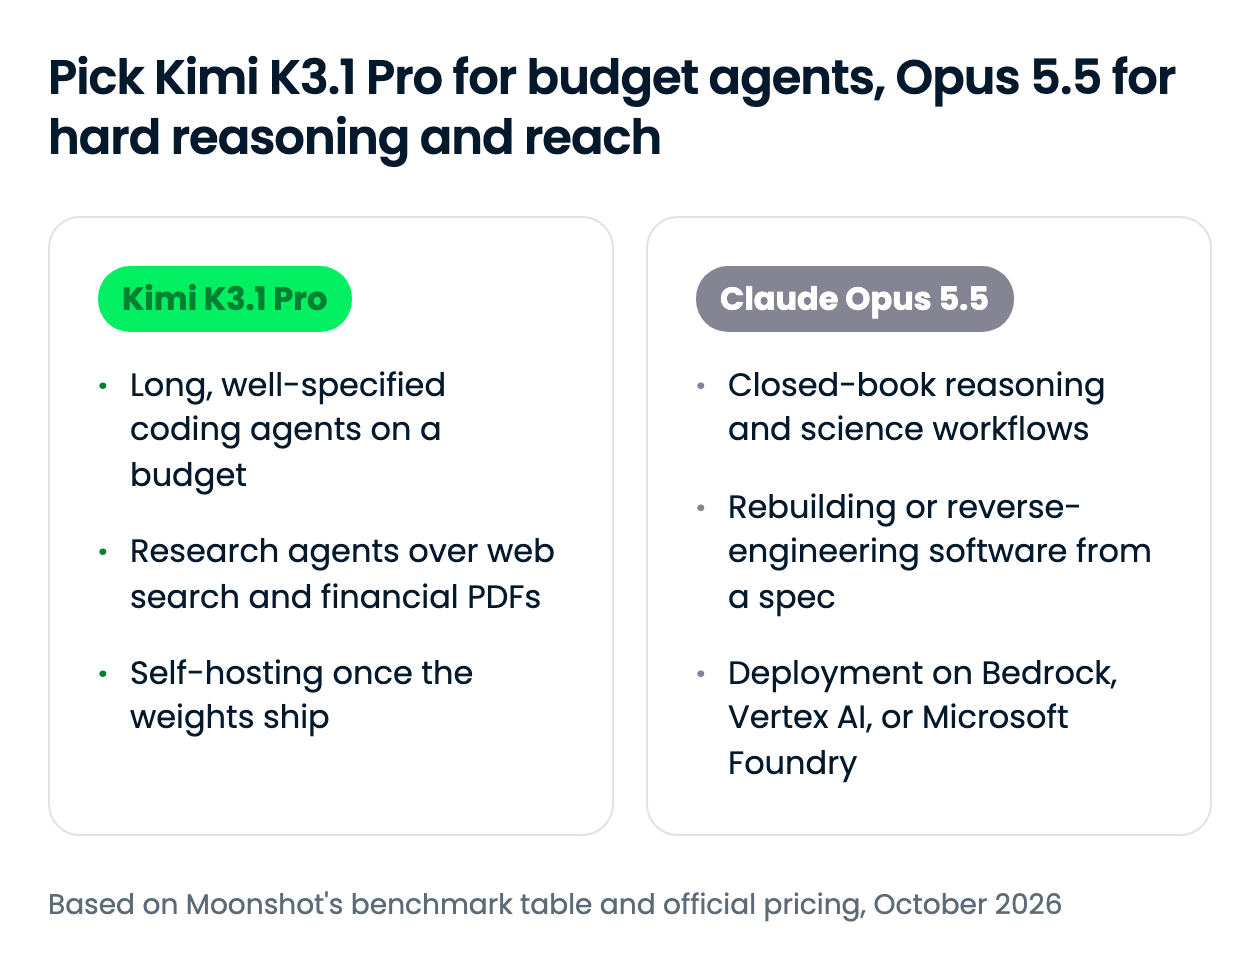
El dilema es precio frente a amplitud: Kimi K3.1 Pro reduce a la mitad la tarifa por token, y Opus 5.5 cubre los casos de razonamiento donde Kimi se queda atrás y las plataformas cloud en las que Kimi aún no está confirmado. Si tu agente funciona sobre todo con contexto en caché, el ahorro se acerca más a un tercio que a la mitad.
Puedes llamar a ambos modelos hoy a través de sus APIs o mediante OpenRouter, y Opus 5.5 también está en Amazon Bedrock, Vertex AI y Microsoft Foundry.
| Superficie | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| App de consumo | Kimi.com, apps móviles de Kimi, app de escritorio Kimi Work | Apps de Claude (Pro, Max, Team, Enterprise) |
| API propia | Kimi API (compatible con OpenAI) | Claude API |
| Plataformas cloud | No disponible aún en Azure AI Foundry o Amazon Bedrock a 29 oct 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Agentes de código | Kimi Code (aún no disponible en GitHub Copilot y Cursor a 29 oct 2026) | Claude Code, Cursor, GitHub Copilot |
| Routers de terceros | OpenRouter | OpenRouter |
| Pesos abiertos | Previstos para el 4 de noviembre de 2026 | No |
| ID de modelo en API | kimi-k3.1-pro |
claude-opus-5-5 |
La diferencia de alcance es decisiva para muchos equipos: Opus 5.5 está en todas las nubes principales y en los agentes de código más usados, mientras que Kimi K3.1 Pro solo está confirmado en las superficies de Moonshot y OpenRouter hasta que lleguen los pesos. En las APIs propias, los IDs son kimi-k3.1-pro y claude-opus-5-5; en OpenRouter son moonshotai/kimi-k3.1-pro y anthropic/claude-opus-5.5.
El endpoint compatible con OpenAI de OpenRouter convierte estos dos modelos en un simple cambio de cadena, la forma más fácil de hacer un A/B con tus prompts.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Nuestro tutorial del API de Opus 5.5 profundiza en el lado de Claude, y nuestro explicador sobre OpenCode muestra cómo conectar cualquiera de los dos modelos a un agente de código de código abierto.
Kimi K3.1 Pro iguala a Claude Opus 5.5 en programación por terminal y lo supera en ejecuciones largas de agentes con muchas herramientas, con un descuento notable. Si tus agentes ejecutan tareas largas y bien definidas con herramientas, usa Kimi; si razonan sin ayuda, parten de especificaciones difusas o deben vivir en AWS, Google Cloud o Azure, usa Opus.
Lo más interesante es cómo los dos laboratorios gestionan de forma diferente el mismo riesgo: Moonshot recorta la capacidad ciber de los pesos antes de publicarlos, y Anthropic la mantiene en el modelo y la controla en tiempo de servicio. Yo probaría Kimi vía OpenRouter y valoraría el autohospedaje cuando lleguen los pesos y la licencia en noviembre.
Si te apetece construir con modelos como estos, te recomiendo nuestro itinerario Associate AI Engineer for Developers.
¡Aprende IA con DataCamp!
Programa
Curso
Practica y programa tu progreso.
Continuar Con Googleblog
Abid Ali Awan
9 min
blog
Ryan Ong
8 min
blog
Matt Crabtree
12 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
Tutorial
Moez Ali
11 min