

Program
Insinyur Kecerdasan Buatan (AI) untuk Pengembang
26 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleMoonshot AI merilis Kimi K3.1 Pro pada Oktober 2026 dengan klaim yang tidak biasa spesifik: pada Terminal-Bench 4.0, model open-weight barunya berada dalam selisih satu poin dari Claude Opus 5.5, model andalan Anthropic yang diluncurkan pada 22 September. Itu dicapai dengan harga per token setengah dari Anthropic, dan Moonshot menjanjikan bobot yang dapat diunduh pada 4 November.
Dalam artikel ini, saya akan membandingkan Kimi K3.1 Pro dan Claude Opus 5.5 pada pengodean agen, penalaran, pekerjaan agen yang berat alat, kontrol keamanan, dan berapa sebenarnya biaya operasional masing-masing.
Jika Anda tertarik dengan rilis model baru, pastikan juga membaca panduan kami tentang flagship terbaru Google, Gemini 4 Carbon dan Genie 4. Untuk tetap mengikuti berita AI terbaru, saya juga merekomendasikan berlangganan buletin mingguan kami, The Median.
Kimi K3.1 Pro adalah model andalan Moonshot AI, dirilis pada Oktober 2026 sebagai versi pasca-pelatihan dari Kimi K3 dengan bobot terbuka yang dijanjikan pada 4 November.
Nilai jualnya adalah reinforcement learning skala besar: Moonshot menjalankan RL gabungan di ratusan domain hilir, yang paling tampak pada pengodean jangka panjang, riset keuangan, dan pembuatan 3D.
Panduan Kimi K3.1 Pro kami membahas peluncurannya secara lengkap.
Claude Opus 5.5 adalah flagship tertutup Anthropic dan model pertama dalam keluarga Claude 5.5, dirilis pada 22 September 2026.
Anthropic memposisikannya setara kinerja Claude Fable 5.1 pada sebagian besar pekerjaan dengan harga lebih rendah daripada Opus 5, dengan skor terbaik yang mereka ukur pada audit alignment otomatisnya.
Panduan Claude Opus 5.5 kami membahas peluncurannya; tutorial API Opus 5.5 kami memandu pembuatan investigator insiden AI.
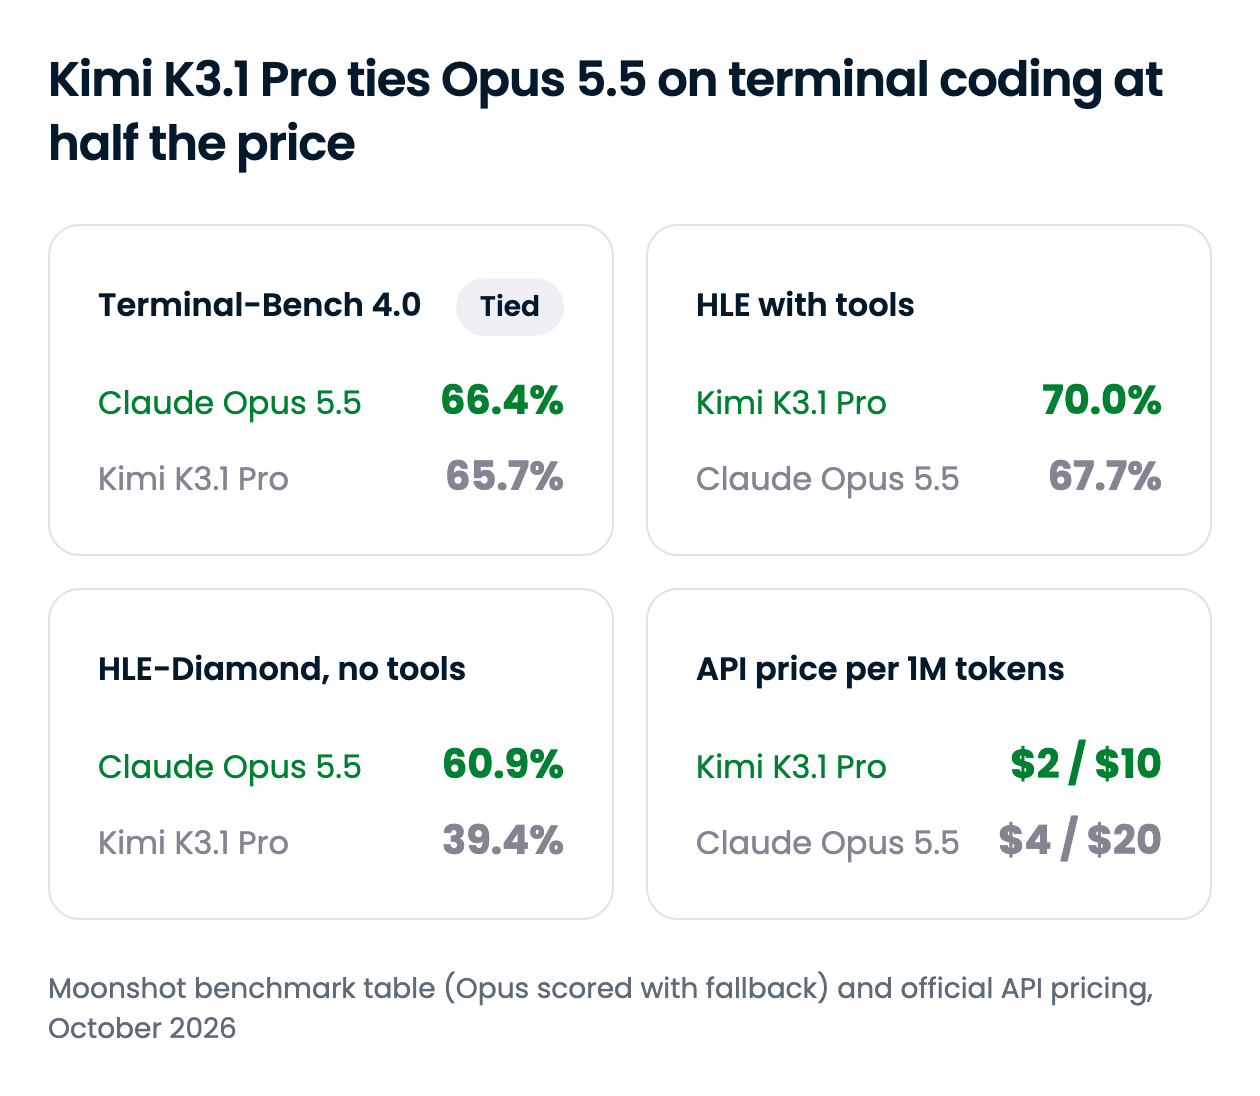
Kimi K3.1 Pro unggul pada harga dan pekerjaan agen yang mengandalkan alat; Opus 5.5 menang kapan pun model harus menalar tanpa bantuan atau menyelesaikan masalah yang spesifikasinya kurang. Ringkasan di bawah mencakup setiap dimensi, dan bagian setelahnya membahas area yang celahnya dapat mengubah keputusan.
| Fitur | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Pengembang | Moonshot AI | Anthropic |
| Rilis | Oktober 2026 | 22 September 2026 |
| Bobot | Open weights dijadwalkan 4 November 2026 (lisensi belum diumumkan) | Tertutup |
| Jendela konteks | 1 juta token | 1 juta token |
| Output maksimum | Hingga 1.048.576 token (131.072 secara default) | 128K token (300K pada Batch API, beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Pengodean jangka panjang (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Penalaran closed-book (HLE-Diamond) | 39,4% | 60,9% |
| Penalaran berbantuan alat (HLE dengan alat) | 70,0% | 67,7% |
| Siber ofensif (ExploitBench) | 74,7 | 91,0 |
| Harga API | Setengah Opus 5.5 pada input dan output | Patokan |
| Di mana dapat dijalankan | API Kimi, aplikasi Kimi, OpenRouter | API Claude, aplikasi Claude, AWS, Google Cloud, Azure, agen pengodean utama |
Satu catatan berlaku untuk setiap skor di bagian ini. Angka head-to-head berasal dari tabel tolok ukur Moonshot sendiri, yang menandai setiap hasil Opus 5.5 "dengan fallback": kontrol keamanan Anthropic mengalihkan sebagian tugas siber dan biologi ke model Claude lain (Opus 4.8 dan Opus 5, masing-masing), yang kemungkinan menurunkan skor tersebut.
Kedua model pada dasarnya setara pada Terminal-Bench 4.0, dan judul utama itu menyembunyikan perbedaan nyata. Kimi K3.1 Pro memimpin baris jangka panjang, sementara Opus 5.5 unggul lebar di mana pun tugasnya terbuka.
Jarak terbesar ada pada ProgramBench, yang meminta model membangun ulang program dari biner dan spesifikasinya. Opus 5.5 menyelesaikan 65,0% tugas hingga minimal 95% pengujian lulus, sedangkan Kimi K3.1 Pro mencapai 31,5%, kurang dari setengahnya.
| Tolok ukur | Kimi K3.1 Pro | Claude Opus 5.5 | Catatan |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi dijalankan di harness Claude Code; Opus pada upaya xhigh per Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Tugas rekayasa multi-jam |
| DeepSWE v1.1 | 75,5% | 74,2% | Setup masing-masing lab sendiri, jadi anggap seri |
| Kimi Code Bench 3.0 Jangka panjang | 61,2% | 58,5% | Tolok ukur internal Moonshot |
| ProgramBench (skor biner) | 31,5% | 65,0% | Porsi tugas yang skornya minimal 95% |
| Terminal-Bench Science 0,1 | 38,1% | 63,3% | Tabel Anthropic sendiri melaporkan 58,7% untuk Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi dijalankan pada GPU H20, bukan H100 |
| BenchCAD dengan alat | 92,7% | 96,2% | Rekonstruksi 3D melalui kode CAD |
Pola ini konsisten. Berikan Kimi K3.1 Pro tugas rekayasa yang terdefinisi baik dan banyak waktu, ia akan terus maju: run unggulan Moonshot membuatnya memperbaiki 36 kesalahan dalam perhitungan otot bahu simulator jalan manusia di 167 misi. Cerita setara Anthropic adalah translasi C ke Rust untuk HAProxy yang lolos hampir semua uji regresi bawaan HAProxy.
Ketika spesifikasinya tipis, Opus melesat. ProgramBench, alur kerja riset ilmiah, dan eksperimen pasca-pelatihan semuanya menuntut penentuan apa sebenarnya tugasnya, dan di situlah ketahanan jangka panjang Kimi berhenti menguntungkan.
Untuk agen pengodean yang panjang dan terdefinisi baik, Kimi K3.1 Pro adalah alternatif nyata; untuk rekayasa balik, kode riset, dan tiket yang samar, Opus 5.5 lebih aman.
Tanpa alat, Opus 5.5 memimpin jelas. Jarak terlebar ada pada HLE-Diamond, subset 1.000 pertanyaan tersulit dari Humanity's Last Exam, di mana Opus mencetak 60,9% melawan 39,4% milik Kimi.
| Tolok ukur | Kimi K3.1 Pro | Claude Opus 5.5 | Catatan |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2.500 pertanyaan, tanpa alat |
| HLE-Diamond | 39,4% | 60,9% | 1.000 pertanyaan tersulit |
| GPQA-Diamond | 94,2% | 93,9% | Hampir jenuh; seri |
| MMMU-Pro | 84,1% | 87,7% | Pertanyaan gambar dan teks |
| Kimi Hallu Bench (lebih rendah lebih baik) | 5,4% | 6,8% | Internal Moonshot; tingkat halusinasi pada level klaim |
Keduanya seri pada GPQA-Diamond, yang terlalu dekat dengan plafonnya untuk membedakan siapa pun. Tingkat halusinasi Kimi yang lebih rendah berasal dari uji stres Moonshot sendiri, jadi saya anggap itu lebih sebagai tanda pekerjaan akurasi faktual membuahkan hasil daripada putusan head-to-head. Untuk penalaran closed-book, Opus 5.5 lebih kuat.
Berikan kedua model alat dan hasil penalaran berbalik. Pada Humanity's Last Exam dengan alat, Kimi K3.1 Pro mencetak 70,0% melawan 67,7% milik Opus, dan memimpin sebagian besar baris riset dan dokumen Moonshot.
| Tolok ukur | Kimi K3.1 Pro | Claude Opus 5.5 | Catatan |
|---|---|---|---|
| HLE-Full dengan alat | 70,0% | 67,7% | Pertanyaan yang sama, alat diperbolehkan |
| BrowseComp | 92,1% | 90,8% | Informasi web yang sulit ditemukan |
| OfficeQA Pro v2 | 64,4 | 62,2 | Analisis numerik pada PDF keuangan |
| Frontier Finance | 58,6 | 56,7 | Alur kerja investasi, dari penyaringan hingga profitabilitas |
| AutomationBench-AA | 73,3 | 69,5 | Versi Artificial Analysis, bukan milik Zapier |
| OSWorld V2.1 | 79,6% | 81,8% | Mengoperasikan komputer desktop |
| APEX-Agents | 67,2 | 73,5 | Papan peringkat Mercor |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Kemenangan Kimi kecil namun konsisten pada penelusuran dan dokumen keuangan. Opus mempertahankan keunggulan pada penggunaan komputer dan papan peringkat agen pihak ketiga, jadi Kimi K3.1 Pro lebih baik sebagai agen riset dan Opus 5.5 lebih baik sebagai agen desktop dan kantor umum.
Kedua model membaca konteks berukuran sama, dan keduanya selalu berpikir: baik Moonshot maupun Anthropic tidak memungkinkan Anda mematikan penalaran. Namun defaultnya berbeda. Kimi K3.1 Pro berjalan pada upaya max kecuali Anda mengatur low atau high, sementara Opus 5.5 default ke medium, sehingga pemanggilan Kimi tanpa penyetelan menghabiskan penalaran lebih banyak per permintaan.
Batas output adalah celah praktis yang lebih besar. Kimi K3.1 Pro dapat mengembalikan output sebesar jendela konteks penuh dalam satu panggilan, kira-kira delapan kali batas Opus 5.5 di luar Batch API. Pembuat agen yang bermigrasi ke Opus juga perlu tahu bahwa pemaksaan penggunaan alat kini mengembalikan error 400.
Kedua lab membatasi kemampuan siber ofensif, dengan cara yang berlawanan. Moonshot menghapus data terkait siber dari pelatihan menengah dan RL untuk rilis open-weight, yang menurunkan tolok ukur eksploit internalnya dari 90,5% menjadi 81,0%. Anthropic mempertahankan kapabilitas itu di Opus 5.5 dan mengalihkan sebagian besar permintaan keamanan siber ke Opus 4.8 saat penyajian.
Pada ExploitBench, Opus mencetak 91,0 melawan 74,7 milik Kimi, dan Moonshot secara gamblang mengatakan bahwa K3.1 Pro sengaja tetap di belakang model proprietary terdepan dalam hal siber. Imbalannya adalah kontrol: setelah bobot dirilis, Anda dapat menjalankan Kimi di infrastruktur Anda sendiri, sesuatu yang tidak ditawarkan Opus.
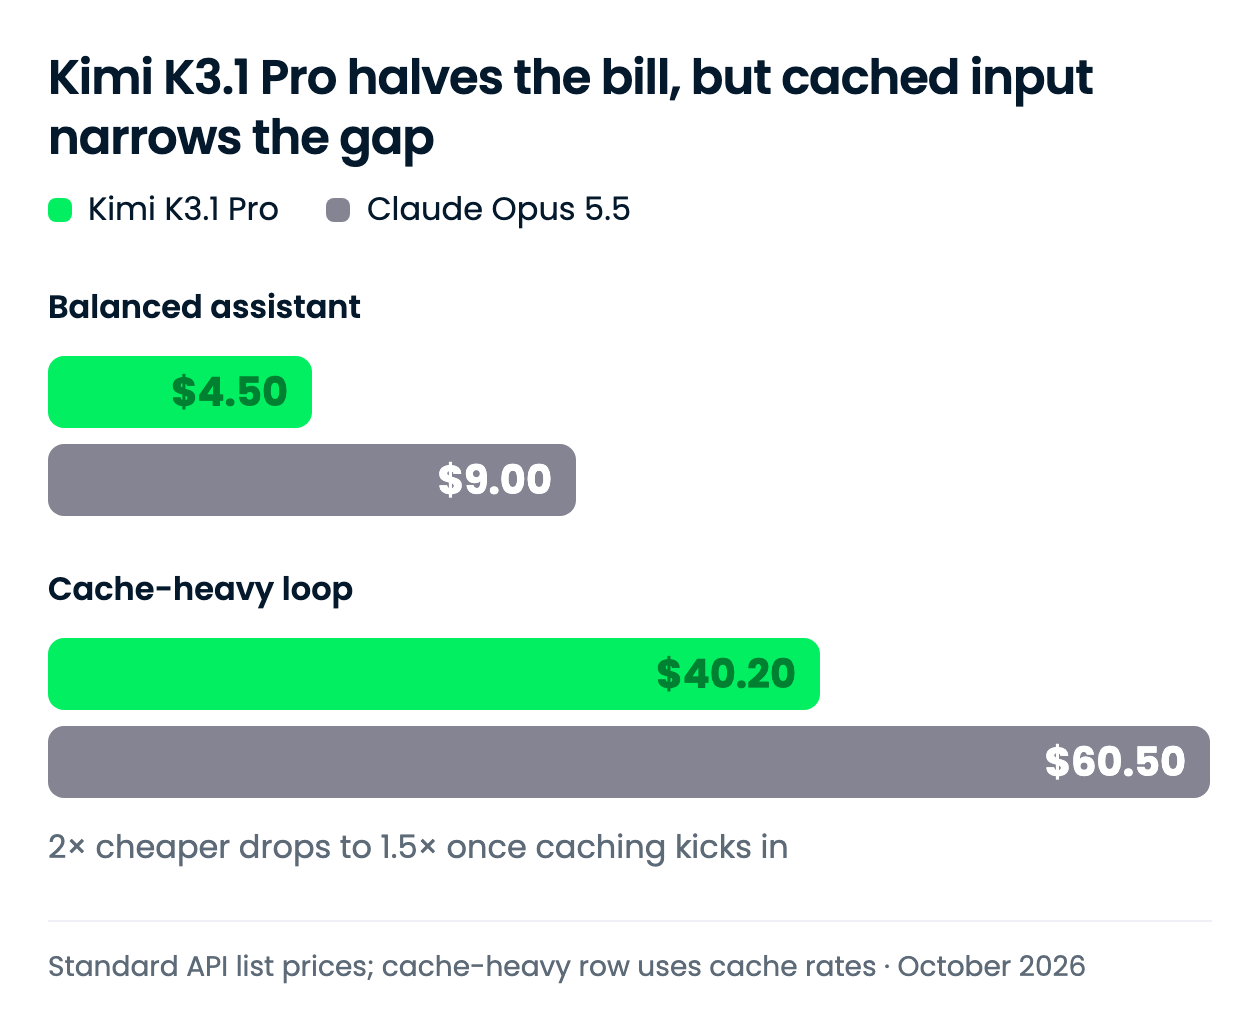
Kimi K3.1 Pro berharga setengah Opus 5.5 pada token baru. Penghematan menyusut ketika beban kerja berjalan pada konteks yang di-cache, karena kedua vendor mengenakan biaya yang sama untuk pembacaan cache.
Semua tarif per 1 juta token, dari halaman harga resmi Moonshot dan Anthropic.
| Tarif | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Input, per 1 juta token | $2,00 | $4,00 |
| Output, per 1 juta token | $10,00 | $20,00 |
| Pembacaan input cache, per 1 juta token | $0,20 | $0,20 |
| Penulisan cache, TTL 5 menit | $2,00 | $5,00 |
| Penulisan cache, TTL 1 jam | $4,00 | $8,00 |
| Varian lebih cepat | K3.1 Pro Highspeed, 2–3x lebih cepat: $4,00 / $20,00 | Mode cepat, hingga 2,5x lebih cepat: $8,00 / $40,00 |
Kelipatannya tidak seragam: 0,5x pada input, output, dan penulisan cache 1 jam, 0,4x pada penulisan cache 5 menit, dan 1,0x pada pembacaan cache. Tak ada vendor yang menambahkan biaya tambahan untuk konteks panjang.
Ada dua keanehan dari tabel ini. Varian Highspeed Kimi biayanya persis sama dengan Opus standar. Batch API Anthropic memangkas Opus menjadi $2 dan $10, menyamai tarif standar Kimi, sementara halaman harga Moonshot tidak mencantumkan diskon batch.
Saya memilih dua bentuk beban kerja bulanan: asisten seimbang sebagai jangkar skala, dan loop agen yang berat cache, karena harga cache adalah tempat dua daftar harga ini berbeda.
| Beban kerja | Kimi K3.1 Pro | Claude Opus 5.5 | Selisih |
|---|---|---|---|
| Asisten seimbang: 1 juta masuk / 250 ribu keluar | $4,50 | $9,00 | $4,50 (Kimi 50% lebih murah) |
| Loop berat cache: prefiks 100 ribu ditulis sekali, 1.000 pembacaan cache, plus 5 ribu masuk baru / 1 ribu keluar per permintaan | $40,20 | $60,50 | $20,30 (Kimi 34% lebih murah) |
Setiap total adalah (volume ÷ 1 juta) × tarif, dijumlahkan untuk baris input, output, dan cache; baris berat cache menggunakan penulisan cache 5 menit. Baris seimbang hanyalah selisih tarif 2x.
Baris berat cache adalah yang perlu direncanakan. 100 juta token yang di-cache berbiaya $20 pada kedua model, jadi hanya token baru dan penulisan cache yang membawa diskon Kimi, dan penghematan turun menjadi sekitar sepertiga. Anthropic mengatakan pembacaan cache menyumbang mayoritas biaya pengodean agen, jadi agen yang berjalan lama akan lebih dekat ke baris ini daripada baris pertama.
Kedua model menggunakan tokenizer berbeda, dan tak ada vendor yang menerbitkan hitungan token untuk beban kerja bersama, jadi anggap total ini sebagai perbandingan tarif, bukan tagihan.
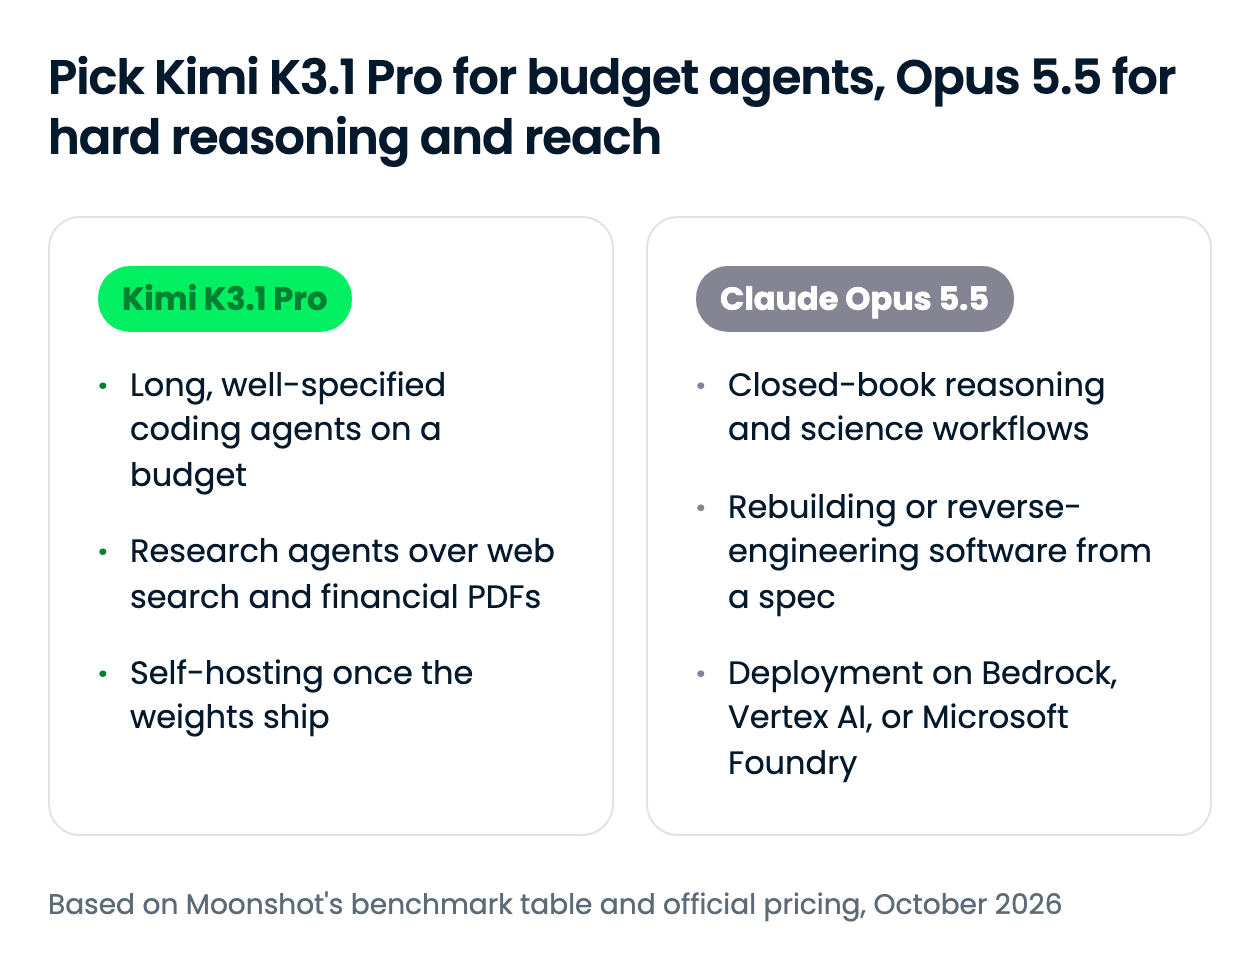
Pilihan bercabang antara harga dan keluasan: Kimi K3.1 Pro memangkas tarif per token menjadi setengahnya, dan Opus 5.5 mencakup kasus penalaran tempat Kimi tertinggal dan platform cloud yang belum dikonfirmasi untuk Kimi. Jika agen Anda berjalan terutama pada konteks yang di-cache, penghematan lebih dekat ke sepertiga daripada setengah.
Anda dapat memanggil kedua model hari ini melalui API masing-masing atau melalui OpenRouter, dan Opus 5.5 juga berjalan di Amazon Bedrock, Vertex AI, dan Microsoft Foundry.
| Permukaan | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Aplikasi konsumen | Kimi.com, aplikasi seluler Kimi, aplikasi desktop Kimi Work | Aplikasi Claude (Pro, Max, Team, Enterprise) |
| API pihak pertama | API Kimi (kompatibel OpenAI) | API Claude |
| Platform cloud | Belum tersedia di Azure AI Foundry atau Amazon Bedrock per 29 Okt 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Agen pengodean | Kimi Code (belum tersedia di GitHub Copilot dan Cursor per 29 Okt 2026) | Claude Code, Cursor, GitHub Copilot |
| Router pihak ketiga | OpenRouter | OpenRouter |
| Open weights | Dijadwalkan 4 November 2026 | Tidak |
| ID model API | kimi-k3.1-pro |
claude-opus-5-5 |
Kesenjangan jangkauan menjadi faktor penentu bagi banyak tim: Opus 5.5 tersedia di setiap cloud besar dan di agen pengodean arus utama, sementara Kimi K3.1 Pro sejauh ini dikonfirmasi hanya di permukaan Moonshot sendiri dan OpenRouter hingga bobotnya tiba. Pada API pihak pertama ID modelnya adalah kimi-k3.1-pro dan claude-opus-5-5; di OpenRouter adalah moonshotai/kimi-k3.1-pro dan anthropic/claude-opus-5.5.
Endpoint OpenAI-kompatibel OpenRouter membuat kedua model dapat ditukar dengan satu string, yang merupakan cara termudah untuk A/B pada prompt Anda sendiri.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Tutorial API Opus 5.5 kami membahas sisi Claude lebih dalam, dan penjelasan kami tentang OpenCode menunjukkan cara menyambungkan salah satu model ke agen pengodean sumber terbuka.
Kimi K3.1 Pro menyamai Claude Opus 5.5 pada pengodean terminal dan mengunggulinya pada run agen yang panjang dan berat alat, dengan diskon signifikan. Jika agen Anda menjalankan tugas panjang yang terdefinisi baik dengan alat, gunakan Kimi; jika mereka menalar tanpa bantuan, mengejar spesifikasi yang samar, atau harus hidup di AWS, Google Cloud, atau Azure, gunakan Opus.
Yang paling menarik bagi saya adalah betapa berbedanya kedua lab menangani risiko yang sama: Moonshot memotong kapabilitas siber dari bobot sebelum memublikasikannya, dan Anthropic mempertahankannya di model dan membatasinya saat penyajian. Saya akan menguji Kimi melalui OpenRouter dan meninjau kembali self-hosting setelah bobot dan lisensinya hadir pada November.
Jika Anda bersemangat membangun dengan model seperti ini, saya sarankan melihat jalur Associate AI Engineer for Developers kami.
Belajar AI Bersama DataCamp!
Program
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



