

लर्निंग पाथ
डेवलपर्स के लिए एसोसिएट AI इंजीनियर
26 घंटा
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंMoonshot AI ने अक्टूबर 2026 में Kimi K3.1 Pro जारी किया, एक असामान्य रूप से सटीक दावे के साथ: Terminal-Bench 4.0 पर इसका नया ओपन-वेट मॉडल Claude Opus 5.5 से एक अंक के भीतर आता है, जिसे Anthropic ने 22 सितंबर को शिप किया था। यह ऐसा Anthropic की प्रति-टोकन कीमत के आधे पर करता है, और Moonshot ने 4 नवंबर तक डाउनलोड योग्य वेट्स देने का वादा किया है।
इस लेख में, मैं एजेंटिक कोडिंग, तर्क, टूल-भारी एजेंट कार्य, सुरक्षा नियंत्रणों, और रन लागत के आधार पर Kimi K3.1 Pro और Claude Opus 5.5 की तुलना करूँगा।
यदि आप नए मॉडल रिलीज़ में रुचि रखते हैं, तो Google के नवीनतम फ्लैगशिप्स पर हमारे गाइड भी ज़रूर पढ़ें: Gemini 4 Carbon और Genie 4। ताकि नवीनतम AI समाचारों से अपडेट रहें, मैं हमारे साप्ताहिक न्यूज़लेटर The Median की सदस्यता लेने की भी सलाह देता हूँ।
Kimi K3.1 Pro Moonshot AI का फ्लैगशिप मॉडल है, जिसे अक्टूबर 2026 में Kimi K3 के पोस्ट-ट्रेंड संस्करण के रूप में जारी किया गया, और 4 नवंबर तक ओपन वेट्स का वादा किया गया है।
इसकी खासियत बड़े पैमाने पर रिइनफोर्समेंट लर्निंग है: Moonshot ने सैकड़ों डाउनस्ट्रीम डोमेन्स पर संयुक्त RL चलाया, जिसका प्रभाव सबसे ज़्यादा लंबी-अवधि कोडिंग, वित्तीय रिसर्च और 3D क्रिएशन में दिखता है।
हमारा Kimi K3.1 Pro गाइड लॉन्च को विस्तार से कवर करता है।
Claude Opus 5.5 Anthropic का क्लोज़्ड फ्लैगशिप है और Claude 5.5 फैमिली का पहला मॉडल, जो 22 सितंबर, 2026 को जारी हुआ।
Anthropic इसे Opus 5 से कम कीमत पर अधिकांश कार्यों में Claude Fable 5.1-स्तरीय प्रदर्शन के रूप में पेश करता है, और अपने स्वचालित एलाइनमेंट ऑडिट पर इसके सर्वोत्तम स्कोर बताता है।
हमारा Claude Opus 5.5 गाइड लॉन्च कवर करता है; हमारा Opus 5.5 API ट्यूटोरियल एक AI incident investigator बनाने की प्रक्रिया बताता है।
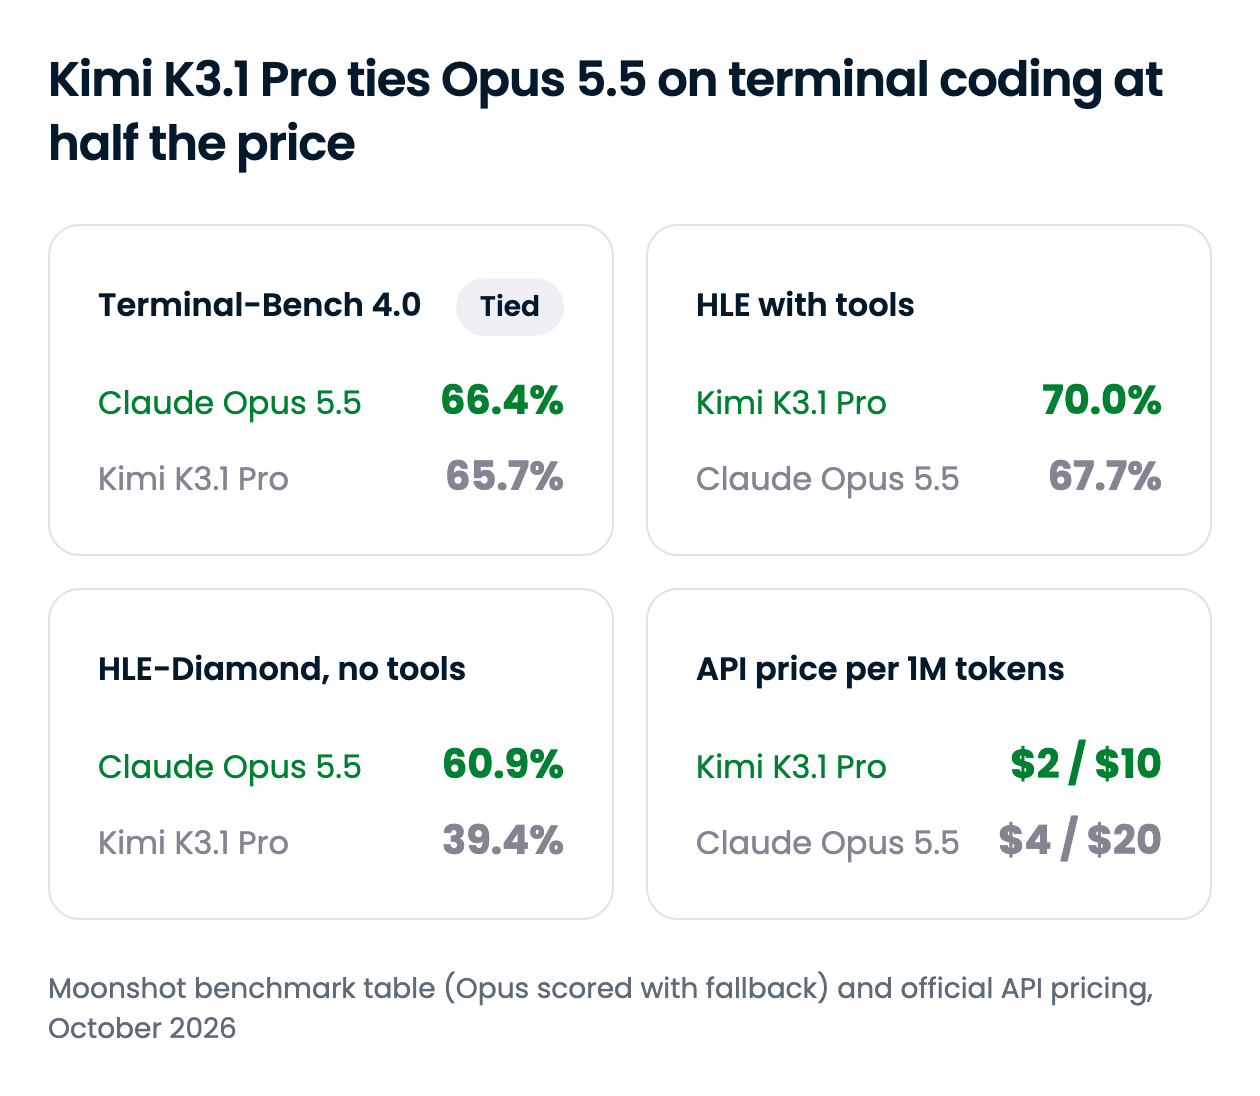
Kimi K3.1 Pro कीमत और उन एजेंट कार्यों में जीतता है जो टूल्स पर निर्भर हैं; Opus 5.5 वहाँ जीतता है जहाँ मॉडल को बिना मदद के तर्क करना हो या किसी कम-परिभाषित समस्या को सुलझाना हो। नीचे का सारांश हर आयाम को कवर करता है, और उसके बाद के खंड उन बिंदुओं पर विस्तार देते हैं जहाँ अंतर निर्णय बदल देता है।
| फीचर | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| डेवलपर | Moonshot AI | Anthropic |
| रिलीज़ | अक्टूबर 2026 | 22 सितंबर, 2026 |
| वेट्स | ओपन वेट्स 4 नवंबर, 2026 तक अपेक्षित (लाइसेंस अभी घोषित नहीं) | क्लोज़्ड |
| कॉन्टेक्स्ट विंडो | 1M टोकन | 1M टोकन |
| अधिकतम आउटपुट | 1,048,576 टोकन तक (डिफ़ॉल्ट 131,072) | 128K टोकन (Batch API पर 300K, बीटा) |
| Terminal-Bench 4.0 | 65.7% | 66.4% |
| लॉन्ग-होराइज़न कोडिंग (SWE-Marathon v1.1) | 51.7% | 46.3% |
| क्लोज़्ड-बुक तर्क (HLE-Diamond) | 39.4% | 60.9% |
| टूल-असिस्टेड तर्क (HLE with tools) | 70.0% | 67.7% |
| ऑफेंसिव साइबर (ExploitBench) | 74.7 | 91.0 |
| API कीमत | इनपुट और आउटपुट पर Opus 5.5 की आधी | बेसलाइन |
| कहाँ चला सकते हैं | Kimi API, Kimi ऐप्स, OpenRouter | Claude API, Claude ऐप्स, AWS, Google Cloud, Azure, प्रमुख कोडिंग एजेंट्स |
इस खंड के हर स्कोर पर एक चेतावनी लागू होती है। आमने-सामने के आँकड़े Moonshot की अपनी बेंचमार्क तालिका से आते हैं, जो प्रत्येक Opus 5.5 परिणाम को "with fallback" चिन्हित करती है: Anthropic के सेफ़गार्ड कुछ साइबर और बायोलॉजी कार्य अन्य Claude मॉडलों को सौंपते हैं (Opus 4.8 और Opus 5, क्रमशः), जिससे वे स्कोर संभवतः नीचे आते हैं।
दोनों मॉडल व्यावहारिक रूप से Terminal-Bench 4.0 पर बराबर हैं, और यह हेडलाइन अंदर छुपे वास्तविक बँटवारे को ढक देती है। Kimi K3.1 Pro लंबी-अवधि वाली पंक्तियों में आगे है, जबकि Opus 5.5 वहाँ बढ़त लेता है जहाँ कार्य ओपन-एंडेड है।
सबसे बड़ा अंतर ProgramBench है, जो किसी मॉडल से उसके बायनरी और स्पेक से प्रोग्राम को फिर से बनाने को कहता है। Opus 5.5 कम-से-कम 95% टेस्ट पास वाले 65.0% कार्य पूरे करता है, जबकि Kimi K3.1 Pro 31.5% पर रुक जाता है, जो आधे से भी कम है।
| बेंचमार्क | Kimi K3.1 Pro | Claude Opus 5.5 | टिप्पणियाँ |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | Kimi को Claude Code हार्नेस में चलाया गया; Opus Anthropic के अनुसार xhigh effort पर |
| SWE-Marathon v1.1 | 51.7% | 46.3% | मल्टी-आवर इंजीनियरिंग कार्य |
| DeepSWE v1.1 | 75.5% | 74.2% | प्रत्येक लैब की अपनी सेटअप, इसलिए बराबरी मानें |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | 58.5% | Moonshot का आंतरिक बेंचमार्क |
| ProgramBench (बाइनरी स्कोर) | 31.5% | 65.0% | कम-से-कम 95% स्कोर वाले कार्यों का हिस्सा |
| Terminal-Bench Science 0.1 | 38.1% | 63.3% | Anthropic की अपनी तालिका Opus के लिए 58.7% रिपोर्ट करती है |
| PostTrainBench v1.2 | 36.5% | 43.8% | Kimi H100s की जगह H20 GPUs पर चलाया गया |
| BenchCAD with tools | 92.7% | 96.2% | CAD कोड के माध्यम से 3D पुनर्निर्माण |
पैटर्न एकसमान है। Kimi K3.1 Pro को कोई अच्छी-तरह परिभाषित इंजीनियरिंग कार्य और पर्याप्त समय दें, तो यह चलता रहता है: Moonshot के शोकेस रन में उसने एक ह्यूमन वॉकिंग सिम्युलेटर के शोल्डर-मसल कैलकुलेशनों में 167 मिशनों में 36 त्रुटियाँ ठीक कीं। Anthropic की समकक्ष कहानी HAProxy का C-से-Rust अनुवाद है, जिसने HAProxy के अपने लगभग सभी रिग्रेशन टेस्ट पास किए।
जहाँ स्पेक पतला है, Opus आगे निकलता है। ProgramBench, वैज्ञानिक रिसर्च वर्कफ़्लो, और पोस्ट-ट्रेनिंग प्रयोगों में पहले यह समझना होता है कि कार्य है क्या, और वहीं Kimi की लंबी-दौड़ क्षमता का लाभ रुक जाता है।
लंबे, अच्छी तरह से परिभाषित कोडिंग एजेंट्स के लिए Kimi K3.1 Pro एक वास्तविक विकल्प है; रिवर्स-इंजीनियरिंग, रिसर्च कोड, और अस्पष्ट टिकटों के लिए Opus 5.5 सुरक्षित पसंद है।
टूल्स हटा दें, तो Opus 5.5 साफ़ बढ़त लेता है। सबसे चौड़ा अंतर HLE-Diamond है, Humanity's Last Exam का 1,000-प्रश्नों वाला सबसे कठिन सबसेट, जहाँ Opus 60.9% और Kimi 39.4% स्कोर करता है।
| बेंचमार्क | Kimi K3.1 Pro | Claude Opus 5.5 | टिप्पणियाँ |
|---|---|---|---|
| HLE-Full | 51.1% | 59.8% | 2,500 प्रश्न, बिना टूल |
| HLE-Diamond | 39.4% | 60.9% | सबसे कठिन 1,000 प्रश्न |
| GPQA-Diamond | 94.2% | 93.9% | सीलिंग के क़रीब; बराबरी |
| MMMU-Pro | 84.1% | 87.7% | छवि और पाठ प्रश्न |
| Kimi Hallu Bench (कम बेहतर) | 5.4% | 6.8% | Moonshot आंतरिक; क्लेम-स्तर भ्रम दर |
वे GPQA-Diamond पर बराबरी करते हैं, जो अपनी सीलिंग के बहुत क़रीब है, किसी को अलग नहीं करता। Kimi की कम hallucination दर Moonshot के अपने स्ट्रेस टेस्ट से आती है, इसलिए मैं इसे हेड-टू-हेड फ़ैसले की बजाय तथ्यात्मक-सटीकता कार्य के असर के संकेत के रूप में देखूँगा। क्लोज़्ड-बुक तर्क के लिए Opus 5.5 मजबूत मॉडल है।
दोनों मॉडलों को टूल दें और तर्क का नतीजा पलट जाता है। Humanity's Last Exam with tools पर Kimi K3.1 Pro 70.0% स्कोर करता है, जबकि Opus 67.7% पर रहता है, और यह Moonshot की रिसर्च और दस्तावेज़ी पंक्तियों में अधिकतर आगे है।
| बेंचमार्क | Kimi K3.1 Pro | Claude Opus 5.5 | टिप्पणियाँ |
|---|---|---|---|
| HLE-Full with tools | 70.0% | 67.7% | वही प्रश्न, टूल्स की अनुमति |
| BrowseComp | 92.1% | 90.8% | वेब पर कठिन-से-पाई जाने वाली जानकारी |
| OfficeQA Pro v2 | 64.4 | 62.2 | वित्तीय PDFs पर संख्यात्मक विश्लेषण |
| Frontier Finance | 58.6 | 56.7 | निवेश वर्कफ़्लो, स्क्रीनिंग से लाभप्रदता तक |
| AutomationBench-AA | 73.3 | 69.5 | Artificial Analysis संस्करण, Zapier का नहीं |
| OSWorld V2.1 | 79.6% | 81.8% | डेस्कटॉप कंप्यूटर का संचालन |
| APEX-Agents | 67.2 | 73.5 | Mercor लीडरबोर्ड |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Kimi की जीतें खोज और वित्तीय दस्तावेज़ों पर छोटी पर सुसंगत हैं। Opus कंप्यूटर उपयोग और तृतीय-पक्ष एजेंट लीडरबोर्ड पर बढ़त बनाए रखता है, इसलिए रिसर्च एजेंट के रूप में Kimi K3.1 Pro बेहतर है और डेस्कटॉप व सामान्य ऑफिस एजेंट के रूप में Opus 5.5।
दोनों मॉडल समान आकार का कॉन्टेक्स्ट पढ़ते हैं, और दोनों हमेशा सोचते हैं: न Moonshot और न Anthropic आपको रीजनिंग बंद करने देते हैं। लेकिन डिफ़ॉल्ट अलग हैं। Kimi K3.1 Pro max effort पर चलता है जब तक आप low या high सेट न करें, जबकि Opus 5.5 का डिफ़ॉल्ट medium है, इसलिए बिना ट्यून किए Kimi कॉल हर अनुरोध पर अधिक रीजनिंग खर्च करता है।
व्यावहारिक तौर पर आउटपुट की सीमा बड़ा अंतर है। Kimi K3.1 Pro एक कॉल में पूरे कॉन्टेक्स्ट विंडो के बराबर आउटपुट लौटा सकता है, जो Batch API के बाहर Opus 5.5 की सीमा से लगभग आठ गुना है। Opus पर माइग्रेट कर रहे एजेंट बिल्डर्स को यह भी पता होना चाहिए कि अब फोर्स्ड टूल उपयोग 400 त्रुटि लौटाता है।
दोनों लैब्स ऑफेंसिव साइबर क्षमता को अलग-अलग तरीकों से थ्रॉटल करती हैं। Moonshot ने ओपन-वेट रिलीज़ के लिए मिड-ट्रेनिंग और RL से साइबर-संबंधित डेटा हटा दिया, जिससे उसके आंतरिक एक्सप्लॉइट बेंचमार्क 90.5% से गिरकर 81.0% रह गया। Anthropic Opus 5.5 में क्षमता बनाए रखता है और सर्विंग समय पर ज़्यादातर साइबरसिक्योरिटी अनुरोधों को Opus 4.8 पर रूट करता है।
ExploitBench पर Opus 91.0 स्कोर करता है जबकि Kimi 74.7, और Moonshot साफ़ कहता है कि K3.1 Pro साइबर पर डिजाइन से फ्रंटियर प्रॉपर्टायटरी मॉडलों से पीछे रहता है। इसका सौदा नियंत्रण है: वेट्स आने के बाद आप Kimi को अपने इन्फ्रास्ट्रक्चर पर चला सकते हैं, जो Opus नहीं देता।
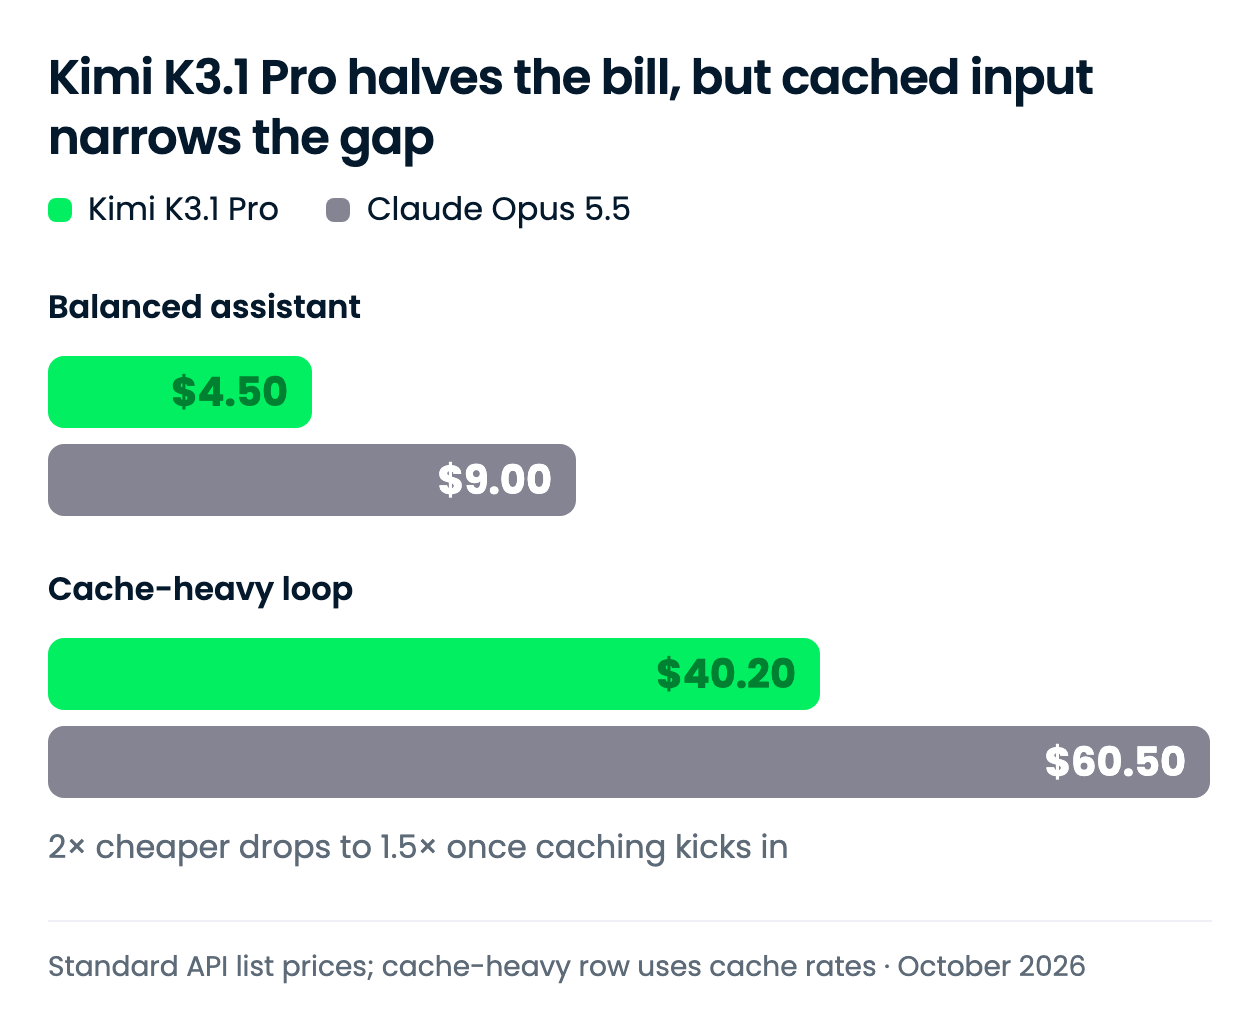
ताज़ा टोकनों पर Kimi K3.1 Pro, Opus 5.5 की आधी कीमत है। जब कोई वर्कलोड कैश्ड कॉन्टेक्स्ट पर चलता है, तो बचत घट जाती है, क्योंकि दोनों विक्रेता कैश रीड के लिए समान शुल्क लेते हैं।
सारी दरें प्रति 1M टोकन हैं, Moonshot और Anthropic के आधिकारिक प्राइसिंग पेजों से।
| दर | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| इनपुट, प्रति 1M टोकन | $2.00 | $4.00 |
| आउटपुट, प्रति 1M टोकन | $10.00 | $20.00 |
| कैश्ड इनपुट रीड, प्रति 1M टोकन | $0.20 | $0.20 |
| कैश राइट, 5-मिनट TTL | $2.00 | $5.00 |
| कैश राइट, 1-घंटा TTL | $4.00 | $8.00 |
| तेज़ वेरिएंट | K3.1 Pro Highspeed, 2–3x स्पीड: $4.00 / $20.00 | Fast मोड, अधिकतम 2.5x स्पीड: $8.00 / $40.00 |
मल्टिप्लायर एक-सा नहीं है: इनपुट, आउटपुट और 1-घंटा कैश राइट पर 0.5x, 5-मिनट कैश राइट पर 0.4x, और कैश रीड पर 1.0x। कोई भी विक्रेता लंबा-कॉन्टेक्स्ट सरचार्ज नहीं जोड़ता।
तालिका से दो विचित्रताएँ निकलती हैं। Kimi का Highspeed वेरिएंट ठीक वही लागत रखता है जो स्टैंडर्ड Opus की है। Anthropic का Batch API Opus की दरों को आधा कर $2 और $10 करता है, जो Kimi की स्टैंडर्ड दर से मेल खाता है, जबकि Moonshot के प्राइसिंग पेज पर बैच छूट सूचीबद्ध नहीं है।
मैंने दो मासिक वर्कलोड आकार चुने: एक बैलेंस्ड असिस्टेंट को स्केल एंकर के रूप में, और एक कैश-हेवी एजेंट लूप, क्योंकि कैश प्राइसिंग वहीं है जहाँ दोनों प्राइस लिस्ट अलग होती हैं।
| वर्कलोड | Kimi K3.1 Pro | Claude Opus 5.5 | अंतर |
|---|---|---|---|
| बैलेंस्ड असिस्टेंट: 1M इन / 250K आउट | $4.50 | $9.00 | $4.50 (Kimi 50% सस्ता) |
| कैश-हेवी लूप: 100K प्रीफ़िक्स एक बार लिखा, 1,000 कैश्ड रीड्स, साथ में प्रति रिक्वेस्ट 5K ताज़ा इन / 1K आउट | $40.20 | $60.50 | $20.30 (Kimi 34% सस्ता) |
प्रत्येक कुल (वॉल्यूम ÷ 1M) × दर है, जिसे इनपुट, आउटपुट, और कैश लाइनों पर जोड़ा गया; कैश-हेवी पंक्ति 5-मिनट कैश राइट का उपयोग करती है। बैलेंस्ड पंक्ति सरलता से 2x दर अंतर है।
कैश-हेवी पंक्ति वह है जिसके आधार पर योजना बनानी चाहिए। 100M कैश्ड टोकन दोनों मॉडलों पर $20 लागत रखते हैं, इसलिए केवल ताज़ा टोकन और कैश राइट पर Kimi की छूट मिलती है, और बचत लगभग एक-तिहाई पर आ जाती है। Anthropic कहता है कि कैश रीड्स एजेंटिक कोडिंग लागतों का अधिकांश हिस्सा बनाती हैं, इसलिए लंबे समय तक चलने वाले एजेंट पहले से अधिक इस पंक्ति के क़रीब आएँगे।
दोनों मॉडल अलग टोकनाइज़र उपयोग करते हैं, और किसी साझा वर्कलोड के लिए किसी विक्रेता ने टोकन काउंट प्रकाशित नहीं किया है, इसलिए इन कुलों को बिल के बजाय दर तुलना के रूप में मानें।
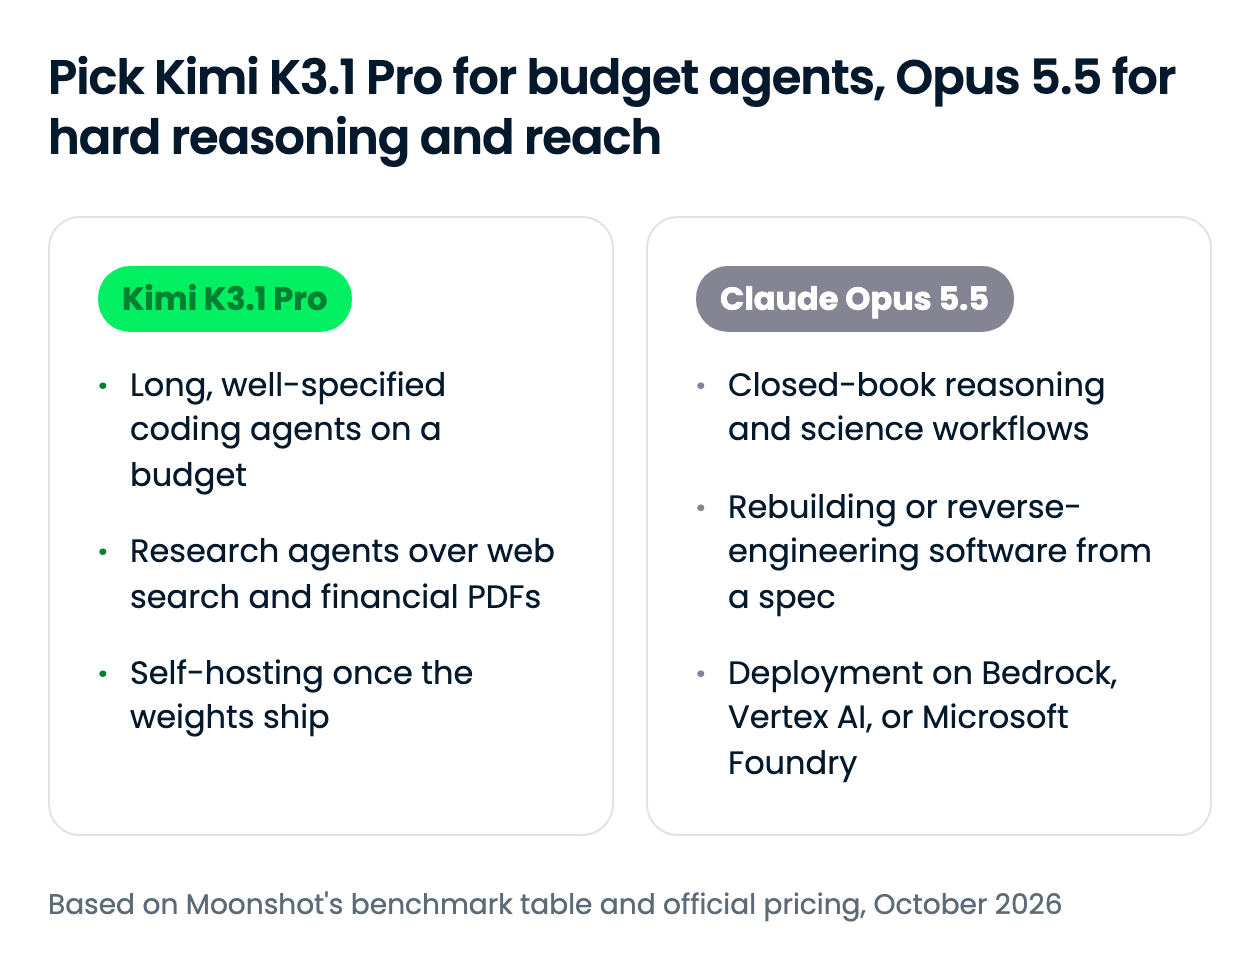
चयन कीमत बनाम विस्तार पर टिका है: Kimi K3.1 Pro प्रति-टोकन दर आधी करता है, और Opus 5.5 वे तर्क-आधारित मामले और क्लाउड प्लेटफ़ॉर्म कवर करता है जहाँ Kimi पीछे है। यदि आपका एजेंट अधिकतर कैश्ड कॉन्टेक्स्ट पर चलता है, तो बचत आधी के बजाय लगभग एक-तिहाई होगी।
आप दोनों मॉडलों को आज उनकी अपनी APIs या OpenRouter के माध्यम से कॉल कर सकते हैं, और Opus 5.5 Amazon Bedrock, Vertex AI, और Microsoft Foundry पर भी चलता है।
| सर्फ़ेस | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| कंज्यूमर ऐप | Kimi.com, Kimi मोबाइल ऐप्स, Kimi Work डेस्कटॉप ऐप | Claude ऐप्स (Pro, Max, Team, Enterprise) |
| फ़र्स्ट-पार्टी API | Kimi API (OpenAI-कम्पैटिबल) | Claude API |
| क्लाउड प्लेटफ़ॉर्म | 29 Oct 2026 तक Azure AI Foundry या Amazon Bedrock पर उपलब्ध नहीं | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| कोडिंग एजेंट्स | Kimi Code (29 Oct 2026 तक GitHub Copilot और Cursor में उपलब्ध नहीं) | Claude Code, Cursor, GitHub Copilot |
| थर्ड-पार्टी राउटर्स | OpenRouter | OpenRouter |
| ओपन वेट्स | 4 नवंबर, 2026 तक अपेक्षित | नहीं |
| API मॉडल ID | kimi-k3.1-pro |
claude-opus-5-5 |
कई टीमों के लिए पहुँच का अंतर निर्णायक होता है: Opus 5.5 हर प्रमुख क्लाउड पर और मुख्यधारा के कोडिंग एजेंट्स में है, जबकि Kimi K3.1 Pro वेट्स आने तक केवल Moonshot की अपनी सतहों और OpenRouter पर पुष्टि हुई है। फ़र्स्ट-पार्टी APIs पर मॉडल IDs kimi-k3.1-pro और claude-opus-5-5 हैं; OpenRouter पर वे moonshotai/kimi-k3.1-pro और anthropic/claude-opus-5.5 हैं।
OpenRouter का OpenAI-कम्पैटिबल एंडपॉइंट दोनों मॉडलों को एक-स्ट्रिंग स्वैप बना देता है, जो आपके अपने प्रॉम्प्ट्स पर A/B टेस्ट का सबसे आसान तरीका है।
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
हमारा Opus 5.5 API ट्यूटोरियल Claude पक्ष पर और गहराई में जाता है, और OpenCode पर हमारा एक्सप्लेनर दिखाता है कि किसी भी मॉडल को ओपन-सोर्स कोडिंग एजेंट में कैसे प्लग करें।
Kimi K3.1 Pro टर्मिनल कोडिंग में Claude Opus 5.5 की बराबरी करता है और लंबे, टूल-भारी एजेंट रन पर उसे मात देता है, वह भी उल्लेखनीय छूट पर। यदि आपके एजेंट लंबे, अच्छी-तरह परिभाषित कार्य टूल्स के साथ चलाते हैं, तो Kimi लें; यदि वे बिना मदद के तर्क करते हैं, धुँधले स्पेक्स का पीछा करते हैं, या AWS, Google Cloud, या Azure पर रहने होते हैं, तो Opus लें।
मेरे लिए सबसे दिलचस्प यह है कि दोनों लैब्स एक ही जोखिम को कितने अलग तरीके से संभालती हैं: Moonshot वेट्स प्रकाशित करने से पहले साइबर क्षमता को काट देता है, और Anthropic इसे मॉडल में रखता है और सर्विंग समय पर गेट करता है। मैं Kimi को OpenRouter के माध्यम से टेस्ट करूँगा और नवंबर में वेट्स और लाइसेंस आने पर सेल्फ-होस्टिंग पर फिर विचार करूँगा।
यदि आप ऐसे मॉडलों से निर्माण करने के इच्छुक हैं, तो मैं हमारे Associate AI Engineer for Developers ट्रैक को देखने की सलाह देता हूँ।
DataCamp के साथ AI सीखें!
लर्निंग पाथ
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें