

学习路径
面向开发者的 AI 工程师助理
26 小时
实践并学习路径你的进步。
使用 Google 继续Moonshot AI 于 2026 年 10 月发布了 Kimi K3.1 Pro,并给出了一个不同寻常的具体承诺:在 Terminal-Bench 4.0 上,这款新的开放权重模型与 Anthropic 于 9 月 22 日发布的旗舰 Claude Opus 5.5 相差不到 1 分。同时,它的每 token 价格仅为 Anthropic 的一半,Moonshot 承诺将于 11 月 4 日前提供可下载的权重。
在本文中,我将从自主编码、推理、重工具的代理任务、安全控制,以及各自的实际运行成本等方面,对 Kimi K3.1 Pro 与 Claude Opus 5.5 进行对比。
如果您对新模型发布感兴趣,也别错过我们对 Google 最新旗舰的指南:Gemini 4 Carbon 和 Genie 4。为便于及时了解最新 AI 动态,我也推荐订阅我们的周报 The Median。
Kimi K3.1 Pro 是 Moonshot AI 的旗舰模型,于 2026 年 10 月发布,基于 Kimi K3 后训练版本,承诺在 11 月 4 日前提供开放权重。
其卖点是大规模强化学习:Moonshot 在数百个下游领域进行联合 RL,优势主要体现在长时程编码、金融研究与 3D 创作。
我们的 Kimi K3.1 Pro 指南对发布进行了完整解读。
Claude Opus 5.5 是 Anthropic 的闭源旗舰,也是 Claude 5.5 系列的首款模型,于 2026 年 9 月 22 日发布。
Anthropic 将其定位为:在多数任务上接近 Claude Fable 5.1 的表现、价格低于 Opus 5,并在其自动化对齐审计中拿到迄今最佳分数。
我们的 Claude Opus 5.5 指南覆盖了发布内容;我们的 Opus 5.5 API 教程演示了如何构建 AI 事件调查员。
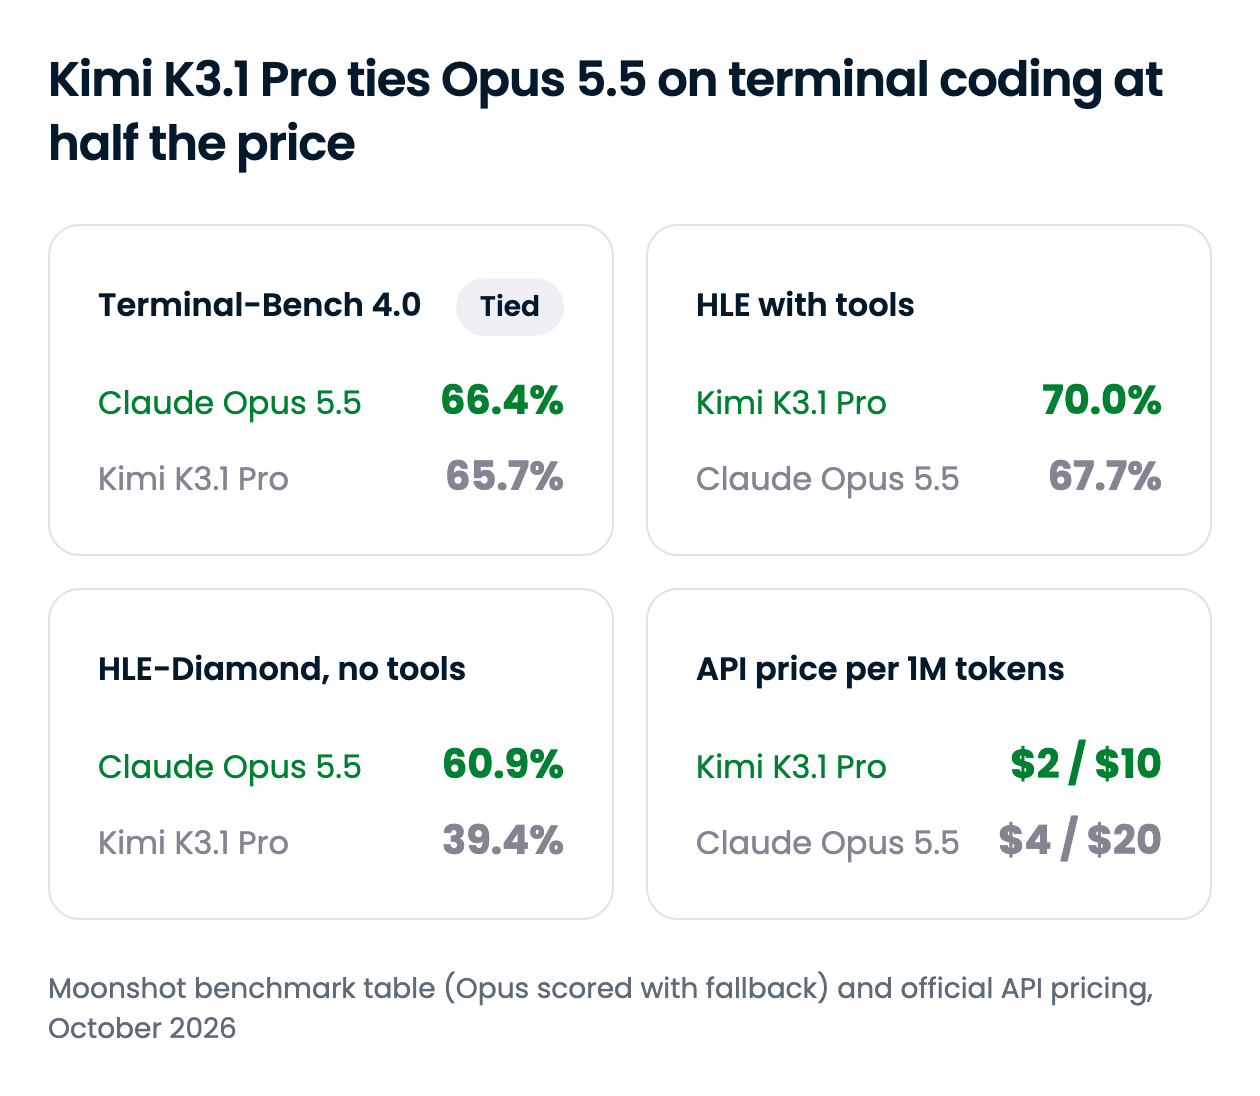
Kimi K3.1 Pro 在价格与依赖工具的代理任务上更胜一筹;而在需要无辅助推理或解决规格不明确的问题时,Opus 5.5 占优。下方摘要覆盖各个维度,后续章节将深入探讨可能影响决策的差异点。
| 特性 | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| 开发方 | Moonshot AI | Anthropic |
| 发布时间 | 2026 年 10 月 | 2026 年 9 月 22 日 |
| 权重 | 开放权重预计 2026 年 11 月 4 日前发布(许可证尚未公布) | 闭源 |
| 上下文窗口 | 100 万 tokens | 100 万 tokens |
| 最大输出 | 最多 1,048,576 tokens(默认 131,072) | 128K tokens(批处理 API 可达 300K,测试中) |
| Terminal-Bench 4.0 | 65.7% | 66.4% |
| 长时程编码(SWE-Marathon v1.1) | 51.7% | 46.3% |
| 闭卷推理(HLE-Diamond) | 39.4% | 60.9% |
| 工具辅助推理(HLE with tools) | 70.0% | 67.7% |
| 进攻性网络安全(ExploitBench) | 74.7 | 91.0 |
| API 价格 | 输入与输出均为 Opus 5.5 的一半 | 基准 |
| 可运行位置 | Kimi API、Kimi 应用、OpenRouter | Claude API、Claude 应用、AWS、Google Cloud、Azure、主流编码代理 |
本节所有分数均有一条共同的注意事项:正面对比数字来自 Moonshot 自己的基准表,其中将每个 Opus 5.5 的结果标注为“带回退”。Anthropic 的安全机制会把部分网络安全与生物任务转交给其他 Claude 模型(分别是 Opus 4.8 和 Opus 5),这可能拉低了这些分数。
两款模型在 Terminal-Bench 4.0 上基本持平,但这个标题之下实则分野明显。Kimi K3.1 Pro 在长时程任务上领先,而在开放式任务中,Opus 5.5 以较大优势领先。
差距最大的是 ProgramBench,它要求模型基于二进制与规格重建程序。Opus 5.5 将 65.0% 的任务推进到至少 95% 的测试通过,而 Kimi K3.1 Pro 为 31.5%,不到其一半。
| 基准 | Kimi K3.1 Pro | Claude Opus 5.5 | 备注 |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | Kimi 在 Claude Code 框架中运行;Opus 按 Anthropic 为 xhigh 努力度 |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 数小时级工程任务 |
| DeepSWE v1.1 | 75.5% | 74.2% | 各实验室自有设置,视作平手 |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | 58.5% | Moonshot 内部基准 |
| ProgramBench(二进制评分) | 31.5% | 65.0% | 达到至少 95% 的任务占比 |
| Terminal-Bench Science 0.1 | 38.1% | 63.3% | Anthropic 自己的表中 Opus 为 58.7% |
| PostTrainBench v1.2 | 36.5% | 43.8% | Kimi 运行在 H20 GPU 而非 H100 |
| BenchCAD with tools | 92.7% | 96.2% | 通过 CAD 代码进行 3D 重建 |
这一模式相当一致。给 Kimi K3.1 Pro 明确的工程任务和足够的时间,它就会持续推进:Moonshot 的展示案例是它在 167 个任务中修复了一个人体行走模拟器肩部肌肉计算的 36 个错误。Anthropic 的对应故事是将 HAProxy 从 C 迁移至 Rust,并通过了几乎所有 HAProxy 自身的回归测试。
当规格不充分时,Opus 会拉开差距。ProgramBench、科学研究工作流与后训练实验都需要先弄清任务本身,这正是 Kimi 的长跑耐力不再奏效之处。
对于长时程、规格明确的编码代理,Kimi K3.1 Pro 是真正的替代方案;而在逆向工程、研究型代码与模糊需求上,Opus 5.5 更稳妥。
拿走工具后,Opus 5.5 优势明显。差距最大的是 HLE-Diamond(“人类最后考试”中最难的 1,000 题子集),Opus 得分 60.9%,Kimi 为 39.4%。
| 基准 | Kimi K3.1 Pro | Claude Opus 5.5 | 备注 |
|---|---|---|---|
| HLE-Full | 51.1% | 59.8% | 2,500 题,禁用工具 |
| HLE-Diamond | 39.4% | 60.9% | 最难的 1,000 题 |
| GPQA-Diamond | 94.2% | 93.9% | 接近饱和;判作平手 |
| MMMU-Pro | 84.1% | 87.7% | 图像与文本混合问题 |
| Kimi Hallu Bench(越低越好) | 5.4% | 6.8% | Moonshot 内部;声明级幻觉率 |
两者在 GPQA-Diamond 上打平,因其已接近天花板,难以拉开差距。Kimi 较低的幻觉率来自 Moonshot 的内部压力测试,我更倾向将其视为事实准确性工作的落地信号,而非正面对比的裁决。就闭卷推理而言,Opus 5.5 更强。
同时交给两者工具后,推理结果出现反转。在允许工具的“人类最后考试”中,Kimi K3.1 Pro 得分 70.0%,Opus 为 67.7%,且它在 Moonshot 的多数研究与文档类指标上领先。
| 基准 | Kimi K3.1 Pro | Claude Opus 5.5 | 备注 |
|---|---|---|---|
| HLE-Full with tools | 70.0% | 67.7% | 相同题目,允许工具 |
| BrowseComp | 92.1% | 90.8% | 难以检索的网页信息 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 跨金融 PDF 的数值分析 |
| Frontier Finance | 58.6 | 56.7 | 投资工作流:从筛选到盈利能力 |
| AutomationBench-AA | 73.3 | 69.5 | Artificial Analysis 版本,非 Zapier |
| OSWorld V2.1 | 79.6% | 81.8% | 操作桌面计算机 |
| APEX-Agents | 67.2 | 73.5 | Mercor 排行 |
| AA-Briefcase v1.1(Elo) | 1678 | 1803 | Artificial Analysis |
Kimi 在搜索与金融文档上小幅但稳定领先。Opus 则在计算机使用与第三方代理榜单上保持优势。因此,Kimi K3.1 Pro 更适合做研究代理,Opus 5.5 更适合桌面与通用办公代理。
两者的上下文大小相同,且都会进行“思考”:Moonshot 与 Anthropic 均不允许关闭推理。但默认设置不同。Kimi K3.1 Pro 默认为 max 努力度,除非您设为 low 或 high;而 Opus 5.5 默认为 medium,因此在未调优的情况下,Kimi 每次请求会花费更多推理。
更实际的差异在于输出上限。Kimi K3.1 Pro 能在一次调用中返回接近完整上下文窗口的输出,约为 Opus 5.5 在非批处理 API 场景下上限的八倍。迁移至 Opus 的代理构建者也需注意,强制使用工具现在会返回 400 错误。
两家都对进攻性网络安全能力进行限速,但方式相反。Moonshot 为开放权重发布,在中期训练与 RL 中移除了与网络安全相关的数据,使其内部漏洞利用基准从 90.5% 降至 81.0%。Anthropic 则在 Opus 5.5 中保留该能力,并在服务时将多数网络安全请求重路由至 Opus 4.8。
在 ExploitBench 上,Opus 以 91.0 对 74.7 领先,Moonshot 也直言 K3.1 Pro 在网络安全方面有意落后于前沿专有模型。权衡在于可控性:一旦权重发布,您可在自有基础设施上运行 Kimi,这是 Opus 不提供的。
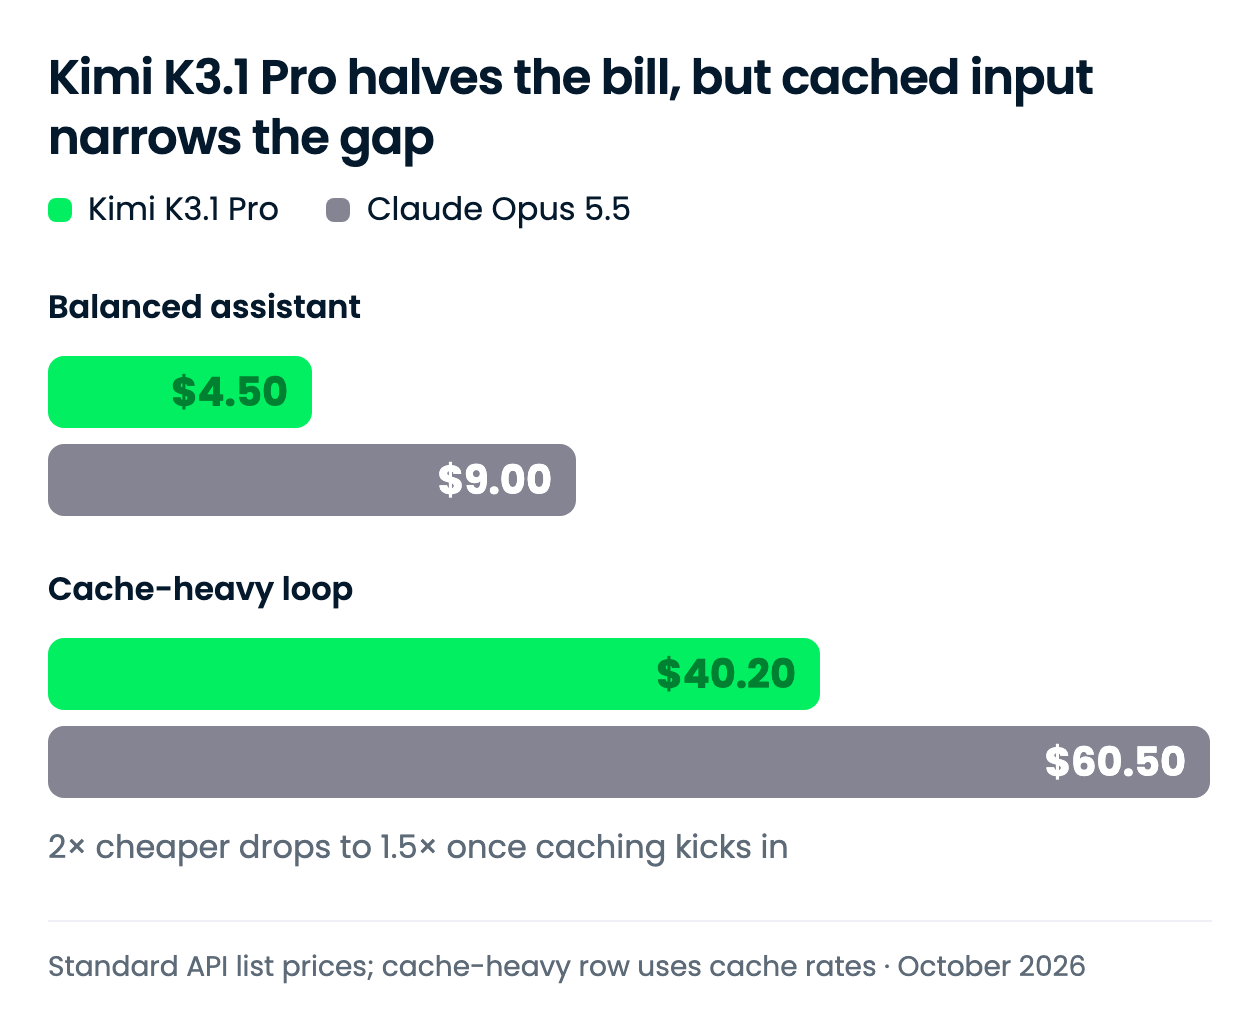
Kimi K3.1 Pro 在新增 tokens 上的价格是 Opus 5.5 的一半。当工作负载主要依赖缓存上下文时,节省幅度会缩小,因为两家对缓存读取的收费相同。
所有费率均为每 100 万 tokens,来自 Moonshot 与 Anthropic 的官方定价页。
| 费率 | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| 输入,每 100 万 tokens | $2.00 | $4.00 |
| 输出,每 100 万 tokens | $10.00 | $20.00 |
| 缓存输入读取,每 100 万 tokens | $0.20 | $0.20 |
| 缓存写入,5 分钟 TTL | $2.00 | $5.00 |
| 缓存写入,1 小时 TTL | $4.00 | $8.00 |
| 更快的变体 | K3.1 Pro Highspeed,2–3 倍速度:$4.00 / $20.00 | 快速模式,最高 2.5 倍速度:$8.00 / $40.00 |
倍数并不完全一致:输入、输出与 1 小时缓存写入为 0.5 倍,5 分钟缓存写入为 0.4 倍,缓存读取为 1.0 倍。两家都不对长上下文加收附加费。
表格带出两点小差异。Kimi 的 Highspeed 变体费用恰好等于 Opus 标准价。Anthropic 的批处理 API 将 Opus 价格减半至 $2 和 $10,与 Kimi 标准价持平,而 Moonshot 的定价页未列出批量折扣。
我选了两种月度工作负载形态:一个均衡助手作为规模锚点,以及一个重缓存的代理循环,因为两者在缓存定价上存在差异。
| 工作负载 | Kimi K3.1 Pro | Claude Opus 5.5 | 差额 |
|---|---|---|---|
| 均衡助手:100 万入 / 25 万出 | $4.50 | $9.00 | $4.50(Kimi 便宜 50%) |
| 重缓存循环:10 万前缀写入一次,缓存读取 1,000 次;每次另有 5K 新输入 / 1K 输出 | $40.20 | $60.50 | $20.30(Kimi 便宜 34%) |
每个总价为(用量 ÷ 100 万)× 费率,按输入、输出与缓存项分别求和;重缓存一行使用 5 分钟缓存写入。均衡一行基本体现了 2 倍费率差。
需要重点规划的是重缓存一行。1 亿缓存 tokens 在任一模型上都要 $20,因此只有新增 tokens 与缓存写入享受 Kimi 的折扣,节省降至约三分之一。Anthropic 表示缓存读取占据了自主编码成本的大头,因此长时间运行的代理更接近后一行的结果。
两者使用不同的 tokenizer,且都未公布相同工作负载下的 token 统计,因此将这些总价视为费率对比而非最终账单。
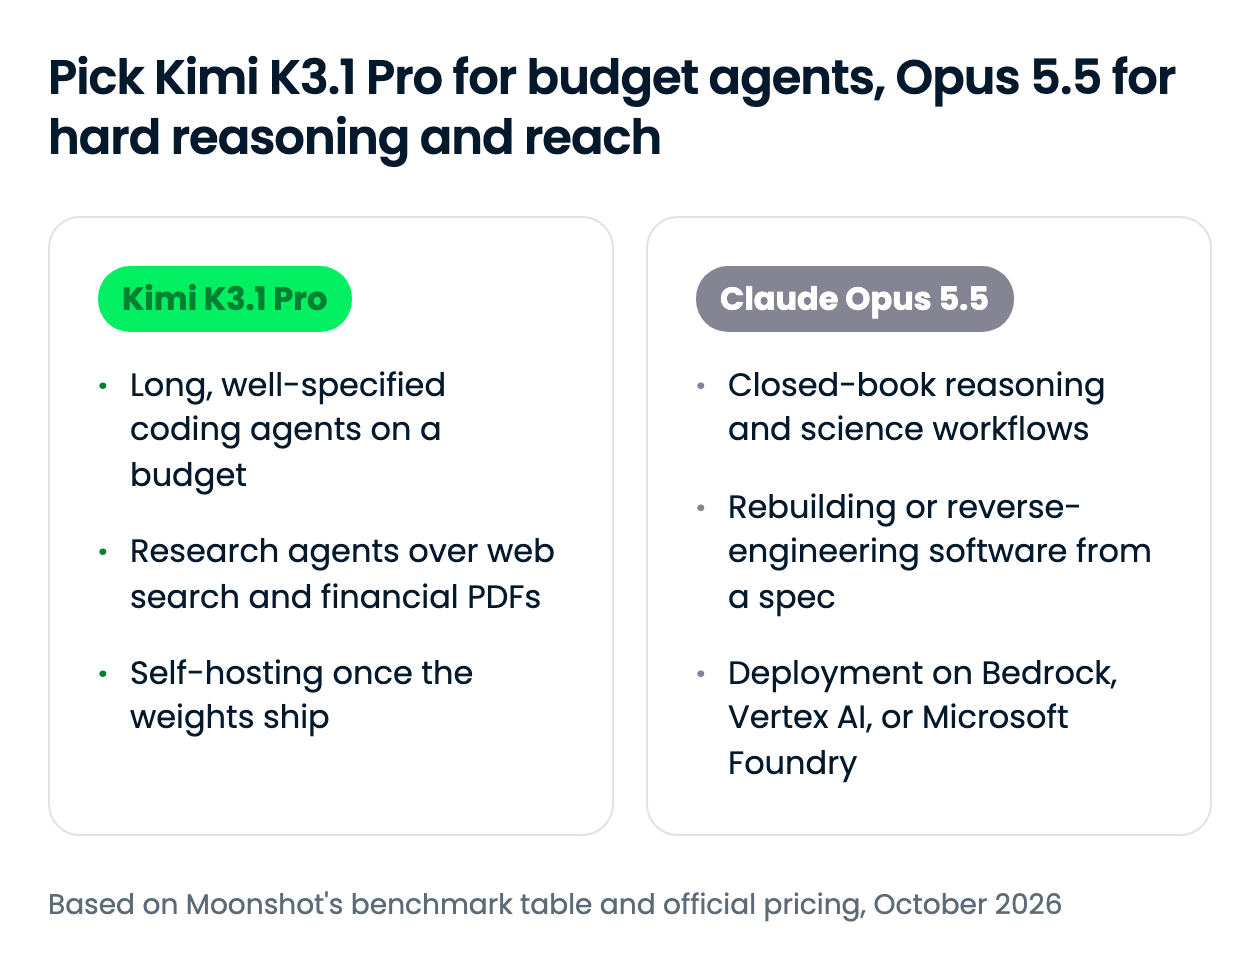
抉择在于价格与覆盖面的取舍:Kimi K3.1 Pro 将每 token 费率砍半,而 Opus 5.5 覆盖了 Kimi 落后的推理场景与 Kimi 尚未确认的云平台。如果您的代理主要运行在缓存上下文上,节省更接近三分之一而非一半。
您今天即可通过两者的官方 API 或 OpenRouter 调用两款模型;Opus 5.5 也可在 Amazon Bedrock、Vertex AI 与 Microsoft Foundry 上运行。
| 使用入口 | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| 消费级应用 | Kimi.com、Kimi 移动应用、Kimi Work 桌面应用 | Claude 应用(Pro、Max、Team、Enterprise) |
| 一方 API | Kimi API(兼容 OpenAI) | Claude API |
| 云平台 | 截至 2026 年 10 月 29 日,尚未在 Azure AI Foundry 或 Amazon Bedrock 上线 | Amazon Bedrock、Vertex AI、Microsoft Foundry |
| 编码代理 | Kimi Code(截至 2026 年 10 月 29 日,尚未在 GitHub Copilot 与 Cursor 中提供) | Claude Code、Cursor、GitHub Copilot |
| 第三方路由 | OpenRouter | OpenRouter |
| 开放权重 | 预计 2026 年 11 月 4 日前发布 | 无 |
| API 模型 ID | kimi-k3.1-pro |
claude-opus-5-5 |
对许多团队而言,覆盖面的差异是关键:Opus 5.5 已登陆各大云与主流编码代理,而 Kimi K3.1 Pro 在权重发布前,仅确认可在 Moonshot 自有入口与 OpenRouter 使用。在一方 API 上,模型 ID 分别为 kimi-k3.1-pro 与 claude-opus-5-5;在 OpenRouter 上分别为 moonshotai/kimi-k3.1-pro 与 anthropic/claude-opus-5.5。
OpenRouter 的 OpenAI 兼容端点让两款模型只需替换一个字符串即可 A/B 测试您自己的提示。
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
我们的 Opus 5.5 API 教程更深入介绍了 Claude 侧的用法;我们的 OpenCode 解析则展示了如何将任一模型接入开源编码代理。
Kimi K3.1 Pro 在终端编码上与 Claude Opus 5.5 持平,并在长时程、重工具的代理任务中胜出,且价格更实惠。若您的代理运行的是规格明确、配合工具的长任务,请用 Kimi;若需无辅助推理、应对模糊规格,或必须部署在 AWS、Google Cloud、Azure 上,请用 Opus。
我觉得最有意思的是两家在同一风险上的不同处理方式:Moonshot 在发布权重前直接从权重中剔除网络安全能力;Anthropic 则将其保留在模型内,并在服务时加以门控。我会先通过 OpenRouter 测试 Kimi,待 11 月权重与许可证落地后再评估自托管。
如果您希望用这类模型进行构建,推荐查看我们的 面向开发者的初级 AI 工程师学习路径。
与 DataCamp 一起学习 AI!
学习路径
课程
实践并学习路径你的进步。
使用 Google 继续