

Ścieżka
Inżynier AI Associate dla programistów
26 godz.
Ćwicz i monitoruj swoje postępy.
Kontynuuj Z GoogleMoonshot AI wypuścił Kimi K3.1 Pro w październiku 2026 r. z niezwykle konkretną deklaracją: w Terminal-Bench 4.0 jego nowy model z otwartymi wagami plasuje się o punkt od Claude Opus 5.5, flagowca Anthropic z 22 września. Robi to za połowę ceny za token w porównaniu z Anthropic, a Moonshot zapowiada możliwość pobrania wag do 4 listopada.
W tym artykule porównam Kimi K3.1 Pro i Claude Opus 5.5 pod kątem agentowego kodowania, rozumowania, pracy agentów mocno korzystających z narzędzi, kontroli bezpieczeństwa oraz realnych kosztów uruchomienia.
Jeśli interesują cię nowe premiery modeli, koniecznie zajrzyj też do naszych przewodników po najnowszych flagowcach Google: Gemini 4 Carbon i Genie 4. To, by być na bieżąco z najnowszymi wiadomościami o AI, polecam też nasz cotygodniowy newsletter The Median.
Kimi K3.1 Pro to flagowy model Moonshot AI, wydany w październiku 2026 r. jako potrenowana wersja Kimi K3 z zapowiedzianymi otwartymi wagami do 4 listopada.
Jego atutem jest RL na dużą skalę: Moonshot prowadził wspólne RL w setkach docelowych domen, co najbardziej widać w długohoryzontalnym kodowaniu, badaniach finansowych i tworzeniu 3D.
Nasz przewodnik po Kimi K3.1 Pro omawia premierę w całości.
Claude Opus 5.5 to zamknięty flagowiec Anthropic i pierwszy model z rodziny Claude 5.5, wydany 22 września 2026 r.
Anthropic pozycjonuje go jako wydajność na poziomie Claude Fable 5.1 w większości zadań przy niższej cenie niż Opus 5, z najlepszymi wynikami w ich zautomatyzowanym audycie alignmentu.
Nasz przewodnik po Claude Opus 5.5 opisuje premierę; nasz tutorial API Opus 5.5 pokazuje, jak zbudować agenta do badania incydentów AI.
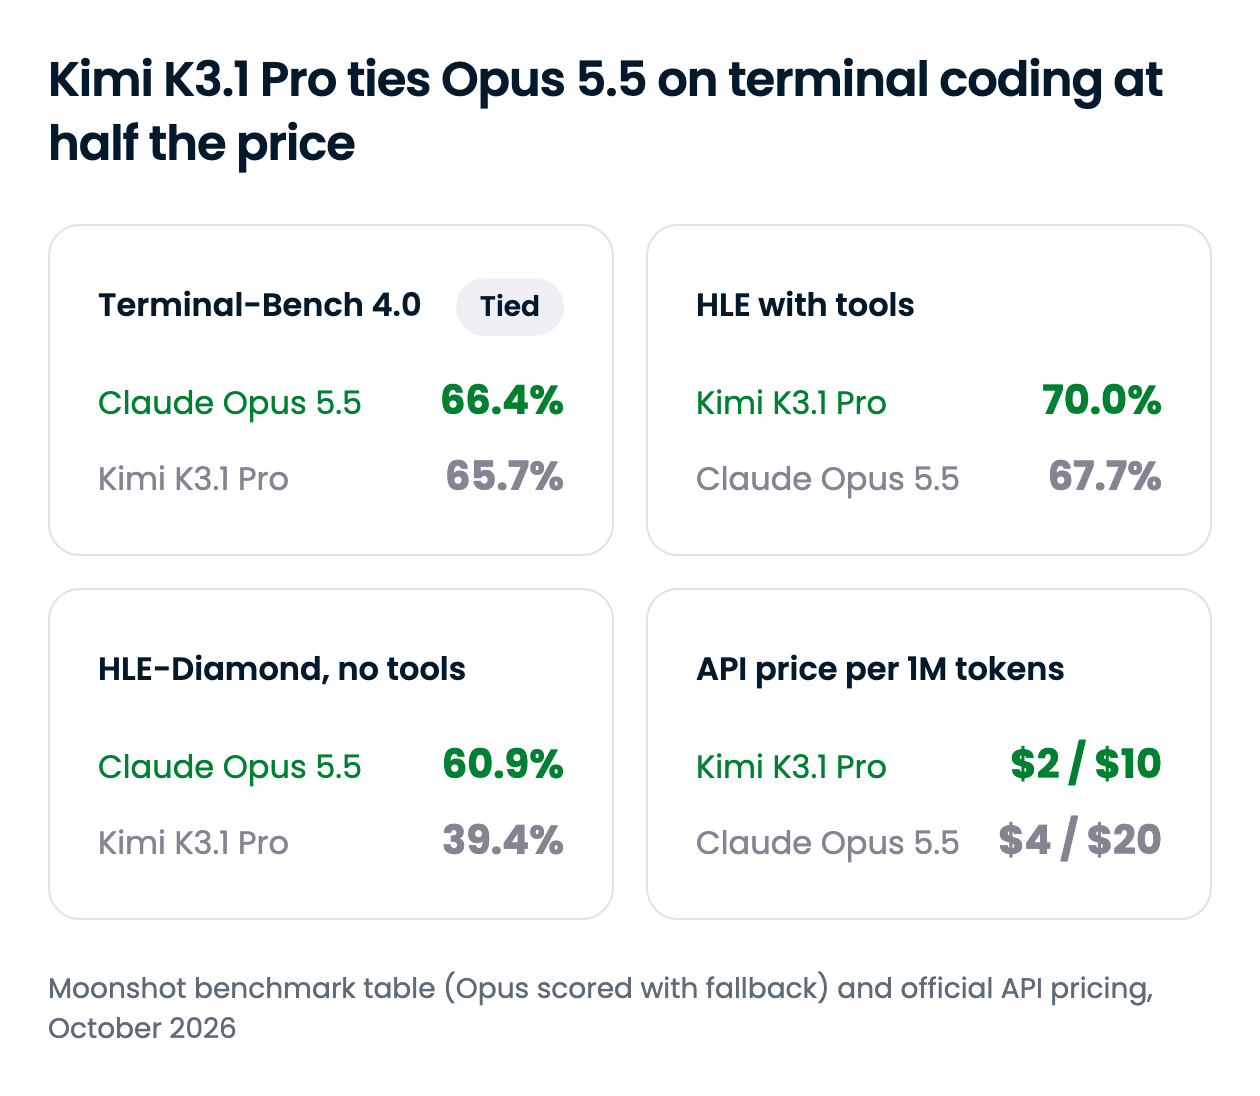
Kimi K3.1 Pro wygrywa ceną i w pracy agentów silnie korzystających z narzędzi; Opus 5.5 wygrywa wszędzie tam, gdzie model musi rozumować bez wsparcia lub rozgryźć niedookreślony problem. Poniższe zestawienie obejmuje wszystkie wymiary, a dalsze sekcje rozwijają te, które mogą zmienić decyzję.
| Cecha | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Deweloper | Moonshot AI | Anthropic |
| Premiera | Październik 2026 | 22 września 2026 |
| Wagi | Otwarte wagi mają się ukazać do 4 listopada 2026 (licencja jeszcze nie ogłoszona) | Zamknięte |
| Okno kontekstu | 1M tokenów | 1M tokenów |
| Maks. output | Do 1 048 576 tokenów (domyślnie 131 072) | 128K tokenów (300K w Batch API, beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Długohoryzontalne kodowanie (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Rozumowanie bez źródeł (HLE-Diamond) | 39,4% | 60,9% |
| Rozumowanie z narzędziami (HLE z narzędziami) | 70,0% | 67,7% |
| Ofensywny cyber (ExploitBench) | 74,7 | 91,0 |
| Cena API | Połowa stawki Opus 5.5 na wejściu i wyjściu | Poziom bazowy |
| Gdzie uruchomisz | API Kimi, aplikacje Kimi, OpenRouter | API Claude, aplikacje Claude, AWS, Google Cloud, Azure, główne agenty do kodu |
Jedno zastrzeżenie dotyczy każdego wyniku w tej sekcji. Liczby head-to-head pochodzą z tabeli benchmarków Moonshot i przy każdym wyniku Opus 5.5 widnieje dopisek „with fallback”: zabezpieczenia Anthropic przekazują część zadań z cyber i biologii do innych modeli Claude (Opus 4.8 i Opus 5), co prawdopodobnie zaniża te wyniki.
Oba modele są praktycznie równe w Terminal-Bench 4.0, ale ten nagłówek maskuje realny rozjazd pod spodem. Kimi K3.1 Pro prowadzi w wierszach z długim horyzontem, a Opus 5.5 wyraźnie wygrywa tam, gdzie zadanie jest otwarte.
Największa różnica to ProgramBench, gdzie model ma odtworzyć program z jego binarki i specyfikacji. Opus 5.5 doprowadza 65,0% zadań do co najmniej 95% zaliczonych testów, podczas gdy Kimi K3.1 Pro osiąga 31,5%, mniej niż połowę.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Uwagi |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi uruchomione w harnessie Claude Code; Opus przy xhigh effort wg Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Wielogodzinne zadania inżynieryjne |
| DeepSWE v1.1 | 75,5% | 74,2% | Własne konfiguracje laboratoriów, więc traktuj jako remis |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | 58,5% | Wewnętrzny benchmark Moonshot |
| ProgramBench (wynik binarny) | 31,5% | 65,0% | Udział zadań z wynikiem co najmniej 95% |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | Tabela Anthropic raportuje 58,7% dla Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi uruchomione na GPU H20 zamiast H100 |
| BenchCAD z narzędziami | 92,7% | 96,2% | Rekonstrukcja 3D przez kod CAD |
Wzorzec jest spójny. Daj Kimi K3.1 Pro dobrze zdefiniowane zadanie inżynieryjne i dużo czasu, a będzie parło naprzód: pokaz Moonshotu to naprawa 36 błędów w obliczeniach mięśni barku w symulatorze chodu człowieka w 167 misjach. Odpowiednikiem Anthropic jest tłumaczenie HAProxy z C na Rusta, które przeszło niemal wszystkie testy regresji HAProxy.
Gdy spec jest szczupła, Opus odjeżdża. ProgramBench, naukowe workflowy badawcze i eksperymenty post-trainingowe wymagają najpierw doprecyzowania samego zadania — i tu długodystansowa wytrzymałość Kimi przestaje się opłacać.
Do długich, dobrze określonych agentów kodujących Kimi K3.1 Pro to realna alternatywa; do reverse engineeringu, kodu badawczego i „fuzzy” ticketów bezpieczniejszy jest Opus 5.5.
Bez narzędzi Opus 5.5 prowadzi wyraźnie. Najszersza różnica jest w HLE-Diamond, najtrudniejszym, 1000-pytaniowym podzbiorze Humanity’s Last Exam: Opus ma 60,9% wobec 39,4% Kimi.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Uwagi |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2 500 pytań, bez narzędzi |
| HLE-Diamond | 39,4% | 60,9% | Najtrudniejsze 1000 pytań |
| GPQA-Diamond | 94,2% | 93,9% | Blisko sufitu; remis |
| MMMU-Pro | 84,1% | 87,7% | Pytania obraz + tekst |
| Kimi Hallu Bench (niżej = lepiej) | 5,4% | 6,8% | Wewnętrzny Moonshot; odsetek halucynacji na poziomie twierdzeń |
Remisują w GPQA-Diamond, które jest zbyt blisko sufitu, by kogoś odróżnić. Niższy wskaźnik halucynacji Kimi pochodzi z wewnętrznego testu Moonshot — potraktowałbym to raczej jako sygnał, że prace nad faktografią przyniosły efekt, niż werdykt head-to-head. Do rozumowania bez źródeł mocniejszy jest Opus 5.5.
Gdy oba modele dostają narzędzia, wynik w rozumowaniu się odwraca. W Humanity’s Last Exam z narzędziami Kimi K3.1 Pro ma 70,0% wobec 67,7% Opusa i prowadzi w większości wierszy Moonshot dotyczących researchu i dokumentów.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Uwagi |
|---|---|---|---|
| HLE-Full z narzędziami | 70,0% | 67,7% | Te same pytania, z narzędziami |
| BrowseComp | 92,1% | 90,8% | Trudne do znalezienia informacje w sieci |
| OfficeQA Pro v2 | 64,4 | 62,2 | Analiza liczbowa na finansowych PDF-ach |
| Frontier Finance | 58,6 | 56,7 | Workflows inwestycyjne, od screeningu do rentowności |
| AutomationBench-AA | 73,3 | 69,5 | Wersja Artificial Analysis, nie Zapiera |
| OSWorld V2.1 | 79,6% | 81,8% | Obsługa komputera stacjonarnego |
| APEX-Agents | 67,2 | 73,5 | Leaderboard Mercor |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Wygrane Kimi są małe, ale konsekwentne w wyszukiwaniu i dokumentach finansowych. Opus zachowuje przewagę w obsłudze komputera i na zewnętrznych leaderboardach agentów, więc Kimi K3.1 Pro to lepszy agent badawczy, a Opus 5.5 — lepszy agent biurowy i desktopowy.
Oba modele czytają taki sam kontekst i oba zawsze „myślą”: ani Moonshot, ani Anthropic nie pozwala wyłączyć rozumowania. Różnią się jednak domyślne ustawienia. Kimi K3.1 Pro działa przy wysiłku max, chyba że ustawisz low lub high, podczas gdy Opus 5.5 domyślnie ma medium, więc nietuningowane wywołanie Kimi zużywa więcej rozumowania na prośbę.
Praktycznie większa różnica to sufit wyjścia. Kimi K3.1 Pro może zwrócić w jednej odpowiedzi pełne okno kontekstu — mniej więcej osiem razy więcej niż limit Opus 5.5 poza Batch API. Twórcy agentów migrujący do Opusa powinni też wiedzieć, że wymuszone użycie narzędzia zwraca teraz błąd 400.
Oba laboratoria dławią ofensywne możliwości cyber, ale w przeciwny sposób. Moonshot usunął dane związane z cyber z fazy mid-training i RL na potrzeby wydania otwartych wag, co ścięło wewnętrzny benchmark exploitów z 90,5% do 81,0%. Anthropic zachowuje tę zdolność w Opus 5.5 i przekierowuje większość próśb z cyberbezpieczeństwa do Opus 4.8 w czasie serwowania.
W ExploitBench Opus ma 91,0 wobec 74,7 Kimi, a Moonshot wprost mówi, że K3.1 Pro z założenia pozostaje za czołowymi modelami własnościowymi w cyber. W zamian dostajesz kontrolę: gdy wagi się pojawią, uruchomisz Kimi na własnej infrastrukturze, czego Opus nie oferuje.
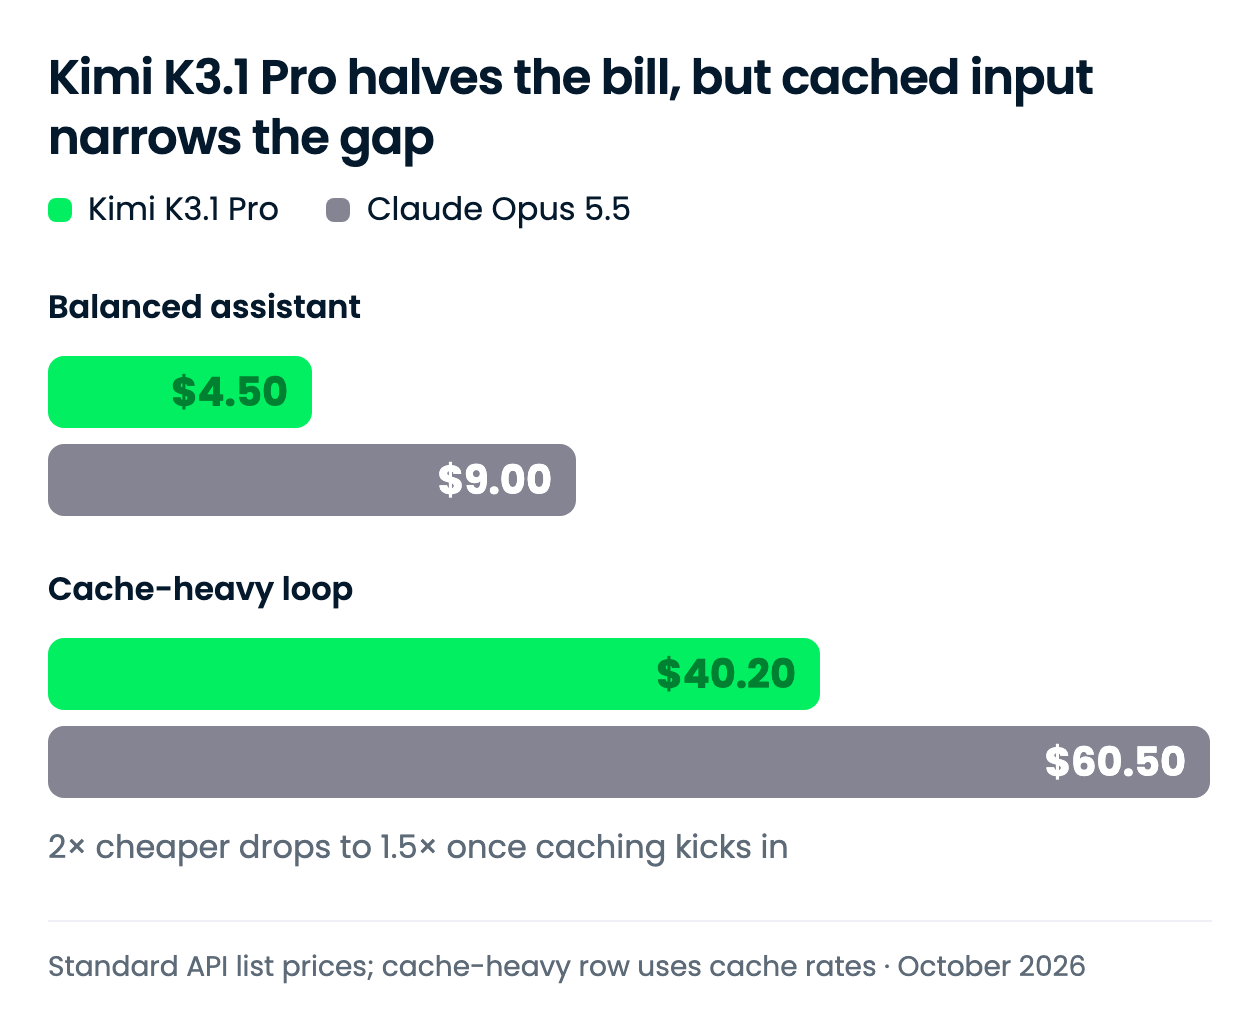
Kimi K3.1 Pro kosztuje połowę Opus 5.5 na świeżych tokenach. Oszczędność maleje, gdy obciążenie działa na cache’owanym kontekście, bo obaj dostawcy pobierają tyle samo za odczyt z cache.
Wszystkie stawki za 1M tokenów, z oficjalnych stron cen Moonshot i Anthropic.
| Stawka | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Wejście, za 1M tokenów | $2.00 | $4.00 |
| Wyjście, za 1M tokenów | $10.00 | $20.00 |
| Odczyt cache wejścia, za 1M tokenów | $0.20 | $0.20 |
| Zapis cache, TTL 5 minut | $2.00 | $5.00 |
| Zapis cache, TTL 1 godzina | $4.00 | $8.00 |
| Szybszy wariant | K3.1 Pro Highspeed, 2–3× szybciej: $4.00 / $20.00 | Fast mode, do 2,5× szybciej: $8.00 / $40.00 |
Współczynnik nie jest jednolity: 0,5× na wejściu, wyjściu i 1‑godzinnym zapisie cache, 0,4× na 5‑minutowym zapisie cache i 1,0× na odczycie cache. Żaden dostawca nie dolicza dopłaty za długi kontekst.
Z tabeli wynikają dwa niuanse. Wariant Highspeed Kimi kosztuje dokładnie tyle, co standardowy Opus. Batch API Anthropic tnie stawki Opus o połowę do $2 i $10, zrównując je ze standardową stawką Kimi, podczas gdy strona cen Moonshot nie podaje zniżki batch.
Wybrałem dwa miesięczne profile obciążenia: zbalansowanego asystenta jako punkt odniesienia oraz pętlę agenta intensywnie korzystającą z cache, bo to w cenniku cache oba modele się różnią.
| Obciążenie | Kimi K3.1 Pro | Claude Opus 5.5 | Różnica |
|---|---|---|---|
| Zbalansowany asystent: 1M in / 250K out | $4.50 | $9.00 | $4.50 (Kimi tańsze o 50%) |
| Pętla z dużym cache: 100K prefiks zapisany raz, 1 000 odczytów cache, plus 5K świeżych in / 1K out na żądanie | $40.20 | $60.50 | $20.30 (Kimi tańsze o 34%) |
Każdy wynik to (wolumen ÷ 1M) × stawka, zsumowane dla wejścia, wyjścia i linii cache; w wierszu z cache użyto 5‑minutowego zapisu cache. Wiersz zbalansowany to po prostu 2× różnica stawek.
Wiersz z dużym cache to ten, wokół którego warto planować. 100M tokenów w cache kosztuje $20 na każdym modelu, więc tylko świeże tokeny i zapis cache niosą zniżkę Kimi, a oszczędność spada do około jednej trzeciej. Anthropic podaje, że odczyty cache stanowią większość kosztów agentowego kodowania, więc długo działające agenty będą bliżej tego wiersza niż pierwszego.
Modele używają różnych tokenizerów i żaden dostawca nie opublikował liczby tokenów dla wspólnego obciążenia, więc traktuj te sumy jako porównanie stawek, a nie rzeczywisty rachunek.
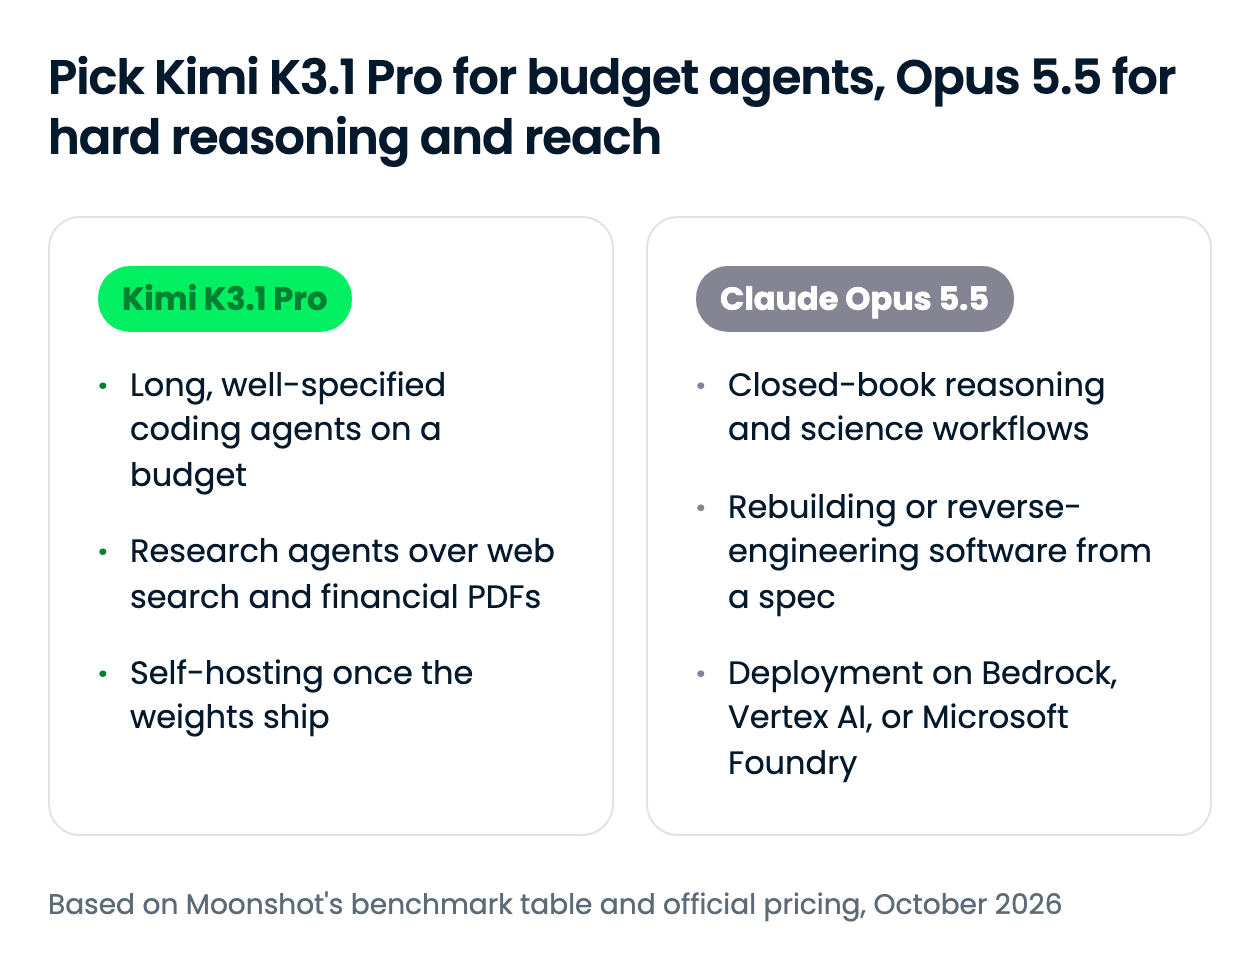
Rozdroże to cena kontra zasięg: Kimi K3.1 Pro tnie stawkę za token o połowę, a Opus 5.5 pokrywa przypadki rozumowania, w których Kimi odstaje, oraz platformy chmurowe, na których Kimi nie jest potwierdzone. Jeśli twój agent działa głównie na cache’owanym kontekście, oszczędność bliższa jest jednej trzeciej niż połowie.
Oba modele możesz wywołać już dziś przez ich własne API lub przez OpenRouter, a Opus 5.5 działa też na Amazon Bedrock, Vertex AI i Microsoft Foundry.
| Powierzchnia | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Aplikacja konsumencka | Kimi.com, aplikacje mobilne Kimi, aplikacja desktopowa Kimi Work | Aplikacje Claude (Pro, Max, Team, Enterprise) |
| API pierwszej strony | API Kimi (kompatybilne z OpenAI) | API Claude |
| Platformy chmurowe | Niedostępne jeszcze w Azure AI Foundry ani Amazon Bedrock na 29 paź 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Agenty do kodu | Kimi Code (niedostępne jeszcze w GitHub Copilot i Cursor na 29 paź 2026) | Claude Code, Cursor, GitHub Copilot |
| Zewnętrzne routery | OpenRouter | OpenRouter |
| Otwarte wagi | Do 4 listopada 2026 | Nie |
| ID modelu w API | kimi-k3.1-pro |
claude-opus-5-5 |
Luka w zasięgu jest dla wielu zespołów rozstrzygająca: Opus 5.5 jest na każdej dużej chmurze i w głównych agentach do kodu, podczas gdy Kimi K3.1 Pro jest potwierdzony tylko na własnych powierzchniach Moonshot i w OpenRouter, dopóki nie pojawią się wagi. W API pierwszej strony ID modeli to kimi-k3.1-pro i claude-opus-5-5; w OpenRouter to moonshotai/kimi-k3.1-pro i anthropic/claude-opus-5.5.
Endpoint OpenRouter zgodny z OpenAI sprawia, że podmiana modeli to zmiana jednego stringa — najłatwiejszy sposób na A/B twoich własnych promptów.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Nasz tutorial API Opus 5.5 zagłębia się w stronę Claude, a nasz tekst o OpenCode pokazuje, jak podpiąć którykolwiek model do open-source’owego agenta do kodu.
Kimi K3.1 Pro dorównuje Claude Opus 5.5 w terminalowym kodowaniu i wygrywa w długich, narzędziowo ciężkich przebiegach agentów — przy znaczącej zniżce. Jeśli twoi agenci realizują długie, dobrze określone zadania z narzędziami, wybierz Kimi; jeśli rozumują bez wsparcia, gonią mgliste specyfikacje lub muszą działać na AWS, Google Cloud czy Azure, wybierz Opus.
Najciekawsze jest dla mnie to, jak różnie oba laboratoria podchodzą do tego samego ryzyka: Moonshot wycina zdolności cyber z wag przed publikacją, a Anthropic utrzymuje je w modelu i bramkuje na etapie serwowania. Przetestowałbym Kimi przez OpenRouter i wrócił do tematu self-hostingu, gdy w listopadzie pojawią się wagi i licencja.
Jeśli chcesz budować z takimi modelami, polecam nasz ścieżkę Associate AI Engineer for Developers.
Ucz się AI z DataCamp!
Ścieżka
Kurs
Ćwicz i monitoruj swoje postępy.
Kontynuuj Z Google