

Lärstig
Associate AI Engineer för utvecklare
26 tim
Öva och håll koll på dina framsteg.
Fortsätt Med GoogleMoonshot AI släppte Kimi K3.1 Pro i oktober 2026 med ett ovanligt specifikt påstående: på Terminal-Bench 4.0 hamnar den nya open-weight-modellen inom en poäng från Claude Opus 5.5, flaggskeppet som Anthropic lanserade den 22 september. Det gör den till halva Anthropics per-tokenpris, och Moonshot utlovar nedladdningsbara vikter senast den 4 november.
I den här artikeln jämför jag Kimi K3.1 Pro och Claude Opus 5.5 inom agentisk kodning, resonemang, verktygstunga agentuppgifter, säkerhetskontroller och vad det faktiskt kostar att köra var och en.
Om du är intresserad av nya modellsläpp bör du också läsa våra guider om Googles senaste flaggskepp, Gemini 4 Carbon och Genie 4. För att hålla dig uppdaterad med de senaste AI-nyheterna rekommenderar jag också att du prenumererar på vårt veckobrev, The Median.
Kimi K3.1 Pro är Moonshot AI:s flaggskeppsmodell, släppt i oktober 2026 som en eftertränad version av Kimi K3 med öppna vikter utlovade till den 4 november.
Dess säljpunkt är förstärkningsinlärning i stor skala: Moonshot körde gemensam RL över hundratals nedströmsdomäner, vilket märks mest i långsiktig kodning, finansiell forskning och 3D-skapande.
Vår guide till Kimi K3.1 Pro täcker lanseringen i sin helhet.
Claude Opus 5.5 är Anthropics stängda flaggskepp och den första modellen i Claude 5.5-familjen, släppt den 22 september 2026.
Anthropic positionerar den som Claude Fable 5.1-nivå på det mesta arbete till ett lägre pris än Opus 5, med de bästa resultat de uppmätt i sin automatiserade alignment-granskning.
Vår guide till Claude Opus 5.5 täcker lanseringen; vår API-handledning för Opus 5.5 går igenom hur du bygger en AI-incidentutredare.
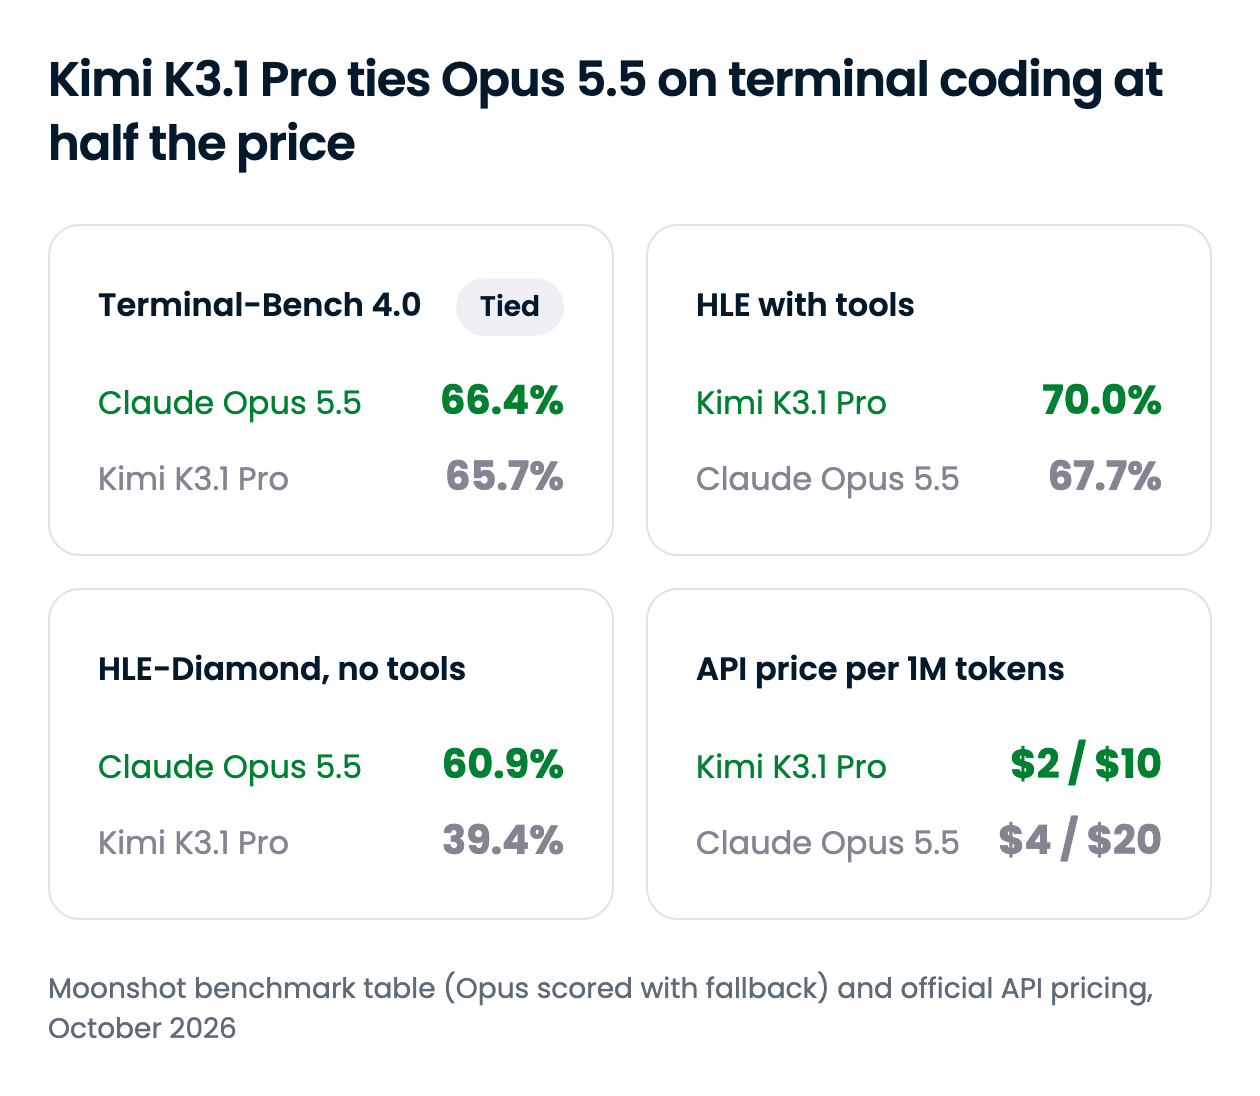
Kimi K3.1 Pro vinner på pris och på agentarbete som lutar sig mot verktyg; Opus 5.5 vinner när modellen måste resonera utan hjälp eller lösa en underspecificerad uppgift. Sammanfattningen nedan täcker varje dimension, och avsnitten efter går djupare i de områden där skillnaden kan avgöra valet.
| Funktion | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Utvecklare | Moonshot AI | Anthropic |
| Lanserad | Oktober 2026 | 22 september 2026 |
| Vikter | Öppna vikter förväntas senast 4 november 2026 (licens ännu ej annonserad) | Stängda |
| Context-fönster | 1M tokens | 1M tokens |
| Maxutdata | Upp till 1 048 576 tokens (131 072 som standard) | 128K tokens (300K på Batch API, beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Långsiktig kodning (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Closed-book-resonemang (HLE-Diamond) | 39,4% | 60,9% |
| Verktygsassisterat resonemang (HLE med verktyg) | 70,0% | 67,7% |
| Offensiv cyber (ExploitBench) | 74,7 | 91,0 |
| API-pris | Hälften av Opus 5.5 på in- och utdata | Baslinje |
| Var den kan köras | Kimi API, Kimi-appar, OpenRouter | Claude API, Claude-appar, AWS, Google Cloud, Azure, större kodningsagenter |
Ett förbehåll gäller alla poäng i detta avsnitt. Siffrorna sida vid sida kommer från Moonshots egen benchmarktabell, som markerar varje Opus 5.5-resultat "med fallback": Anthropics skyddsmekanismer dirigerar vissa cyber- och biologirelaterade uppgifter till andra Claude-modeller (Opus 4.8 respektive Opus 5), vilket sannolikt drar ner dessa poäng.
Modellerna är i praktiken jämbördiga på Terminal-Bench 4.0, och den rubriken döljer en verklig uppdelning under ytan. Kimi K3.1 Pro leder de långsiktiga raderna, medan Opus 5.5 leder med bred marginal där uppgiften är mer öppen.
Den största skillnaden är ProgramBench, som ber en modell att återskapa ett program från dess binär och specifikation. Opus 5.5 får 65,0% av uppgifterna till minst 95% godkända tester, medan Kimi K3.1 Pro klarar 31,5%, mindre än hälften.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Anmärkningar |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi körd i Claude Code-harnessen; Opus på xhigh effort enligt Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Flera timmars ingenjörsuppgifter |
| DeepSWE v1.1 | 75,5% | 74,2% | Varje labs egen setup, betrakta som oavgjort |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | 58,5% | Moonshots interna benchmark |
| ProgramBench (binärt resultat) | 31,5% | 65,0% | Andel uppgifter med minst 95% |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | Anthropics egen tabell rapporterar 58,7% för Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi körd på H20-GPU:er i stället för H100 |
| BenchCAD med verktyg | 92,7% | 96,2% | 3D-rekonstruktion via CAD-kod |
Mönstret är konsekvent. Ge Kimi K3.1 Pro en väl definierad ingenjörsuppgift och gott om tid, så fortsätter den: Moonshots visningskörning lät den fixa 36 fel i en gångsimulators axelmuskulaturberäkningar över 167 uppdrag. Anthropics motsvarande berättelse är en C-till-Rust-översättning av HAProxy som klarade nästan alla Haproxys egna regressionstester.
När specifikationen är tunn drar Opus ifrån. ProgramBench, vetenskapliga forskningsarbetsflöden och eftertränings-experiment kräver alla att man först tar reda på vad uppgiften faktiskt är, och där slutar Kimis långlöpningsuthållighet att löna sig.
För långa, väl specificerade kodningsagenter är Kimi K3.1 Pro ett verkligt alternativ; för reverse engineering, forskningskod och otydliga biljetter är Opus 5.5 det säkrare valet.
Utan verktyg leder Opus 5.5 tydligt. Den största skillnaden är HLE-Diamond, den svåraste delmängden om 1 000 frågor i Humanity's Last Exam, där Opus får 60,9% mot Kimis 39,4%.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Anmärkningar |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2 500 frågor, inga verktyg |
| HLE-Diamond | 39,4% | 60,9% | Svåraste 1 000 frågorna |
| GPQA-Diamond | 94,2% | 93,9% | Nästan mättnad; oavgjort |
| MMMU-Pro | 84,1% | 87,7% | Bild- och textfrågor |
| Kimi Hallu Bench (lägre är bättre) | 5,4% | 6,8% | Moonshots interna; påståendenivåns hallucinationsfrekvens |
De går jämt på GPQA-Diamond, som ligger för nära sitt tak för att särskilja någon. Kimis lägre hallucinationsfrekvens kommer från Moonshots eget stresstest, så jag skulle snarare se det som ett tecken på att arbetet med faktakorrekthet gett resultat än som en direkt jämförelse. För closed-book-resonemang är Opus 5.5 den starkare modellen.
Med verktyg i handen vänds resonemangsresultatet. På Humanity's Last Exam med verktyg får Kimi K3.1 Pro 70,0% mot Opus 67,7%, och den leder de flesta av Moonshots research- och dokumentrader.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Anmärkningar |
|---|---|---|---|
| HLE-Full med verktyg | 70,0% | 67,7% | Samma frågor, verktyg tillåtna |
| BrowseComp | 92,1% | 90,8% | Svårfunnen webbinformation |
| OfficeQA Pro v2 | 64,4 | 62,2 | Numerisk analys över finansiella PDF:er |
| Frontier Finance | 58,6 | 56,7 | Investeringsflöden, från screening till lönsamhet |
| AutomationBench-AA | 73,3 | 69,5 | Artificial Analysis-version, inte Zapiers |
| OSWorld V2.1 | 79,6% | 81,8% | Att använda en skrivbordsdator |
| APEX-Agents | 67,2 | 73,5 | Mercor-topplistan |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Kimis vinster är små men konsekventa i sök och finansiella dokument. Opus behåller övertaget i datoranvändning och på tredjeparts-agenttopplistor, så Kimi K3.1 Pro är den bättre forskningsagenten och Opus 5.5 den bättre desktop- och kontorsagenten.
Båda modellerna läser lika stora kontexter, och båda tänker alltid: varken Moonshot eller Anthropic låter dig stänga av resonemang. Standarderna skiljer sig dock. Kimi K3.1 Pro kör på max-insats om du inte sätter low eller high, medan Opus 5.5 har medium som standard, så ett otunat Kimi-anrop spenderar mer resonemang per förfrågan.
Utdatataket är den större praktiska skillnaden. Kimi K3.1 Pro kan returnera ett helt context-fönsters utdata i ett anrop, ungefär åtta gånger Opus 5.5:s tak utanför Batch API. Agentbyggare som migrerar till Opus bör också känna till att tvingad verktygsanvändning nu returnerar ett 400-fel.
Båda labben stryper offensiv cyberförmåga, men på motsatta sätt. Moonshot tog bort cyberrelaterad data från mitt-träning och RL inför open-weight-släppet, vilket sänkte deras interna exploit-benchmark från 90,5% till 81,0%. Anthropic behåller förmågan i Opus 5.5 och omdirigerar de flesta cybersäkerhetsförfrågningar till Opus 4.8 vid serving.
På ExploitBench får Opus 91,0 mot Kimis 74,7, och Moonshot säger rakt ut att K3.1 Pro ligger bakom de främsta proprietära modellerna inom cyber per design. Avvägningen är kontroll: när vikterna väl släpps kan du köra Kimi i din egen infrastruktur, vilket inte erbjuds för Opus.
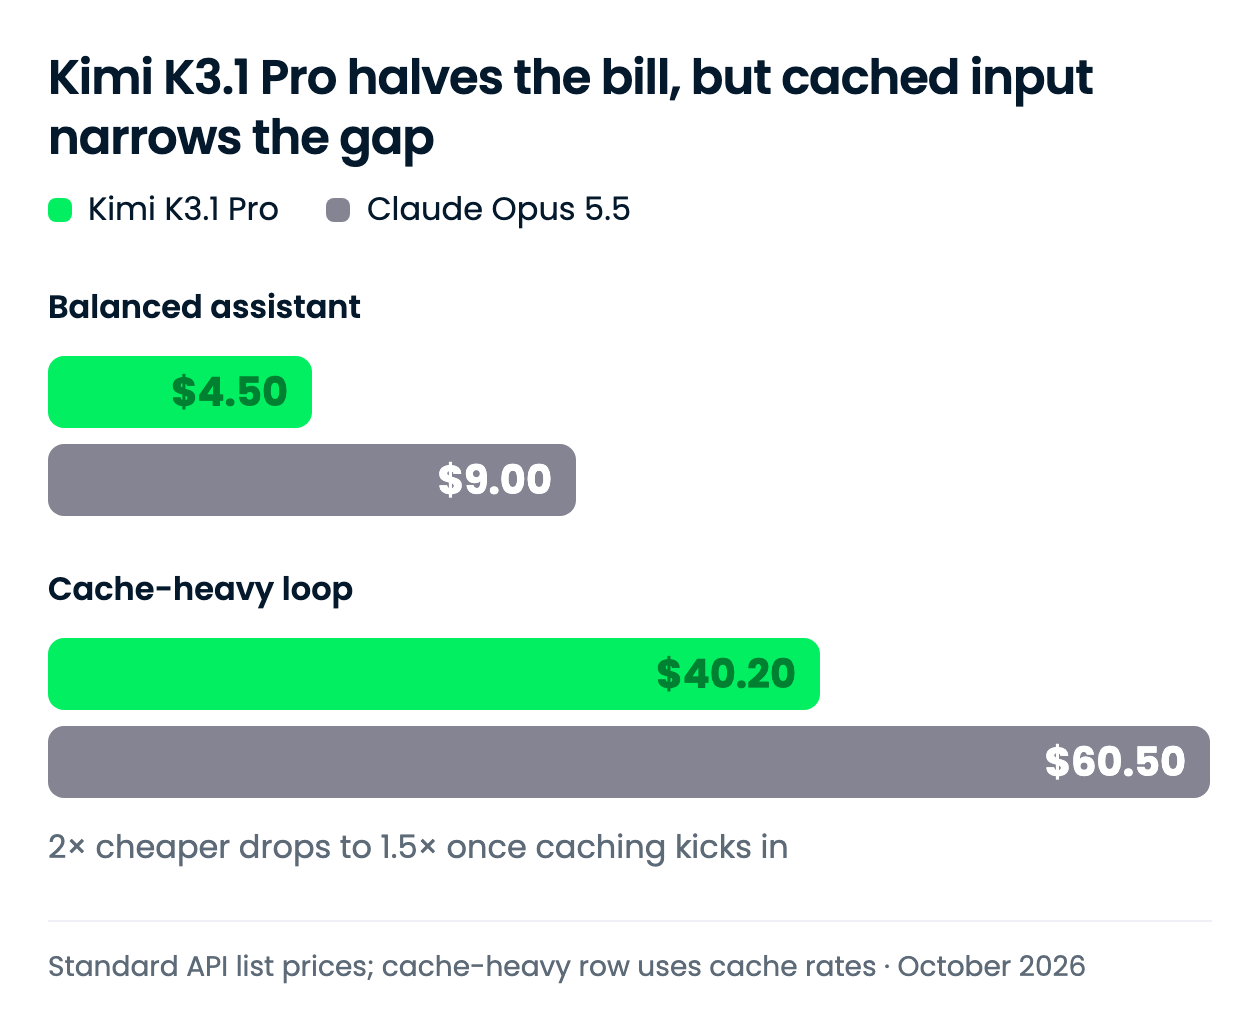
Kimi K3.1 Pro kostar hälften så mycket som Opus 5.5 på nya tokens. Besparingen krymper när en arbetslast körs på cachad kontext, eftersom båda leverantörerna tar samma betalt för en cacheread.
Alla priser är per 1M tokens, från Moonshots och Anthropics officiella prissidor.
| Prisrad | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Indata, per 1M tokens | $2.00 | $4.00 |
| Utdata, per 1M tokens | $10.00 | $20.00 |
| Cachad indataläsning, per 1M tokens | $0.20 | $0.20 |
| Cache-skrivning, 5 min TTL | $2.00 | $5.00 |
| Cache-skrivning, 1 timme TTL | $4.00 | $8.00 |
| Snabbare variant | K3.1 Pro Highspeed, 2–3x hastighet: $4.00 / $20.00 | Fast mode, upp till 2,5x hastighet: $8.00 / $40.00 |
Multipeln är inte enhetlig: 0,5x på indata, utdata och 1 timmes cache-skrivning, 0,4x på 5 minuters cache-skrivning och 1,0x på cachereads. Ingen av leverantörerna lägger på ett tillägg för långa kontexter.
Två egenheter följer av tabellen. Kimis Highspeed-variant kostar exakt vad standard-Opus kostar. Anthropics Batch API halverar Opus till $2 och $10, vilket matchar Kimis standardpris, medan Moonshots prissida inte listar någon batchrabatt.
Jag valde två månatliga arbetslastformer: en balanserad assistent som skaleankare, och en cache-tung agentloop, eftersom cacheprissättningen är där prislistorna skiljer sig.
| Arbetslast | Kimi K3.1 Pro | Claude Opus 5.5 | Skillnad |
|---|---|---|---|
| Balanserad assistent: 1M in / 250K ut | $4.50 | $9.00 | $4.50 (Kimi 50% billigare) |
| Cache-tung loop: 100K prefix skrivet en gång, 1 000 cachade läsningar, plus 5K nya in / 1K ut per förfrågan | $40.20 | $60.50 | $20.30 (Kimi 34% billigare) |
Varje total är (volym ÷ 1M) × pris, summerat över indata, utdata och cacherader; den cache-tunga raden använder 5 minuters cache-skrivning. Den balanserade raden är helt enkelt 2x-prisskillnaden.
Den cache-tunga raden är den att planera kring. De 100M cachade tokens kostar $20 på endera modell, så bara nya tokens och cache-skrivningen bär Kimis rabatt, och besparingen sjunker till cirka en tredjedel. Anthropic säger att cachereads utgör majoriteten av kostnaderna för agentisk kodning, så långkörande agenter hamnar närmare den här raden än den första.
Modellerna använder olika tokenizers, och ingen av leverantörerna har publicerat tokenantal för en gemensam arbetslast, så betrakta dessa totalsummor som en prisjämförelse snarare än en faktura.
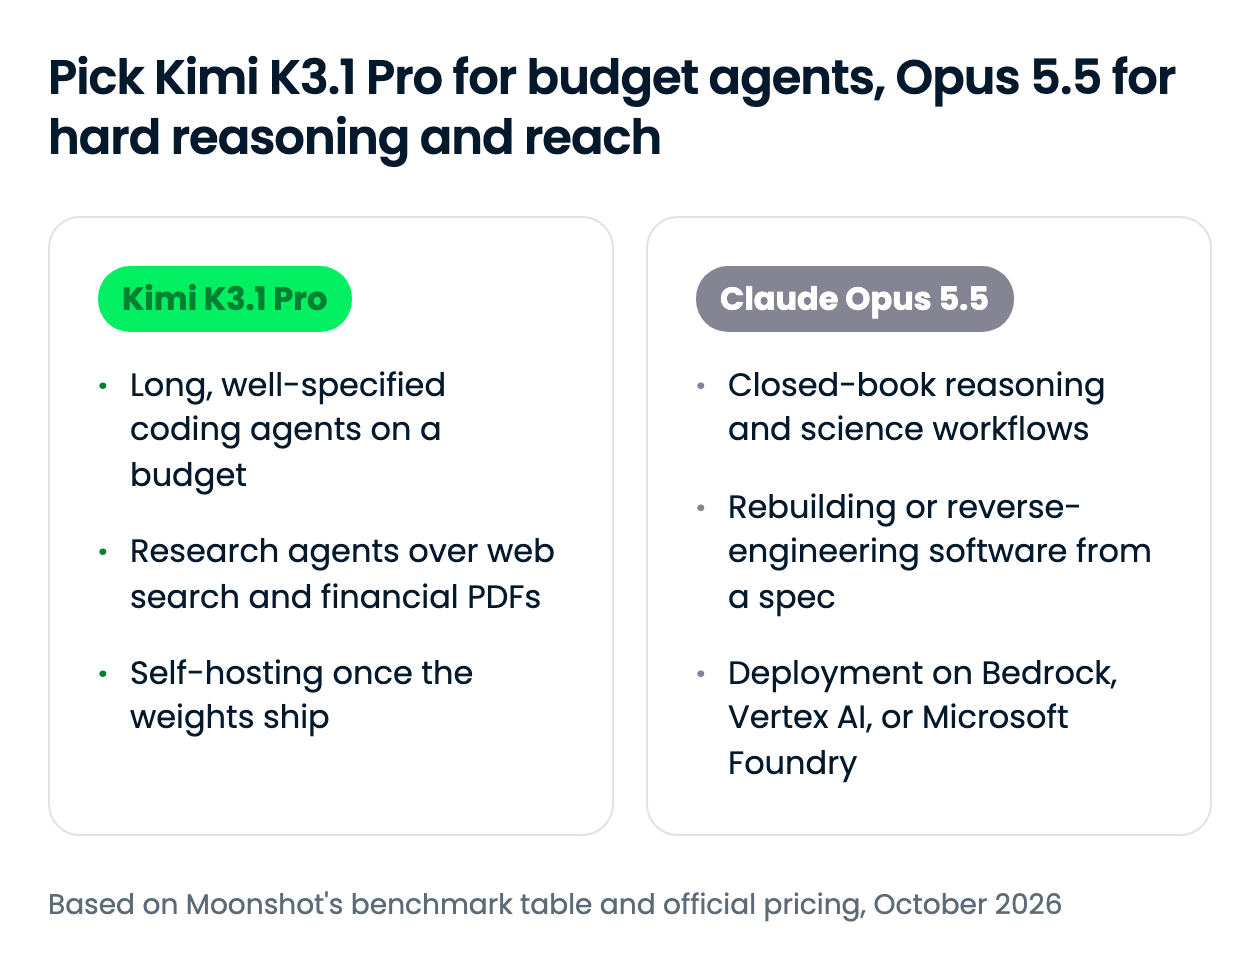
Avvägningen är pris mot bredd: Kimi K3.1 Pro halverar per-token-priset, och Opus 5.5 täcker de resonemangsfall där Kimi ligger efter och de molnplattformar där Kimi inte är bekräftad. Om din agent mestadels körs på cachad kontext är besparingen närmare en tredjedel än hälften.
Du kan anropa båda modellerna redan idag via deras egna API:er eller via OpenRouter, och Opus 5.5 körs även på Amazon Bedrock, Vertex AI och Microsoft Foundry.
| Yta | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Konsumentapp | Kimi.com, Kimi mobilappar, Kimi Work skrivbordsapp | Claude-appar (Pro, Max, Team, Enterprise) |
| Förstaparts-API | Kimi API (OpenAI-kompatibelt) | Claude API |
| Molnplattformar | Ännu inte tillgänglig på Azure AI Foundry eller Amazon Bedrock per 29 okt 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Kodningsagenter | Kimi Code (ännu inte tillgänglig i GitHub Copilot och Cursor per 29 okt 2026) | Claude Code, Cursor, GitHub Copilot |
| Tredjepartsroutrar | OpenRouter | OpenRouter |
| Öppna vikter | Förväntas senast 4 november 2026 | Nej |
| API-modell-ID | kimi-k3.1-pro |
claude-opus-5-5 |
Räckviddsgapet är avgörande för många team: Opus 5.5 finns på alla stora moln och i de etablerade kodningsagenterna, medan Kimi K3.1 Pro är bekräftad endast på Moonshots egna ytor och OpenRouter tills vikterna anländer. På förstaparts-API:erna är modell-ID:na kimi-k3.1-pro och claude-opus-5-5; på OpenRouter är de moonshotai/kimi-k3.1-pro och anthropic/claude-opus-5.5.
OpenRouters OpenAI-kompatibla endpoint gör de två modellerna till ett strängbyte, vilket är det enklaste sättet att A/B-testa dem på dina egna promptar.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Vår API-handledning för Opus 5.5 går djupare på Claude-sidan, och vår förklaring av OpenCode visar hur du kopplar in endera modellen i en open-source-kodningsagent.
Kimi K3.1 Pro matchar Claude Opus 5.5 i terminalkodning och slår den i långa, verktygstunga agentkörningar, till en tydlig rabatt. Om dina agenter kör långa, väl definierade uppgifter med verktyg, använd Kimi; om de resonerar utan hjälp, jagar diffusa specifikationer eller måste leva på AWS, Google Cloud eller Azure, använd Opus.
Det mest intressanta är hur olika de två labben hanterar samma risk: Moonshot skär bort cyberförmåga ur vikterna innan publicering, och Anthropic behåller den i modellen och spärrar vid serving. Jag skulle testa Kimi via OpenRouter och återkomma till self-hosting när vikter och licens landar i november.
Om du vill bygga med modeller som dessa rekommenderar jag att du kollar in vår utbildningsväg Associate AI Engineer for Developers.
Lär dig AI med DataCamp!
Lärstig
Kurs
Öva och håll koll på dina framsteg.
Fortsätt Med Google