

Трек
Ассоциированный AI-инженер для разработчиков
26 ч
Практикуйтесь и следите за своим прогрессом.
Продолжить С GoogleMoonshot AI выпустила Kimi K3.1 Pro в октябре 2026 года с необычно конкретным заявлением: на Terminal-Bench 4.0 её новая модель с открываемыми весами набирает результат в пределах одного пункта от Claude Opus 5.5, флагмана Anthropic, представленного 22 сентября. При этом цена за токен у Kimi — вдвое ниже, а Moonshot обещает выложить веса до 4 ноября.
В этой статье мы сравним Kimi K3.1 Pro и Claude Opus 5.5 по агентному кодингу, рассуждению, работе агентов с инструментами, механизмам безопасности и реальной стоимости эксплуатации.
Если вам интересны новые релизы моделей, также загляните в наши обзоры новых флагманов Google — Gemini 4 Carbon и Genie 4. Чтобы быть в курсе последних новостей об ИИ, рекомендуем подписаться на нашу еженедельную рассылку The Median.
Kimi K3.1 Pro — флагманская модель Moonshot AI, выпущенная в октябре 2026 года как пост‑тренированная версия Kimi K3 с обещанием открытых весов до 4 ноября.
Её ключевое преимущество — масштабное обучение с подкреплением: Moonshot провела совместный RL по сотням прикладных доменов, что особенно проявляется в долгосрочном кодинге, финансовых исследованиях и 3D‑создании.
Наш обзор Kimi K3.1 Pro подробно разбирает запуск.
Claude Opus 5.5 — закрытый флагман Anthropic и первая модель семейства Claude 5.5, выпущенная 22 сентября 2026 года.
Anthropic позиционирует её как производительность уровня Claude Fable 5.1 на большинстве задач по более низкой цене, чем у Opus 5, и с лучшими показателями по их автоматическому аудиту выравнивания.
Наш обзор Claude Opus 5.5 охватывает запуск; в руководстве по API Opus 5.5 показано, как собрать ИИ‑инструмент для расследования инцидентов.
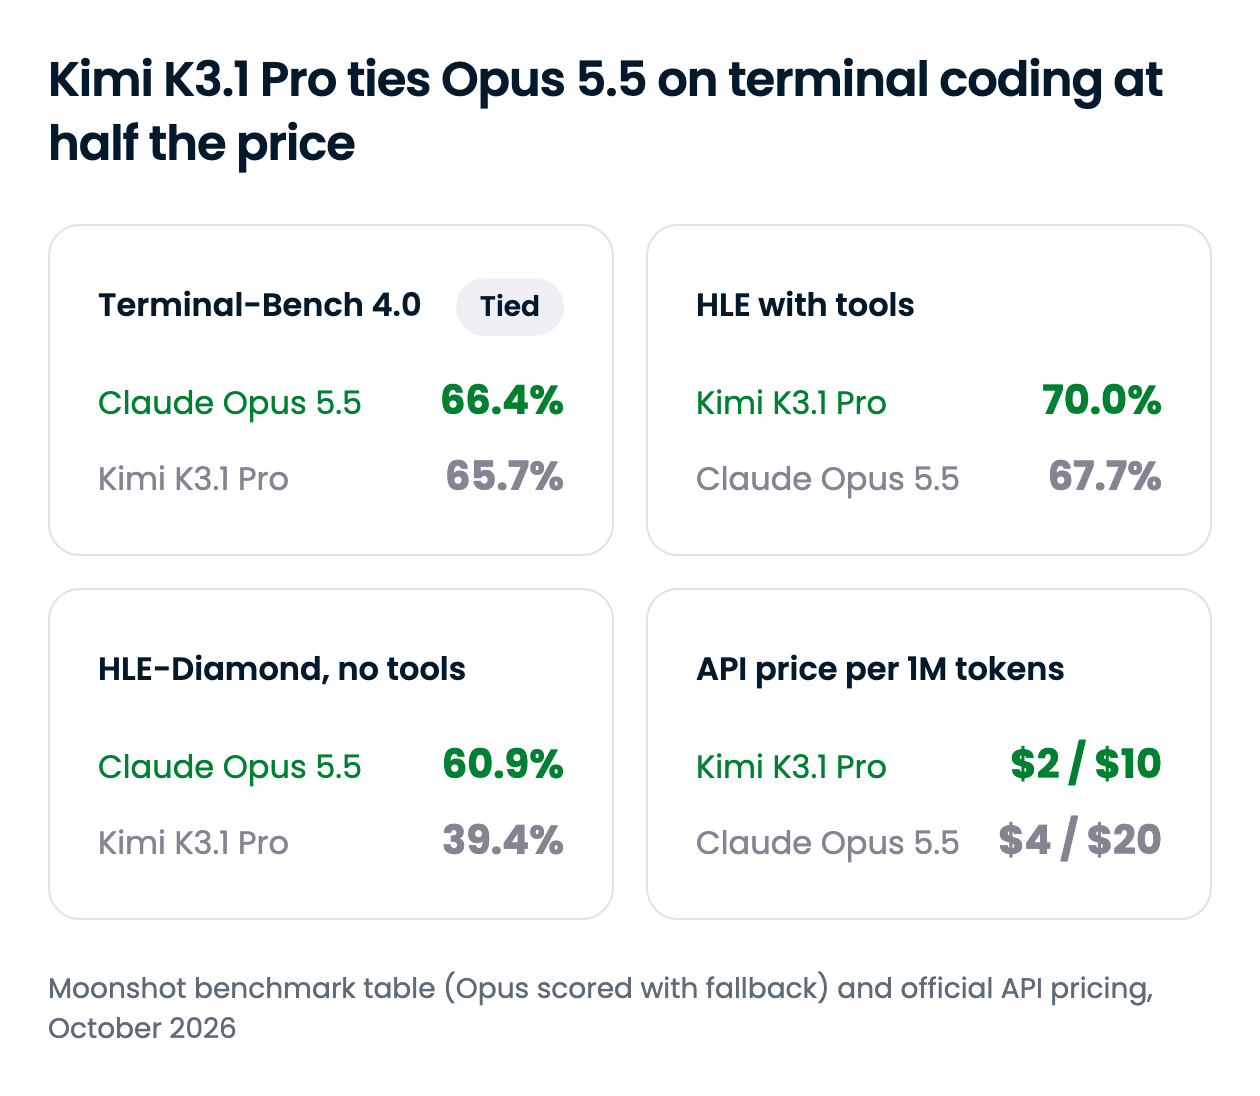
Kimi K3.1 Pro выигрывает по цене и в агентной работе с упором на инструменты; Opus 5.5 лидирует там, где модели нужно рассуждать без подсказок или разбираться с недоопределённой задачей. Ниже — сводка по всем аспектам, а далее — детали по тем, что реально влияют на выбор.
| Характеристика | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Разработчик | Moonshot AI | Anthropic |
| Релиз | Октябрь 2026 | 22 сентября 2026 |
| Веса | Открытые веса обещаны до 4 ноября 2026 (лицензия ещё не объявлена) | Закрыты |
| Окно контекста | 1M токенов | 1M токенов |
| Макс. вывод | До 1,048,576 токенов (по умолчанию 131,072) | 128K токенов (300K в Batch API, бета) |
| Terminal-Bench 4.0 | 65.7% | 66.4% |
| Долгий кодинг (SWE-Marathon v1.1) | 51.7% | 46.3% |
| Закрытое рассуждение (HLE-Diamond) | 39.4% | 60.9% |
| Рассуждение с инструментами (HLE с инструментами) | 70.0% | 67.7% |
| Оффенсив‑кибер (ExploitBench) | 74.7 | 91.0 |
| Цена API | Вдвое ниже Opus 5.5 на вводе и выводе | Базовая |
| Где можно запустить | API Kimi, приложения Kimi, OpenRouter | API Claude, приложения Claude, AWS, Google Cloud, Azure, крупные кодинг‑агенты |
Есть важная оговорка ко всем этим показателям. Сравнение основано на таблице бенчмарков Moonshot, где каждый результат Opus 5.5 помечен «с откатом»: механизмы безопасности Anthropic передают часть задач по кибербезопасности и биологии другим моделям Claude (Opus 4.8 и Opus 5), что, вероятно, занижает эти баллы.
На Terminal-Bench 4.0 модели фактически равны, но за этим заголовком скрыт чёткий разрыв. Kimi K3.1 Pro ведёт в длинных задачах, а Opus 5.5 — с большим отрывом — там, где задания открытые.
Самый большой разрыв — ProgramBench, где модели нужно восстановить программу по бинарю и спецификации. Opus 5.5 доводит 65.0% задач до прохождения не менее 95% тестов, а Kimi K3.1 Pro — 31.5%, менее половины.
| Бенчмарк | Kimi K3.1 Pro | Claude Opus 5.5 | Примечания |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | Kimi запущена в окружении Claude Code; Opus на уровне усилий xhigh по Anthropic |
| SWE-Marathon v1.1 | 51.7% | 46.3% | Многочасовые инженерные задачи |
| DeepSWE v1.1 | 75.5% | 74.2% | У каждой лаборатории своя методика; считать ничьёй |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | 58.5% | Внутренний бенчмарк Moonshot |
| ProgramBench (binary score) | 31.5% | 65.0% | Доля задач с результатом не менее 95% |
| Terminal-Bench Science 0.1 | 38.1% | 63.3% | В таблице Anthropic указан 58.7% для Opus |
| PostTrainBench v1.2 | 36.5% | 43.8% | Kimi запущена на H20, а не H100 |
| BenchCAD с инструментами | 92.7% | 96.2% | 3D‑реконструкция через CAD‑код |
Паттерн устойчивый. Дайте Kimi K3.1 Pro чёткую инженерную задачу и много времени — и она будет методично работать: в демонстрации Moonshot модель исправила 36 ошибок в расчётах мышц плеча симулятора ходьбы человека за 167 миссий. Эквивалентная история Anthropic — перевод HAProxy с C на Rust с прохождением почти всех собственных регрессионных тестов HAProxy.
Когда спецификация «тонкая», вперёд выходит Opus. ProgramBench, научные исследовательские конвейеры и пост‑тренировочные эксперименты требуют сначала понять саму задачу — и здесь выносливость Kimi на длинной дистанции перестаёт окупаться.
Для длинных, хорошо определённых кодовых агентов Kimi K3.1 Pro — реальная альтернатива; для реверс‑инжиниринга, исследовательского кода и «размытых» тикетов надёжнее выбрать Opus 5.5.
Без инструментов Opus 5.5 уверенно лидирует. Самый большой разрыв — HLE-Diamond, 1000 самых сложных вопросов Humanity's Last Exam: у Opus 60.9% против 39.4% у Kimi.
| Бенчмарк | Kimi K3.1 Pro | Claude Opus 5.5 | Примечания |
|---|---|---|---|
| HLE-Full | 51.1% | 59.8% | 2,500 вопросов, без инструментов |
| HLE-Diamond | 39.4% | 60.9% | Самые сложные 1000 вопросов |
| GPQA-Diamond | 94.2% | 93.9% | Почти потолок; ничья |
| MMMU-Pro | 84.1% | 87.7% | Вопросы по изображениям и тексту |
| Kimi Hallu Bench (меньше — лучше) | 5.4% | 6.8% | Внутренний Moonshot; доля галлюцинаций на уровне утверждений |
На GPQA-Diamond — ничья, метрика близка к насыщению. Более низкий уровень «галлюцинаций» у Kimi — результат внутреннего стресс‑теста Moonshot, так что это скорее сигнал о проработке фактической точности, чем прямое сравнение. В закрытом рассуждении Opus 5.5 сильнее.
Если дать обоим моделям инструменты, расклад по рассуждению меняется. На Humanity's Last Exam с инструментами Kimi K3.1 Pro набирает 70.0% против 67.7% у Opus и лидирует в большинстве строк Moonshot по исследованиям и документам.
| Бенчмарк | Kimi K3.1 Pro | Claude Opus 5.5 | Примечания |
|---|---|---|---|
| HLE-Full с инструментами | 70.0% | 67.7% | Те же вопросы, с инструментами |
| BrowseComp | 92.1% | 90.8% | Труднодоступная информация в интернете |
| OfficeQA Pro v2 | 64.4 | 62.2 | Числовой анализ по финансовым PDF |
| Frontier Finance | 58.6 | 56.7 | Инвест‑воркфлоу: от скрининга до прибыльности |
| AutomationBench-AA | 73.3 | 69.5 | Версия Artificial Analysis, не Zapier |
| OSWorld V2.1 | 79.6% | 81.8% | Управление рабочим столом |
| APEX-Agents | 67.2 | 73.5 | Таблица лидеров Mercor |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Победы Kimi невелики, но стабильны в поиске и по финансовым документам. Opus сохраняет преимущество в управлении компьютером и на сторонних лидербордах агентов, так что Kimi K3.1 Pro лучше как исследовательский агент, а Opus 5.5 — как агент для десктопа и офисных задач.
Обе модели читают одинаковый объём контекста и всегда «думают»: ни Moonshot, ни Anthropic не позволяют отключать рассуждение. Но умолчания разные. Kimi K3.1 Pro по умолчанию запускается с усилием max, если явно не задать low или high, тогда как Opus 5.5 — с medium, поэтому без тюнинга Kimi тратит больше рассуждения на запрос.
Более важная практическая разница — потолок вывода. Kimi K3.1 Pro может вернуть за один вызов весь объём окна контекста — примерно в восемь раз больше потолка Opus 5.5 вне Batch API. Строителям агентов, мигрирующим на Opus, стоит знать, что принудительное использование инструмента теперь возвращает 400‑ошибку.
Обе лаборатории ограничивают наступательные кибервозможности, но по‑разному. Moonshot вырезает киберданные из середины обучения и RL для релиза с открытыми весами — это снизило их внутренний бенчмарк эксплойтов с 90.5% до 81.0%. Anthropic сохраняет способность в Opus 5.5 и на этапе сервинга перенаправляет большинство запросов по кибербезопасности на Opus 4.8.
На ExploitBench у Opus 91.0 против 74.7 у Kimi, и Moonshot прямо говорит, что K3.1 Pro по киберу умышленно отстаёт от передовых проприетарных моделей. Зато при выходе весов вы сможете запускать Kimi на своей инфраструктуре — чего Opus не предлагает.
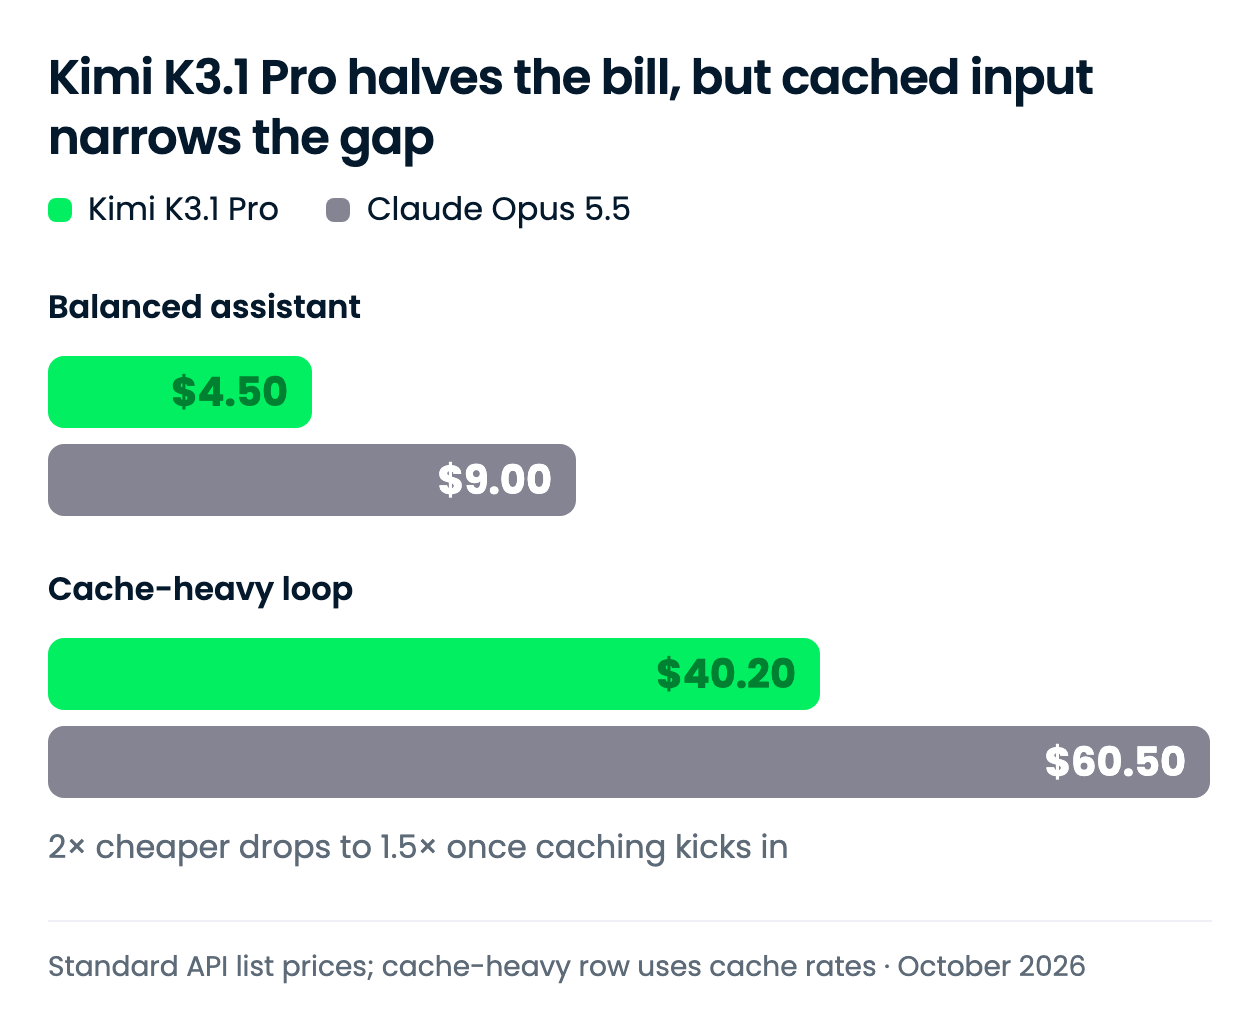
Kimi K3.1 Pro стоит вдвое дешевле Opus 5.5 на «свежих» токенах. Экономия уменьшается, когда нагрузка идёт по кэшированному контексту, потому что оба вендора берут одинаково за чтение из кэша.
Все ставки указаны за 1M токенов, по официальным страницам цен Moonshot и Anthropic.
| Ставка | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Ввод, за 1M токенов | $2.00 | $4.00 |
| Вывод, за 1M токенов | $10.00 | $20.00 |
| Чтение кэша, за 1M токенов | $0.20 | $0.20 |
| Запись кэша, TTL 5 минут | $2.00 | $5.00 |
| Запись кэша, TTL 1 час | $4.00 | $8.00 |
| Быстрый вариант | K3.1 Pro Highspeed, в 2–3 раза быстрее: $4.00 / $20.00 | Fast mode, до 2.5 раза быстрее: $8.00 / $40.00 |
Множитель не везде одинаков: 0.5× на вводе, выводе и часовых записях кэша; 0.4× — на 5‑минутных записях; 1.0× — на чтениях из кэша. На длинный контекст наценок нет.
Два интересных нюанса. Вариант Kimi Highspeed стоит ровно как стандартный Opus. Batch API Anthropic делит цены Opus надвое — до $2 и $10, что совпадает со стандартными ставками Kimi, тогда как у Moonshot скидки за пакет не заявлены.
Рассмотрены два ежемесячных профиля: сбалансированный ассистент как опорная точка и агентный цикл с активным кэшем — потому что именно там ценники расходятся.
| Нагрузка | Kimi K3.1 Pro | Claude Opus 5.5 | Разница |
|---|---|---|---|
| Сбалансированный ассистент: 1M ввод / 250K вывод | $4.50 | $9.00 | $4.50 (Kimi дешевле на 50%) |
| Цикл с кэшем: префикс 100K записан раз, 1,000 чтений из кэша, плюс 5K свежего ввода / 1K вывода на запрос | $40.20 | $60.50 | $20.30 (Kimi дешевле на 34%) |
Итог — это сумма по строкам ввода, вывода и кэша: (объём ÷ 1M) × ставка; для «кэш‑тяжёлой» строки использована запись кэша на 5 минут. Сбалансированный случай — это просто двукратная разница ставок.
Второй профиль — тот, под который стоит планировать. 100M кэшированных токенов стоят $20 в обеих моделях, поэтому скидка Kimi действует лишь на свежие токены и запись кэша, и экономия снижается до примерно трети. По словам Anthropic, чтения из кэша составляют большую часть затрат в агентном кодинге, так что долгоживущие агенты окажутся ближе ко второму ряду, чем к первому.
У моделей разные токенайзеры, и ни один вендор не публиковал токенизацию общего профиля нагрузки, поэтому рассматривайте суммы как сравнение ставок, а не как счёт к оплате.
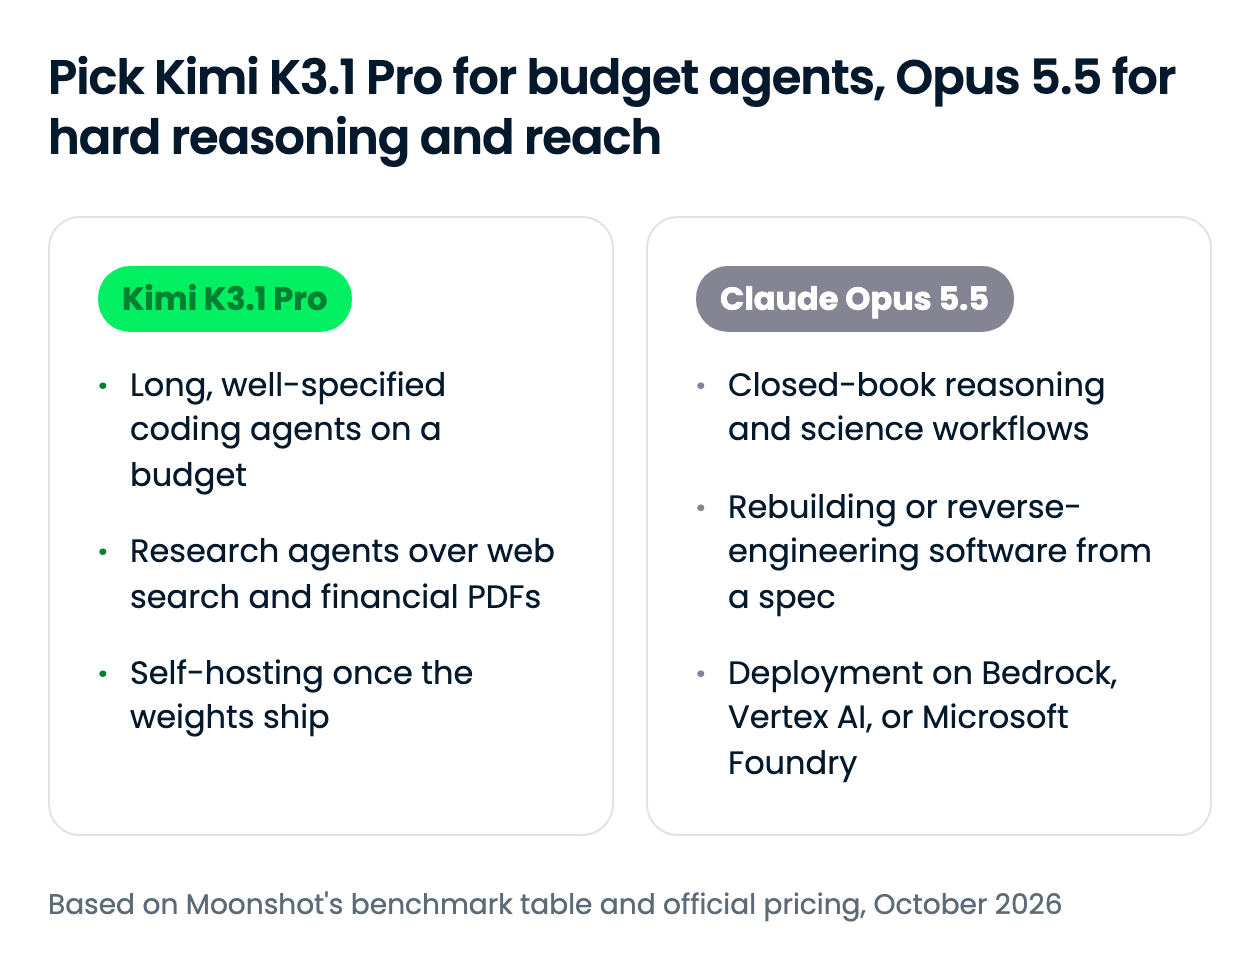
Выбор — между ценой и охватом: Kimi K3.1 Pro вдвое снижает ставку за токен, а Opus 5.5 покрывает случаи рассуждения, где Kimi отстаёт, и облачные платформы, где Kimi пока не подтверждена. Если ваш агент в основном работает на кэшированном контексте, экономия ближе к трети, чем к половине.
Обе модели уже доступны через собственные API или через OpenRouter, а Opus 5.5 также работает в Amazon Bedrock, Vertex AI и Microsoft Foundry.
| Поверхность | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Пользовательское приложение | Kimi.com, мобильные приложения Kimi, десктоп‑приложение Kimi Work | Приложения Claude (Pro, Max, Team, Enterprise) |
| Собственный API | Kimi API (совместим с OpenAI) | Claude API |
| Облачные платформы | Недоступна в Azure AI Foundry и Amazon Bedrock по состоянию на 29 окт 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Кодинг‑агенты | Kimi Code (недоступен в GitHub Copilot и Cursor по состоянию на 29 окт 2026) | Claude Code, Cursor, GitHub Copilot |
| Сторонние роутеры | OpenRouter | OpenRouter |
| Открытые веса | Ожидаются до 4 ноября 2026 | Нет |
| ID модели в API | kimi-k3.1-pro |
claude-opus-5-5 |
Для многих команд решающим становится охват: Opus 5.5 есть во всех крупных облаках и в популярных кодинг‑агентах, тогда как Kimi K3.1 Pro пока подтверждена только на площадках Moonshot и в OpenRouter — до выхода весов. В собственных API ID моделей — kimi-k3.1-pro и claude-opus-5-5; в OpenRouter — moonshotai/kimi-k3.1-pro и anthropic/claude-opus-5.5.
OpenAI‑совместимая конечная точка OpenRouter делает замену между моделями делом одной строки — это самый простой способ A/B‑тестирования на ваших промптах.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Наше руководство по API Opus 5.5 подробнее раскрывает сторону Claude, а наш материал о OpenCode показывает, как подключить любую из моделей к опенсорсному кодинг‑агенту.
Kimi K3.1 Pro сопоставима с Claude Opus 5.5 в терминальном кодинге и обгоняет её в длинных агентных запусках с инструментами — при заметной скидке. Если ваши агенты выполняют длинные, чётко заданные задачи с инструментами — выбирайте Kimi; если им нужно рассуждать без подсказок, разбираться с размытыми ТЗ или жить в AWS, Google Cloud или Azure — выбирайте Opus.
Интереснее всего — разный подход к одному риску: Moonshot вырезает кибервозможности из весов перед публикацией, а Anthropic сохраняет их в модели и ограничивает на этапе сервинга. Имеет смысл протестировать Kimi через OpenRouter и вернуться к вопросу о самостоятельном хостинге, когда в ноябре появятся веса и лицензия.
Если хотите строить проекты на таких моделях, рекомендуем наш трек Associate AI Engineer for Developers.
Изучайте ИИ с DataCamp!
Трек
Курс
Практикуйтесь и следите за своим прогрессом.
Продолжить С Google