

Program
Geliştiriciler için Yardımcı Yapay Zeka Mühendisi
26 sa
Alıştırma and program your progress.
Google Ile Devam EdinMoonshot AI, Ekim 2026'da Kimi K3.1 Pro'yu alışılmadık derecede spesifik bir iddiayla yayınladı: Terminal-Bench 4.0'da, yeni açık ağırlıklı modeli, Anthropic'in 22 Eylül'de sunduğu amiral gemisi Claude Opus 5.5'in bir puanı içinde kalıyor. Bunu, Anthropic'in token başına fiyatının yarısına yapıyor ve Moonshot, 4 Kasım'a kadar indirilebilir ağırlıklar vaat ediyor.
Bu yazıda, Kimi K3.1 Pro ve Claude Opus 5.5'i araçsal kodlama, akıl yürütme, yoğun araç kullanan ajan işleri, güvenlik kontrolleri ve her birinin çalıştırma maliyeti açısından karşılaştıracağım.
Yeni model sürümleriyle ilgileniyorsanız, Google'ın en yeni amiral gemileri Gemini 4 Carbon ve Genie 4 üzerine hazırladığımız rehberleri de mutlaka okuyun. En güncel yapay zeka haberlerinden haberdar olmak için haftalık bültenimiz The Median'a abone olmanızı da öneririm.
Kimi K3.1 Pro, Ekim 2026'da Kimi K3'ün sonradan eğitilmiş bir sürümü olarak yayınlanan ve 4 Kasım'a kadar açık ağırlıklar vaat edilen Moonshot AI'ın amiral gemisi modelidir.
Öne çıkan yanı ölçekli pekiştirmeli öğrenmedir: Moonshot, yüzlerce aşağı akış alanında ortak RL çalıştırdı; bu da en çok uzun ufuklu kodlama, finansal araştırma ve 3B üretimde kendini gösteriyor.
Kimi K3.1 Pro rehberimiz lansmanı tüm detaylarıyla ele alıyor.
Claude Opus 5.5, Anthropic'in kapalı amiral gemisidir ve 22 Eylül 2026'da yayınlanan Claude 5.5 ailesinin ilk modelidir.
Anthropic, çoğu işte Claude Fable 5.1 seviyesinde performansı, Opus 5'ten daha düşük bir fiyata sunduğunu ve otomatik hizalama denetiminde ölçtüğü en iyi puanlara ulaştığını söylüyor.
Claude Opus 5.5 rehberimiz lansmanı kapsıyor; Opus 5.5 API eğitimi ise bir yapay zeka olay araştırmacısının nasıl kurulacağını adım adım anlatıyor.
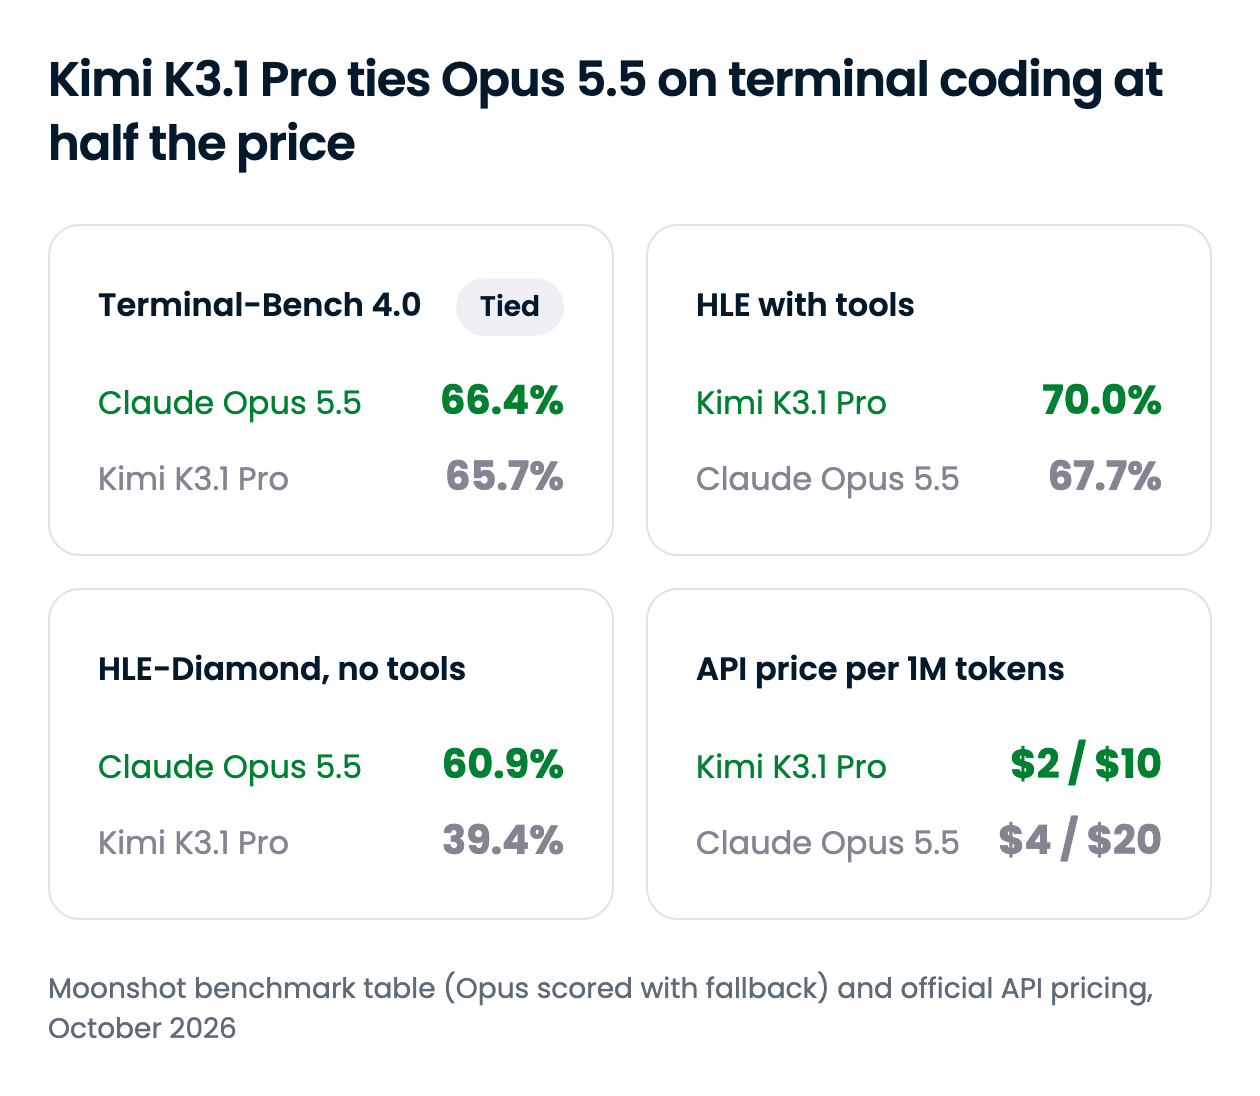
Kimi K3.1 Pro, fiyat ve araçlara yaslanan ajan işlerinde önde; modelin yardımsız akıl yürütmesi veya eksik tanımlı bir problemi çözmesi gerektiğinde Opus 5.5 kazanıyor. Aşağıdaki özet her boyutu kapsıyor; sonrasındaki bölümler ise farkın kararı etkilediği yerleri detaylandırıyor.
| Özellik | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Geliştirici | Moonshot AI | Anthropic |
| Yayın tarihi | Ekim 2026 | 22 Eylül 2026 |
| Ağırlıklar | 4 Kasım 2026'ya kadar açık ağırlıklar (lisans henüz açıklanmadı) | Kapalı |
| Bağlam penceresi | 1M token | 1M token |
| Maksimum çıktı | 1.048.576 token'a kadar (varsayılan 131.072) | 128K token (Batch API'de 300K, beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Uzun ufuklu kodlama (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Kapalı kitap akıl yürütme (HLE-Diamond) | 39,4% | 60,9% |
| Araç destekli akıl yürütme (Araçlarla HLE) | 70,0% | 67,7% |
| Saldırgan siber (ExploitBench) | 74,7 | 91,0 |
| API fiyatı | Girdi ve çıktı için Opus 5.5'in yarısı | Kıstas |
| Nerede çalıştırabilirsiniz | Kimi API, Kimi uygulamaları, OpenRouter | Claude API, Claude uygulamaları, AWS, Google Cloud, Azure, başlıca kodlama ajanları |
Bu bölümdeki her puana bir çekince uygulanır. Bire bir karşılaştırma sayıları Moonshot'ın kendi kıyaslama tablosundan geliyor ve her Opus 5.5 sonucunu "yedeklemeli" olarak işaretliyor: Anthropic'in koruma önlemleri, bazı siber ve biyoloji görevlerini diğer Claude modellerine (Opus 4.8 ve Opus 5) devrediyor; bu da muhtemelen bu puanları aşağı çekiyor.
İki model Terminal-Bench 4.0'da fiilen aynı seviyede ve bu başlık, altındaki gerçek bir ayrımı gizliyor. Kimi K3.1 Pro, uzun ufuklu satırlarda öndeyken, görev açık uçlu olduğunda Opus 5.5 farkla öne geçiyor.
En büyük fark ProgramBench'te: bir modelden, bir programı ikilinden ve spesifikasyonundan yeniden inşa etmesi isteniyor. Opus 5.5, görevlerin %65,0'ini en az %95 test geçerliğine ulaştırırken, Kimi K3.1 Pro %31,5'te kalıyor; yarıdan az.
| Kıyas | Kimi K3.1 Pro | Claude Opus 5.5 | Notlar |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi, Claude Code düzeninde çalıştırıldı; Opus, Anthropic'e göre xhigh çabada |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Saatler süren mühendislik görevleri |
| DeepSWE v1.1 | 75,5% | 74,2% | Her laboratuvarın kendi kurulumu; eşit sayın |
| Kimi Code Bench 3.0 Uzun ufuk | 61,2% | 58,5% | Moonshot iç kıyaslaması |
| ProgramBench (ikili puan) | 31,5% | 65,0% | En az %95 puan alan görev payı |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | Anthropic'in kendi tablosu Opus için %58,7 rapor ediyor |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi, H100 yerine H20 GPU'larda çalıştırıldı |
| BenchCAD araçlarla | 92,7% | 96,2% | CAD kodu üzerinden 3B yeniden kurulum |
Desen tutarlı. Kimi K3.1 Pro'ya iyi tanımlı bir mühendislik görevi ve bol zaman verin, devam eder: Moonshot'ın vitrin çalıştırması, bir insan yürüme simülatörünün omuz kası hesaplamalarında 167 görev boyunca 36 hatayı düzeltmesini gösterdi. Anthropic'in eşdeğeri ise HAProxy'nin C'den Rust'a çevirisi ve HAProxy'nin kendi regresyon testlerinin neredeyse tamamını geçmesiydi.
Spesifikasyon zayıf olduğunda Opus öne çıkıyor. ProgramBench, bilimsel araştırma iş akışları ve sonradan eğitim deneyleri, görevin tam olarak ne olduğunu bulmayı gerektiriyor ve Kimi'nin uzun koşu dayanıklılığı burada işe yaramayı bırakıyor.
Uzun, iyi tanımlı kodlama ajanları için Kimi K3.1 Pro gerçek bir alternatif; tersine mühendislik, araştırma kodu ve muğlak biletler için Opus 5.5 daha güvenli bir tercih.
Araçları kaldırın, Opus 5.5 açık ara önde. En geniş fark, Humanity's Last Exam'in en zor 1.000 soruluk alt kümesi HLE-Diamond'da: Opus %60,9, Kimi %39,4 alıyor.
| Kıyas | Kimi K3.1 Pro | Claude Opus 5.5 | Notlar |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2.500 soru, araç yok |
| HLE-Diamond | 39,4% | 60,9% | En zor 1.000 soru |
| GPQA-Diamond | 94,2% | 93,9% | Tavana yakın; eşit sayılır |
| MMMU-Pro | 84,1% | 87,7% | Görüntü ve metin soruları |
| Kimi Hallu Bench (daha düşük daha iyi) | %5,4 | %6,8 | Moonshot iç testi; iddia düzeyi halüsinasyon oranı |
GPQA-Diamond'da berabere kalıyorlar; bu kıyas, tavanına çok yakın olduğundan kimseyi ayırt etmiyor. Kimi'nin daha düşük halüsinasyon oranı Moonshot'ın kendi stres testinden geliyor; bunu başa baş bir hükümden ziyade olgusal doğruluk çalışmasının isabet ettiği yönünde bir işaret olarak görmek gerekir. Kapalı kitap akıl yürütmede daha güçlü model Opus 5.5.
İki modele de araç verin ve akıl yürütme sonucu tersine döner. Araçlarla Humanity's Last Exam'de Kimi K3.1 Pro %70,0 alırken Opus %67,7'de kalıyor ve Moonshot'ın araştırma ve doküman satırlarının çoğunda önde.
| Kıyas | Kimi K3.1 Pro | Claude Opus 5.5 | Notlar |
|---|---|---|---|
| Araçlarla HLE-Full | 70,0% | 67,7% | Aynı sorular, araçlara izinli |
| BrowseComp | 92,1% | 90,8% | Bulması zor web bilgisi |
| OfficeQA Pro v2 | 64,4 | 62,2 | Finansal PDF'lerde sayısal analiz |
| Frontier Finance | 58,6 | 56,7 | Yatırım iş akışları, elemeden kârlılığa |
| AutomationBench-AA | 73,3 | 69,5 | Zapier'in değil, Artificial Analysis sürümü |
| OSWorld V2.1 | %79,6 | %81,8 | Bir masaüstü bilgisayarı işletme |
| APEX-Agents | 67,2 | 73,5 | Mercor liderlik tablosu |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Kimi'nin arama ve finans dokümanlarında galibiyetleri küçük ama tutarlı. Opus, bilgisayar kullanımı ve üçüncü taraf ajan liderlik tablolarında üstünlüğünü koruyor; bu nedenle Kimi K3.1 Pro daha iyi bir araştırma ajanı, Opus 5.5 ise daha iyi bir masaüstü ve genel ofis ajanı.
Her iki model de aynı boyutta bağlam okur ve ikisi de her zaman düşünür: Ne Moonshot ne de Anthropic akıl yürütmeyi kapatma seçeneği sunar. Varsayılanlar farklıdır. Kimi K3.1 Pro, siz low veya high ayarlamadıkça max çabada çalışır; Opus 5.5 ise varsayılan olarak medium'dır, bu nedenle ayarsız bir Kimi çağrısı istek başına daha fazla akıl yürütme harcar.
Pratikte daha büyük fark çıktı tavanıdır. Kimi K3.1 Pro tek çağrıda tam bir bağlam penceresi kadar çıktı döndürebilir; bu, Batch API dışında Opus 5.5'in tavanının kabaca sekiz katıdır. Opus'a geçiş yapan ajan geliştiriciler, zorunlu araç kullanımının artık 400 hatası döndürdüğünü de bilmelidir.
Her iki laboratuvar da saldırgan siber kabiliyeti farklı şekillerde kısıyor. Moonshot, açık ağırlık sürümü için orta eğitim ve RL'den siberle ilgili verileri çıkardı; bu da dahili exploit kıyasını %90,5'ten %81,0'e düşürdü. Anthropic ise bu kabiliyeti Opus 5.5'te tutuyor ve çoğu siber güvenlik isteğini sunum zamanında Opus 4.8'e yönlendiriyor.
ExploitBench'te Opus 91,0, Kimi 74,7 alıyor ve Moonshot, K3.1 Pro'nun tasarım gereği siberde sınırdaki tescilli modellerin gerisinde kaldığını açıkça söylüyor. Takas, kontrol: Ağırlıklar yayınlandığında Kimi'yi kendi altyapınızda çalıştırabilirsiniz; Opus bunu sunmuyor.
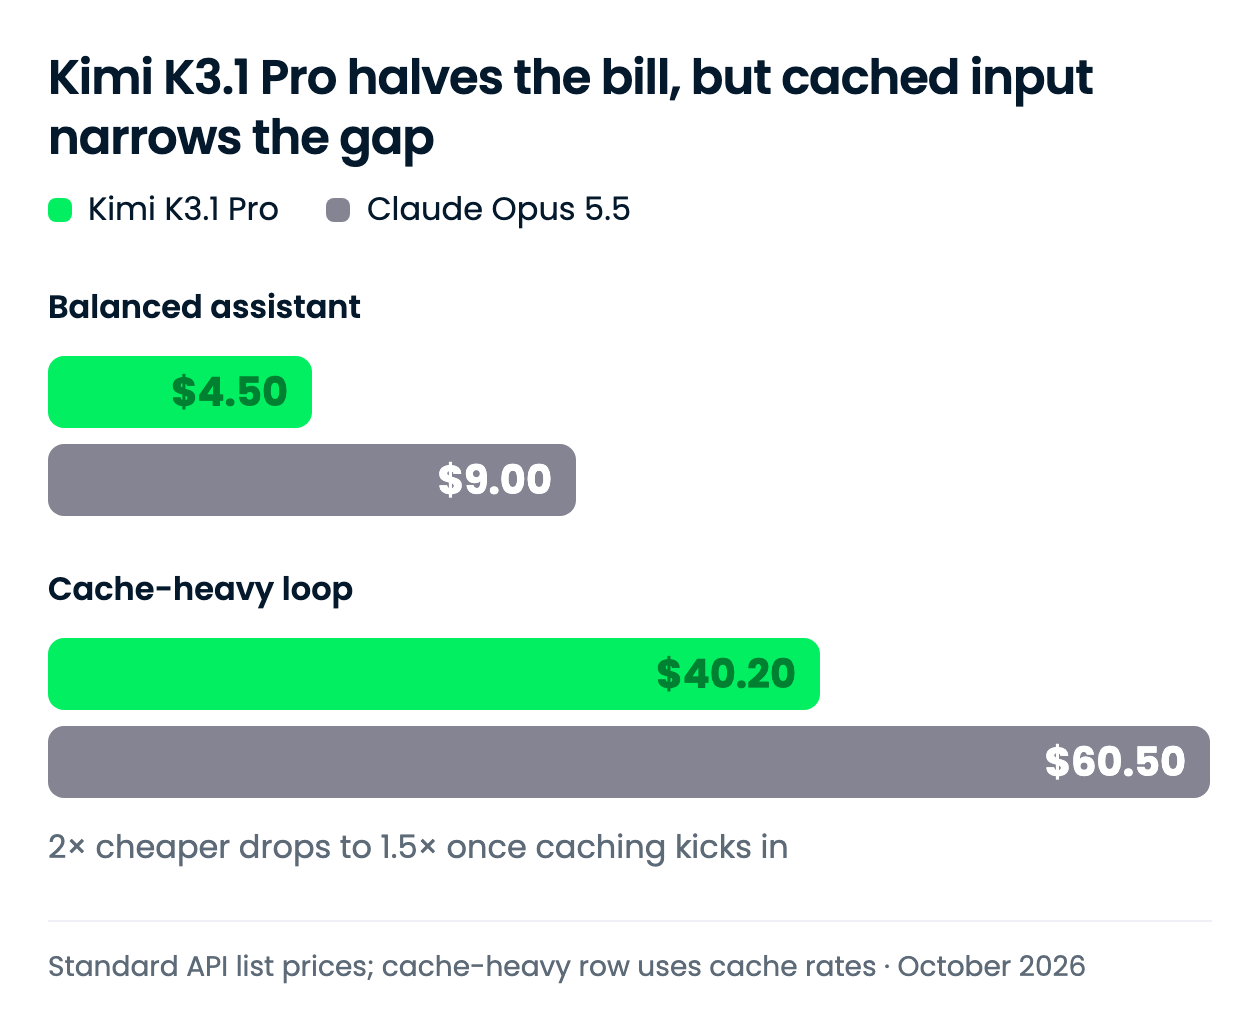
Kimi K3.1 Pro, taze token'larda Opus 5.5'in yarısı kadar maliyettedir. Bir iş yükü önbelleğe alınmış bağlam üzerinde çalıştığında tasarruf küçülür; çünkü her iki sağlayıcı da önbellek okumaları için aynı ücreti alır.
Tüm oranlar Moonshot ve Anthropic'in resmi fiyatlandırma sayfalarından alınmış olup 1M token başınadır.
| Oran | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Girdi, 1M token başına | $2.00 | $4.00 |
| Çıktı, 1M token başına | $10.00 | $20.00 |
| Önbellekli girdi okuma, 1M token başına | $0.20 | $0.20 |
| Önbelleğe yazma, 5 dakikalık TTL | $2.00 | $5.00 |
| Önbelleğe yazma, 1 saatlik TTL | $4.00 | $8.00 |
| Daha hızlı varyant | K3.1 Pro Highspeed, 2–3x hız: $4.00 / $20.00 | Hızlı mod, 2,5x hıza kadar: $8.00 / $40.00 |
Çarpan tek tip değil: girdi, çıktı ve 1 saatlik önbelleğe yazmada 0,5x; 5 dakikalık önbelleğe yazmada 0,4x; önbellek okumada 1,0x. Hiçbir sağlayıcı uzun bağlam için ek ücret almıyor.
Tablodan iki tuhaflık çıkıyor. Kimi'nin Highspeed varyantı, standart Opus ile tam olarak aynı fiyata. Anthropic'in Batch API'si, Opus'u $2 ve $10'a yarıya indiriyor ve Kimi'nin standart oranıyla eşleşiyor; Moonshot'ın fiyatlandırma sayfasında ise toplu indirim listelenmiyor.
İki aylık iş yükü şekli seçtim: ölçek çıpası olarak dengeli bir asistan ve iki fiyat listesinin ayrıştığı yer olan önbellek fiyatlandırması nedeniyle önbellek ağırlıklı bir ajan döngüsü.
| İş yükü | Kimi K3.1 Pro | Claude Opus 5.5 | Fark |
|---|---|---|---|
| Dengeli asistan: 1M girdi / 250K çıktı | $4.50 | $9.00 | $4.50 (Kimi %50 daha ucuz) |
| Önbellek ağırlıklı döngü: 100K önek bir kez yazılır, 1.000 önbellek okuma, artı istek başına 5K taze girdi / 1K çıktı | $40.20 | $60.50 | $20.30 (Kimi %34 daha ucuz) |
Her toplam, girdi, çıktı ve önbellek kalemleri için (hacim ÷ 1M) × oran şeklinde toplanmıştır; önbellek ağırlıklı satır 5 dakikalık önbelleğe yazmayı kullanır. Dengeli satır ise sadece 2x oran farkıdır.
Planlamanız gereken satır önbellek ağırlıklı olandır. 100M önbellekli token her iki modelde de $20 tutar; dolayısıyla yalnızca taze token'lar ve önbelleğe yazma Kimi'nin indirimini taşır ve tasarruf yaklaşık üçte bire düşer. Anthropic, ajan kodlama maliyetlerinin çoğunluğunu önbellek okumalarının oluşturduğunu söylüyor; bu nedenle uzun süre çalışan ajanlar ilk satıra göre bu satıra daha yakın tutarlar çıkaracaktır.
İki model farklı belirteçleyiciler kullanıyor ve hiçbir sağlayıcı paylaşılan bir iş yükü için token sayımlarını yayımlamadı; bu nedenle bu toplamları bir fatura değil, bir oran karşılaştırması olarak değerlendirin.
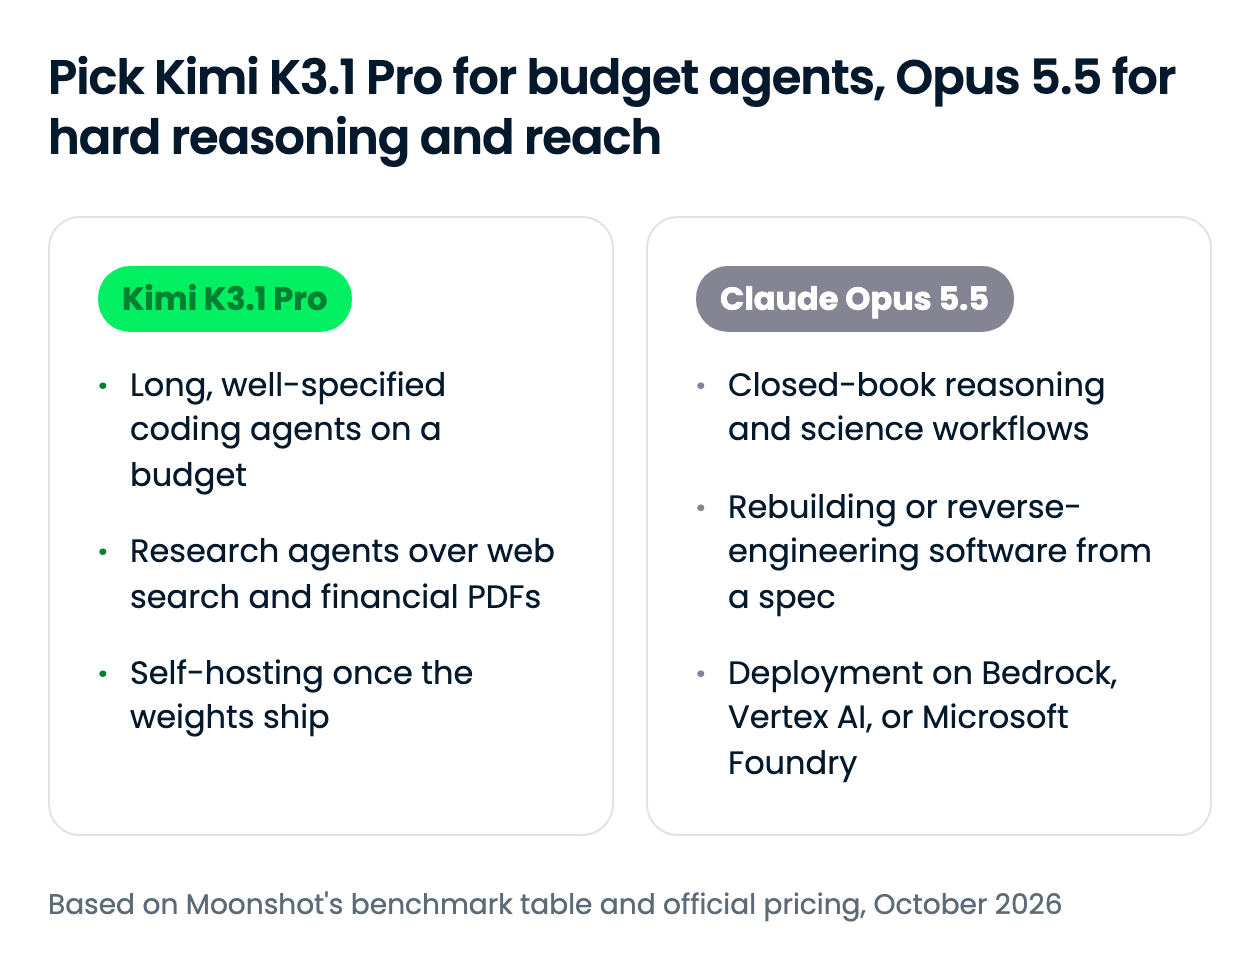
Tercih, fiyat ile kapsama arasında: Kimi K3.1 Pro token başına oranı yarıya indiriyor; Opus 5.5 ise Kimi'nin geride kaldığı akıl yürütme kullanım durumlarını ve Kimi'nin doğrulanmadığı bulut platformlarını kapsıyor. Ajanınız çoğunlukla önbelleğe alınmış bağlam üzerinde çalışıyorsa tasarruf yarıdan çok üçte bire daha yakındır.
Her iki modeli de bugün kendi API'leri veya OpenRouter üzerinden çağırabilirsiniz; Opus 5.5 ayrıca Amazon Bedrock, Vertex AI ve Microsoft Foundry üzerinde de çalışır.
| Yüzey | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Tüketici uygulaması | Kimi.com, Kimi mobil uygulamaları, Kimi Work masaüstü uygulaması | Claude uygulamaları (Pro, Max, Team, Enterprise) |
| Birinci taraf API | Kimi API (OpenAI ile uyumlu) | Claude API |
| Bulut platformları | 29 Ekim 2026 itibarıyla Azure AI Foundry veya Amazon Bedrock'ta henüz mevcut değil | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Kodlama ajanları | Kimi Code (29 Ekim 2026 itibarıyla GitHub Copilot ve Cursor'da henüz mevcut değil) | Claude Code, Cursor, GitHub Copilot |
| Üçüncü taraf yönlendiriciler | OpenRouter | OpenRouter |
| Açık ağırlıklar | 4 Kasım 2026'ya kadar | Hayır |
| API model kimliği | kimi-k3.1-pro |
claude-opus-5-5 |
Erişim farkı birçok ekip için belirleyicidir: Opus 5.5 her büyük bulutta ve ana akım kodlama ajanlarında yer alırken, Kimi K3.1 Pro ağırlıklar gelene kadar yalnızca Moonshot'ın kendi yüzeylerinde ve OpenRouter'da doğrulanmıştır. Birinci taraf API'lerde model kimlikleri kimi-k3.1-pro ve claude-opus-5-5; OpenRouter'da ise moonshotai/kimi-k3.1-pro ve anthropic/claude-opus-5.5.
OpenRouter'ın OpenAI uyumlu uç noktası, iki modeli tek bir diziyle değiştirmenizi sağlar; bu da kendi istemlerinizde A/B testi yapmanın en kolay yoludur.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Opus 5.5 API eğitimi Claude tarafında daha derine iner ve OpenCode üzerine açıklayıcımız, her iki modeli de açık kaynak bir kodlama ajanına nasıl bağlayacağınızı gösterir.
Kimi K3.1 Pro, terminal kodlamada Claude Opus 5.5 ile eşleşir ve uzun, yoğun araç kullanan ajan çalıştırmalarında onu anlamlı bir indirimle geride bırakır. Ajanlarınız uzun, iyi tanımlı görevleri araçlarla yürütüyorsa Kimi'yi; yardımsız akıl yürütüyor, muğlak spesifikasyonları kovalıyor veya AWS, Google Cloud ya da Azure üzerinde yaşaması gerekiyorsa Opus'u kullanın.
En ilginç bulduğum nokta, iki laboratuvarın aynı riski ne kadar farklı ele aldığı: Moonshot, ağırlıkları yayımlamadan önce siber kabiliyeti kesiyor; Anthropic ise kabiliyeti modelde tutup sunum zamanında kapıdan geçiriyor. Kimi'yi OpenRouter üzerinden test eder, Kasım'da ağırlıklar ve lisans geldiğinde kendi altyapınızda çalıştırmayı yeniden değerlendirirdim.
Bu tür modellerle geliştirme yapmak istiyorsanız, Geliştiriciler için Associate AI Engineer eğitim yolumuzu incelemenizi öneririm.
DataCamp ile Yapay Zeka Öğrenin!
Program
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



