Programa
Associate AI Engineer para desenvolvedores
26 h
Pratique e programa seu progresso.
Continuar Com O GoogleA Moonshot AI lançou o Kimi K3.1 Pro em outubro de 2026 com uma promessa incomum: no Terminal-Bench 4.0, seu novo modelo com pesos abertos fica a menos de um ponto do Claude Opus 5.5, carro-chefe que a Anthropic lançou em 22 de setembro. Faz isso cobrando metade do preço por token da Anthropic, e a Moonshot promete disponibilizar os pesos para download até 4 de novembro.
Neste artigo, vou comparar o Kimi K3.1 Pro e o Claude Opus 5.5 em coding agentivo, raciocínio, tarefas intensivas em ferramentas, controles de segurança e quanto cada um realmente custa para rodar.
Se você curte acompanhar lançamentos, vale ler também nossos guias sobre os novos flagships do Google, Gemini 4 Carbon e Genie 4. Para ficar por dentro das últimas novidades em IA, recomendo também assinar nossa newsletter semanal, The Median.
O Kimi K3.1 Pro é o modelo principal da Moonshot AI, lançado em outubro de 2026 como uma versão pós-treinada do Kimi K3, com pesos abertos prometidos para 4 de novembro.
Seu diferencial é o reinforcement learning em escala: a Moonshot rodou RL conjunto em centenas de domínios downstream, o que aparece mais em coding de longo prazo, pesquisa financeira e criação 3D.
Nosso guia do Kimi K3.1 Pro cobre o lançamento em detalhes.
O Claude Opus 5.5 é o flagship fechado da Anthropic e o primeiro modelo da família Claude 5.5, lançado em 22 de setembro de 2026.
A Anthropic posiciona-o com performance de nível Claude Fable 5.1 na maioria dos trabalhos, por um preço menor que o Opus 5, e com as melhores pontuações medidas no seu auditoria automatizada de alinhamento.
Nosso guia do Claude Opus 5.5 traz o lançamento; nosso tutorial da API do Opus 5.5 mostra como construir um investigador de incidentes de IA.
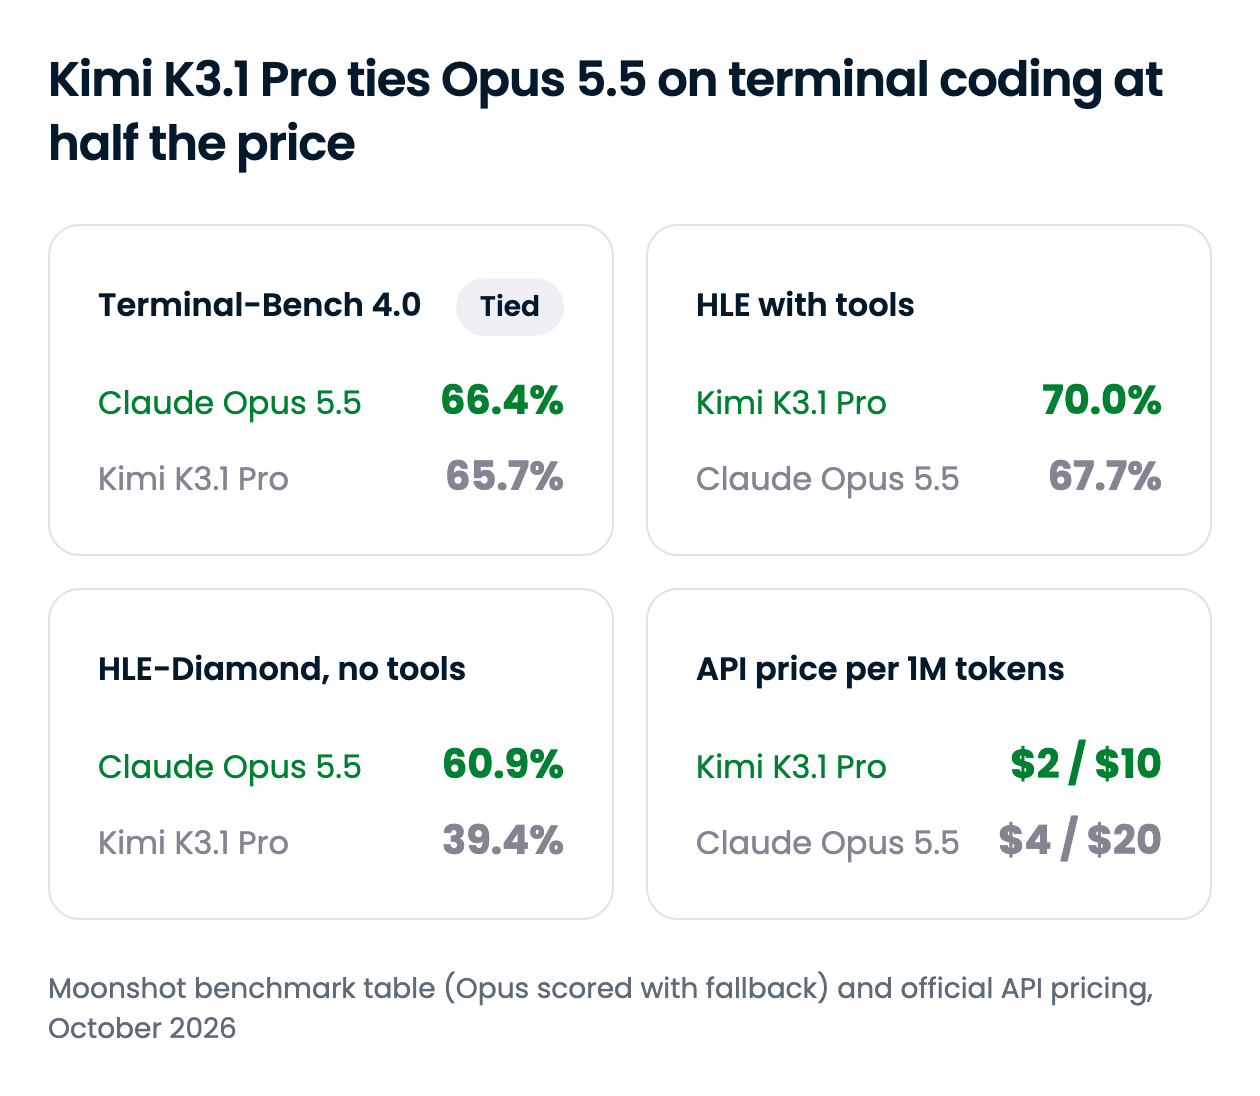
O Kimi K3.1 Pro vence em preço e em trabalhos de agente que dependem de ferramentas; o Opus 5.5 vence sempre que o modelo precisa raciocinar sem ajuda ou resolver um problema pouco especificado. O resumo abaixo cobre cada dimensão, e as seções seguintes detalham onde a diferença muda a decisão.
| Recurso | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Desenvolvedor | Moonshot AI | Anthropic |
| Lançamento | Outubro de 2026 | 22 de setembro de 2026 |
| Pesos | Pesos abertos previstos até 4 de novembro de 2026 (licença ainda não anunciada) | Fechado |
| Janela de contexto | 1M tokens | 1M tokens |
| Saída máxima | Até 1.048.576 tokens (131.072 por padrão) | 128K tokens (300K na Batch API, beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Coding de longo horizonte (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Raciocínio sem consulta (HLE-Diamond) | 39,4% | 60,9% |
| Raciocínio com ferramentas (HLE com tools) | 70,0% | 67,7% |
| Ciberofensiva (ExploitBench) | 74,7 | 91,0 |
| Preço da API | Metade do Opus 5.5 no input e no output | Referência |
| Onde roda | API do Kimi, apps do Kimi, OpenRouter | API do Claude, apps do Claude, AWS, Google Cloud, Azure, principais agentes de coding |
Uma ressalva vale para todas as pontuações desta seção. Os números lado a lado vêm da própria tabela de benchmarks da Moonshot, que marca cada resultado do Opus 5.5 como "with fallback": as salvaguardas da Anthropic redirecionam algumas tarefas de cibersegurança e biologia para outros modelos Claude (Opus 4.8 e Opus 5, respectivamente), o que provavelmente puxa essas notas para baixo.
Os dois modelos ficam praticamente empatados no Terminal-Bench 4.0, mas esse título esconde um racha real. O Kimi K3.1 Pro lidera nas linhas de longo prazo, enquanto o Opus 5.5 abre boa vantagem sempre que a tarefa é aberta.
O maior gap é o ProgramBench, que pede ao modelo para reconstruir um programa a partir do binário e da especificação. O Opus 5.5 leva 65,0% das tarefas a pelo menos 95% dos testes passando, enquanto o Kimi K3.1 Pro chega a 31,5%, menos da metade.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Observações |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi rodado no harness do Claude Code; Opus em xhigh effort segundo a Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Tarefas de engenharia de várias horas |
| DeepSWE v1.1 | 75,5% | 74,2% | Setup próprio de cada laboratório; trate como empate |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | 58,5% | Benchmark interno da Moonshot |
| ProgramBench (pontuação binária) | 31,5% | 65,0% | Proporção de tarefas com pelo menos 95% |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | A própria tabela da Anthropic reporta 58,7% para o Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi rodado em GPUs H20 em vez de H100 |
| BenchCAD com ferramentas | 92,7% | 96,2% | Reconstrução 3D via código CAD |
O padrão é consistente. Dê ao Kimi K3.1 Pro uma tarefa de engenharia bem definida e bastante tempo, e ele segue firme: a demonstração da Moonshot mostrou o modelo corrigindo 36 erros no cálculo do músculo do ombro de um simulador de caminhada humana ao longo de 167 missões. A história equivalente da Anthropic é a tradução de C para Rust do HAProxy que passou quase todos os testes de regressão do próprio HAProxy.
Quando a especificação é frouxa, o Opus dispara. ProgramBench, fluxos de pesquisa científica e experimentos de pós-treinamento exigem entender o que a tarefa realmente é, e é aí que a resistência do Kimi em longas execuções deixa de compensar.
Para agentes de coding longos e bem especificados, o Kimi K3.1 Pro é uma alternativa real; para engenharia reversa, código de pesquisa e tickets vagos, o Opus 5.5 é a escolha mais segura.
Sem ferramentas, o Opus 5.5 lidera com folga. O maior gap é no HLE-Diamond, o subconjunto mais difícil (1.000 questões) do Humanity's Last Exam, onde o Opus marca 60,9% contra 39,4% do Kimi.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Observações |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2.500 questões, sem ferramentas |
| HLE-Diamond | 39,4% | 60,9% | As 1.000 questões mais difíceis |
| GPQA-Diamond | 94,2% | 93,9% | Próximo ao teto; empate técnico |
| MMMU-Pro | 84,1% | 87,7% | Perguntas com imagem e texto |
| Kimi Hallu Bench (quanto menor, melhor) | 5,4% | 6,8% | Interno da Moonshot; taxa de alucinação por afirmação |
Eles empatam no GPQA-Diamond, que está perto demais do teto para diferenciar. A menor taxa de alucinação do Kimi vem de um teste de estresse da própria Moonshot, então eu veria mais como sinal de que o trabalho de acurácia factual funcionou do que um veredito direto. Para raciocínio fechado, o Opus 5.5 é o modelo mais forte.
Dando ferramentas a ambos, o resultado no raciocínio se inverte. No Humanity's Last Exam com ferramentas, o Kimi K3.1 Pro marca 70,0% contra 67,7% do Opus, e lidera a maioria das linhas de pesquisa e documentos da Moonshot.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Observações |
|---|---|---|---|
| HLE-Full com ferramentas | 70,0% | 67,7% | Mesmas questões, com tools |
| BrowseComp | 92,1% | 90,8% | Informações difíceis de encontrar na web |
| OfficeQA Pro v2 | 64,4 | 62,2 | Análise numérica em PDFs financeiros |
| Frontier Finance | 58,6 | 56,7 | Workflows de investimento, do screening à lucratividade |
| AutomationBench-AA | 73,3 | 69,5 | Versão Artificial Analysis, não a do Zapier |
| OSWorld V2.1 | 79,6% | 81,8% | Operando um desktop |
| APEX-Agents | 67,2 | 73,5 | Mercor leaderboard |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
As vitórias do Kimi são pequenas, mas consistentes em busca e documentos financeiros. O Opus mantém a vantagem em uso de computador e nos rankings de agentes de terceiros, então o Kimi K3.1 Pro é melhor como agente de pesquisa e o Opus 5.5 como agente de desktop e escritório geral.
Ambos leem o mesmo tamanho de contexto e ambos sempre "pensam": nem a Moonshot nem a Anthropic permitem desligar o raciocínio. Os padrões, porém, diferem. O Kimi K3.1 Pro roda em esforço max a menos que você defina low ou high, enquanto o Opus 5.5 usa medium por padrão, então uma chamada Kimi sem tuning consome mais raciocínio por requisição.
O teto de saída é a diferença prática mais relevante. O Kimi K3.1 Pro consegue retornar, em uma única chamada, um volume de saída equivalente à janela completa de contexto, cerca de oito vezes o teto do Opus 5.5 fora da Batch API. Quem migrar agentes para o Opus deve saber também que uso forçado de ferramenta agora retorna erro 400.
Ambos os laboratórios limitam a capacidade ciberofensiva, de formas opostas. A Moonshot removeu dados de ciber do meio do treinamento e do RL para o lançamento com pesos abertos, o que reduziu seu benchmark interno de exploits de 90,5% para 81,0%. A Anthropic mantém a capacidade no Opus 5.5 e redireciona a maioria das solicitações de cibersegurança para o Opus 4.8 no momento do serving.
No ExploitBench, o Opus marca 91,0 contra 74,7 do Kimi, e a Moonshot diz claramente que o K3.1 Pro fica atrás de modelos proprietários de fronteira em ciber por design. A troca é o controle: quando os pesos forem liberados, você pode rodar o Kimi na sua própria infraestrutura, algo que o Opus não oferece.
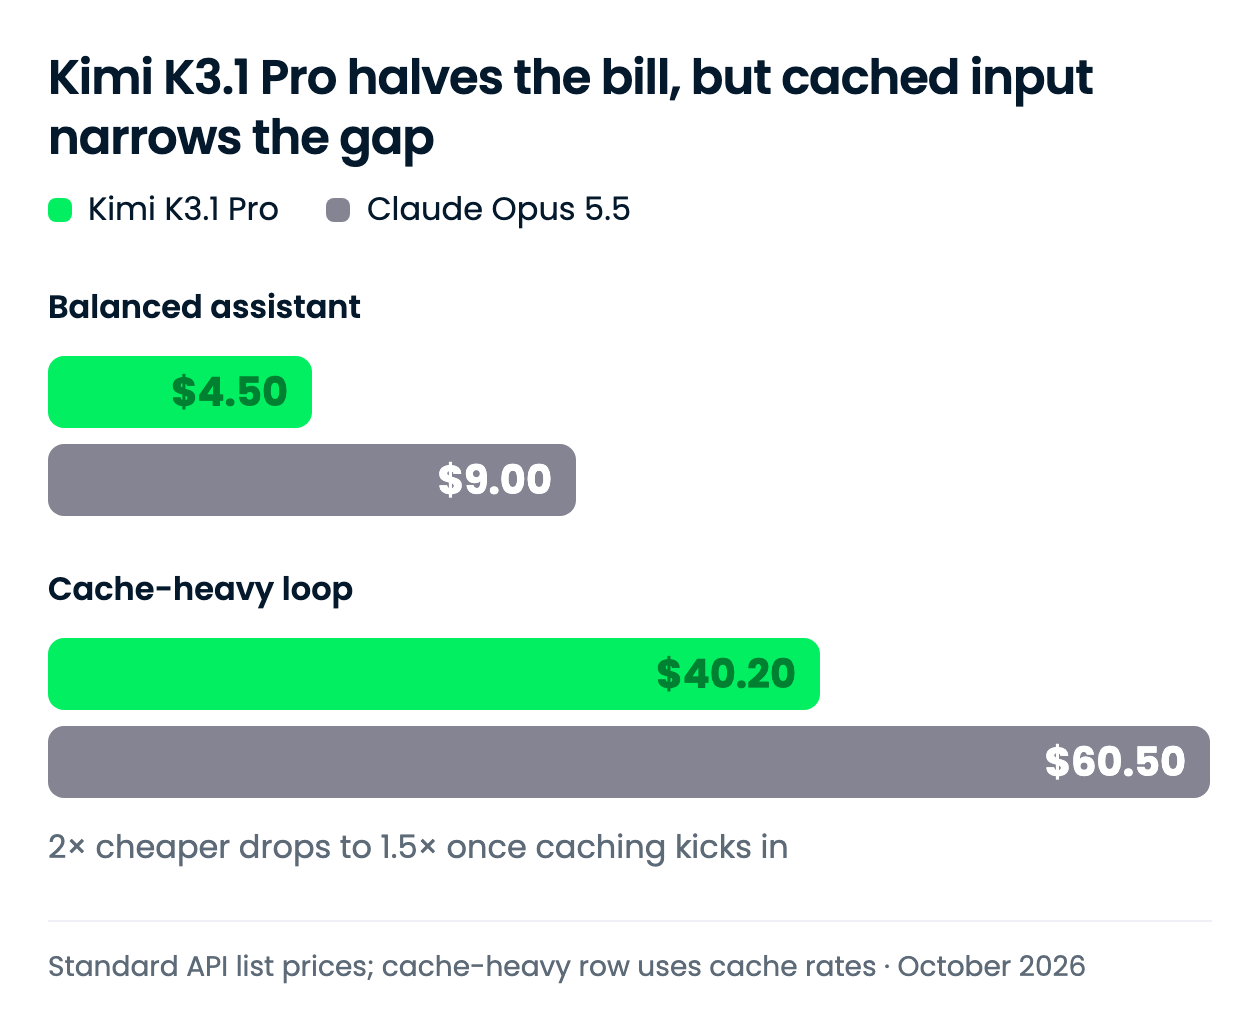
O Kimi K3.1 Pro custa metade do Opus 5.5 em tokens novos. A economia diminui quando a carga roda em contexto em cache, porque ambos cobram o mesmo por leitura de cache.
Todas as tarifas são por 1M de tokens, das páginas oficiais de preços da Moonshot e da Anthropic.
| Tarifa | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Input, por 1M de tokens | $2,00 | $4,00 |
| Output, por 1M de tokens | $10,00 | $20,00 |
| Leitura de input em cache, por 1M de tokens | $0,20 | $0,20 |
| Gravação em cache, TTL de 5 minutos | $2,00 | $5,00 |
| Gravação em cache, TTL de 1 hora | $4,00 | $8,00 |
| Variante mais rápida | K3.1 Pro Highspeed, 2–3x mais veloz: $4,00 / $20,00 | Fast mode, até 2,5x mais veloz: $8,00 / $40,00 |
O múltiplo não é uniforme: 0,5x em input, output e gravações de cache de 1 hora; 0,4x em gravações de 5 minutos; e 1,0x em leituras de cache. Nenhum dos dois cobra sobretaxa por contexto longo.
Duas particularidades chamam atenção. A variante Highspeed do Kimi custa exatamente o que o Opus padrão custa. A Batch API da Anthropic reduz o Opus à metade ($2 e $10), igualando a tarifa padrão do Kimi, enquanto a página de preços da Moonshot não lista desconto para batch.
Escolhi dois perfis mensais: um assistente equilibrado como âncora de escala e um loop de agente com uso pesado de cache, porque é no cache que as tabelas de preços divergem.
| Workload | Kimi K3.1 Pro | Claude Opus 5.5 | Diferença |
|---|---|---|---|
| Assistente equilibrado: 1M in / 250K out | $4,50 | $9,00 | $4,50 (Kimi 50% mais barato) |
| Loop pesado de cache: prefixo de 100K gravado uma vez, 1.000 leituras em cache, mais 5K novos in / 1K out por requisição | $40,20 | $60,50 | $20,30 (Kimi 34% mais barato) |
Cada total é (volume ÷ 1M) × tarifa, somado entre linhas de input, output e cache; na linha pesada de cache, usei a gravação com TTL de 5 minutos. A linha equilibrada reflete simplesmente a diferença de 2x nas tarifas.
É a linha pesada de cache que merece planejamento. Os 100M de tokens em cache custam $20 em qualquer modelo, então só os tokens novos e a gravação em cache levam o desconto do Kimi, e a economia cai para cerca de um terço. A Anthropic diz que leituras de cache compõem a maior parte do custo em coding agentivo, então agentes de longa duração vão se aproximar mais dessa linha do que da primeira.
Os modelos usam tokenizers diferentes, e nenhum dos fornecedores publicou contagens de tokens para o mesmo workload, então trate esses totais como comparação de tarifas, não como fatura.
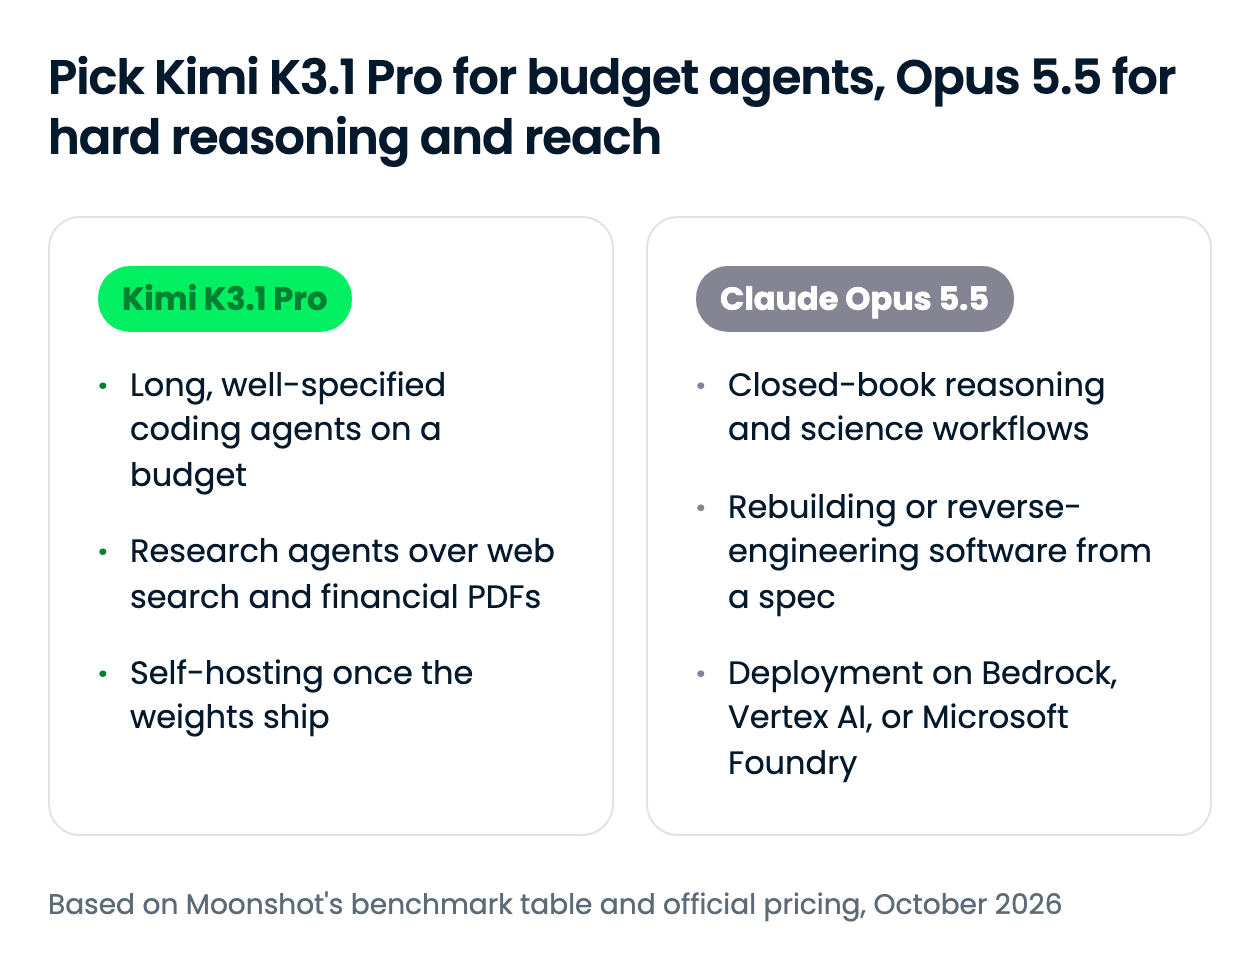
A escolha opõe preço a amplitude: o Kimi K3.1 Pro corta a tarifa por token pela metade, e o Opus 5.5 cobre os casos de raciocínio em que o Kimi fica atrás e as plataformas de nuvem onde o Kimi ainda não está confirmado. Se seu agente roda majoritariamente em contexto em cache, a economia fica mais perto de um terço do que da metade.
Você pode chamar os dois modelos hoje pelas APIs próprias ou pelo OpenRouter, e o Opus 5.5 também roda no Amazon Bedrock, Vertex AI e Microsoft Foundry.
| Superfície | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| App para consumidor | Kimi.com, apps mobile do Kimi, app desktop Kimi Work | Apps do Claude (Pro, Max, Team, Enterprise) |
| API própria | Kimi API (compatível com OpenAI) | Claude API |
| Plataformas de nuvem | Ainda indisponível no Azure AI Foundry ou Amazon Bedrock em 29 out 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Agentes de coding | Kimi Code (ainda indisponível no GitHub Copilot e Cursor em 29 out 2026) | Claude Code, Cursor, GitHub Copilot |
| Roteadores de terceiros | OpenRouter | OpenRouter |
| Pesos abertos | Previstos para 4 de novembro de 2026 | Não |
| ID do modelo na API | kimi-k3.1-pro |
claude-opus-5-5 |
O alcance é o fator decisivo para muitos times: o Opus 5.5 está em todas as grandes nuvens e nos agentes de coding mainstream, enquanto o Kimi K3.1 Pro está confirmado apenas nas superfícies da própria Moonshot e no OpenRouter até os pesos chegarem. Nas APIs próprias, os IDs são kimi-k3.1-pro e claude-opus-5-5; no OpenRouter são moonshotai/kimi-k3.1-pro e anthropic/claude-opus-5.5.
O endpoint compatível com OpenAI do OpenRouter torna os dois modelos uma simples troca de string, o jeito mais fácil de fazer A/B com seus próprios prompts.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # troque por "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Encontre a race condition neste worker pool..."}],
)
print(response.choices[0].message.content)
Nosso tutorial da API do Opus 5.5 aprofunda o lado do Claude, e nosso explicador sobre OpenCode mostra como plugar qualquer um dos modelos em um agente de coding open-source.
O Kimi K3.1 Pro iguala o Claude Opus 5.5 em coding no terminal e vence em execuções longas com muitas ferramentas, com um bom desconto. Se seus agentes rodam tarefas longas, bem definidas e com ferramentas, use o Kimi; se precisam raciocinar sozinhos, lidar com especificações vagas ou viver em AWS, Google Cloud ou Azure, use o Opus.
O que mais me chama atenção é como os dois laboratórios tratam o mesmo risco de formas opostas: a Moonshot corta a capacidade ciber dos pesos antes de publicá-los, e a Anthropic mantém no modelo e controla no serving. Eu testaria o Kimi via OpenRouter e voltaria a avaliar o self-hosting quando os pesos e a licença chegarem em novembro.
Se você quer construir com modelos como esses, recomendo conferir nossa trilha Associate AI Engineer for Developers.
Aprenda IA com a DataCamp!
Programa
Curso
Pratique e programa seu progresso.
Continuar Com O Googleblog
Abid Ali Awan
9 min
blog
Richie Cotton
7 min
blog
Abid Ali Awan
8 min
Tutorial
Abid Ali Awan
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
11 min