

Programma
Ingegnere AI associato per sviluppatori
26 ore
Pratica and corso your progress.
Continua Con GoogleMoonshot AI ha rilasciato Kimi K3.1 Pro nell’ottobre 2026 con un’affermazione insolitamente specifica: su Terminal-Bench 4.0, il suo nuovo modello a pesi aperti si posiziona a un punto di distanza da Claude Opus 5.5, il top di gamma che Anthropic ha lanciato il 22 settembre. Lo fa a metà del prezzo per token di Anthropic, e Moonshot promette i pesi scaricabili entro il 4 novembre.
In questo articolo confronto Kimi K3.1 Pro e Claude Opus 5.5 su coding agentico, ragionamento, lavori di agenti pesanti sugli strumenti, controlli di sicurezza e quanto costa davvero farli girare.
Se ti interessano i nuovi rilasci di modelli, leggi anche le nostre guide sui nuovi flagship di Google, Gemini 4 Carbon e Genie 4. Per restare aggiornato sulle ultime notizie sull’AI, ti consiglio anche di iscriverti alla nostra newsletter settimanale, The Median.
Kimi K3.1 Pro è il modello di punta di Moonshot AI, rilasciato nell’ottobre 2026 come versione post-trained di Kimi K3 con pesi aperti promessi entro il 4 novembre.
Il suo punto di forza è il reinforcement learning su larga scala: Moonshot ha eseguito RL congiunto su centinaia di domini a valle, che si nota soprattutto nel coding a lungo orizzonte, nella ricerca finanziaria e nella creazione 3D.
La nostra guida a Kimi K3.1 Pro copre il lancio in dettaglio.
Claude Opus 5.5 è il flagship chiuso di Anthropic e il primo modello della famiglia Claude 5.5, rilasciato il 22 settembre 2026.
Anthropic lo propone come prestazioni a livello di Claude Fable 5.1 sulla maggior parte dei lavori a un prezzo inferiore rispetto a Opus 5, con i migliori punteggi che abbia misurato sul suo audit di allineamento automatico.
La nostra guida a Claude Opus 5.5 copre il lancio; il nostro tutorial sull’API di Opus 5.5 spiega come costruire un investigatore di incidenti AI.
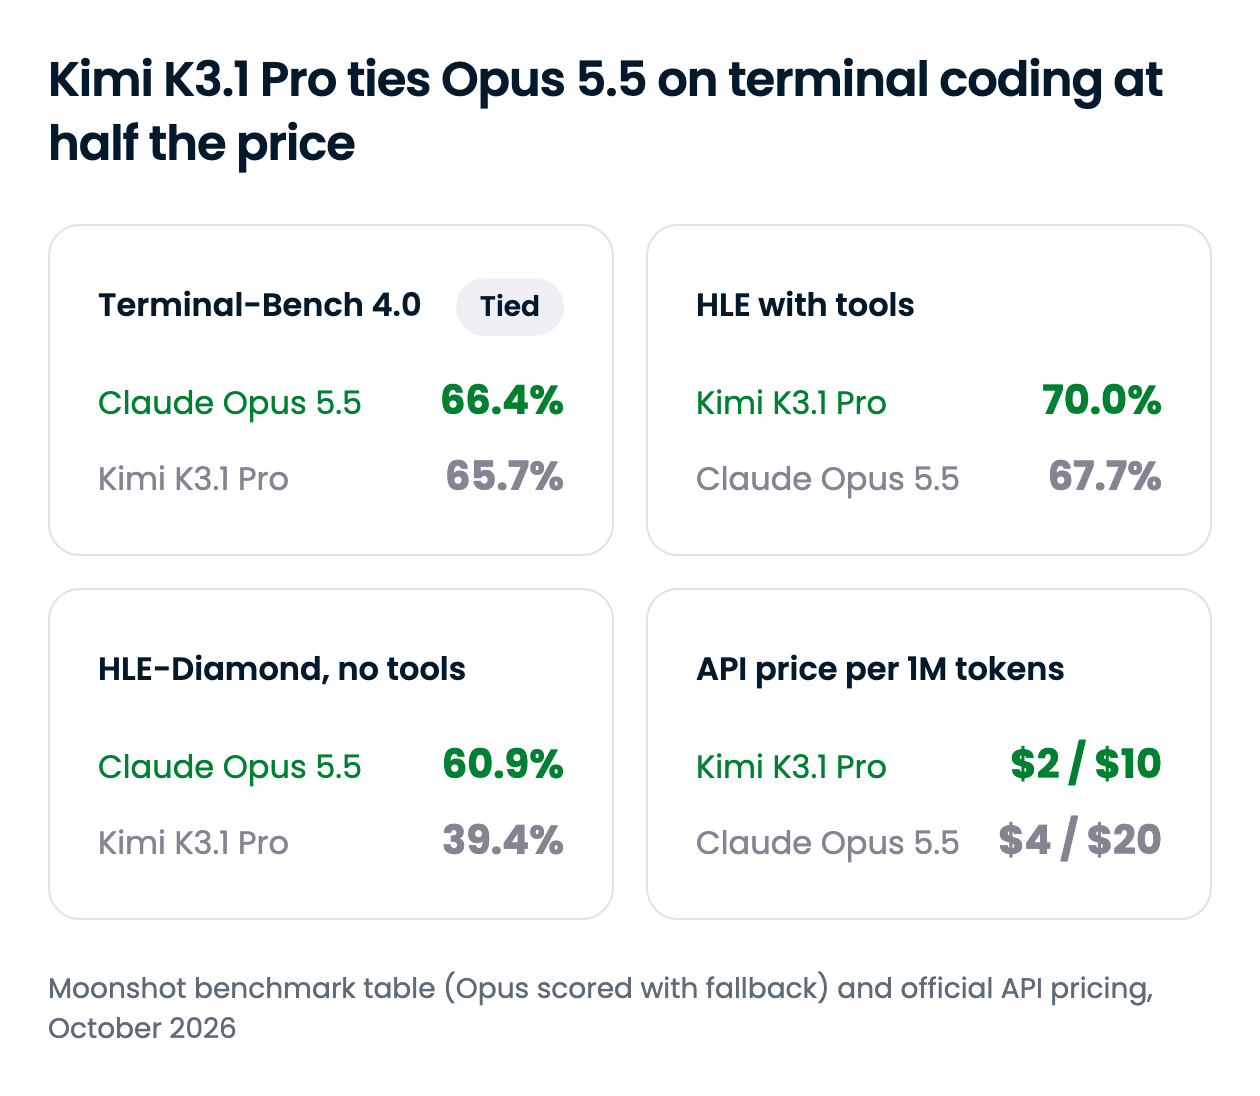
Kimi K3.1 Pro vince sul prezzo e nel lavoro di agenti che fanno largo uso di strumenti; Opus 5.5 vince ogni volta che il modello deve ragionare senza aiuti o risolvere un problema sotto-specificato. Il riepilogo qui sotto copre ogni dimensione, e le sezioni successive approfondiscono dove il divario cambia la scelta.
| Caratteristica | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Sviluppatore | Moonshot AI | Anthropic |
| Rilascio | Ottobre 2026 | 22 settembre 2026 |
| Pesi | Pesi aperti previsti entro il 4 novembre 2026 (licenza non ancora annunciata) | Chiusi |
| Finestra di contesto | 1M token | 1M token |
| Output massimo | Fino a 1.048.576 token (131.072 di default) | 128K token (300K su Batch API, beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Coding a lungo orizzonte (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Ragionamento a libro chiuso (HLE-Diamond) | 39,4% | 60,9% |
| Ragionamento con strumenti (HLE con strumenti) | 70,0% | 67,7% |
| Cyber offensivo (ExploitBench) | 74,7 | 91,0 |
| Prezzo API | Metà di Opus 5.5 su input e output | Riferimento |
| Dove puoi eseguirlo | API Kimi, app Kimi, OpenRouter | API Claude, app Claude, AWS, Google Cloud, Azure, principali agenti di coding |
Una precisazione vale per ogni punteggio in questa sezione. I numeri a confronto provengono dalla tabella benchmark di Moonshot, che contrassegna ciascun risultato di Opus 5.5 come "con fallback": le salvaguardie di Anthropic affidano alcune attività di cyber e biologia ad altri modelli Claude (Opus 4.8 e Opus 5, rispettivamente), cosa che probabilmente abbassa quei punteggi.
I due modelli sono di fatto allo stesso livello su Terminal-Bench 4.0, ma questo dato di testa nasconde una reale spaccatura. Kimi K3.1 Pro è avanti nelle tracce a lungo orizzonte, mentre Opus 5.5 domina, di molto, dove il compito è aperto.
Il maggior divario è su ProgramBench, che chiede a un modello di ricostruire un programma dal suo binario e dalla specifica. Opus 5.5 porta il 65,0% dei task ad almeno il 95% dei test superati, mentre Kimi K3.1 Pro arriva al 31,5%, meno della metà.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Note |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi eseguito nell’harness di Claude Code; Opus a sforzo xhigh secondo Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Task di ingegneria multi-ora |
| DeepSWE v1.1 | 75,5% | 74,2% | Setup proprio di ciascun laboratorio, quindi da considerare un pareggio |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | 58,5% | Benchmark interno di Moonshot |
| ProgramBench (punteggio binario) | 31,5% | 65,0% | Quota di task che ottengono almeno il 95% |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | La tabella di Anthropic riporta 58,7% per Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi eseguito su GPU H20 anziché H100 |
| BenchCAD con strumenti | 92,7% | 96,2% | Ricostruzione 3D tramite codice CAD |
Il pattern è coerente. Dai a Kimi K3.1 Pro un compito di ingegneria ben definito e molto tempo, e lui continua: la demo di Moonshot lo ha visto correggere 36 errori nei calcoli dei muscoli della spalla di un simulatore di camminata umana su 167 missioni. La storia equivalente di Anthropic è una traduzione da C a Rust di HAProxy che ha superato quasi tutti i test di regressione di HAProxy.
Quando la specifica è scarna, Opus prende il largo. ProgramBench, i workflow di ricerca scientifica e gli esperimenti di post-training richiedono di capire anche solo quale sia il compito, ed è lì che la resistenza di Kimi sulle lunghe distanze smette di ripagare.
Per agenti di coding lunghi e ben specificati, Kimi K3.1 Pro è una vera alternativa; per reverse engineering, codice di ricerca e ticket vaghi, Opus 5.5 è la scelta più sicura.
Togli gli strumenti e Opus 5.5 è chiaramente in testa. Il divario più ampio è su HLE-Diamond, il sottoinsieme più difficile da 1.000 domande di Humanity’s Last Exam, dove Opus segna 60,9% contro il 39,4% di Kimi.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Note |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2.500 domande, senza strumenti |
| HLE-Diamond | 39,4% | 60,9% | Le 1.000 domande più difficili |
| GPQA-Diamond | 94,2% | 93,9% | Vicino alla saturazione; un pareggio |
| MMMU-Pro | 84,1% | 87,7% | Domande su immagini e testo |
| Kimi Hallu Bench (più basso è meglio) | 5,4% | 6,8% | Interno Moonshot; tasso di allucinazione a livello di affermazione |
Pareggiano su GPQA-Diamond, che è troppo vicino al suo tetto per distinguere. Il tasso di allucinazioni inferiore di Kimi proviene dallo stress test di Moonshot, quindi lo tratterei più come segnale che il lavoro sull’accuratezza fattuale è riuscito che come verdetto testa a testa. Per il ragionamento a libro chiuso, Opus 5.5 è il modello più forte.
Metti in mano a entrambi gli strumenti e il risultato sul ragionamento si ribalta. Su Humanity’s Last Exam con strumenti, Kimi K3.1 Pro ottiene 70,0% contro il 67,7% di Opus, e guida la maggior parte delle tracce di ricerca e documenti di Moonshot.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Note |
|---|---|---|---|
| HLE-Full con strumenti | 70,0% | 67,7% | Stesse domande, strumenti consentiti |
| BrowseComp | 92,1% | 90,8% | Informazioni web difficili da trovare |
| OfficeQA Pro v2 | 64,4 | 62,2 | Analisi numerica su PDF finanziari |
| Frontier Finance | 58,6 | 56,7 | Workflow d’investimento, dallo screening alla redditività |
| AutomationBench-AA | 73,3 | 69,5 | Versione Artificial Analysis, non quella di Zapier |
| OSWorld V2.1 | 79,6% | 81,8% | Uso di un computer desktop |
| APEX-Agents | 67,2 | 73,5 | Classifica Mercor |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Le vittorie di Kimi sono piccole ma costanti su ricerca e documenti finanziari. Opus mantiene il vantaggio sull’uso del computer e sulle classifiche di agenti di terze parti, quindi Kimi K3.1 Pro è il miglior agente di ricerca e Opus 5.5 il miglior agente da desktop e ufficio generale.
Entrambi i modelli leggono lo stesso contesto e pensano sempre: né Moonshot né Anthropic consentono di disattivare il reasoning. Le preimpostazioni però differiscono. Kimi K3.1 Pro gira a sforzo max a meno che tu non imposti low o high, mentre Opus 5.5 predefinisce medium, quindi una chiamata Kimi non ottimizzata spende più reasoning per richiesta.
Il tetto dell’output è il divario pratico più grande. Kimi K3.1 Pro può restituire in una sola chiamata un output pari all’intera finestra di contesto, circa otto volte il tetto di Opus 5.5 fuori dalla Batch API. I builder di agenti che migrano a Opus dovrebbero anche sapere che l’uso forzato degli strumenti ora restituisce un errore 400.
Entrambi i laboratori limitano la capacità cyber offensiva, ma in modi opposti. Moonshot ha rimosso dati relativi al cyber dal mid-training e dall’RL per il rilascio a pesi aperti, riducendo il suo benchmark interno di exploit da 90,5% a 81,0%. Anthropic mantiene la capacità in Opus 5.5 e reindirizza la maggior parte delle richieste di cybersecurity a Opus 4.8 al momento del serving.
Su ExploitBench, Opus segna 91,0 contro 74,7 di Kimi, e Moonshot afferma apertamente che K3.1 Pro resta dietro ai modelli proprietari di frontiera sul cyber per scelta progettuale. Il compromesso è il controllo: una volta pubblicati i pesi, puoi eseguire Kimi sulla tua infrastruttura, cosa che Opus non offre.
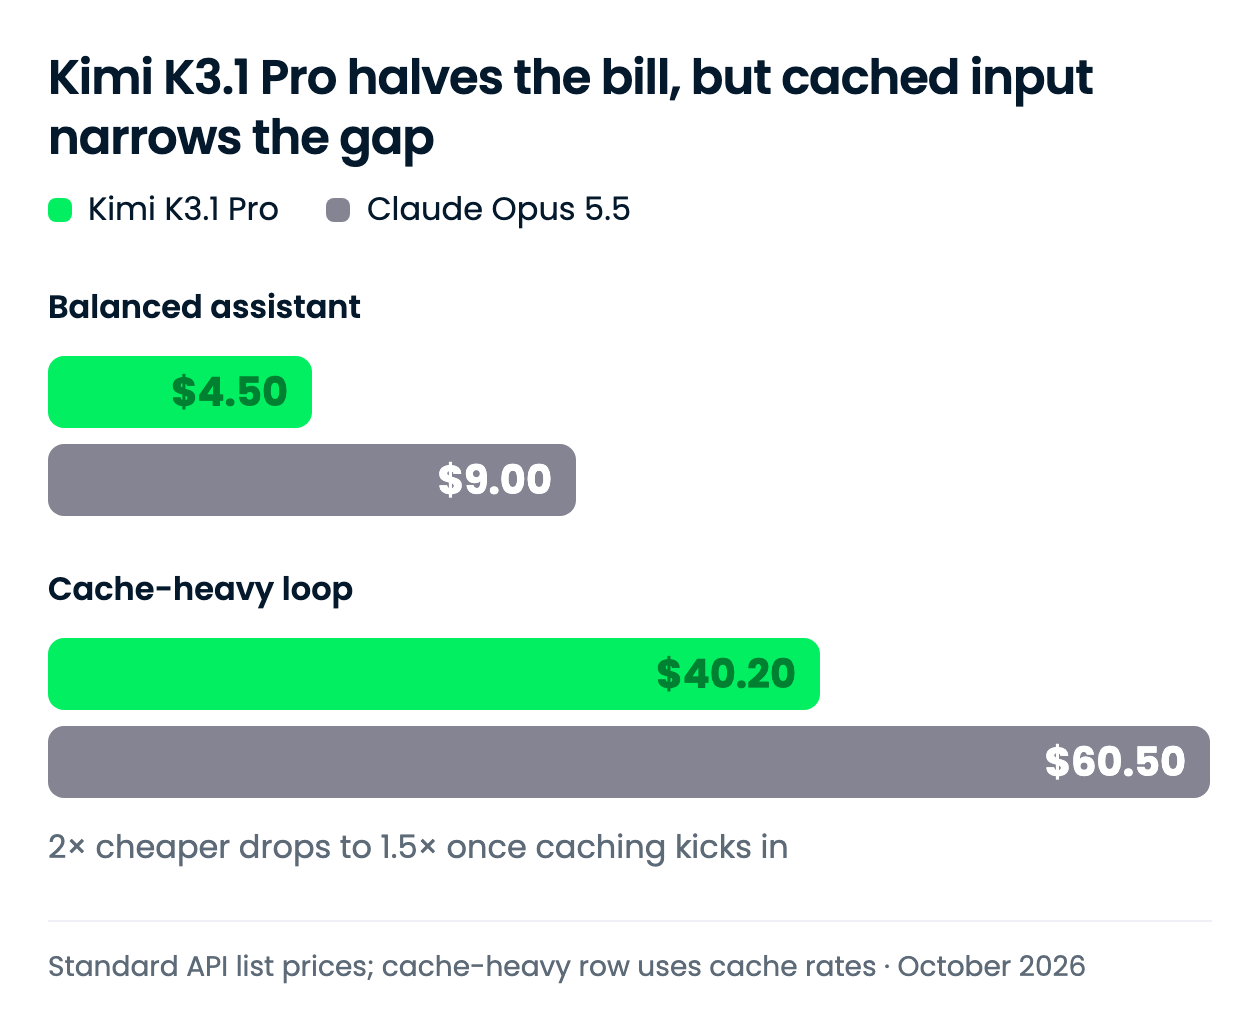
Kimi K3.1 Pro costa la metà di Opus 5.5 sui token freschi. Il risparmio si riduce quando un carico gira su contesto in cache, perché entrambi i fornitori fanno pagare uguale per una lettura da cache.
Tutte le tariffe sono per 1M token, tratte dalle pagine prezzi ufficiali di Moonshot e Anthropic.
| Tariffa | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M token | $2,00 | $4,00 |
| Output, per 1M token | $10,00 | $20,00 |
| Lettura input in cache, per 1M token | $0,20 | $0,20 |
| Scrittura cache, TTL 5 minuti | $2,00 | $5,00 |
| Scrittura cache, TTL 1 ora | $4,00 | $8,00 |
| Variante più veloce | K3.1 Pro Highspeed, velocità 2–3x: $4,00 / $20,00 | Fast mode, fino a 2,5x: $8,00 / $40,00 |
Il multiplo non è uniforme: 0,5x su input, output e scritture cache a 1 ora, 0,4x sulle scritture cache a 5 minuti e 1,0x sulle letture cache. Nessuno dei due applica un sovrapprezzo per contesti lunghi.
Dal quadro emergono due particolarità. La variante Highspeed di Kimi costa esattamente quanto l’Opus standard. La Batch API di Anthropic dimezza Opus a $2 e $10, allineandolo alla tariffa standard di Kimi, mentre la pagina prezzi di Moonshot non elenca sconti per batch.
Ho scelto due profili di carico mensile: un assistente bilanciato come ancoraggio di scala e un loop di agente con uso intenso di cache, perché è sui prezzi della cache che i due listini divergono.
| Carico | Kimi K3.1 Pro | Claude Opus 5.5 | Differenza |
|---|---|---|---|
| Assistente bilanciato: 1M in / 250K out | $4,50 | $9,00 | $4,50 (Kimi costa il 50% in meno) |
| Loop pesante su cache: prefisso da 100K scritto una volta, 1.000 letture in cache, più 5K input freschi / 1K output per richiesta | $40,20 | $60,50 | $20,30 (Kimi costa il 34% in meno) |
Ogni totale è (volume ÷ 1M) × tariffa, sommando input, output e righe di cache; la riga del loop su cache usa la scrittura con TTL 5 minuti. La riga bilanciata riflette semplicemente il divario di tariffa 2x.
La riga cache-heavy è quella su cui pianificare. I 100M token in cache costano $20 su entrambi i modelli, quindi solo i token freschi e la scrittura in cache portano lo sconto di Kimi, e il risparmio scende a circa un terzo. Anthropic afferma che le letture cache costituiscono la maggior parte dei costi del coding agentico, quindi gli agenti di lunga durata si avvicineranno più a questa riga che alla prima.
I due modelli usano tokenizer diversi, e nessuno dei fornitori ha pubblicato conteggi di token per un carico condiviso, quindi considera questi totali come un confronto di tariffe, non come una fattura.
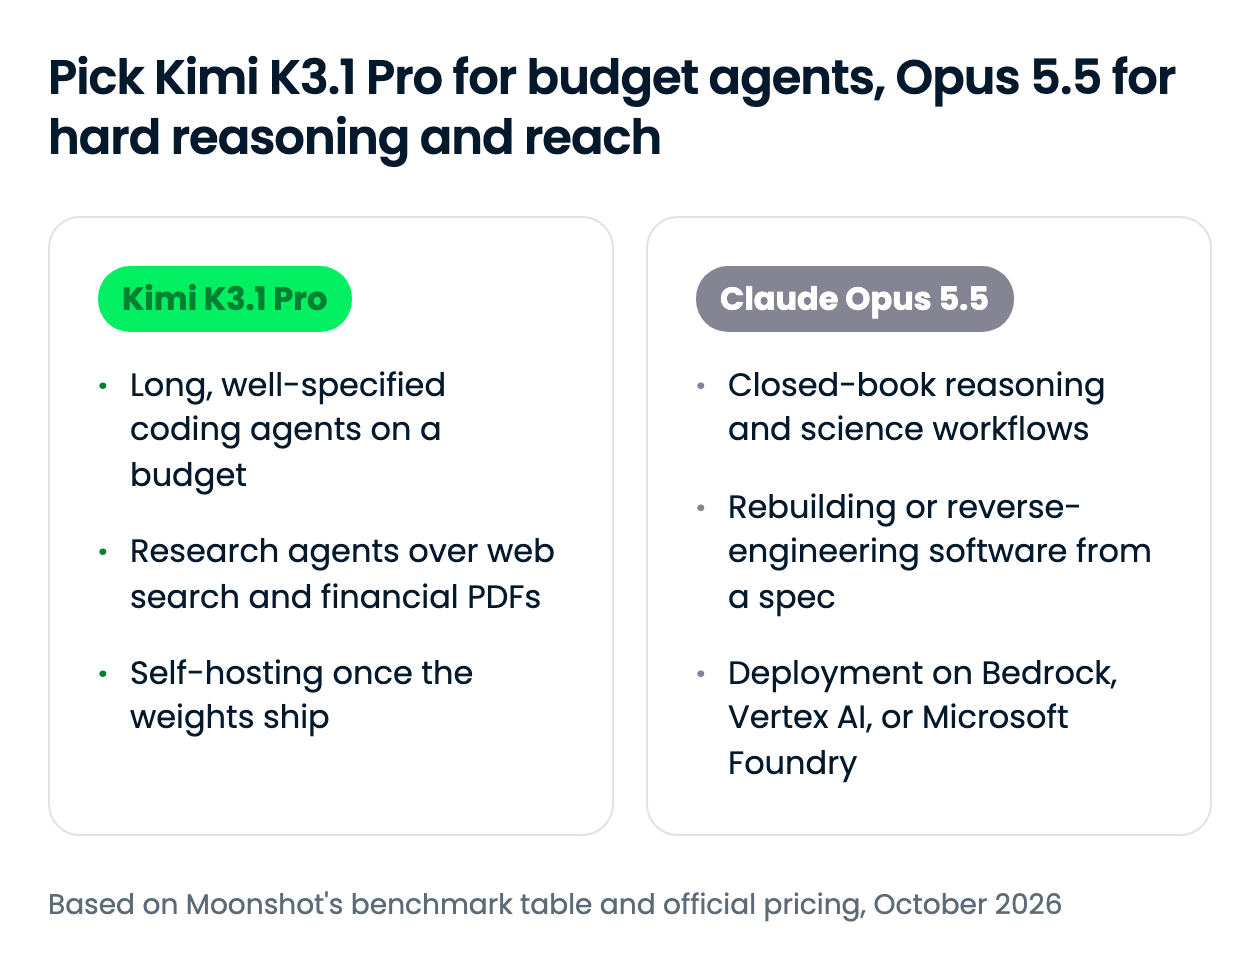
Il bivio è prezzo contro ampiezza: Kimi K3.1 Pro dimezza la tariffa per token, e Opus 5.5 copre i casi di ragionamento in cui Kimi è indietro e le piattaforme cloud su cui Kimi non è confermato. Se il tuo agente gira soprattutto su contesto in cache, il risparmio è più vicino a un terzo che a metà.
Puoi chiamare entrambi i modelli oggi tramite le loro API o tramite OpenRouter, e Opus 5.5 gira anche su Amazon Bedrock, Vertex AI e Microsoft Foundry.
| Superficie | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| App consumer | Kimi.com, app Kimi, app desktop Kimi Work | App Claude (Pro, Max, Team, Enterprise) |
| API first-party | API Kimi (compatibile OpenAI) | API Claude |
| Piattaforme cloud | Non ancora disponibile su Azure AI Foundry o Amazon Bedrock al 29 ott 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Agenti di coding | Kimi Code (non ancora disponibile in GitHub Copilot e Cursor al 29 ott 2026) | Claude Code, Cursor, GitHub Copilot |
| Router di terze parti | OpenRouter | OpenRouter |
| Pesi aperti | Previsti entro il 4 novembre 2026 | No |
| ID modello API | kimi-k3.1-pro |
claude-opus-5-5 |
Per molte squadre, il fattore decisivo è la portata: Opus 5.5 è su tutti i principali cloud e negli agenti di coding mainstream, mentre Kimi K3.1 Pro è confermato solo sulle superfici di Moonshot e su OpenRouter finché non arrivano i pesi. Sulle API first-party gli ID modello sono kimi-k3.1-pro e claude-opus-5-5; su OpenRouter sono moonshotai/kimi-k3.1-pro e anthropic/claude-opus-5.5.
L’endpoint di OpenRouter compatibile con OpenAI rende i due modelli intercambiabili con una stringa, il modo più semplice per fare A/B sui tuoi prompt.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Il nostro tutorial sull’API di Opus 5.5 approfondisce il lato Claude, e il nostro articolo su OpenCode mostra come collegare entrambi i modelli a un agente di coding open-source.
Kimi K3.1 Pro eguaglia Claude Opus 5.5 nel coding da terminale e lo supera nelle esecuzioni lunghe e ricche di strumenti, con uno sconto significativo. Se i tuoi agenti eseguono compiti lunghi e ben definiti con strumenti, usa Kimi; se ragionano senza aiuto, inseguono specifiche vaghe o devono vivere su AWS, Google Cloud o Azure, usa Opus.
Trovo interessante soprattutto come i due laboratori gestiscono in modo diverso lo stesso rischio: Moonshot taglia la capacità cyber dai pesi prima di pubblicarli, e Anthropic la mantiene nel modello e la controlla al momento del serving. Testerei Kimi tramite OpenRouter e riprenderei in considerazione il self-hosting quando pesi e licenza arriveranno a novembre.
Se vuoi costruire con modelli di questo tipo, dai un’occhiata al nostro percorso Associate AI Engineer for Developers.
Impara l’AI con DataCamp!
Programma
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



