

トラック
開発者向けアソシエイトAIエンジニア
26時間
練習とトラックであなたの進捗を記録しましょう。
Googleで登録Moonshot AI は 2026 年 10 月、Kimi K3.1 Pro を発表しました。主張は異例に具体的で、Terminal-Bench 4.0 において、9 月 22 日に Anthropic が出荷したフラッグシップ Claude Opus 5.5 とほぼ同点だというものです。しかも Anthropic のトークン単価の半額で達成し、重みは 11 月 4 日までにダウンロード可能になると約束しています。
この記事では、エージェントによるコーディング、推論、ツールを多用するエージェント作業、安全制御、そして実際の運用コストという観点で、Kimi K3.1 Pro と Claude Opus 5.5 を比較します。
最新モデルのリリースに関心がある場合は、Google の最新フラッグシップである Gemini 4 Carbon と Genie 4 のガイドもぜひご覧ください。Tまた、最新の AI ニュースを追うには、週刊ニュースレター The Median の購読をおすすめします。
Kimi K3.1 Pro は Moonshot AI のフラッグシップモデルで、2026 年 10 月に Kimi K3 の事後学習版としてリリースされ、重みは 11 月 4 日までに公開予定です。
強みはスケールした強化学習です。Moonshot は数百の下流ドメインにまたがって共同 RL を実行しており、その効果は長期視点のコーディング、ファイナンスリサーチ、3D 生成で最も顕著です。
詳細は Kimi K3.1 Pro ガイドをご覧ください。
Claude Opus 5.5 は Anthropic のクローズドなフラッグシップで、Claude 5.5 ファミリー最初のモデルとして 2026 年 9 月 22 日にリリースされました。
Anthropic は、Opus 5 より低価格で、ほとんどの作業において Claude Fable 5.1 相当の性能を発揮し、同社の自動アライメント監査で過去最高のスコアを記録したと説明しています。
ローンチの詳細は Claude Opus 5.5 ガイド、Opus 5.5 API チュートリアルでは AI インシデント調査官の構築手順を解説しています。
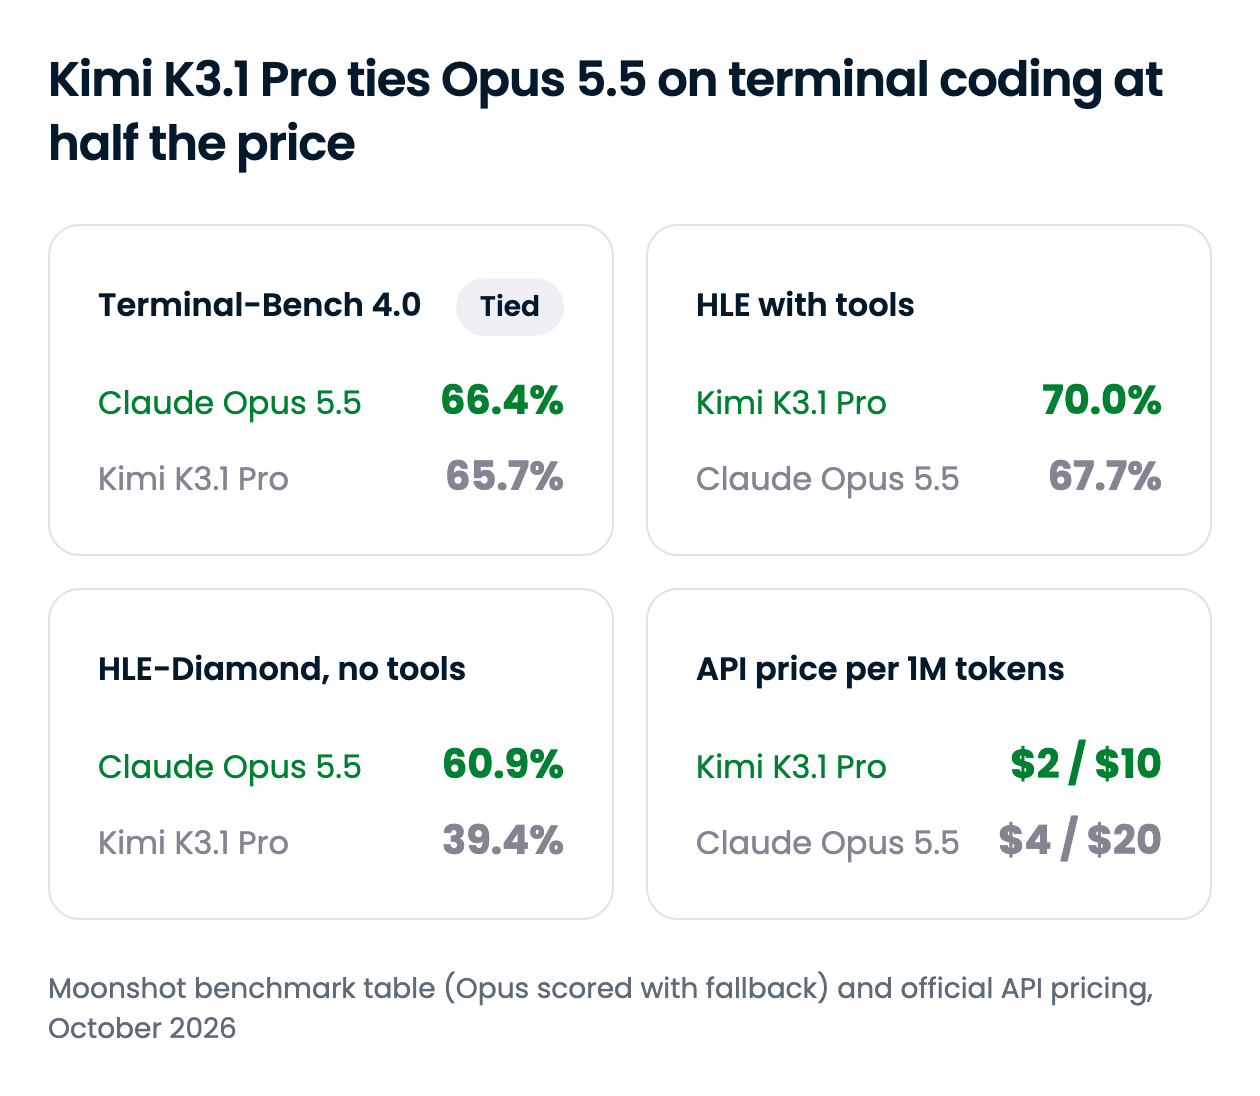
Kimi K3.1 Pro は価格とツール依存のエージェント作業で優位、Opus 5.5 は支援なしでの推論や曖昧な課題の解決で優勢です。以下のサマリーは各側面を網羅し、その後のセクションで意思決定に影響する差を掘り下げます。
| 項目 | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| 開発元 | Moonshot AI | Anthropic |
| リリース | 2026 年 10 月 | 2026 年 9 月 22 日 |
| 重み | 2026 年 11 月 4 日までに公開予定(ライセンスは未発表) | 非公開 |
| コンテキストウィンドウ | 100 万トークン | 100 万トークン |
| 最大出力 | 最大 1,048,576 トークン(デフォルト 131,072) | 128K トークン(Batch API は 300K、ベータ) |
| Terminal-Bench 4.0 | 65.7% | 66.4% |
| 長期コーディング(SWE-Marathon v1.1) | 51.7% | 46.3% |
| クローズドブック推論(HLE-Diamond) | 39.4% | 60.9% |
| ツール支援推論(HLE with tools) | 70.0% | 67.7% |
| 攻撃的サイバー(ExploitBench) | 74.7 | 91.0 |
| API 価格 | 入力・出力ともに Opus 5.5 の半額 | 基準 |
| 実行可能な場所 | Kimi API、Kimi アプリ、OpenRouter | Claude API、Claude アプリ、AWS、Google Cloud、Azure、主要なコーディングエージェント |
ここでの全スコアには留意点があります。ヘッドツーヘッドの数値は Moonshot のベンチマーク表に基づき、各 Opus 5.5 の結果に「フォールバックあり」と明記されています。Anthropic のセーフガードにより、サイバーやバイオの一部タスクは他の Claude モデル(それぞれ Opus 4.8、Opus 5)に回されており、これがスコアを押し下げている可能性があります。
両モデルは Terminal-Bench 4.0 で実質同水準ですが、その見出しの裏には明確な棲み分けがあります。Kimi K3.1 Pro は長期行の課題でリードし、Opus 5.5 はタスクがオープンエンドな場面で大差をつけます。
最大の差は ProgramBench で、バイナリと仕様からプログラムを再構築させる課題です。Opus 5.5 は 65.0% のタスクで合格率 95% 以上に到達する一方、Kimi K3.1 Pro は 31.5% にとどまり、半分未満です。
| ベンチマーク | Kimi K3.1 Pro | Claude Opus 5.5 | 備考 |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | Kimi は Claude Code のハーネスで実行、Opus は Anthropic 定義の xhigh effort |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 複数時間に及ぶエンジニアリングタスク |
| DeepSWE v1.1 | 75.5% | 74.2% | 各研究室の独自設定のため実質同点 |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | 58.5% | Moonshot 内部ベンチマーク |
| ProgramBench(バイナリスコア) | 31.5% | 65.0% | 95%以上を達成したタスクの割合 |
| Terminal-Bench Science 0.1 | 38.1% | 63.3% | Anthropic 公表表では Opus は 58.7% |
| PostTrainBench v1.2 | 36.5% | 43.8% | Kimi は H100 ではなく H20 GPU で実行 |
| BenchCAD with tools | 92.7% | 96.2% | CAD コードによる 3D 再構成 |
傾向は一貫しています。明確に定義されたエンジニアリングタスクと十分な時間を与えると、Kimi K3.1 Pro は粘り強くやり遂げます。Moonshot のデモでは、肩の筋計算を含む人間歩行シミュレーターで発生した 36 件のエラーを、167 ミッションにわたって修正しました。Anthropic の事例は、HAProxy の C から Rust への翻訳で、HAProxy 自身の回帰テストのほぼすべてを通過しています。
一方で仕様が薄いと Opus が先行します。ProgramBench、科学研究ワークフロー、事後学習の実験は、そもそもタスクの見立てが重要で、そこで Kimi の長距離耐性は報われにくくなります。
長時間・明確な仕様のコーディングエージェントには Kimi K3.1 Pro が有力な選択肢。リバースエンジニアリング、研究コード、曖昧なチケットには Opus 5.5 が無難です。
ツールを外すと、Opus 5.5 が明確に優勢です。最大の差は HLE-Diamond(Humanity's Last Exam の最難 1,000 問)で、Opus が 60.9%、Kimi は 39.4% です。
| ベンチマーク | Kimi K3.1 Pro | Claude Opus 5.5 | 備考 |
|---|---|---|---|
| HLE-Full | 51.1% | 59.8% | 2,500 問、ツールなし |
| HLE-Diamond | 39.4% | 60.9% | 最難の 1,000 問 |
| GPQA-Diamond | 94.2% | 93.9% | 上限付近で差がつかず、実質同点 |
| MMMU-Pro | 84.1% | 87.7% | 画像・テキスト混在の設問 |
| Kimi Hallu Bench(低いほど良い) | 5.4% | 6.8% | Moonshot 内部テスト。事実性改善の指標と見るのが妥当 |
GPQA-Diamond は天井が近く差が出ません。Kimi の低い幻覚率は Moonshot のストレステストによるもので、ヘッドツーヘッドの決定打というより、事実性向上の成果と捉えるのが適切でしょう。クローズドブック推論では Opus 5.5 が優勢です。
両モデルにツールを与えると、推論の優位は逆転します。Humanity's Last Exam のツールありでは、Kimi K3.1 Pro が 70.0%、Opus は 67.7% で、Moonshot のリサーチ・文書系の多くでも Kimi が先行します。
| ベンチマーク | Kimi K3.1 Pro | Claude Opus 5.5 | 備考 |
|---|---|---|---|
| HLE-Full(ツールあり) | 70.0% | 67.7% | 同一設問、ツール使用可 |
| BrowseComp | 92.1% | 90.8% | 見つけにくい Web 情報の探索 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 財務 PDF 横断の数値解析 |
| Frontier Finance | 58.6 | 56.7 | 投資ワークフロー(スクリーニングから収益性まで) |
| AutomationBench-AA | 73.3 | 69.5 | Artificial Analysis 版(Zapier 版ではない) |
| OSWorld V2.1 | 79.6% | 81.8% | デスクトップ操作 |
| APEX-Agents | 67.2 | 73.5 | Mercor リーダーボード |
| AA-Briefcase v1.1(Elo) | 1678 | 1803 | Artificial Analysis |
検索や財務文書では Kimi の小幅ながら安定した勝ちが目立ちます。コンピュータ操作やサードパーティのエージェント系リーダーボードでは Opus が優位で、リサーチエージェントは Kimi K3.1 Pro、デスクトップ・一般的オフィス業務のエージェントは Opus 5.5 が適しています。
両モデルとも同じサイズのコンテキストを読み、常に思考を行います。Moonshot も Anthropic も推論オフの切り替えは提供していません。ただしデフォルトは異なります。Kimi K3.1 Pro は指定がなければ max、明示的に low または high を設定可能。一方で Opus 5.5 はデフォルトが medium で、無調整の Kimi 呼び出しは 1 リクエスト当たりの推論コストが高めになりがちです。
実務上の差としては出力上限が大きいです。Kimi K3.1 Pro は 1 回の呼び出しでコンテキスト全体に匹敵する出力を返せ、Batch API を除くと Opus 5.5 の上限の約 8 倍です。Opus への移行時には、強制的なツール使用が 400 エラーを返すようになった点にも注意してください。
両ラボは攻撃的サイバー能力を抑制していますが、手法は正反対です。Moonshot は公開重みに向けて学習途中と RL からサイバー関連データを除去し、内部のエクスプロイト系ベンチマークは 90.5% から 81.0% に低下。一方 Anthropic は Opus 5.5 に能力を残したまま、提供時に多くのサイバーセキュリティリクエストを Opus 4.8 にリルートします。
ExploitBench では Opus が 91.0、Kimi は 74.7。Moonshot は K3.1 Pro が意図的に最前線のクローズドモデルよりサイバーで控えめに設計されていると明言しています。その代わり、重みが出荷されれば自社インフラで Kimi を実行でき、これは Opus にはない利点です。
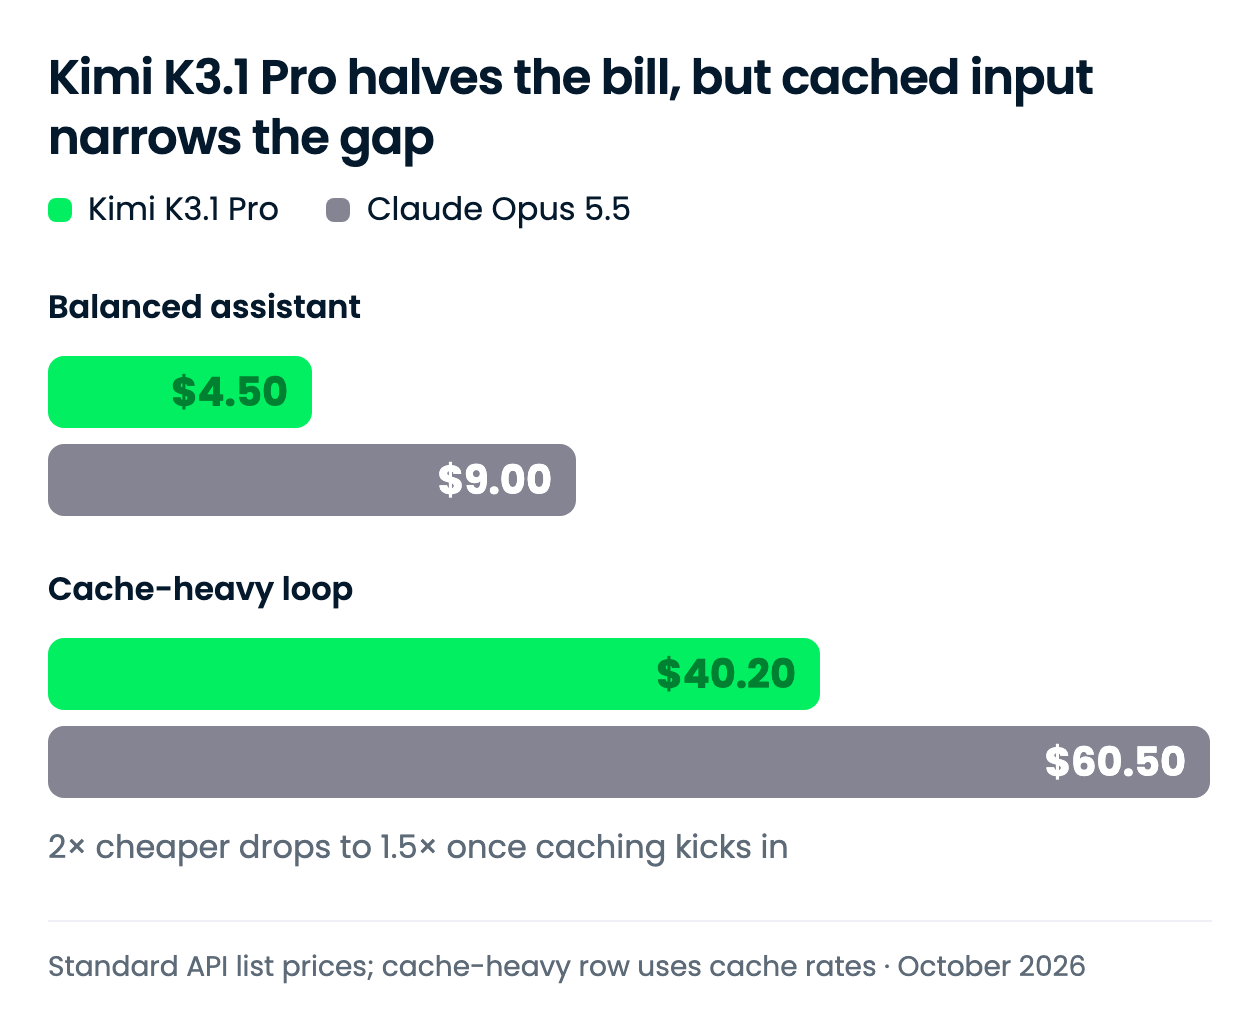
Kimi K3.1 Pro は新規トークンで Opus 5.5 の半額です。ワークロードがキャッシュ済みコンテキストに依存するほど節約幅は縮みます。両社ともキャッシュ読み出しは同一料金だからです。
すべて 100 万トークン当たりの料金で、Moonshot と Anthropic の公式価格ページに基づきます。
| 料金項目 | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| 入力(100 万トークン) | $2.00 | $4.00 |
| 出力(100 万トークン) | $10.00 | $20.00 |
| キャッシュ入力読み出し(100 万トークン) | $0.20 | $0.20 |
| キャッシュ書き込み(TTL 5 分) | $2.00 | $5.00 |
| キャッシュ書き込み(TTL 1 時間) | $4.00 | $8.00 |
| 高速版 | K3.1 Pro Highspeed、2–3 倍速:$4.00 / $20.00 | Fast モード、最大 2.5 倍速:$8.00 / $40.00 |
倍率は一様ではありません。入力・出力・1 時間キャッシュ書き込みは 0.5 倍、5 分キャッシュ書き込みは 0.4 倍、キャッシュ読み出しは 1.0 倍です。いずれのベンダーも長コンテキストの追加料金はありません。
表から読み取れる注意点が 2 つあります。Kimi の Highspeed 版は標準の Opus と同額です。Anthropic の Batch API は Opus を $2 と $10 に半減させ、Kimi の標準レートと一致しますが、Moonshot の価格ページにはバッチ割引の記載がありません。
月次のワークロードを 2 パターン想定しました。基準としてバランス型アシスタント、そしてキャッシュ料金に差が出るためキャッシュ依存のエージェントループです。
| ワークロード | Kimi K3.1 Pro | Claude Opus 5.5 | 差額 |
|---|---|---|---|
| バランス型アシスタント:入力 100 万 / 出力 25 万 | $4.50 | $9.00 | $4.50(Kimi が 50% 安い) |
| キャッシュ依存ループ:10 万トークンのプレフィックスを 1 回書き込み、1,000 回キャッシュ読み出し、各リクエストで新規入力 5,000 / 出力 1,000 | $40.20 | $60.50 | $20.30(Kimi が 34% 安い) |
各合計は(ボリューム ÷ 100 万)× 単価を入力・出力・キャッシュ行で合計。キャッシュ依存の行は 5 分 TTL の書き込みを使用しています。バランス型は単純に 2 倍のレート差です。
計画上重要なのはキャッシュ依存の方です。キャッシュ読み出し 1 億トークン分はどちらも $20 で、Kimi の割引が効くのは新規トークンとキャッシュ書き込みのみ。そのため節約は約 3 分の 1 に縮まります。Anthropic によれば、エージェント的コーディングのコストの大半はキャッシュ読み出しが占めるため、長時間稼働のエージェントはこの行に近い着地になります。
両モデルは異なるトークナイザを使用しており、共通ワークロードのトークン数は未公表です。したがって、これらの合計は請求額というよりレート比較として扱ってください。
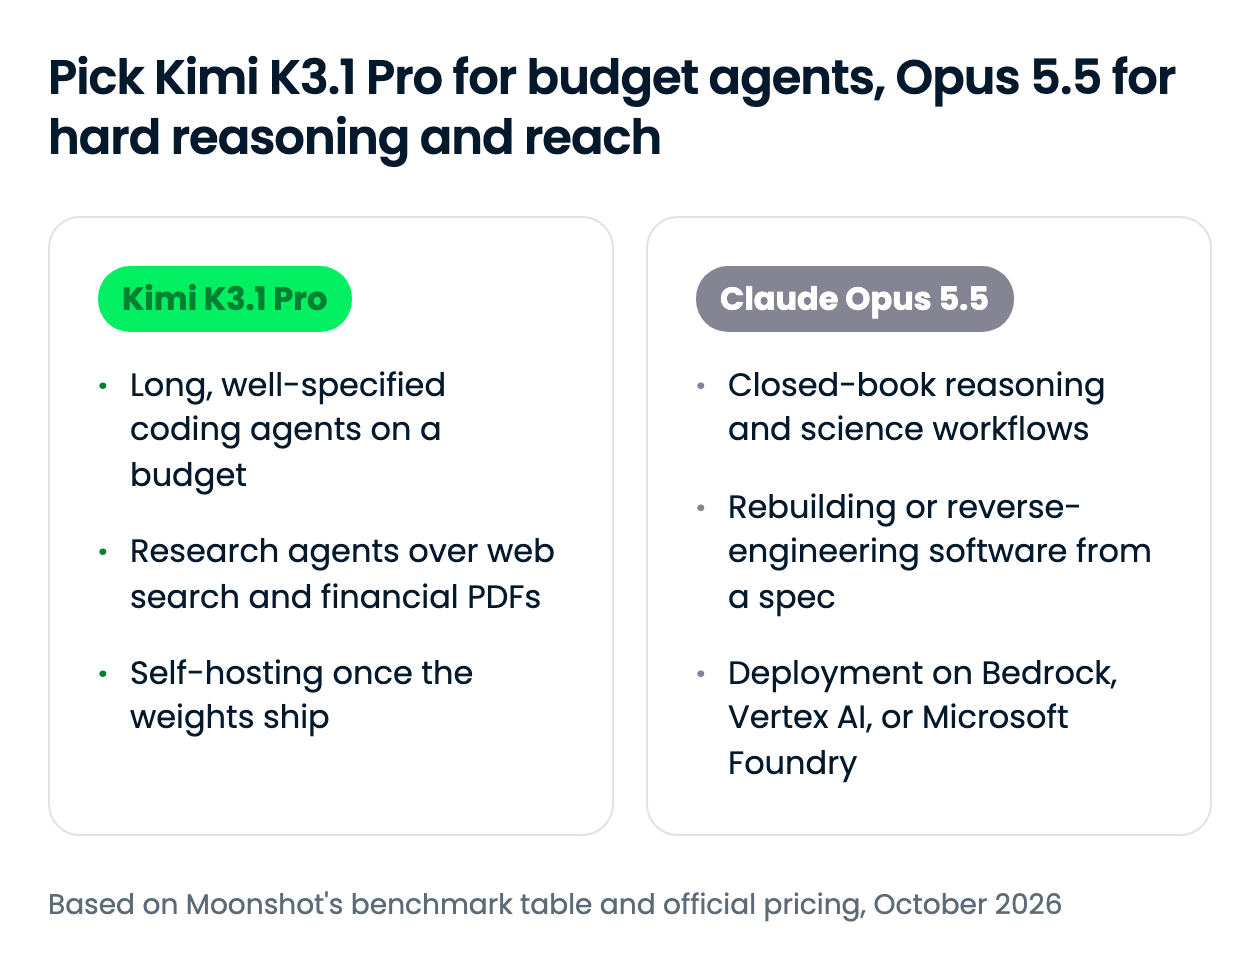
分岐は価格対対応範囲です。Kimi K3.1 Pro はトークン単価を半減させ、Opus 5.5 は Kimi が遅れをとる推論分野と、Kimi が未確認のクラウド基盤をカバーします。エージェントが主にキャッシュ済みコンテキストで動く場合、節約幅は半分ではなく 3 分の 1 程度になります。
両モデルは各社の API あるいは OpenRouter から本日利用できます。Opus 5.5 は Amazon Bedrock、Vertex AI、Microsoft Foundry でも動作します。
| サーフェス | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| コンシューマー向けアプリ | Kimi.com、Kimi モバイルアプリ、Kimi Work デスクトップアプリ | Claude アプリ(Pro、Max、Team、Enterprise) |
| ファーストパーティ API | Kimi API(OpenAI 互換) | Claude API |
| クラウドプラットフォーム | 2026 年 10 月 29 日時点で Azure AI Foundry および Amazon Bedrock では未提供 | Amazon Bedrock、Vertex AI、Microsoft Foundry |
| コーディングエージェント | Kimi Code(2026 年 10 月 29 日時点で GitHub Copilot と Cursor では未提供) | Claude Code、Cursor、GitHub Copilot |
| サードパーティルーター | OpenRouter | OpenRouter |
| 公開重み | 2026 年 11 月 4 日までに提供予定 | なし |
| API モデル ID | kimi-k3.1-pro |
claude-opus-5-5 |
多くのチームにとって決め手は到達範囲です。Opus 5.5 は主要クラウドと主流のコーディングエージェントをすべてカバーする一方、Kimi K3.1 Pro は重み公開までは Moonshot の自社サーフェスと OpenRouter のみが確実です。ファーストパーティ API のモデル ID は kimi-k3.1-pro と claude-opus-5-5、OpenRouter では moonshotai/kimi-k3.1-pro と anthropic/claude-opus-5.5 です。
OpenRouter の OpenAI 互換エンドポイントを使えば、2 つのモデルは文字列 1 つの置き換えで切り替えられ、手元のプロンプトで簡単に A/B テストできます。
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Opus 5.5 API チュートリアルでは Claude 側をさらに詳しく解説し、OpenCode の解説では、いずれのモデルもオープンソースのコーディングエージェントに接続する方法を紹介しています。
Kimi K3.1 Pro はターミナルコーディングで Claude Opus 5.5 と互角、長時間・ツール多用のエージェント実行では優位で、価格面でも有利です。ツールを使う長時間・明確なタスクなら Kimi、支援なしでの推論、曖昧な仕様の解釈、AWS・Google Cloud・Azure 上での運用が必要なら Opus を選んでください。
興味深いのは、両ラボが同じリスクに対して全く異なるアプローチを取っている点です。Moonshot は公開前に重みからサイバー能力を削り、Anthropic はモデルに能力を残したまま提供時にゲートします。まずは OpenRouter で Kimi を試し、11 月に重みとライセンスが出そろったらセルフホスティングを検討するのがよいでしょう。
こうしたモデルでの開発に関心がある場合は、Associate AI Engineer for Developers トラックをおすすめします。
DataCamp で AI を学ぼう!
トラック
コース
練習とトラックであなたの進捗を記録しましょう。
Googleで登録