Cursus
Associate AI Engineer pour développeurs
26 h
S'entraîner et cursus vos progrès.
Continuer Avec GoogleMoonshot AI a lancé Kimi K3.1 Pro en octobre 2026 avec une promesse inhabituelle : sur Terminal-Bench 4.0, son nouveau modèle aux poids ouverts se situe à un point de Claude Opus 5.5, le fleuron d'Anthropic disponible depuis le 22 septembre. Il y parvient pour la moitié du prix par jeton d'Anthropic, et Moonshot annonce la publication des poids téléchargeables d'ici le 4 novembre.
Dans cet article, je compare Kimi K3.1 Pro et Claude Opus 5.5 sur le codage agentique, le raisonnement, le travail d'agent lourd en outils, les contrôles de sécurité, et le coût réel d'exécution.
Si vous suivez les nouvelles sorties de modèles, consultez aussi nos guides sur les nouveaux fleurons de Google, Gemini 4 Carbon et Genie 4. Pour rester au fait de l'actualité IA, je vous recommande aussi notre newsletter hebdomadaire, The Median.
Kimi K3.1 Pro est le modèle phare de Moonshot AI, publié en octobre 2026, version post-entriânée de Kimi K3 avec des poids ouverts annoncés pour le 4 novembre.
Son argument clé : de l'apprentissage par renforcement à grande échelle. Moonshot a entraîné un RL conjoint sur des centaines de domaines aval, ce qui se voit surtout sur le codage à long horizon, la recherche financière et la création 3D.
Notre guide Kimi K3.1 Pro détaille l'annonce.
Claude Opus 5.5 est le fleuron fermé d'Anthropic et le premier modèle de la famille Claude 5.5, publié le 22 septembre 2026.
Anthropic le présente comme offrant des performances de niveau Claude Fable 5.1 sur la plupart des tâches, à un prix inférieur à Opus 5, avec ses meilleurs scores à ce jour sur son audit d'alignement automatisé.
Notre guide Claude Opus 5.5 couvre le lancement ; notre tutoriel API Opus 5.5 montre comment créer un assistant d'enquête sur incidents IA.
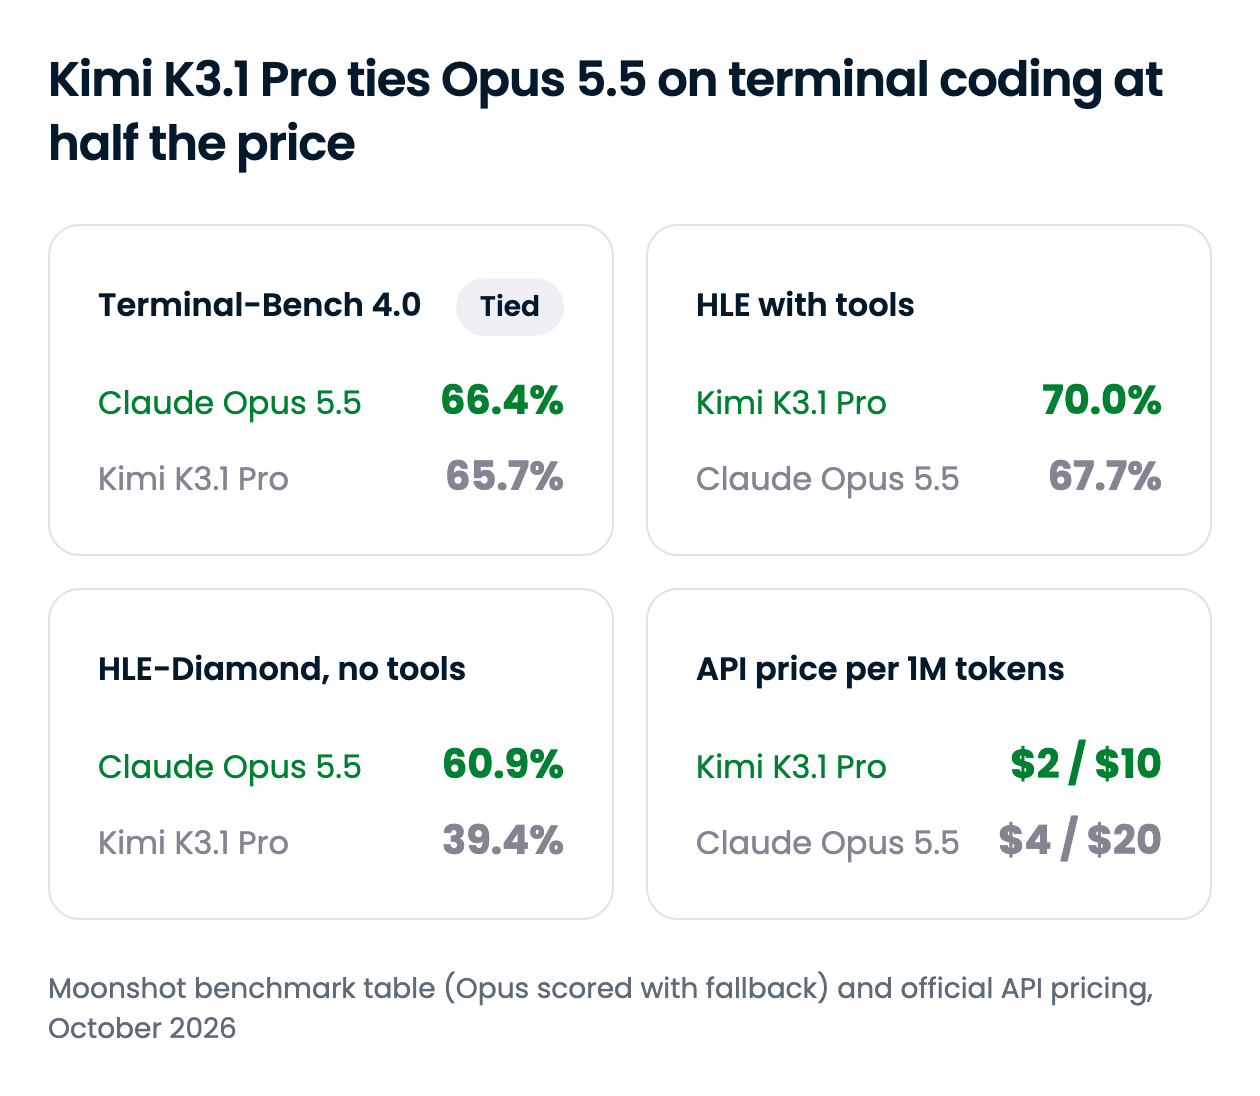
Kimi K3.1 Pro l'emporte sur le prix et sur le travail d'agent qui s'appuie fortement sur les outils ; Opus 5.5 gagne dès que le modèle doit raisonner sans aide ou clarifier une consigne imprécise. Le récapitulatif ci-dessous couvre chaque dimension, et les sections suivantes détaillent celles qui peuvent faire pencher la décision.
| Caractéristique | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Éditeur | Moonshot AI | Anthropic |
| Date de sortie | Octobre 2026 | 22 septembre 2026 |
| Poids | Poids ouverts prévus au plus tard le 4 novembre 2026 (licence non annoncée) | Fermés |
| Fenêtre de contexte | 1 M de jetons | 1 M de jetons |
| Sortie maximale | Jusqu'à 1 48 576 jetons (131 72 par défaut) | 128 K jetons (300 K via l'API Batch, bêta) |
| Terminal-Bench 4.0 | 65,7 % | 66,4 % |
| Codage à long horizon (SWE-Marathon v1.1) | 51,7 % | 46,3 % |
| Raisonnement sans ressources (HLE-Diamond) | 39,4 % | 60,9 % |
| Raisonnement assisté par outils (HLE avec outils) | 70,0 % | 67,7 % |
| Cyber offensif (ExploitBench) | 74,7 | 91,0 |
| Prix API | Moitié du prix d'Opus 5.5 en entrée et en sortie | Référence |
| Où l'exécuter | API Kimi, apps Kimi, OpenRouter | API Claude, apps Claude, AWS, Google Cloud, Azure, principaux agents de codage |
Un avertissement s'applique à tous les scores de cette section : les chiffres proviennent du tableau de benchmarks de Moonshot, qui marque chaque résultat d'Opus 5.5 comme « avec repli » : les garde-fous d'Anthropic redirigent certaines tâches cyber et biologie vers d'autres modèles Claude (Opus 4.8 et Opus 5), ce qui peut tirer ces scores vers le bas.
Les deux modèles sont au coude-à-coude sur Terminal-Bench 4.0, mais ce titre cache une vraie répartition des forces. Kimi K3.1 Pro mène sur les tâches à long horizon, tandis qu'Opus 5.5 domine nettement dès que la tâche est ouverte.
L'écart le plus marqué est ProgramBench, qui demande de reconstruire un programme à partir de son binaire et de sa spécification. Opus 5.5 amène 65,0 % des tâches à au moins 95 % de tests réussis, contre 31,5 % pour Kimi K3.1 Pro, soit moins de la moitié.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Notes |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | 66,4 % | Kimi exécuté dans le harnais Claude Code ; Opus en effort xhigh selon Anthropic |
| SWE-Marathon v1.1 | 51,7 % | 46,3 % | Tâches d'ingénierie sur plusieurs heures |
| DeepSWE v1.1 | 75,5 % | 74,2 % | Configuration propre à chaque labo, à traiter comme une égalité |
| Kimi Code Bench 3.0 long horizon | 61,2 % | 58,5 % | Benchmark interne Moonshot |
| ProgramBench (score binaire) | 31,5 % | 65,0 % | Part des tâches à ≥95 % |
| Terminal-Bench Science 0.1 | 38,1 % | 63,3 % | Le tableau d'Anthropic indique 58,7 % pour Opus |
| PostTrainBench v1.2 | 36,5 % | 43,8 % | Kimi exécuté sur GPU H20 plutôt que H100 |
| BenchCAD avec outils | 92,7 % | 96,2 % | Reconstruction 3D via code CAD |
Le schéma est constant. Donnez à Kimi K3.1 Pro une tâche d'ingénierie bien définie et du temps : il tient la distance. La démonstration de Moonshot le montre corriger 36 erreurs dans le calcul du deltoïde d'un simulateur de marche humaine, en 167 missions. Côté Anthropic, l'histoire équivalente est une traduction C→Rust de HAProxy validée par la quasi-totalité de ses tests de régression.
Lorsque la spéc est lacunaire, Opus passe devant. ProgramBench, les workflows de recherche scientifique et les expériences post-entriânement exigent de définir la tâche elle-même : c'est là que l'endurance de Kimi paye moins.
Pour des agents de codage longs et bien spécifiés, Kimi K3.1 Pro est une vraie alternative ; pour l'ingénierie inverse, le code de recherche et les tickets flous, Opus 5.5 est le choix sûr.
Sans outils, Opus 5.5 mène nettement. L'écart le plus large est sur HLE-Diamond, le sous-ensemble de 1 000 questions le plus difficile de Humanity's Last Exam, où Opus atteint 60,9 % contre 39,4 % pour Kimi.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Notes |
|---|---|---|---|
| HLE-Full | 51,1 % | 59,8 % | 2 500 questions, sans outils |
| HLE-Diamond | 39,4 % | 60,9 % | Les 1 000 questions les plus difficiles |
| GPQA-Diamond | 94,2 % | 93,9 % | Près du plafond ; à considérer comme une égalité |
| MMMU-Pro | 84,1 % | 87,7 % | Questions image et texte |
| Kimi Hallu Bench (plus bas = mieux) | 5,4 % | 6,8 % | Interne Moonshot ; taux d'hallucinations au niveau des affirmations |
Ils font jeu égal sur GPQA-Diamond, trop proche du plafond pour départager. Le taux d'hallucinations plus faible de Kimi vient d'un test interne Moonshot : à lire comme la preuve que le travail sur la factualité a payé, plutôt qu'un verdict direct. Pour le raisonnement en accès fermé, Opus 5.5 est le plus solide.
Avec des outils, la tendance s'inverse. Sur HLE avec outils, Kimi K3.1 Pro atteint 70,0 % contre 67,7 % pour Opus, et il mène la plupart des lignes de recherche et de documents chez Moonshot.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Notes |
|---|---|---|---|
| HLE-Full avec outils | 70,0 % | 67,7 % | Mêmes questions, outils autorisés |
| BrowseComp | 92,1 % | 90,8 % | Recherche Web d'informations difficiles à trouver |
| OfficeQA Pro v2 | 64,4 | 62,2 | Analyses numériques sur des PDF financiers |
| Frontier Finance | 58,6 | 56,7 | Workflows d'investissement, du screening à la rentabilité |
| AutomationBench-AA | 73,3 | 69,5 | Version Artificial Analysis, pas celle de Zapier |
| OSWorld V2.1 | 79,6 % | 81,8 % | Utilisation d'un ordinateur de bureau |
| APEX-Agents | 67,2 | 73,5 | Classement Mercor |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Les gains de Kimi sont modestes mais réguliers sur la recherche et les documents financiers. Opus garde l'avantage sur l'usage du PC et sur les classements d'agents tiers : Kimi K3.1 Pro est donc meilleur comme agent de recherche, et Opus 5.5 comme agent bureautique et desktop généraliste.
Les deux modèles lisent le même volume de contexte, et tous deux « réfléchissent » toujours : ni Moonshot ni Anthropic ne permettent de désactiver le raisonnement. Les défauts diffèrent toutefois : Kimi K3.1 Pro s'exécute en effort max sauf si vous réglez low ou high, tandis qu'Opus 5.5 est en medium par défaut, donc un appel Kimi non ajusté dépense plus de raisonnement par requête.
Le plafond de sortie est l'écart le plus concret. Kimi K3.1 Pro peut renvoyer l'équivalent d'une fenêtre de contexte complète en une seule réponse, soit environ huit fois le plafond d'Opus 5.5 hors API Batch. Les créateurs d'agents qui migrent vers Opus doivent aussi savoir que l'usage forcé d'outils renvoie désormais une erreur 400.
Les deux labos brident la capacité cyber offensive, mais de façon opposée. Moonshot a retiré les données liées au cyber du mid-training et du RL pour la version à poids ouverts, ce qui a fait passer son benchmark d'exploits interne de 90,5 % à 81,0 %. Anthropic conserve cette capacité dans Opus 5.5 et redirige la plupart des requêtes cybersécurité vers Opus 4.8 au moment du service.
Sur ExploitBench, Opus marque 91,0 contre 74,7 pour Kimi, et Moonshot dit clairement que K3.1 Pro reste volontairement derrière les modèles propriétaires de pointe en cyber. Le compromis : une fois les poids publiés, vous pouvez faire tourner Kimi sur votre propre infrastructure, ce qu'Opus ne propose pas.
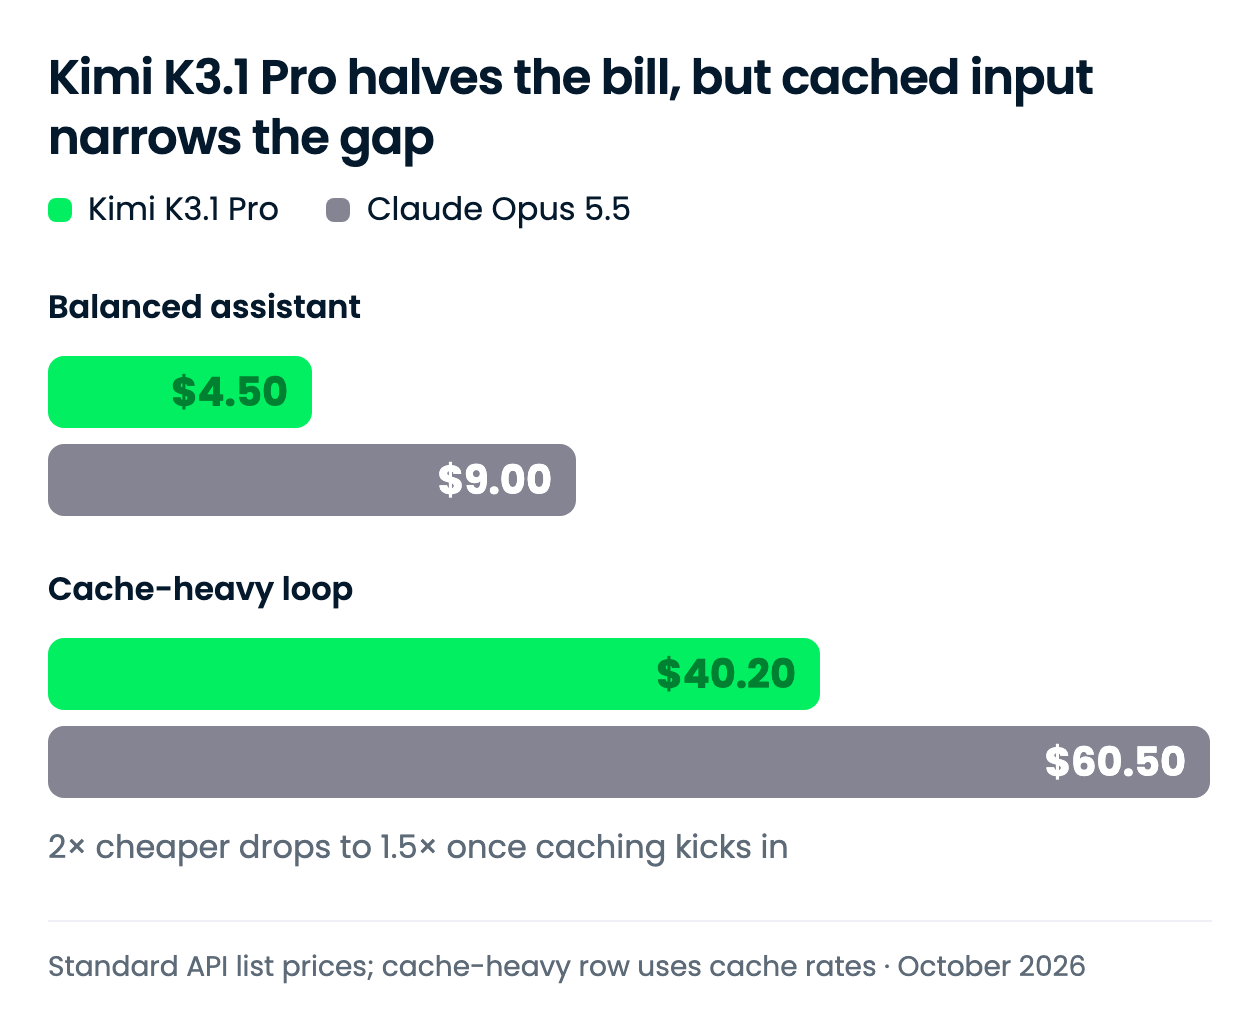
Kimi K3.1 Pro coûte deux fois moins qu'Opus 5.5 sur les jetons non mis en cache. L'économie diminue lorsque la charge s'appuie sur un contexte en cache, car les deux fournisseurs facturent le même prix pour une lecture de cache.
Tous les tarifs sont pour 1 M de jetons, selon les pages de prix officielles de Moonshot et d'Anthropic.
| Tarif | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Entrée, par 1 M de jetons | $2.00 | $4.00 |
| Sortie, par 1 M de jetons | $10.00 | $20.00 |
| Lecture de cache, par 1 M de jetons | $0.20 | $0.20 |
| Écriture cache, TTL 5 min | $2.00 | $5.00 |
| Écriture cache, TTL 1 heure | $4.00 | $8.00 |
| Variante plus rapide | K3.1 Pro Highspeed, 2–3 x plus vite : $4.00 / $20.00 | Mode Fast, jusqu'à 2,5 x plus vite : $8.00 / $40.00 |
Le multiple n'est pas uniforme : 0,5 x sur l'entrée, la sortie et l'écriture cache 1 h, 0,4 x sur l'écriture cache 5 min, et 1,0 x sur les lectures cache. Aucun supplément lié au long contexte chez l'un ou l'autre.
Deux points à noter : la variante Highspeed de Kimi coûte exactement le prix d'Opus standard. L'API Batch d'Anthropic divise par deux les tarifs d'Opus, à $2 et $10, soit l'équivalent du tarif standard de Kimi, alors que la page tarifs de Moonshot n'indique pas de remise batch.
J'ai retenu deux profils mensuels : un assistant équilibré comme point d'ancrage, et une boucle d'agent très à base de cache, car c'est là que les grilles tarifaires divergent.
| Charge | Kimi K3.1 Pro | Claude Opus 5.5 | Écart |
|---|---|---|---|
| Assistant équilibré : 1 M entrée / 250 K sortie | $4.50 | $9.00 | $4.50 (Kimi 50 % moins cher) |
| Boucle à fort cache : préfixe 100 K écrit une fois, 1 000 lectures cache, plus 5 K entrée fraîche / 1 K sortie par requête | $40.20 | $60.50 | $20.30 (Kimi 34 % moins cher) |
Chaque total = (volume ÷ 1 M) × tarif, sommé sur entrée, sortie et lignes cache ; la boucle à fort cache utilise l'écriture cache 5 min. La première ligne reflète le simple écart de x2.
C'est la deuxième ligne qu'il faut anticiper. Les 100 M de jetons lus dans le cache coûtent $20 dans les deux cas, donc seuls les jetons frais et l'écriture cache bénéficient de la remise Kimi ; l'économie tombe à environ un tiers. Anthropic indique que les lectures cache constituent la majorité des coûts du codage agentique, donc les agents de longue durée se rapprocheront plutôt de cette ligne que de la première.
Les deux modèles utilisent des tokenizers différents, et aucun fournisseur n'a publié de décompte de jetons sur une charge partagée ; considérez ces totaux comme une comparaison de tarifs, pas une facture.
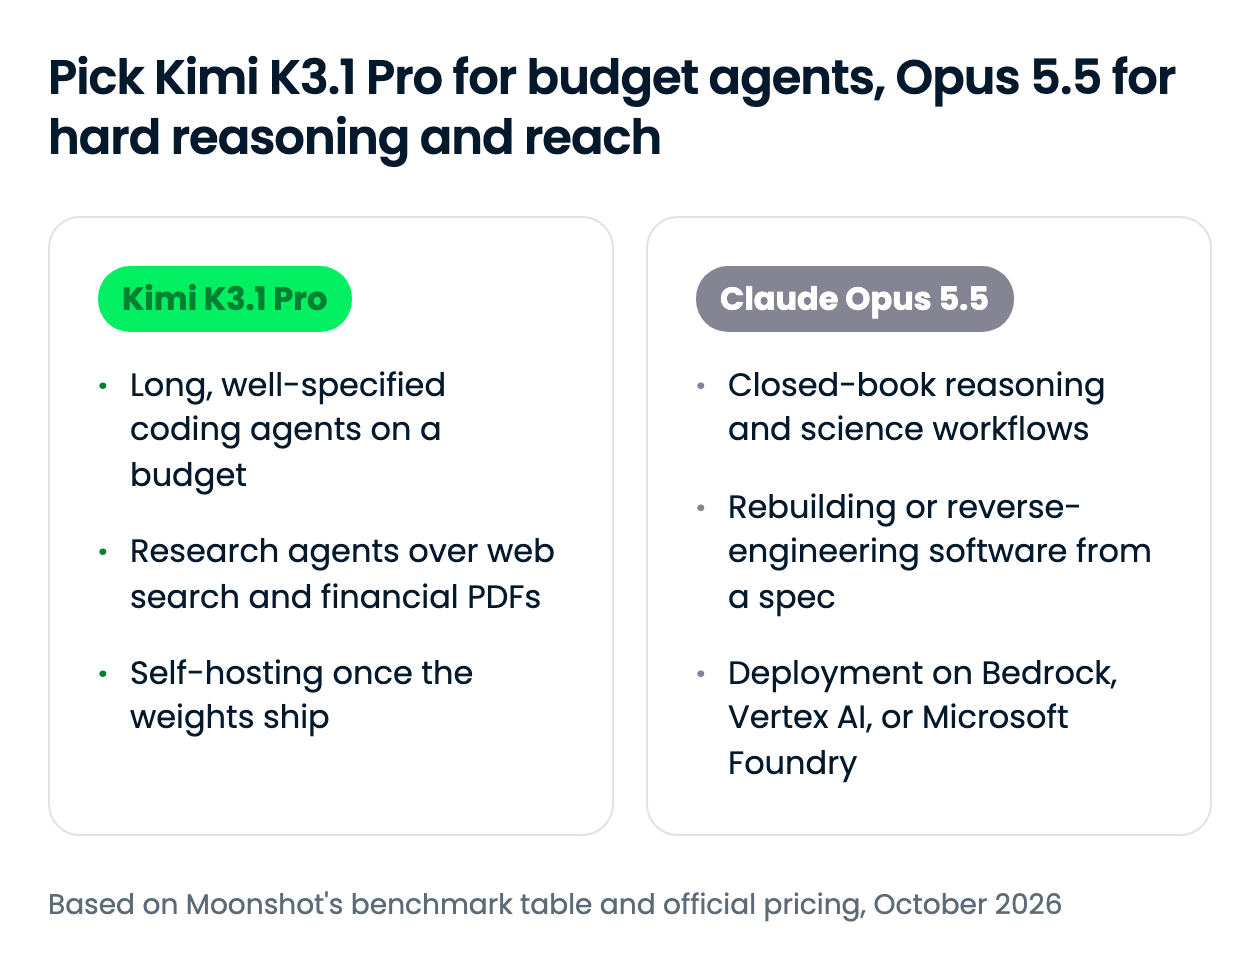
Le choix oppose prix et couverture : Kimi K3.1 Pro divise par deux le tarif par jeton, et Opus 5.5 couvre les cas de raisonnement où Kimi est en retrait et les plateformes cloud où Kimi n'est pas confirmé. Si votre agent tourne surtout sur du contexte en cache, l'économie est plus proche d'un tiers que de la moitié.
Vous pouvez appeler les deux modèles dès aujourd'hui via leurs APIs respectives ou via OpenRouter, et Opus 5.5 est également disponible sur Amazon Bedrock, Vertex AI et Microsoft Foundry.
| Surface | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Application grand public | Kimi.com, apps mobiles Kimi, app desktop Kimi Work | Apps Claude (Pro, Max, Team, Enterprise) |
| API native | API Kimi (compatible OpenAI) | API Claude |
| Plateformes cloud | Pas encore disponible sur Azure AI Foundry ou Amazon Bedrock au 29 oct. 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Agents de codage | Kimi Code (pas encore disponible dans GitHub Copilot et Cursor au 29 oct. 2026) | Claude Code, Cursor, GitHub Copilot |
| Routeurs tiers | OpenRouter | OpenRouter |
| Poids ouverts | Prévus au plus tard le 4 novembre 2026 | Non |
| ID de modèle API | kimi-k3.1-pro |
claude-opus-5-5 |
La différence de portée sera déterminante pour de nombreuses équipes : Opus 5.5 est présent sur tous les grands clouds et dans les agents de codage mainstream, tandis que Kimi K3.1 Pro n'est confirmé que sur les surfaces Moonshot et OpenRouter jusqu'à l'arrivée des poids. Sur les APIs natives, les IDs de modèle sont kimi-k3.1-pro et claude-opus-5-5 ; sur OpenRouter, ce sont moonshotai/kimi-k3.1-pro et anthropic/claude-opus-5.5.
Le point de terminaison compatible OpenAI d'OpenRouter permet de permuter les deux modèles en changeant une seule chaîne : c'est le moyen le plus simple d'A/B tester vos propres invites.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Notre tutoriel API Opus 5.5 va plus loin côté Claude, et notre explication de OpenCode montre comment brancher l'un ou l'autre modèle à un agent de codage open source.
Kimi K3.1 Pro égale Claude Opus 5.5 sur le codage en terminal et le dépasse sur les longs runs d'agents très outillés, avec une remise significative. Si vos agents exécutent des tâches longues, bien définies et outillées, optez pour Kimi ; s'ils doivent raisonner sans aide, gérer des spécs floues ou vivre sur AWS, Google Cloud ou Azure, choisissez Opus.
Ce qui m'intéresse le plus, c'est la manière très différente dont les deux labos gèrent le même risque : Moonshot retire la capacité cyber des poids avant publication, tandis qu'Anthropic la conserve dans le modèle et la filtre à l'exécution. Je testerais Kimi via OpenRouter et je reconsidérerais l'auto-hébergement une fois les poids et la licence disponibles en novembre.
Si vous souhaitez bâtir avec ce type de modèles, je vous recommande notre parcours Associate AI Engineer for Developers.
Formez-vous à l'IA avec DataCamp !
Cursus
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Kurtis Pykes
9 min
blog
Lynn Heidmann
blog
Tutoriel
Tutoriel
Dr Ana Rojo-Echeburúa
12 min
Tutoriel
Laiba Siddiqui
14 min