

트랙
개발자를 위한 AI 엔지니어 보조
26시간
실습 문제하고 트랙하세요.
Google로 계속하기Moonshot AI는 2026년 10월 Kimi K3.1 Pro를 출시하며 이례적으로 구체적인 주장을 내놓았습니다. Terminal-Bench 4.0에서 새 오픈 웨이트 모델이 9월 22일에 출시된 Anthropic의 플래그십 Claude Opus 5.5와 점수 차가 1포인트 이내라는 것입니다. 그 비용은 Anthropic의 토큰당 가격의 절반이며, Moonshot은 11월 4일까지 가중치 다운로드를 약속했습니다.
이 글에서는 Kimi K3.1 Pro와 Claude Opus 5.5를 에이전틱 코딩, 추론, 도구 활용이 많은 에이전트 작업, 안전성 제어, 그리고 실제 운영 비용 측면에서 비교합니다.
새 모델 출시에 관심이 있다면 Google의 최신 플래그십인 Gemini 4 Carbon과 Genie 4 가이드도 꼭 읽어 보세요. 최신 AI 뉴스를 주기적으로 받아보고 싶다면 주간 뉴스레터 The Median 구독도 추천합니다.
Kimi K3.1 Pro는 Moonshot AI의 플래그십 모델로, 2026년 10월 Kimi K3의 포스트 트레이닝 버전으로 출시되었으며, 오픈 웨이트는 11월 4일까지 공개될 예정입니다.
핵심 강점은 대규모 강화학습입니다. Moonshot은 수백 개의 다운스트림 도메인에 걸쳐 공동 RL을 수행했으며, 이 효과는 장기 코딩, 금융 리서치, 3D 생성에서 두드러집니다.
자세한 내용은 Kimi K3.1 Pro 가이드에서 다룹니다.
Claude Opus 5.5는 Anthropic의 클로즈드 플래그십으로, 2026년 9월 22일 출시된 Claude 5.5 계열의 첫 모델입니다.
Anthropic은 Opus 5보다 낮은 가격으로 대부분의 작업에서 Claude Fable 5.1급 성능을 제공한다고 소개하며, 자동화된 정렬 감사에서 측정한 최고 점수를 기록했다고 밝힙니다.
Claude Opus 5.5 가이드에서 출시 내용을, Opus 5.5 API 튜토리얼에서 AI 인시던트 조사관을 구축하는 방법을 확인하세요.
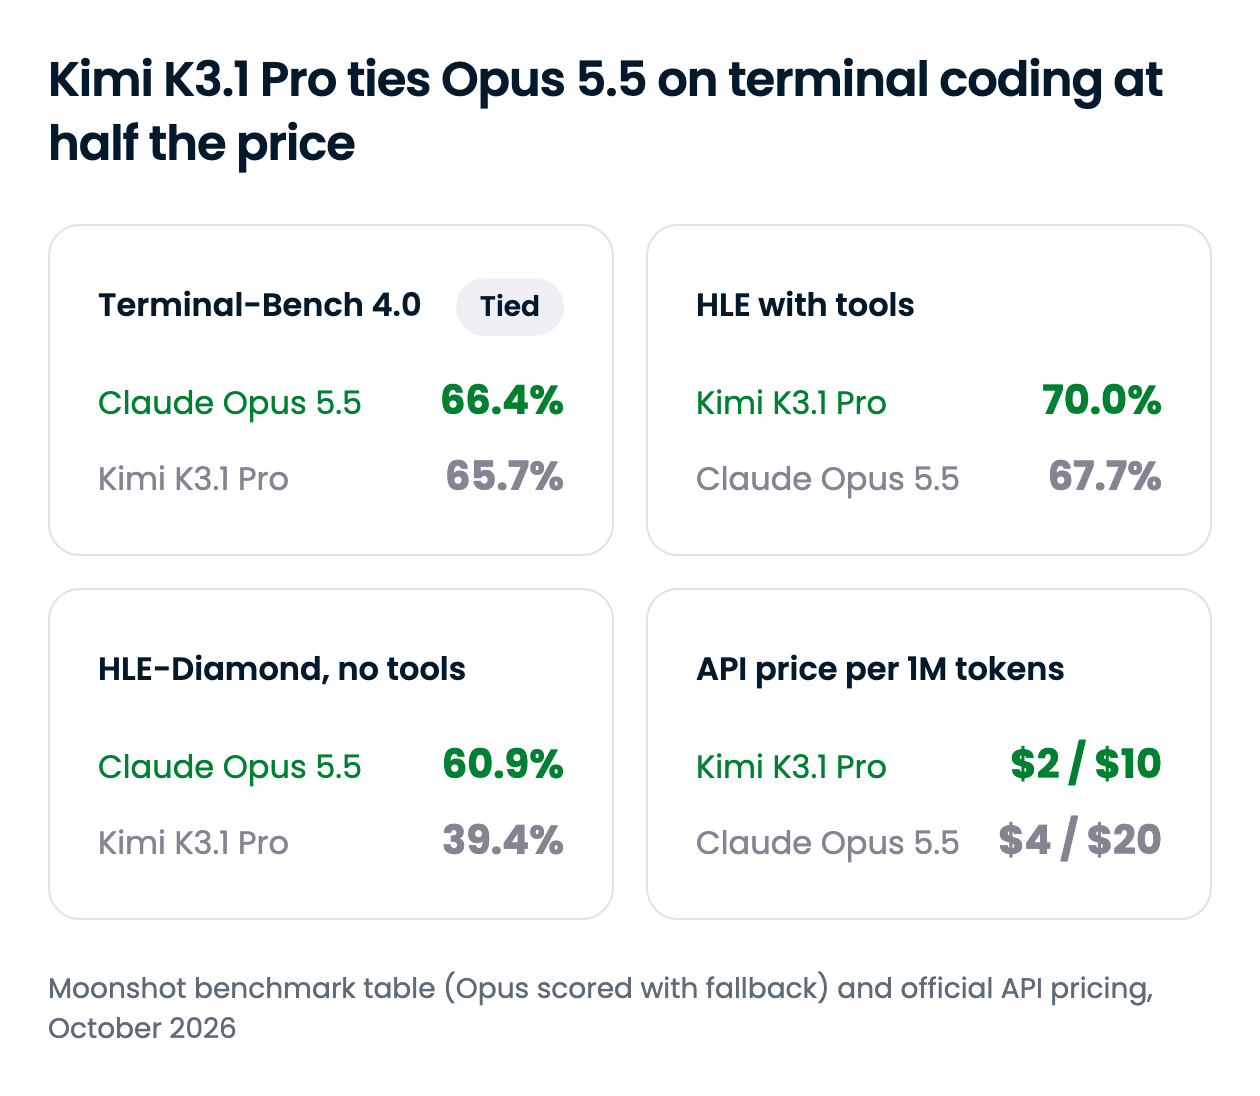
Kimi K3.1 Pro는 가격과 도구 중심 에이전트 작업에서 우세합니다. Opus 5.5는 모델이 도움 없이 추론해야 하거나 사양이 불충분한 문제를 풀어야 할 때 우위를 보입니다. 아래 요약은 모든 측면을 포괄하며, 이어지는 섹션에서는 선택을 바꿀 수 있는 격차가 큰 영역을 자세히 살펴봅니다.
| 기능 | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| 개발사 | Moonshot AI | Anthropic |
| 출시 | 2026년 10월 | 2026년 9월 22일 |
| 가중치 | 2026년 11월 4일까지 오픈 웨이트 예정(라이선스 미정) | 클로즈드 |
| 컨텍스트 윈도우 | 100만 토큰 | 100만 토큰 |
| 최대 출력 | 최대 1,048,576 토큰(기본 131,072) | 128K 토큰(배치 API에서는 300K, 베타) |
| Terminal-Bench 4.0 | 65.7% | 66.4% |
| 장기 코딩(SWE-Marathon v1.1) | 51.7% | 46.3% |
| 클로즈드북 추론(HLE-Diamond) | 39.4% | 60.9% |
| 도구 보조 추론(HLE with tools) | 70.0% | 67.7% |
| 공격적 사이버(ExploitBench) | 74.7 | 91.0 |
| API 가격 | 입력·출력 모두 Opus 5.5의 절반 | 기준 |
| 실행 가능 환경 | Kimi API, Kimi 앱, OpenRouter | Claude API, Claude 앱, AWS, Google Cloud, Azure, 주요 코딩 에이전트 |
이 섹션의 모든 점수에는 하나의 주의점이 있습니다. 정면 비교 수치는 Moonshot의 자체 벤치마크 표에서 가져왔는데, 각 Opus 5.5 결과에 "폴백 있음"으로 표시되어 있습니다. Anthropic의 안전장치가 일부 사이버·생물학 작업을 다른 Claude 모델(Opus 4.8 및 Opus 5)로 넘기며, 이로 인해 점수가 낮아졌을 가능성이 큽니다.
두 모델은 Terminal-Bench 4.0에서 사실상 동급이지만, 그 헤드라인 아래에는 명확한 분화가 있습니다. Kimi K3.1 Pro는 장기 작업에서 앞서고, Opus 5.5는 과제가 개방형일수록 큰 격차로 앞섭니다.
가장 큰 차이는 ProgramBench입니다. 이 벤치마크는 바이너리와 사양에서 프로그램을 재구성하도록 요구합니다. Opus 5.5는 최소 95% 테스트 통과 기준에 65.0%의 작업을 도달시키는 반면, Kimi K3.1 Pro는 31.5%로 절반에도 못 미칩니다.
| 벤치마크 | Kimi K3.1 Pro | Claude Opus 5.5 | 비고 |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | Kimi는 Claude Code 하니스에서 실행; Opus는 Anthropic 기준 xhigh effort |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 수시간 단위 엔지니어링 작업 |
| DeepSWE v1.1 | 75.5% | 74.2% | 각 연구실 자체 설정이므로 사실상 동률 |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | 58.5% | Moonshot 내부 벤치마크 |
| ProgramBench(바이너리 점수) | 31.5% | 65.0% | 최소 95% 득점 작업 비율 |
| Terminal-Bench Science 0.1 | 38.1% | 63.3% | Anthropic 자체 표에서는 Opus 58.7%로 보고 |
| PostTrainBench v1.2 | 36.5% | 43.8% | Kimi는 H100 대신 H20 GPU에서 실행 |
| BenchCAD with tools | 92.7% | 96.2% | CAD 코드로 3D 재구성 |
패턴은 일관적입니다. 명확한 엔지니어링 과제와 충분한 시간을 주면 Kimi K3.1 Pro는 끈질기게 진행합니다. Moonshot의 시연에서는 사람 보행 시뮬레이터의 어깨 근육 계산에서 167개의 미션에 걸쳐 36개의 오류를 수정했습니다. Anthropic의 사례는 HAProxy를 C에서 Rust로 변환해 HAProxy의 회귀 테스트 대부분을 통과시킨 작업입니다.
사양이 빈약하면 Opus가 앞섭니다. ProgramBench, 과학 연구 워크플로, 포스트 트레이닝 실험은 모두 과제 자체를 규정하는 작업이 필요하며, 이 지점에서 Kimi의 장기 지속력은 더 이상 이점을 주지 못합니다.
길고 명확히 정의된 코딩 에이전트에는 Kimi K3.1 Pro가 실질적 대안이지만, 리버스 엔지니어링, 연구용 코드, 모호한 티켓에는 Opus 5.5가 더 안전한 선택입니다.
도구를 제거하면 Opus 5.5가 분명히 우위입니다. 가장 큰 격차는 Humanity's Last Exam의 가장 어려운 1,000문항 하위셋인 HLE-Diamond로, Opus는 60.9%, Kimi는 39.4%입니다.
| 벤치마크 | Kimi K3.1 Pro | Claude Opus 5.5 | 비고 |
|---|---|---|---|
| HLE-Full | 51.1% | 59.8% | 2,500문항, 도구 없음 |
| HLE-Diamond | 39.4% | 60.9% | 가장 어려운 1,000문항 |
| GPQA-Diamond | 94.2% | 93.9% | 포화에 근접; 사실상 동률 |
| MMMU-Pro | 84.1% | 87.7% | 이미지 및 텍스트 문항 |
| Kimi Hallu Bench(낮을수록 좋음) | 5.4% | 6.8% | Moonshot 내부; 주장 단위 환각률 |
GPQA-Diamond에서는 모두 상한에 가까워 우열을 가리기 어렵습니다. Kimi의 낮은 환각률은 Moonshot의 자체 스트레스 테스트 결과이므로, 정합성 개선이 있었음을 시사하는 수준으로 보되 정면 대결의 판정으로 보기는 어렵습니다. 클로즈드북 추론에서는 Opus 5.5가 더 강합니다.
두 모델 모두에게 도구를 주면 추론 결과가 뒤집힙니다. 도구 사용 HLE에서 Kimi K3.1 Pro는 70.0%로 Opus의 67.7%를 앞서며, Moonshot의 리서치·문서 관련 항목 대부분에서 우위를 보입니다.
| 벤치마크 | Kimi K3.1 Pro | Claude Opus 5.5 | 비고 |
|---|---|---|---|
| HLE-Full with tools | 70.0% | 67.7% | 동일 문항, 도구 허용 |
| BrowseComp | 92.1% | 90.8% | 찾기 어려운 웹 정보 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 금융 PDF 전반의 수치 분석 |
| Frontier Finance | 58.6 | 56.7 | 투자 워크플로: 스크리닝부터 수익성까지 |
| AutomationBench-AA | 73.3 | 69.5 | Artificial Analysis 버전(Zipier 것이 아님) |
| OSWorld V2.1 | 79.6% | 81.8% | 데스크톱 컴퓨터 조작 |
| APEX-Agents | 67.2 | 73.5 | Mercor 리더보드 |
| AA-Briefcase v1.1(Elo) | 1678 | 1803 | Artificial Analysis |
Kimi는 검색과 금융 문서에서 작지만 일관된 우세를 보입니다. Opus는 컴퓨터 조작과 서드파티 에이전트 리더보드에서 우위를 유지하므로, 리서치 에이전트는 Kimi K3.1 Pro, 데스크톱·일반 오피스 에이전트는 Opus 5.5가 더 낫습니다.
두 모델 모두 동일한 크기의 컨텍스트를 읽고, 항상 "생각"합니다. Moonshot과 Anthropic 모두 추론 비활성화 옵션을 제공하지 않습니다. 기본값은 다릅니다. Kimi K3.1 Pro는 max 노력이 기본이며 low 또는 high로 설정하지 않으면 요청당 더 많은 추론을 소비합니다. Opus 5.5는 기본이 medium입니다.
실용적으로 더 큰 차이는 출력 상한입니다. Kimi K3.1 Pro는 한 번의 호출에서 전체 컨텍스트 윈도우에 해당하는 출력을 반환할 수 있어, 배치 API 외부에서는 Opus 5.5 상한의 대략 8배입니다. Opus로 마이그레이션하는 에이전트 빌더는 강제 도구 사용이 이제 400 오류를 반환한다는 점도 알아두세요.
양측 연구소는 공격적 사이버 능력을 서로 다른 방식으로 제한합니다. Moonshot은 오픈 웨이트 공개를 앞두고 중간 단계 학습과 RL에서 사이버 관련 데이터를 제거해 내부 익스플로잇 벤치마크 점수가 90.5%에서 81.0%로 하락했습니다. Anthropic은 Opus 5.5 내에 역량을 유지하되, 제공 시점에 사이버 보안 요청 대부분을 Opus 4.8로 재라우팅합니다.
ExploitBench에서 Opus는 91.0, Kimi는 74.7을 기록했으며, Moonshot은 K3.1 Pro가 설계상 사이버 분야에서 프런티어 독점 모델에 뒤처진다고 명시합니다. 그 대신 통제권을 얻습니다. 가중치가 공개되면 자체 인프라에서 Kimi를 실행할 수 있는데, Opus는 이 옵션을 제공하지 않습니다.
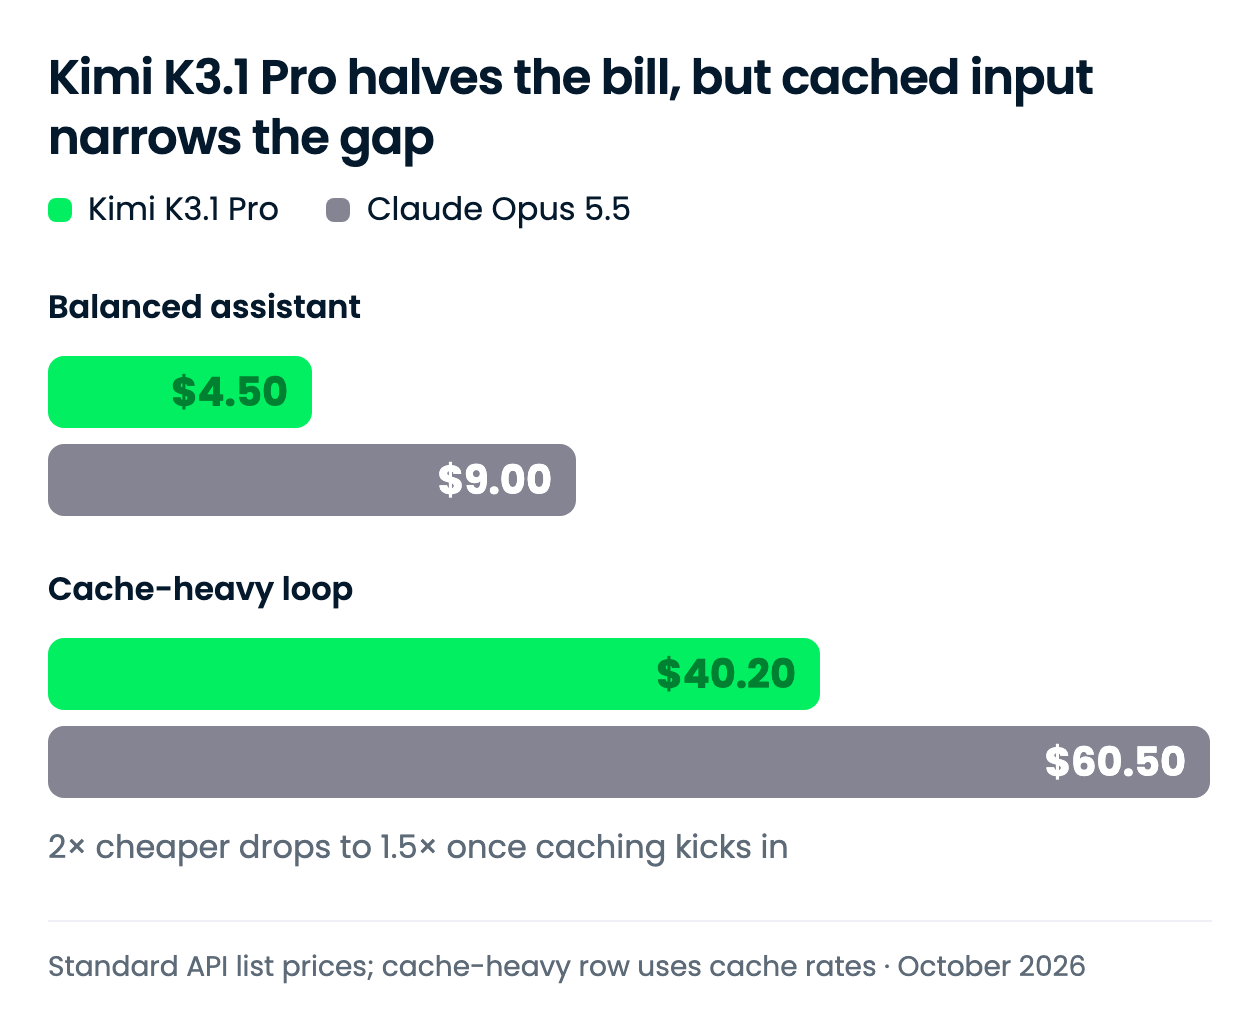
Kimi K3.1 Pro는 신규 토큰에서 Opus 5.5의 절반 비용입니다. 워크로드가 캐시된 컨텍스트에 의존할수록 절감 폭은 줄어듭니다. 두 벤더 모두 캐시 읽기 요금은 동일하게 책정하기 때문입니다.
모든 요금은 100만 토큰 기준이며, Moonshot과 Anthropic의 공식 가격 페이지에서 가져왔습니다.
| 요금 | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| 입력, 100만 토큰당 | $2.00 | $4.00 |
| 출력, 100만 토큰당 | $10.00 | $20.00 |
| 캐시된 입력 읽기, 100만 토큰당 | $0.20 | $0.20 |
| 캐시 쓰기, TTL 5분 | $2.00 | $5.00 |
| 캐시 쓰기, TTL 1시간 | $4.00 | $8.00 |
| 고속 변형 | K3.1 Pro Highspeed, 2–3배 속도: $4.00 / $20.00 | Fast 모드, 최대 2.5배 속도: $8.00 / $40.00 |
배율은 균일하지 않습니다. 입력·출력·1시간 캐시 쓰기는 0.5배, 5분 캐시 쓰기는 0.4배, 캐시 읽기는 1.0배입니다. 두 벤더 모두 장문 컨텍스트 할증을 추가하지 않습니다.
표에서 두 가지 특이점이 드러납니다. Kimi의 Highspeed 변형 요금은 표준 Opus와 정확히 같습니다. Anthropic의 배치 API는 Opus 요금을 $2와 $10으로 절반으로 낮춰 Kimi의 표준 요금과 일치시키며, Moonshot의 가격 페이지에는 배치 할인 표기가 없습니다.
두 가지 월간 워크로드 형태를 골랐습니다. 기준점으로 균형 잡힌 어시스턴트, 그리고 가격표 차이가 나는 캐시 가격을 반영하기 위해 캐시 중심의 에이전트 루프입니다.
| 워크로드 | Kimi K3.1 Pro | Claude Opus 5.5 | 차이 |
|---|---|---|---|
| 균형형 어시스턴트: 입력 100만 / 출력 25만 | $4.50 | $9.00 | $4.50(Kimi가 50% 저렴) |
| 캐시 중심 루프: 10만 토큰 프리픽스 1회 쓰기, 캐시 읽기 1,000회, 요청당 신규 입력 5K / 출력 1K | $40.20 | $60.50 | $20.30(Kimi가 34% 저렴) |
각 합계는 (볼륨 ÷ 100만) × 요금을 입력·출력·캐시 항목별로 합산한 것이며, 캐시 중심 행은 5분 캐시 쓰기를 사용했습니다. 균형형 행은 단순히 2배 요금 격차를 반영합니다.
캐시 중심 행이 특히 중요합니다. 1억 토큰 캐시 읽기 비용은 두 모델 모두 $20이므로, Kimi의 할인은 신규 토큰과 캐시 쓰기에만 적용되어 절감 효과가 약 3분의 1로 줄어듭니다. Anthropic은 에이전틱 코딩 비용의 대다수가 캐시 읽기에서 발생한다고 밝혔으므로, 장기 실행 에이전트는 첫 번째 행보다 이 행에 더 가까운 비용이 나올 것입니다.
두 모델은 서로 다른 토크나이저를 사용하며, 두 벤더 모두 동일 워크로드의 토큰 카운트를 공개하지 않았으므로, 위 합계는 청구서가 아닌 요금 비교로 보아야 합니다.
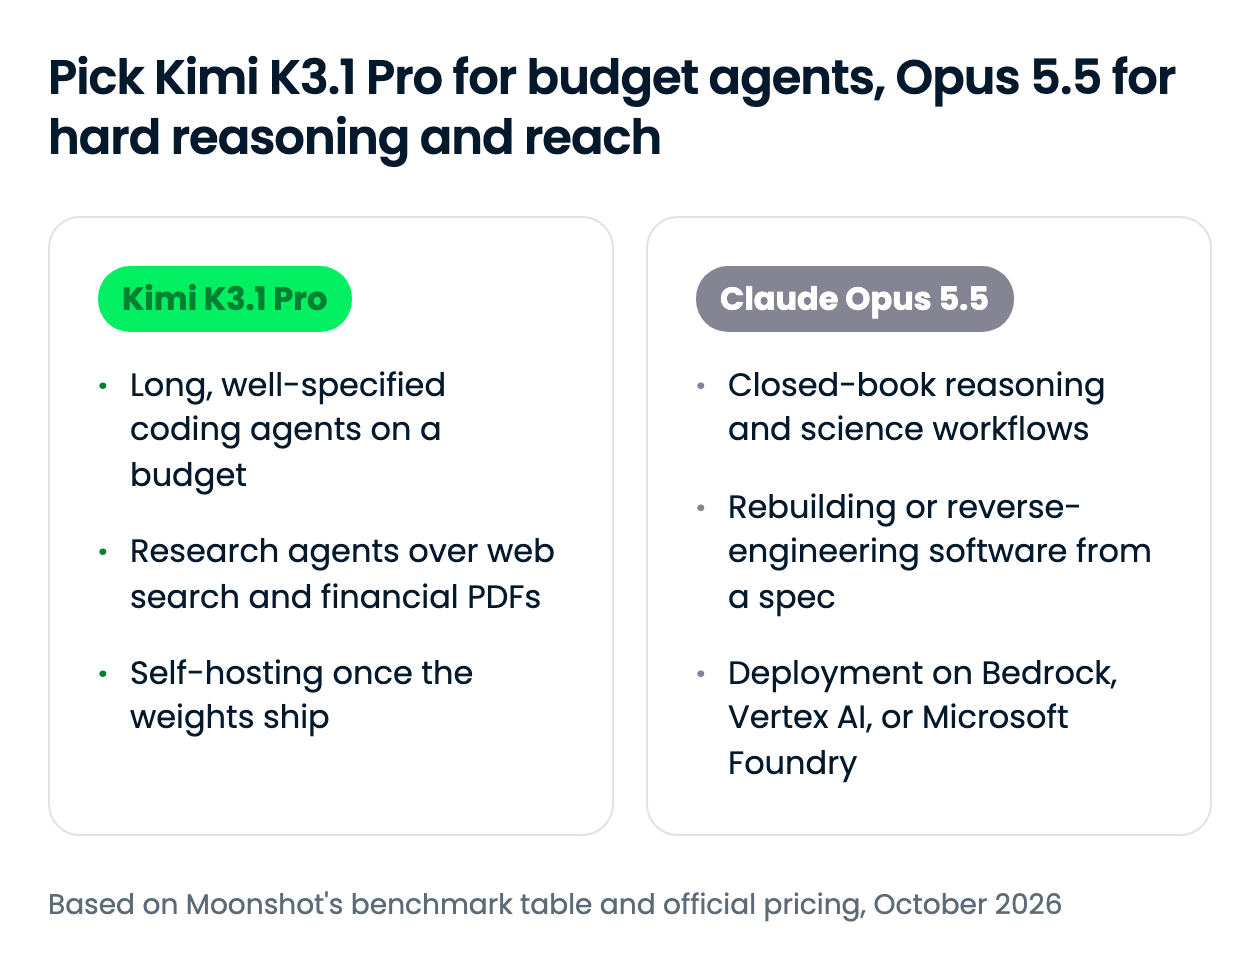
핵심은 가격 대 범위의 대조입니다. Kimi K3.1 Pro는 토큰당 요금을 절반으로 낮추고, Opus 5.5는 Kimi가 뒤처지는 추론 사례와 Kimi가 아직 확인되지 않은 클라우드 플랫폼을 폭넓게 지원합니다. 에이전트가 대부분 캐시된 컨텍스트로 실행된다면 절감 폭은 절반보다 3분의 1에 가깝습니다.
두 모델 모두 자체 API나 OpenRouter로 오늘 바로 호출할 수 있으며, Opus 5.5는 Amazon Bedrock, Vertex AI, Microsoft Foundry에서도 실행됩니다.
| 접점 | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| 컨슈머 앱 | Kimi.com, Kimi 모바일 앱, Kimi Work 데스크톱 앱 | Claude 앱(Pro, Max, Team, Enterprise) |
| 1차 API | Kimi API(OpenAI 호환) | Claude API |
| 클라우드 플랫폼 | 2026년 10월 29일 기준 Azure AI Foundry 또는 Amazon Bedrock에서는 미제공 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| 코딩 에이전트 | Kimi Code(2026년 10월 29일 기준 GitHub Copilot 및 Cursor에는 미제공) | Claude Code, Cursor, GitHub Copilot |
| 서드파티 라우터 | OpenRouter | OpenRouter |
| 오픈 웨이트 | 2026년 11월 4일까지 예정 | 아니오 |
| API 모델 ID | kimi-k3.1-pro |
claude-opus-5-5 |
접점의 범위 차이는 많은 팀에 결정적입니다. Opus 5.5는 주요 클라우드 전반과 주류 코딩 에이전트에 올라와 있는 반면, Kimi K3.1 Pro는 가중치 공개 전까지 Moonshot의 자체 접점과 OpenRouter에서만 확인되었습니다. 1차 API의 모델 ID는 kimi-k3.1-pro와 claude-opus-5-5이고, OpenRouter에서는 moonshotai/kimi-k3.1-pro와 anthropic/claude-opus-5.5입니다.
OpenRouter의 OpenAI 호환 엔드포인트를 사용하면 두 모델을 문자열 한 줄만 바꿔 A/B 테스트할 수 있습니다.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Opus 5.5 API 튜토리얼에서 Claude 쪽을 더 깊게 다루며, OpenCode 설명서는 두 모델을 오픈소스 코딩 에이전트에 연결하는 방법을 보여줍니다.
Kimi K3.1 Pro는 터미널 코딩에서 Claude Opus 5.5와 대등하고, 길고 도구 의존적인 에이전트 실행에서는 더 나은 성능을 보이며 가격도 크게 낮습니다. 에이전트가 명확히 정의된 장기 작업을 도구와 함께 수행한다면 Kimi를, 도움 없이 추론해야 하거나 모호한 사양을 쫓아야 하거나 AWS·Google Cloud·Azure에서 운영해야 한다면 Opus를 선택하세요.
가장 흥미로운 점은 두 연구소가 동일한 위험을 전혀 다르게 다룬다는 것입니다. Moonshot은 가중치 공개 전 사이버 역량을 학습 데이터에서 제거하고, Anthropic은 모델에 역량을 유지한 채 제공 시점에서 게이팅합니다. OpenRouter를 통해 Kimi를 테스트하고, 11월에 가중치와 라이선스가 공개되면 자체 호스팅을 재검토하길 권합니다.
이런 모델로 빌드를 시작하고 싶다면 Associate AI Engineer for Developers 트랙을 확인해 보세요.
DataCamp로 AI를 배워보세요!
트랙
강의
실습 문제하고 트랙하세요.
Google로 계속하기