

Leerpad
Associate AI Engineer voor ontwikkelaars
26 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleMoonshot AI bracht Kimi K3.1 Pro in oktober 2026 uit met een ongewoon specifieke claim: op Terminal-Bench 4.0 komt het nieuwe open-weight-model binnen één punt van Claude Opus 5.5, de vlaggendrager die Anthropic op 22 september lanceerde. Dat doet het voor de helft van Anthropic's prijs per token, en Moonshot belooft downloadbare weights uiterlijk 4 november.
In dit artikel vergelijk ik Kimi K3.1 Pro en Claude Opus 5.5 op agentic coding, redeneren, tool-intensief agentwerk, veiligheidscontroles en wat het in de praktijk kost om ze te draaien.
Als je geïnteresseerd bent in nieuwe modelreleases, lees dan ook onze gidsen over Google's nieuwste vlaggenschepen, Gemini 4 Carbon en Genie 4. To blijf op de hoogte van het laatste AI-nieuws, raad ik ook aan je te abonneren op onze wekelijkse nieuwsbrief, The Median.
Kimi K3.1 Pro is het vlaggenschipmodel van Moonshot AI, uitgebracht in oktober 2026 als een post-trained versie van Kimi K3, met open weights beloofd voor 4 november.
Het verkooppunt is reinforcement learning op schaal: Moonshot draaide gezamenlijke RL over honderden downstream-domeinen, wat vooral zichtbaar is bij long-horizon-coding, financieel onderzoek en 3D-creatie.
Onze Kimi K3.1 Pro-gids behandelt de lancering volledig.
Claude Opus 5.5 is Anthropics gesloten vlaggenschip en het eerste model in de Claude 5.5-familie, uitgebracht op 22 september 2026.
Anthropic positioneert het als Claude Fable 5.1-niveau op het meeste werk tegen een lagere prijs dan Opus 5, met de beste scores die het heeft gemeten op zijn geautomatiseerde alignment-audit.
Onze Claude Opus 5.5-gids behandelt de lancering; onze Opus 5.5 API-tutorial laat zien hoe je een AI-incidentonderzoeker bouwt.
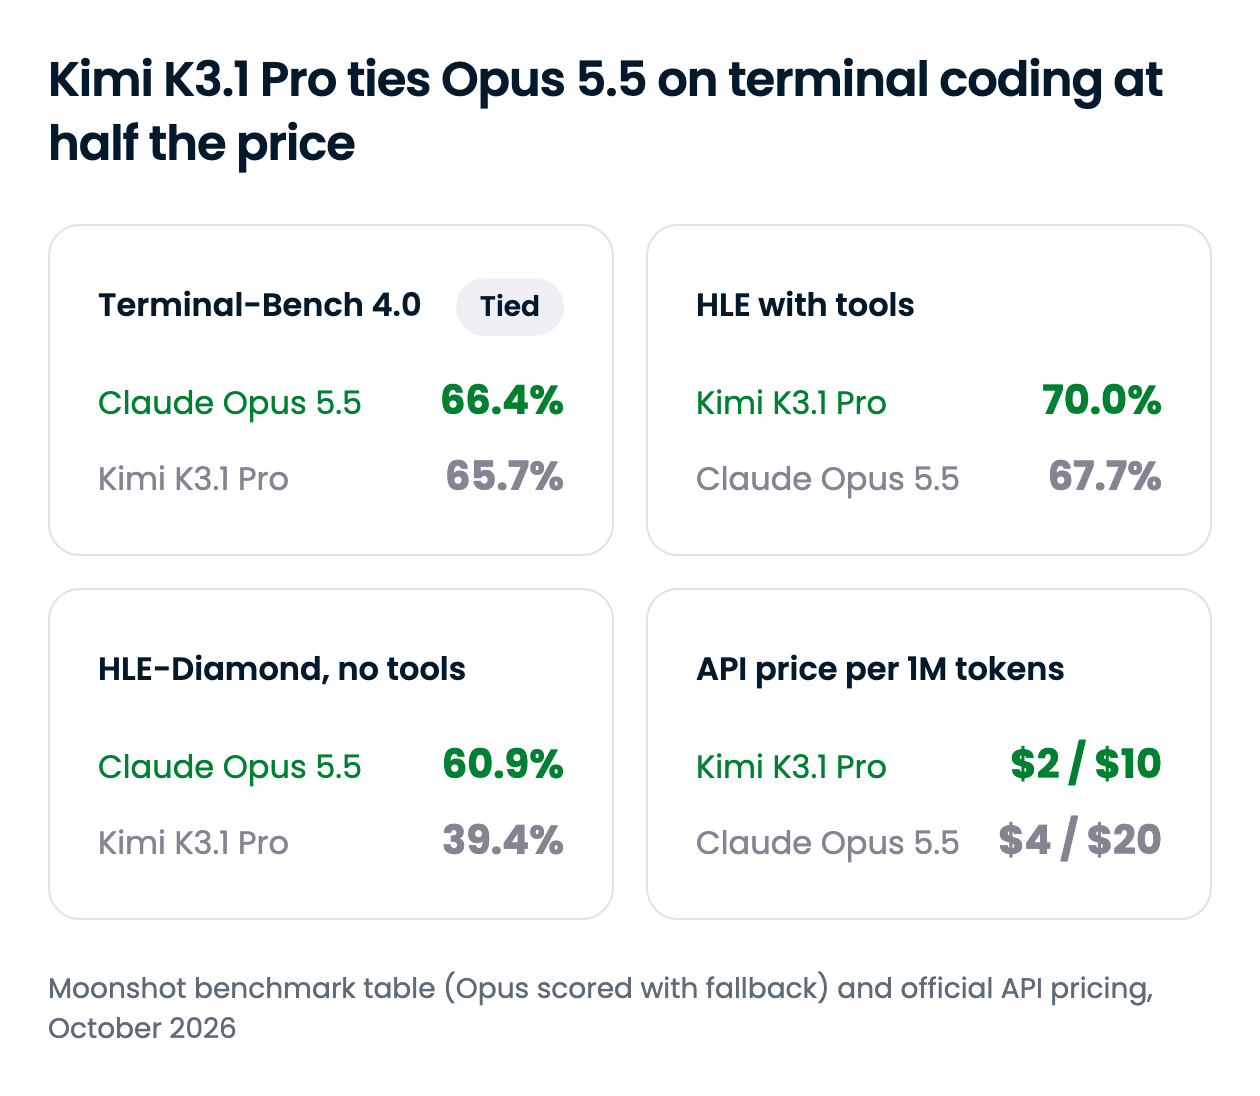
Kimi K3.1 Pro wint op prijs en op agentwerk dat zwaar op tools leunt; Opus 5.5 wint wanneer het model zonder hulp moet redeneren of een ondergespecificeerd probleem moet uitwerken. De samenvatting hieronder bestrijkt elke dimensie, en de secties erna gaan in op de punten waar het verschil je keuze verandert.
| Functie | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Ontwikkelaar | Moonshot AI | Anthropic |
| Uitgebracht | Oktober 2026 | 22 september 2026 |
| Weights | Open weights uiterlijk 4 november 2026 (licentie nog niet aangekondigd) | Gesloten |
| Contextvenster | 1M tokens | 1M tokens |
| Max output | Tot 1.048.576 tokens (standaard 131.072) | 128K tokens (300K op de Batch API, bèta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Long-horizon-coding (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Closed-book-redeneren (HLE-Diamond) | 39,4% | 60,9% |
| Tool-assisted redeneren (HLE met tools) | 70,0% | 67,7% |
| Offensieve cyber (ExploitBench) | 74,7 | 91,0 |
| API-prijs | De helft van Opus 5.5 op input en output | Baseline |
| Waar je het kunt draaien | Kimi API, Kimi-apps, OpenRouter | Claude API, Claude-apps, AWS, Google Cloud, Azure, grote coding-agents |
Eén kanttekening geldt voor elke score in deze sectie. De directe cijfers komen uit Moonshots eigen benchmarktabel, die elk Opus 5.5-resultaat markeert als "with fallback": Anthropics waarborgen geven sommige cyber- en biotaken door aan andere Claude-modellen (Opus 4.8 en Opus 5 respectievelijk), wat die scores waarschijnlijk naar beneden trekt.
De twee modellen liggen op Terminal-Bench 4.0 praktisch gelijk, en die kop verbergt een echte tweedeling eronder. Kimi K3.1 Pro leidt op de long-horizon-rijen, terwijl Opus 5.5 met ruime marge voorligt waar de taak open-ended is.
Het grootste gat is ProgramBench, dat een model vraagt een programma opnieuw op te bouwen uit zijn binary en spec. Opus 5.5 krijgt 65,0% van de taken tot minstens 95% slagen in tests, terwijl Kimi K3.1 Pro 31,5% haalt, minder dan de helft.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Notities |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi gedraaid in de Claude Code-harnas; Opus op xhigh effort volgens Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Meeruur durende engineeringtaken |
| DeepSWE v1.1 | 75,5% | 74,2% | Ieders eigen setup, dus beschouw als gelijkspel |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | 58,5% | Interne Moonshot-benchmark |
| ProgramBench (binary score) | 31,5% | 65,0% | Aandeel taken met minstens 95% score |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | Anthropics eigen tabel meldt 58,7% voor Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi gedraaid op H20-GPU's in plaats van H100's |
| BenchCAD met tools | 92,7% | 96,2% | 3D-reconstructie via CAD-code |
Het patroon is consistent. Geef Kimi K3.1 Pro een goed gedefinieerde engineeringtaak en veel tijd, en het blijft gaan: Moonshots showcaserun liet het 36 fouten oplossen in de schouderspierberekeningen van een simulator voor menselijk lopen over 167 missies. Anthropics equivalent is een C-naar-Rust-vertaling van HAProxy die bijna alle regressietests van HAProxy haalde.
Waar de spec dun is, loopt Opus uit. ProgramBench, wetenschappelijke onderzoeksworkflows en post-train-experimenten vereisen allemaal uitvogelen wat de taak precies is, en daar houdt Kimi's uithoudingsvermogen op lange runs op met renderen.
Voor lange, goed gespecificeerde coding-agents is Kimi K3.1 Pro een echt alternatief; voor reverse-engineering, researchcode en vage tickets is Opus 5.5 de veiligere keuze.
Haal de tools weg en Opus 5.5 leidt duidelijk. Het grootste gat is HLE-Diamond, de 1.000-vragen moeilijkste subset van Humanity's Last Exam, waar Opus 60,9% scoort tegen Kimi's 39,4%.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Notities |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2.500 vragen, geen tools |
| HLE-Diamond | 39,4% | 60,9% | Moeilijkste 1.000 vragen |
| GPQA-Diamond | 94,2% | 93,9% | Bijna verzadigd; gelijkspel |
| MMMU-Pro | 84,1% | 87,7% | Afbeelding- en tekstvragen |
| Kimi Hallu Bench (lager is beter) | 5,4% | 6,8% | Moonshot intern; claim-niveau hallucinatiegraad |
Ze eindigen gelijk op GPQA-Diamond, dat te dicht bij het plafond zit om iemand te onderscheiden. Kimi's lagere hallucinatiegraad komt uit Moonshots eigen stresstest, dus ik zou het eerder zien als een teken dat het factual-accuracy-werk is geland dan als een directe vergelijking. Voor closed-book-redeneren is Opus 5.5 het sterkere model.
Geef beide modellen tools en het redeneringsresultaat draait om. Op Humanity's Last Exam met tools scoort Kimi K3.1 Pro 70,0% tegen Opus' 67,7%, en het leidt de meeste research- en documentrijen van Moonshot.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Notities |
|---|---|---|---|
| HLE-Full met tools | 70,0% | 67,7% | Dezelfde vragen, tools toegestaan |
| BrowseComp | 92,1% | 90,8% | Moeilijk te vinden webinformatie |
| OfficeQA Pro v2 | 64,4 | 62,2 | Numerieke analyse over financiële pdf's |
| Frontier Finance | 58,6 | 56,7 | Beleggingsworkflows, van screening tot winstgevendheid |
| AutomationBench-AA | 73,3 | 69,5 | Artificial Analysis-versie, niet die van Zapier |
| OSWorld V2.1 | 79,6% | 81,8% | Een desktopcomputer bedienen |
| APEX-Agents | 67,2 | 73,5 | Mercor-leaderboard |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Kimi's overwinningen zijn klein maar consistent bij zoeken en financiële documenten. Opus houdt de voorsprong bij computergebruik en op de third-party agent-leaderboards, dus Kimi K3.1 Pro is de betere researchagent en Opus 5.5 de betere desktop- en algemene kantooragent.
Beide modellen lezen evenveel context en beide "denken" altijd: noch Moonshot noch Anthropic laat je het redeneren uitschakelen. De defaults verschillen wel. Kimi K3.1 Pro draait op max effort tenzij je low of high instelt, terwijl Opus 5.5 standaard medium gebruikt, dus een ongetunede Kimi-call verbruikt meer redenering per request.
Het outputplafond is het grotere praktische verschil. Kimi K3.1 Pro kan in één call een volledige contextvenster aan output teruggeven, grofweg acht keer het plafond van Opus 5.5 buiten de Batch API. Agentbouwers die migreren naar Opus moeten ook weten dat geforceerd toolgebruik nu een 400-fout teruggeeft.
Beide labs temperen offensieve cybercapaciteit, maar op tegengestelde manieren. Moonshot verwijderde cybergerelateerde data uit mid-training en RL voor de open-weight-release, wat de interne exploitbenchmark van 90,5% naar 81,0% bracht. Anthropic houdt de capability in Opus 5.5 en routeert de meeste cybersecurityverzoeken bij het bedienen door naar Opus 4.8.
Op ExploitBench scoort Opus 91,0 tegen Kimi's 74,7, en Moonshot zegt expliciet dat K3.1 Pro op cyber bewust achter de frontier-propriëtaire modellen blijft. De trade-off is controle: zodra de weights beschikbaar zijn, kun je Kimi op je eigen infrastructuur draaien, iets wat Opus niet biedt.
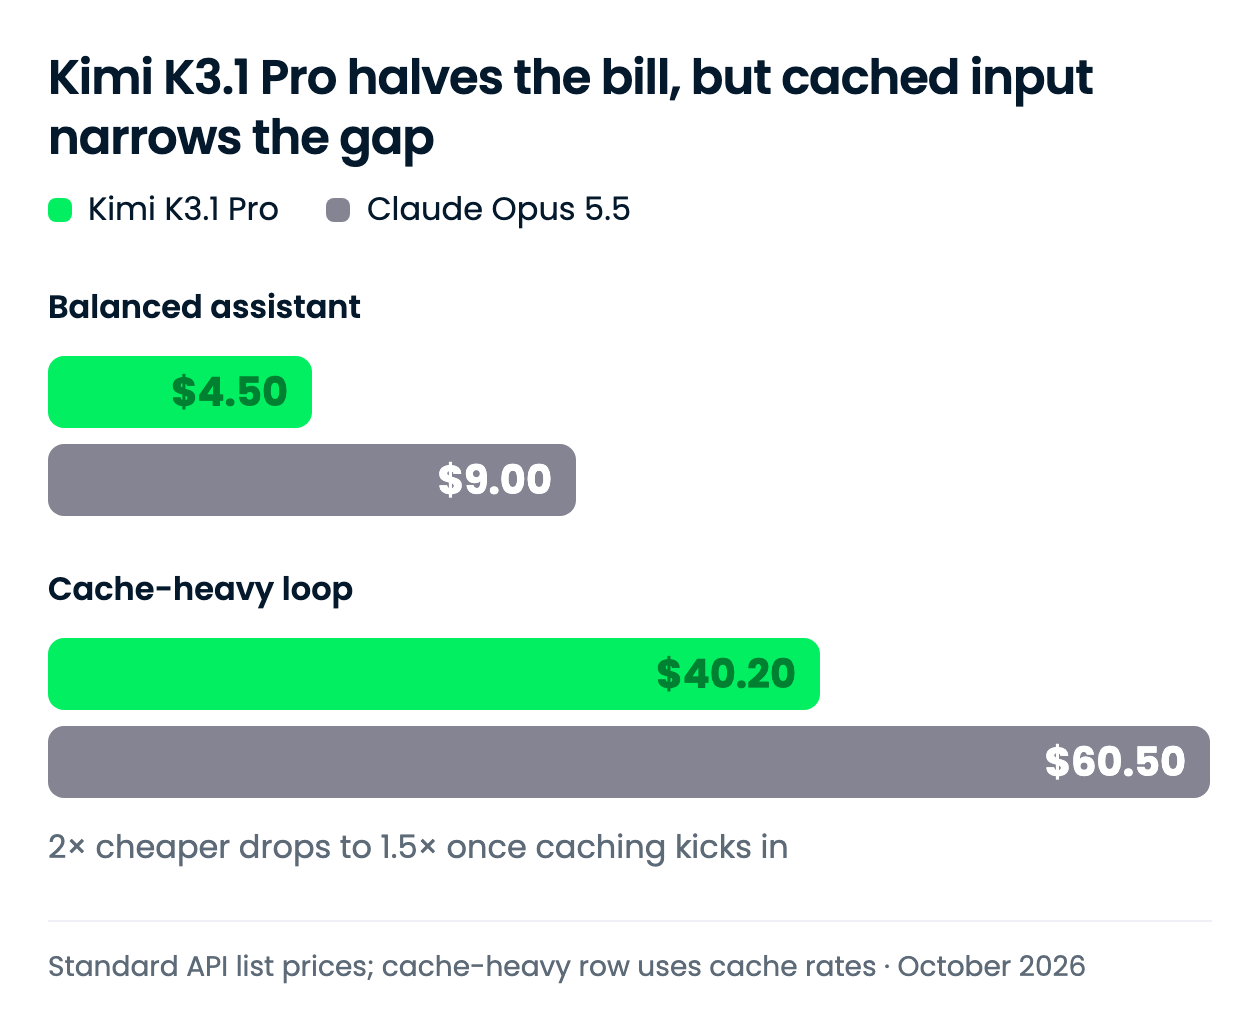
Kimi K3.1 Pro kost de helft van Opus 5.5 op verse tokens. De besparing krimpt wanneer een workload op gecachte context draait, omdat beide aanbieders hetzelfde rekenen voor een cache read.
Alle prijzen zijn per 1M tokens, afkomstig van de officiële prijspagina's van Moonshot en Anthropic.
| Tarief | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M tokens | $2,00 | $4,00 |
| Output, per 1M tokens | $10,00 | $20,00 |
| Cached input read, per 1M tokens | $0,20 | $0,20 |
| Cache write, 5 minuten TTL | $2,00 | $5,00 |
| Cache write, 1 uur TTL | $4,00 | $8,00 |
| Snellere variant | K3.1 Pro Highspeed, 2–3x snelheid: $4,00 / $20,00 | Fast mode, tot 2,5x snelheid: $8,00 / $40,00 |
De multiple is niet uniform: 0,5x op input, output en 1-uur-cachewrites, 0,4x op 5-minuten-cachewrites en 1,0x op cachereads. Geen van beide aanbieders rekent een lang-contexttoeslag.
Twee eigenaardigheden vallen op. Kimi's Highspeed-variant kost exact hetzelfde als standaard Opus. Anthropics Batch API halveert Opus naar $2 en $10, gelijk aan Kimi's standaardtarief, terwijl Moonshots prijspagina geen batchkorting vermeldt.
Ik koos twee maandelijkse workloadvormen: een gebalanceerde assistant als schaalanker, en een cache-zware agentloop, omdat cacheprijzen zijn waar de twee prijslijsten uiteenlopen.
| Workload | Kimi K3.1 Pro | Claude Opus 5.5 | Verschil |
|---|---|---|---|
| Gebalanceerde assistant: 1M in / 250K uit | $4,50 | $9,00 | $4,50 (Kimi 50% goedkoper) |
| Cache-zware loop: 100K prefix één keer geschreven, 1.000 gecachte reads, plus 5K vers in / 1K uit per request | $40,20 | $60,50 | $20,30 (Kimi 34% goedkoper) |
Elk totaal is (volume ÷ 1M) × tarief, opgeteld over input, output en cacheregels; de cache-zware rij gebruikt de 5-minuten-cachewrite. De gebalanceerde rij is eenvoudigweg het 2x tariefverschil.
De cache-zware rij is degene om omheen te plannen. De 100M gecachte tokens kosten bij beide modellen $20, dus alleen de verse tokens en de cachewrite dragen Kimi's korting, en de besparing zakt naar ongeveer een derde. Anthropic zegt dat cachereads het grootste deel van de kosten bij agentic coding uitmaken, dus langlopende agents komen dichter bij deze rij uit dan bij de eerste.
De twee modellen gebruiken verschillende tokenizers, en geen van beide aanbieders heeft tokenaantallen voor een gedeelde workload gepubliceerd, dus beschouw deze totalen als een tariefvergelijking in plaats van een rekening.
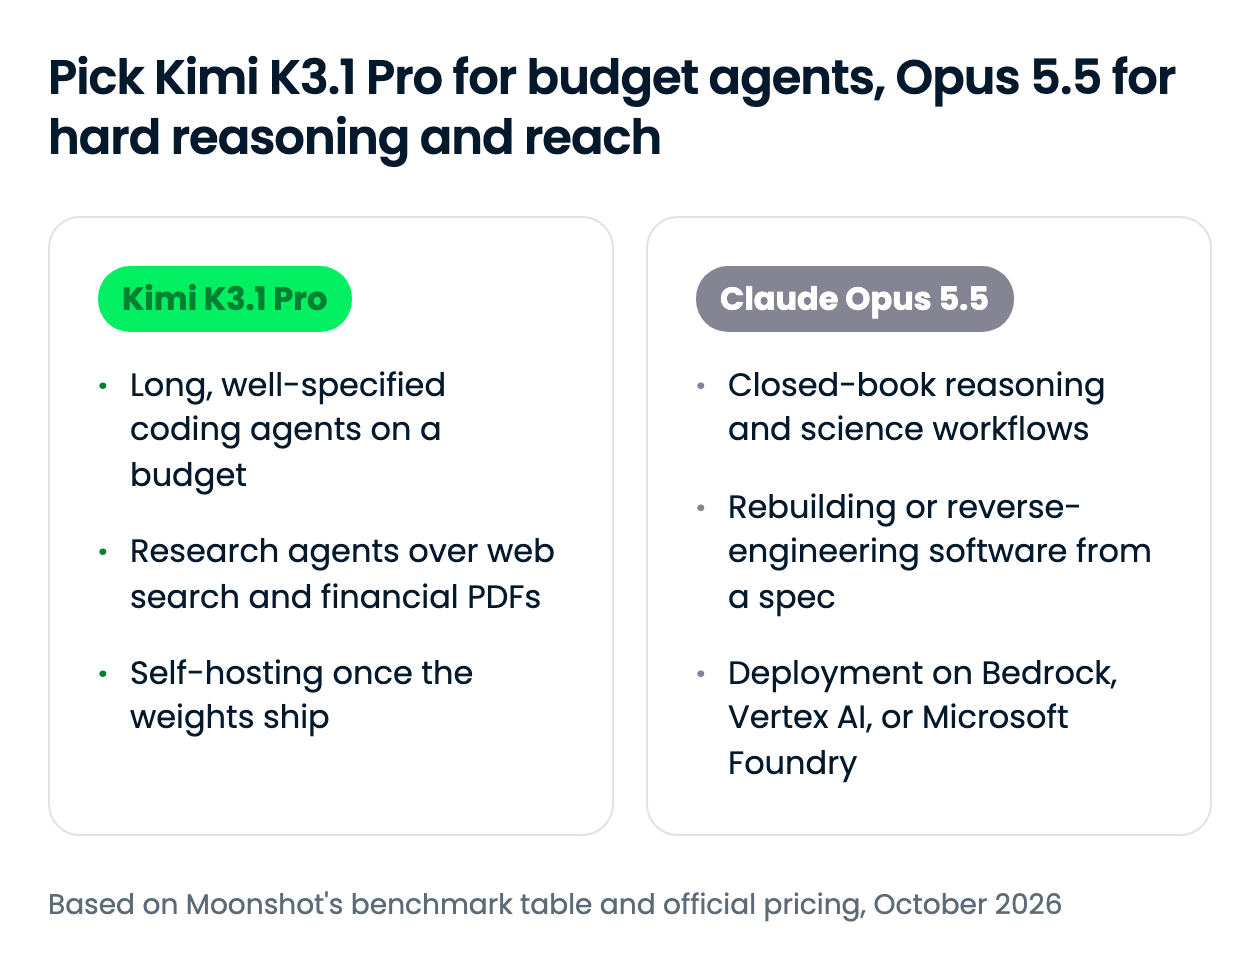
De keuze is prijs tegenover breedte: Kimi K3.1 Pro halveert het per-token-tarief, en Opus 5.5 dekt de redeneercases waar Kimi achterblijft en de cloudplatforms waar Kimi niet op bevestigd is. Als je agent vooral op gecachte context draait, ligt de besparing dichter bij een derde dan bij de helft.
Je kunt beide modellen vandaag aanroepen via hun eigen API's of via OpenRouter, en Opus 5.5 draait ook op Amazon Bedrock, Vertex AI en Microsoft Foundry.
| Surface | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Consumentenapp | Kimi.com, Kimi mobiele apps, Kimi Work desktop-app | Claude-apps (Pro, Max, Team, Enterprise) |
| Eerste-partij API | Kimi API (OpenAI-compatibel) | Claude API |
| Cloudplatforms | Nog niet beschikbaar op Azure AI Foundry of Amazon Bedrock per 29 okt 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Coding-agents | Kimi Code (nog niet beschikbaar in GitHub Copilot en Cursor per 29 okt 2026) | Claude Code, Cursor, GitHub Copilot |
| Third-party routers | OpenRouter | OpenRouter |
| Open weights | Uiterlijk 4 november 2026 | Nee |
| API-model-ID | kimi-k3.1-pro |
claude-opus-5-5 |
Het bereikverschil is de beslissende factor voor veel teams: Opus 5.5 staat op elke grote cloud en in de mainstream coding-agents, terwijl Kimi K3.1 Pro tot de weights arriveren alleen bevestigd is op de eigen surfaces van Moonshot en OpenRouter. Op de first-party API's zijn de model-ID's kimi-k3.1-pro en claude-opus-5-5; op OpenRouter zijn ze moonshotai/kimi-k3.1-pro en anthropic/claude-opus-5.5.
De OpenAI-compatibele endpoint van OpenRouter maakt van de twee modellen een one-string-swap, wat de makkelijkste manier is om ze A/B te testen op je eigen prompts.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Onze Opus 5.5 API-tutorial gaat dieper in op de Claude-kant, en onze uitleg over OpenCode laat zien hoe je elk van beide modellen in een open-source coding-agent plugt.
Kimi K3.1 Pro evenaart Claude Opus 5.5 bij terminal-coding en verslaat het op lange, tool-intensieve agentruns, met een flinke korting. Als je agents lange, goed gedefinieerde taken met tools draaien, gebruik Kimi; als ze zonder hulp redeneren, vage specs najagen of op AWS, Google Cloud of Azure moeten draaien, gebruik Opus.
Wat ik het meest interessant vind, is hoe verschillend de twee labs met hetzelfde risico omgaan: Moonshot snijdt cybercapaciteit uit de weights voordat ze gepubliceerd worden, en Anthropic houdt het in het model en zet een hek bij het bedienen. Ik zou Kimi via OpenRouter testen en self-hosting opnieuw bekijken zodra de weights en licentie in november landen.
Als je graag met dit soort modellen wilt bouwen, raad ik onze Associate AI Engineer for Developers-track aan.
Leer AI met DataCamp!
Leerpad
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

