

Lernpfad
Associate AI Engineer für Entwickler
26 Std.
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleMoonshot AI hat Kimi K3.1 Pro im Oktober 2026 mit einer ungewöhnlich konkreten Ansage veröffentlicht: Auf dem Terminal-Bench 4.0 liegt das neue Open-Weight-Modell nur einen Punkt hinter Claude Opus 5.5, dem Flaggschiff, das Anthropic am 22. September ausgeliefert hat. Das gelingt zum halben Preis pro Token, und Moonshot verspricht herunterladbare Gewichte bis zum 4. November.
In diesem Artikel vergleiche ich Kimi K3.1 Pro und Claude Opus 5.5 in agentischem Coding, Reasoning, toollastiger Agentenarbeit, Safety-Kontrollen und den tatsächlichen Betriebskosten.
Wenn dich neue Modellreleases interessieren, lies auch unsere Guides zu Googles neuesten Flaggschiffen, Gemini 4 Carbon und Genie 4. Um auf dem Laufenden zu bleiben, empfehle ich außerdem unser wöchentliches Newsletter, The Median.
Kimi K3.1 Pro ist das Flaggschiffmodell von Moonshot AI, veröffentlicht im Oktober 2026 als nachtrainierte Version von Kimi K3, mit zugesagten offenen Gewichten bis zum 4. November.
Das Alleinstellungsmerkmal ist Reinforcement Learning im großen Stil: Moonshot hat gemeinsames RL über Hunderte Downstream-Domains gefahren, was sich besonders bei Langzeit-Coding, Finanzresearch und 3D-Erstellung zeigt.
Unser Kimi K3.1 Pro Guide deckt den Launch umfassend ab.
Claude Opus 5.5 ist Anthropics geschlossenes Flaggschiff und das erste Modell der Claude-5.5-Familie, veröffentlicht am 22. September 2026.
Anthropic positioniert es mit Leistung auf Claude Fable 5.1-Niveau für die meisten Aufgaben zu einem niedrigeren Preis als Opus 5, mit den besten Werten, die das Unternehmen in seinem automatisierten Alignment-Audit gemessen hat.
Unser Claude Opus 5.5 Guide beleuchtet den Start; unser Opus 5.5 API-Tutorial zeigt Schritt für Schritt, wie du einen KI-Incident-Investigator baust.
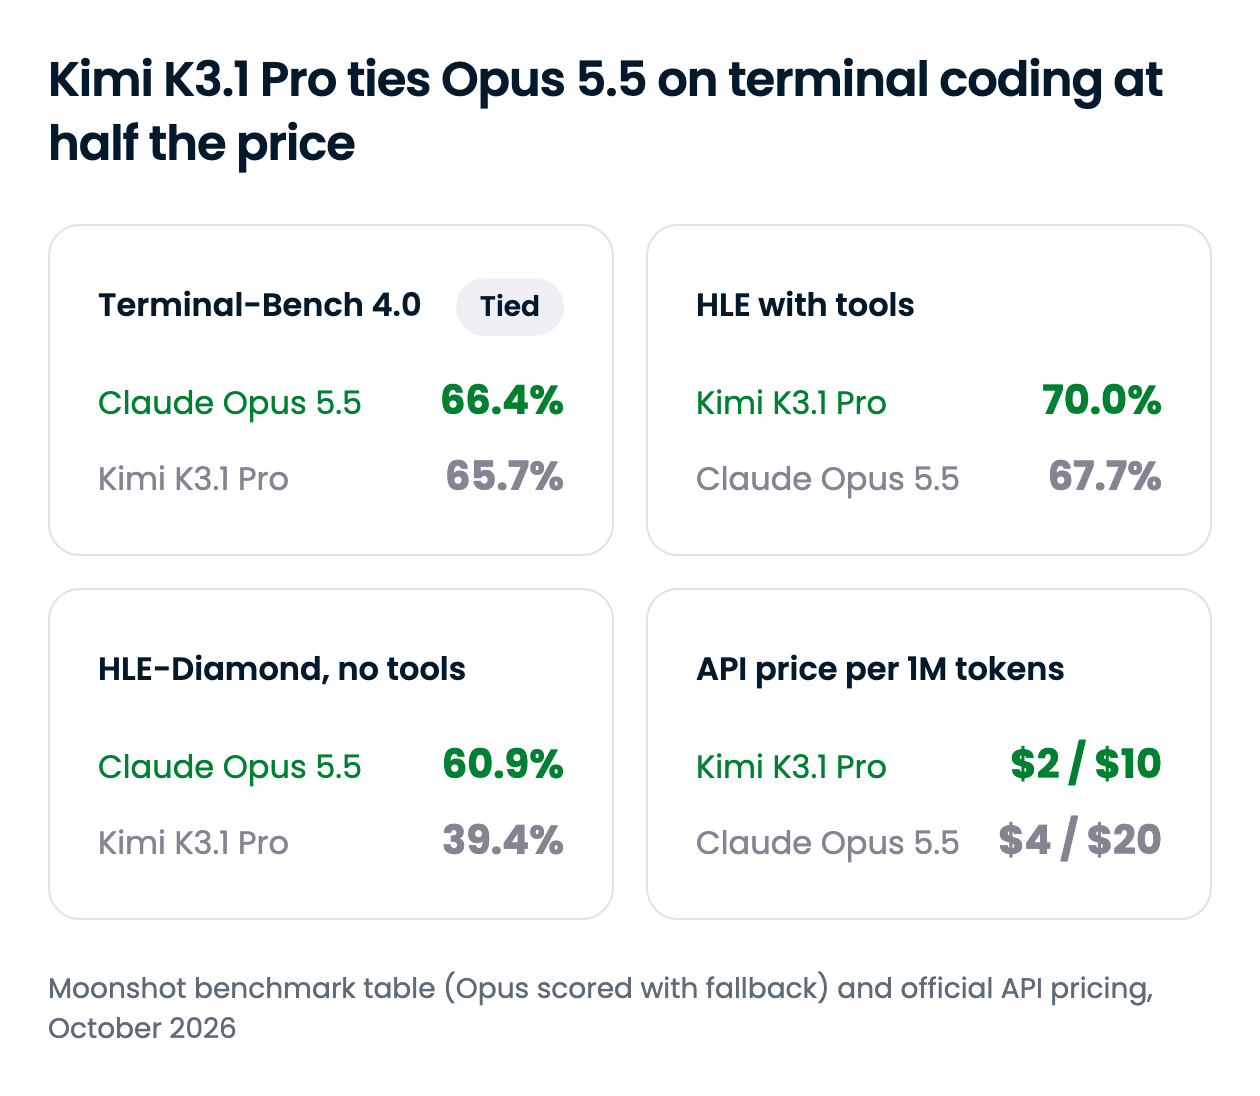
Kimi K3.1 Pro punktet beim Preis und bei Agentenarbeit mit starkem Tool-Einsatz; Opus 5.5 liegt vorn, sobald das Modell ohne Hilfsmittel schlussfolgern oder ein unterbestimmtes Problem ausarbeiten muss. Die Zusammenfassung unten deckt alle Dimensionen ab, und die anschließenden Abschnitte vertiefen die Bereiche, in denen der Unterschied die Entscheidung kippt.
| Feature | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Entwickler | Moonshot AI | Anthropic |
| Release | Oktober 2026 | 22. September 2026 |
| Gewichte | Offene Gewichte bis 4. November 2026 angekündigt (Lizenz noch nicht bekannt) | Geschlossen |
| Kontextfenster | 1 Mio. Tokens | 1 Mio. Tokens |
| Max. Output | Bis zu 1.048.576 Tokens (standardmäßig 131.072) | 128K Tokens (300K über die Batch-API, Beta) |
| Terminal-Bench 4.0 | 65,7% | 66,4% |
| Long-Horizon-Coding (SWE-Marathon v1.1) | 51,7% | 46,3% |
| Closed-Book-Reasoning (HLE-Diamond) | 39,4% | 60,9% |
| Tool-gestütztes Reasoning (HLE mit Tools) | 70,0% | 67,7% |
| Offensive Cyber (ExploitBench) | 74,7 | 91,0 |
| API-Preis | Halb so teuer wie Opus 5.5 bei Input und Output | Baseline |
| Wo es läuft | Kimi API, Kimi Apps, OpenRouter | Claude API, Claude Apps, AWS, Google Cloud, Azure, gängige Coding-Agenten |
Ein Vorbehalt gilt für alle Werte in diesem Abschnitt. Die Head-to-Head-Zahlen stammen aus Moonshots eigener Benchmark-Tabelle, die jedes Opus-5.5-Ergebnis als „mit Fallback“ markiert: Anthropics Schutzmechanismen übergeben einige Cyber- und Biologie-Aufgaben an andere Claude-Modelle (Opus 4.8 bzw. Opus 5), was diese Scores vermutlich drückt.
Auf dem Terminal-Bench 4.0 sind beide Modelle faktisch gleichauf, doch hinter der Überschrift steckt eine echte Aufteilung. Kimi K3.1 Pro führt bei Langzeittasks, während Opus 5.5 überall dort klar vorn liegt, wo die Aufgabe offen formuliert ist.
Die größte Lücke ist ProgramBench, bei dem ein Modell ein Programm aus Binärdatei und Spezifikation rekonstruiert. Opus 5.5 bringt 65,0% der Aufgaben auf mindestens 95% bestandene Tests, Kimi K3.1 Pro schafft 31,5% – weniger als die Hälfte.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Hinweise |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | Kimi im Claude-Code-Harness; Opus mit xhigh effort laut Anthropic |
| SWE-Marathon v1.1 | 51,7% | 46,3% | Mehrstündige Engineering-Aufgaben |
| DeepSWE v1.1 | 75,5% | 74,2% | Je Labor eigene Setups, daher als Gleichstand werten |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | 58,5% | Interner Moonshot-Benchmark |
| ProgramBench (Binary-Score) | 31,5% | 65,0% | Anteil der Aufgaben mit mindestens 95% |
| Terminal-Bench Science 0.1 | 38,1% | 63,3% | Anthropic meldet in der eigenen Tabelle 58,7% für Opus |
| PostTrainBench v1.2 | 36,5% | 43,8% | Kimi lief auf H20-GPUs statt H100s |
| BenchCAD mit Tools | 92,7% | 96,2% | 3D-Rekonstruktion über CAD-Code |
Das Muster ist konsistent. Gib Kimi K3.1 Pro eine klar definierte Engineering-Aufgabe und viel Zeit, und es hört nicht auf: Moonshots Showcase-Run ließ 36 Fehler in den Schultermuskel-Berechnungen eines menschlichen Geh-Simulators über 167 Missionen beheben. Anthropics passende Story ist eine C-zu-Rust-Übersetzung von HAProxy, die fast alle Regressionstests von HAProxy bestand.
Wo die Spezifikation dünn ist, zieht Opus davon. ProgramBench, wissenschaftliche Research-Workflows und Post-Training-Experimente verlangen, die Aufgabe überhaupt erst zu präzisieren – dort zahlt sich Kimis Langstrecken-Stamina nicht mehr aus.
Für lange, gut spezifizierte Coding-Agenten ist Kimi K3.1 Pro eine echte Alternative; für Reverse Engineering, Research-Code und vage Tickets ist Opus 5.5 die sicherere Wahl.
Nimm die Tools weg, und Opus 5.5 führt klar. Die größte Lücke ist HLE-Diamond, das 1.000-Fragen-Kernset von Humanity's Last Exam: Opus erzielt 60,9% zu Kimis 39,4%.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Hinweise |
|---|---|---|---|
| HLE-Full | 51,1% | 59,8% | 2.500 Fragen, keine Tools |
| HLE-Diamond | 39,4% | 60,9% | Die 1.000 härtesten Fragen |
| GPQA-Diamond | 94,2% | 93,9% | Nahe Sättigung; faktisch ein Gleichstand |
| MMMU-Pro | 84,1% | 87,7% | Bild- und Textfragen |
| Kimi Hallu Bench (weniger ist besser) | 5,4% | 6,8% | Moonshot-intern; Halluzinationsrate auf Claim-Ebene |
Bei GPQA-Diamond liegen beide gleichauf, das Set ist zu nah an der Decke, um zu differenzieren. Kimis geringere Halluzinationsrate stammt aus Moonshots eigenem Stresstest, daher eher als Hinweis auf gelungene Faktenarbeit denn als Head-to-Head-Urteil werten. Für Closed-Book-Reasoning ist Opus 5.5 das stärkere Modell.
Gib beiden Modellen Tools an die Hand, und das Reasoning-Ergebnis dreht sich um. Bei Humanity's Last Exam mit Tools erreicht Kimi K3.1 Pro 70,0% gegenüber 67,7% bei Opus, und es liegt bei den meisten Research- und Dokument-Benchmarks von Moonshot vorn.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | Hinweise |
|---|---|---|---|
| HLE-Full mit Tools | 70,0% | 67,7% | Gleiche Fragen, Tools erlaubt |
| BrowseComp | 92,1% | 90,8% | Schwer auffindbare Webinformationen |
| OfficeQA Pro v2 | 64,4 | 62,2 | Numerische Analysen über Finanz-PDFs |
| Frontier Finance | 58,6 | 56,7 | Investment-Workflows, von Screening bis Profitabilität |
| AutomationBench-AA | 73,3 | 69,5 | Artificial-Analysis-Version, nicht Zapiers |
| OSWorld V2.1 | 79,6% | 81,8% | Bedienung eines Desktop-Computers |
| APEX-Agents | 67,2 | 73,5 | Mercor-Leaderboard |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
Kimis Vorteile sind klein, aber konsistent bei Suche und Finanzdokumenten. Opus behält den Vorsprung bei Computerbedienung und auf Drittanbieter-Agenten-Leaderboards. Fazit: Kimi K3.1 Pro ist der bessere Research-Agent, Opus 5.5 der bessere Desktop- und Office-Agent.
Beide Modelle lesen gleich große Kontexte und „denken“ immer: Weder Moonshot noch Anthropic erlauben es, Reasoning abzuschalten. Die Defaults unterscheiden sich jedoch. Kimi K3.1 Pro läuft standardmäßig mit max effort, sofern du nicht low oder high setzt, während Opus 5.5 mit medium startet – ein ungetunter Kimi-Call investiert also mehr Reasoning pro Anfrage.
Die Output-Grenze ist in der Praxis der größere Unterschied. Kimi K3.1 Pro kann in einem Call ein komplettes Kontextfenster an Output zurückgeben – etwa das Achtfache der Obergrenze von Opus 5.5 außerhalb der Batch-API. Für Agent-Builder wichtig: Erzwungene Toolnutzung führt bei Opus nun zu einem 400-Fehler.
Beide Labs drosseln offensive Cyber-Fähigkeiten – auf entgegengesetzte Weise. Moonshot hat cyberrelevante Daten aus Mid-Training und RL für das Open-Weight-Release entfernt, wodurch der interne Exploit-Benchmark von 90,5% auf 81,0% sank. Anthropic lässt die Fähigkeit in Opus 5.5 drin und leitet die meisten Cybersecurity-Anfragen zur Laufzeit an Opus 4.8 um.
Auf der ExploitBench erzielt Opus 91,0 gegenüber 74,7 bei Kimi, und Moonshot sagt offen, dass K3.1 Pro beim Thema Cyber bewusst hinter proprietären Frontier-Modellen zurückbleibt. Der Trade-off ist Kontrolle: Sobald die Gewichte kommen, kannst du Kimi auf eigener Infrastruktur betreiben – bei Opus ist das nicht möglich.
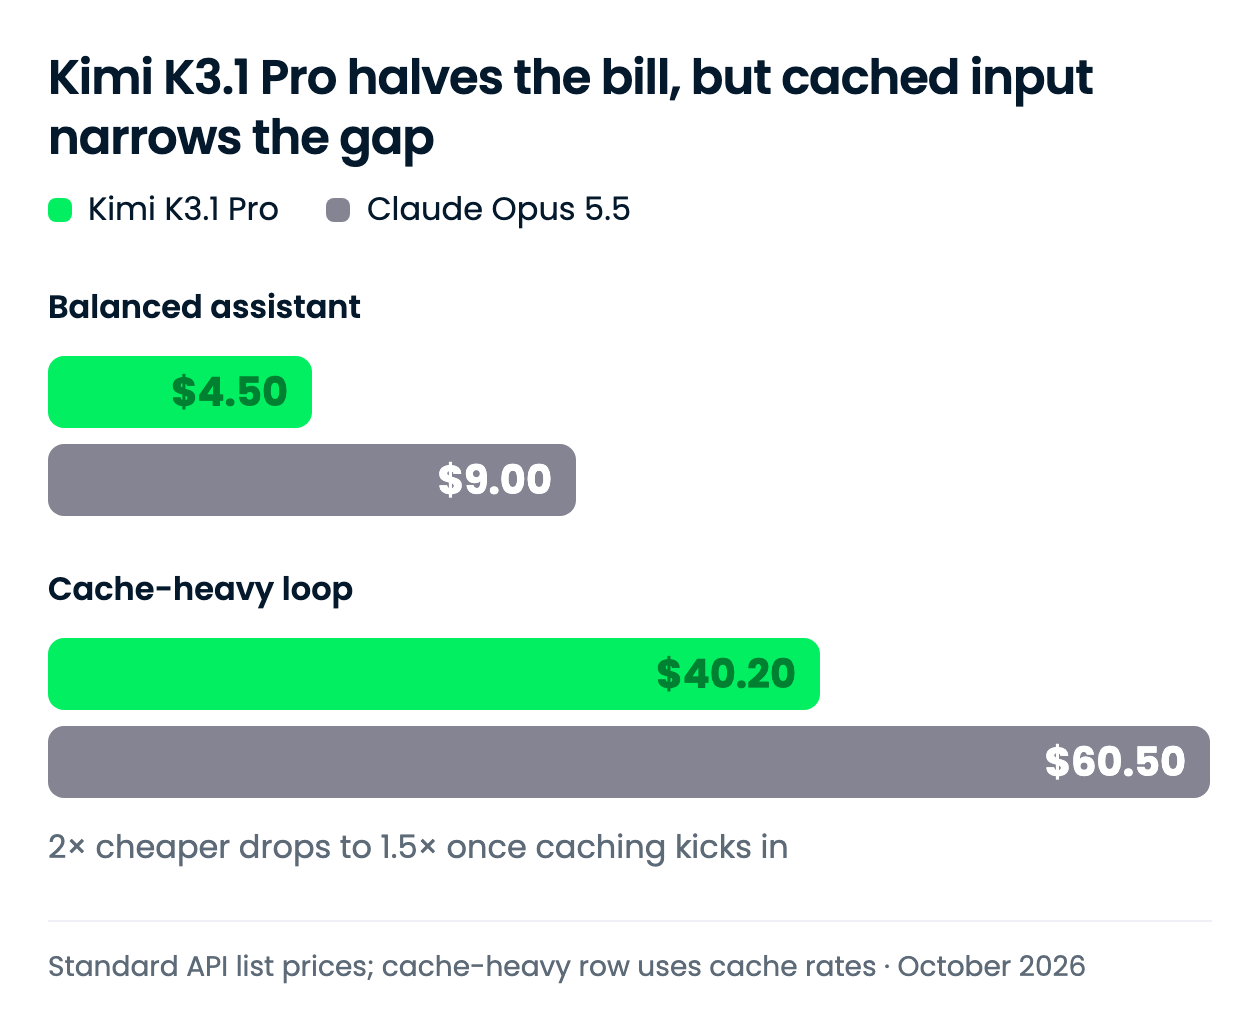
Kimi K3.1 Pro kostet für frische Tokens die Hälfte von Opus 5.5. Die Ersparnis schrumpft, wenn ein Workload stark auf gecachten Kontext setzt, da beide Anbieter für Cache-Reads denselben Preis verlangen.
Alle Preise pro 1 Mio. Tokens, laut den offiziellen Pricing-Seiten von Moonshot und Anthropic.
| Rate | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Input, pro 1 Mio. Tokens | $2,00 | $4,00 |
| Output, pro 1 Mio. Tokens | $10,00 | $20,00 |
| Gecachter Input-Read, pro 1 Mio. Tokens | $0,20 | $0,20 |
| Cache-Write, 5 Minuten TTL | $2,00 | $5,00 |
| Cache-Write, 1 Stunde TTL | $4,00 | $8,00 |
| Schnellere Variante | K3.1 Pro Highspeed, 2–3x Speed: $4,00 / $20,00 | Fast Mode, bis zu 2,5x Speed: $8,00 / $40,00 |
Der Faktor ist nicht überall gleich: 0,5x bei Input, Output und 1-Stunden-Cache-Writes, 0,4x bei 5-Minuten-Cache-Writes und 1,0x bei Cache-Reads. Keiner der Anbieter erhebt einen Long-Context-Zuschlag.
Zwei Auffälligkeiten ergeben sich daraus. Kimis Highspeed-Variante kostet exakt so viel wie Opus im Standardmodus. Anthropics Batch-API halbiert Opus auf $2 und $10 und entspricht damit Kimis Standardrate, während Moonshot auf der Pricing-Seite keinen Batch-Rabatt ausweist.
Ich habe zwei monatliche Workload-Formen gewählt: einen ausgewogenen Assistenten als Anker und einen cachelastigen Agent-Loop, weil sich bei den Cache-Preisen die Unterschiede zeigen.
| Workload | Kimi K3.1 Pro | Claude Opus 5.5 | Differenz |
|---|---|---|---|
| Ausgewogener Assistent: 1 Mio. in / 250K out | $4,50 | $9,00 | $4,50 (Kimi 50% günstiger) |
| Cache-lastiger Loop: 100K Prefix einmal geschrieben, 1.000 gecachte Reads, plus 5K frischer Input / 1K Output pro Request | $40,20 | $60,50 | $20,30 (Kimi 34% günstiger) |
Jede Summe ist (Volumen ÷ 1 Mio.) × Rate, über Input, Output und Cache summiert; die cachelastige Zeile nutzt den 5-Minuten-Cache-Write. Die ausgewogene Zeile spiegelt schlicht den 2x-Rate-Abstand.
Die cachelastige Zeile ist die entscheidende für die Planung. Die 100 Mio. gecachten Tokens kosten bei beiden Modellen $20, also greifen nur bei frischen Tokens und beim Cache-Write Kimis Rabatte – die Ersparnis sinkt auf rund ein Drittel. Laut Anthropic machen Cache-Reads den Großteil der Kosten agentischen Codings aus, daher landen langlebige Agenten näher an dieser Zeile als an der ersten.
Die Modelle nutzen unterschiedliche Tokenizer, und keiner der Anbieter hat Tokencounts für denselben Workload veröffentlicht. Werte daher als Preisvergleich statt als konkrete Rechnung verstehen.
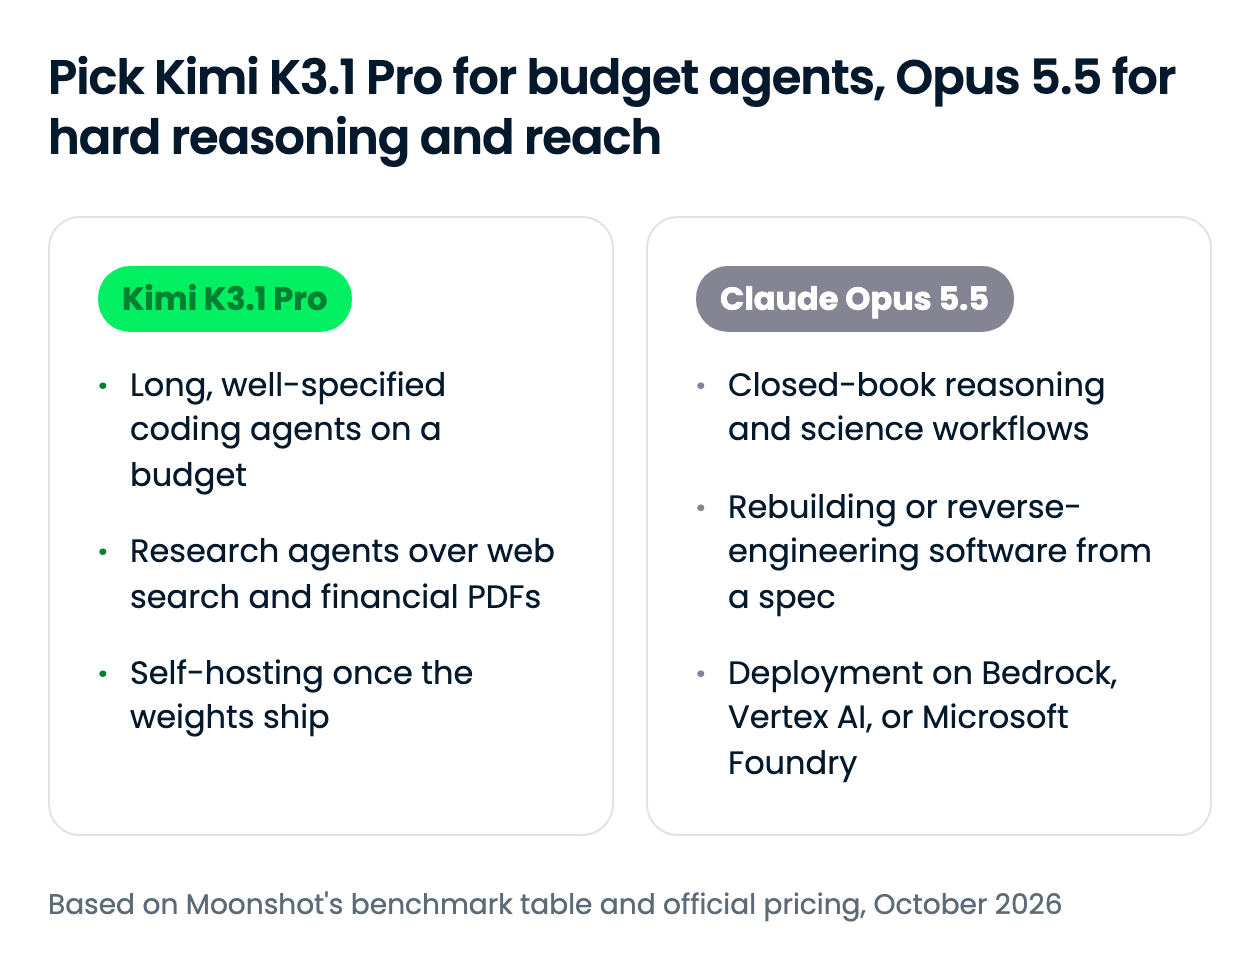
Am Ende ist es Preis gegen Breite: Kimi K3.1 Pro halbiert den Preis pro Token, und Opus 5.5 deckt die Reasoning-Fälle ab, bei denen Kimi zurückliegt, plus die Cloud-Plattformen, auf denen Kimi noch nicht bestätigt ist. Wenn dein Agent überwiegend auf gecachtem Kontext läuft, liegt die Ersparnis näher bei einem Drittel als bei der Hälfte.
Beide Modelle kannst du heute über ihre eigenen APIs oder über OpenRouter aufrufen, und Opus 5.5 läuft zusätzlich auf Amazon Bedrock, Vertex AI und Microsoft Foundry.
| Surface | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Consumer-App | Kimi.com, Kimi Mobile Apps, Kimi Work Desktop-App | Claude Apps (Pro, Max, Team, Enterprise) |
| First-Party-API | Kimi API (OpenAI-kompatibel) | Claude API |
| Cloud-Plattformen | Noch nicht verfügbar auf Azure AI Foundry oder Amazon Bedrock (Stand 29. Okt. 2026) | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| Coding-Agenten | Kimi Code (noch nicht in GitHub Copilot und Cursor verfügbar, Stand 29. Okt. 2026) | Claude Code, Cursor, GitHub Copilot |
| Drittanbieter-Router | OpenRouter | OpenRouter |
| Offene Gewichte | Bis 4. November 2026 angekündigt | Nein |
| API-Model-ID | kimi-k3.1-pro |
claude-opus-5-5 |
Für viele Teams ist die Reichweite entscheidend: Opus 5.5 ist auf allen großen Clouds und in den gängigen Coding-Agenten vertreten, während Kimi K3.1 Pro bis zur Veröffentlichung der Gewichte nur auf Moonshots eigenen Oberflächen und OpenRouter bestätigt ist. Auf den First-Party-APIs lauten die Model-IDs kimi-k3.1-pro und claude-opus-5-5; auf OpenRouter sind es moonshotai/kimi-k3.1-pro und anthropic/claude-opus-5.5.
Der OpenAI-kompatible Endpunkt von OpenRouter macht aus den beiden Modellen einen Ein-String-Tausch – der einfachste Weg, sie mit deinen eigenen Prompts A/B zu testen.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
Unser Opus 5.5 API-Tutorial geht auf der Claude-Seite tiefer, und unser Erklärstück zu OpenCode zeigt, wie du beide Modelle in einen Open-Source-Coding-Agenten einbindest.
Kimi K3.1 Pro zieht beim Terminal-Coding mit Claude Opus 5.5 gleich und übertrumpft es bei langen, toollastigen Agentenläufen – zu einem spürbaren Preisvorteil. Wenn deine Agenten lange, klar definierte Aufgaben mit Tools ausführen, nimm Kimi; wenn sie ohne Hilfsmittel schlussfolgern, vage Specs verfolgen oder auf AWS, Google Cloud oder Azure laufen müssen, nimm Opus.
Am spannendsten finde ich, wie unterschiedlich beide Labs dasselbe Risiko managen: Moonshot schneidet Cyber-Fähigkeiten vor der Veröffentlichung aus den Gewichten heraus, während Anthropic sie im Modell belässt und zur Laufzeit gate’t. Ich würde Kimi über OpenRouter testen und Self-Hosting prüfen, sobald Gewichte und Lizenz im November vorliegen.
Wenn du mit solchen Modellen bauen willst, empfehle ich unseren Associate AI Engineer for Developers Lernpfad.
Lerne KI mit DataCamp!
Lernpfad
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit Google