

แทร็ก
วิศวกร AI ระดับ Associate สำหรับนักพัฒนา
26 ชม.
ฝึกฝนและตรวจสอบความก้าวหน้าของคุณ
ดำเนินการต่อด้วย GoogleMoonshot AI เปิดตัว Kimi K3.1 Pro ในเดือนตุลาคม 2026 พร้อมคำอ้างที่เฉพาะเจาะจงผิดปกติ: บน Terminal-Bench 4.0 โมเดลน้ำหนักเปิดรุ่นใหม่นี้ทำคะแนนห่างจาก Claude Opus 5.5 เพียง 1 คะแนน ซึ่งเป็นเรือธงที่ Anthropic เปิดเมื่อวันที่ 22 กันยายน ทั้งหมดนี้ที่ราคาต่อโทเค็นเพียงครึ่งของ Anthropic และ Moonshot สัญญาว่าจะปล่อยน้ำหนักโมเดลให้ดาวน์โหลดภายในวันที่ 4 พฤศจิกายน
ในบทความนี้ จะเปรียบเทียบ Kimi K3.1 Pro และ Claude Opus 5.5 ในด้านการโค้ดแบบเอเจนต์ การให้เหตุผล งานเอเจนต์ที่ใช้เครื่องมือหนัก การควบคุมความปลอดภัย และต้นทุนการใช้งานจริง
หากสนใจรุ่นโมเดลใหม่ๆ แนะนำให้อ่านคู่มือเรือธงล่าสุดของ Google อย่าง Gemini 4 Carbon และ Genie 4 ด้วย เพื่ออัปเดตข่าวสาร AI ล่าสุด แนะนำให้สมัครรับจดหมายข่าวรายสัปดาห์ของเรา The Median ด้วย
Kimi K3.1 Pro คือโมเดลเรือธงของ Moonshot AI เปิดตัวในเดือนตุลาคม 2026 เป็นเวอร์ชันหลังการฝึกของ Kimi K3 โดยสัญญาว่าจะเปิดน้ำหนักโมเดลภายในวันที่ 4 พฤศจิกายน
จุดขายคือการทำรีอินฟอร์สเมนต์เลิร์นนิงในสเกลใหญ่: Moonshot รัน RL ร่วมกันครอบคลุมหลายร้อยโดเมนดาวน์สตรีม ซึ่งเห็นผลชัดที่สุดในงานโค้ดระยะยาว งานวิจัยการเงิน และการสร้างงาน 3D
คู่มือ Kimi K3.1 Pro ของเราครอบคลุมรายละเอียดการเปิดตัวครบถ้วน
Claude Opus 5.5 คือโมเดลเรือธงแบบปิดของ Anthropic และเป็นรุ่นแรกในตระกูล Claude 5.5 เปิดตัวเมื่อวันที่ 22 กันยายน 2026
Anthropic ระบุว่ามีประสิทธิภาพระดับ Claude Fable 5.1 ในงานส่วนใหญ่ที่ราคาต่ำกว่า Opus 5 พร้อมคะแนนที่ดีที่สุดจากระบบตรวจสอบการปรับแต่งอัตโนมัติของตน
คู่มือ Claude Opus 5.5 ของเราครอบคลุมการเปิดตัว และ บทเรียน API ของ Opus 5.5 สอนการสร้างเอเจนต์สืบสวนเหตุการณ์ AI
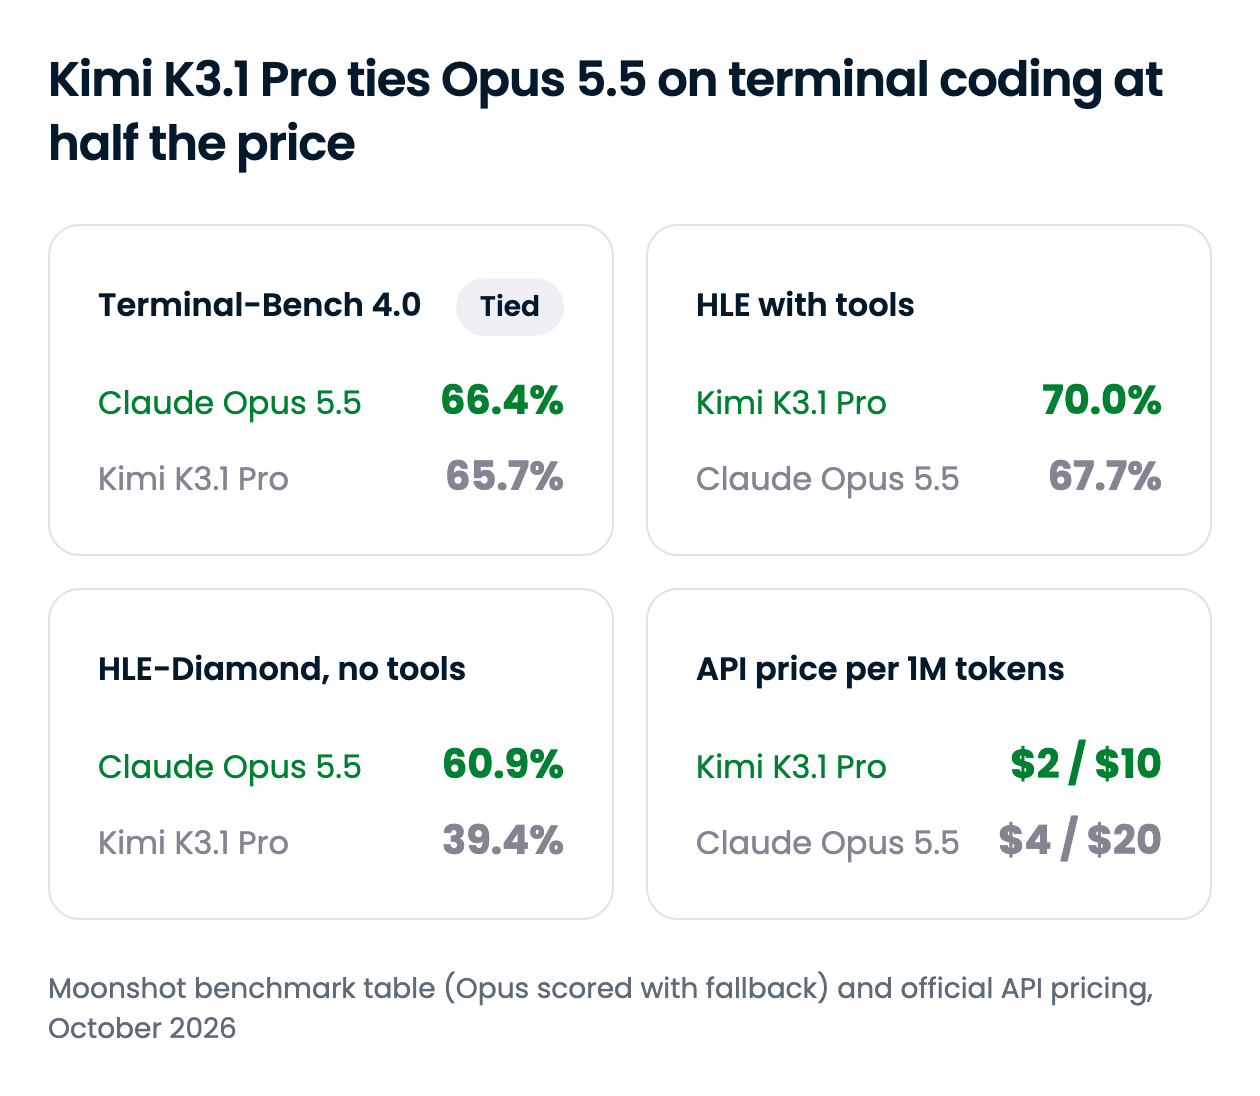
Kimi K3.1 Pro ชนะด้านราคาและงานเอเจนต์ที่พึ่งพาเครื่องมือ ขณะที่ Opus 5.5 ชนะเมื่อโมเดลต้องให้เหตุผลโดยไม่มีตัวช่วยหรือแก้ปัญหาที่ระบุไม่ชัด สรุปด้านล่างครอบคลุมทุกมิติ และส่วนถัดไปจะขยายในจุดที่ช่องว่างมีผลต่อการตัดสินใจ
| คุณสมบัติ | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| ผู้พัฒนา | Moonshot AI | Anthropic |
| วันเปิดตัว | ตุลาคม 2026 | 22 กันยายน 2026 |
| น้ำหนักโมเดล | น้ำหนักเปิดจะปล่อยภายใน 4 พฤศจิกายน 2026 (ยังไม่ประกาศไลเซนส์) | ปิด |
| หน้าต่างคอนเท็กซ์ | 1M โทเค็น | 1M โทเค็น |
| เอาต์พุตสูงสุด | สูงสุด 1,048,576 โทเค็น (ค่าเริ่มต้น 131,072) | 128K โทเค็น (300K บน Batch API, เบต้า) |
| Terminal-Bench 4.0 | 65.7% | 66.4% |
| โค้ดระยะยาว (SWE-Marathon v1.1) | 51.7% | 46.3% |
| การให้เหตุผลแบบปิดหนังสือ (HLE-Diamond) | 39.4% | 60.9% |
| การให้เหตุผลด้วยเครื่องมือช่วย (HLE with tools) | 70.0% | 67.7% |
| ไซเบอร์เชิงรุก (ExploitBench) | 74.7 | 91.0 |
| ราคา API | ครึ่งหนึ่งของ Opus 5.5 ทั้งอินพุตและเอาต์พุต | ราคาอ้างอิง |
| ที่รันได้ | Kimi API, แอป Kimi, OpenRouter | Claude API, แอป Claude, AWS, Google Cloud, Azure, เอเจนต์โค้ดยอดนิยม |
ข้อควรระวังสำคัญสำหรับทุกคะแนนในส่วนนี้: ตัวเลขตัวต่อตัวมาจากตารางเบนช์มาร์กของ Moonshot เอง ซึ่งระบุผลลัพธ์ของ Opus 5.5 แต่ละรายการว่า “with fallback” คือมาตรการป้องกันของ Anthropic จะส่งต่องานไซเบอร์และชีววิทยาบางอย่างไปยังโมเดล Claude อื่น (Opus 4.8 และ Opus 5 ตามลำดับ) ซึ่งน่าจะทำให้คะแนนลดลง
สองโมเดลทำได้ใกล้เคียงกันบน Terminal-Bench 4.0 แต่ใต้พาดหัวนั้นมีความแตกต่างจริง Kimi K3.1 Pro นำในงานระยะยาว ขณะที่ Opus 5.5 นำแบบทิ้งช่วงในงานเปิดปลาย
ช่องว่างใหญ่สุดคือ ProgramBench ที่ให้โมเดลสร้างโปรแกรมขึ้นใหม่จากไบนารีและสเปก Opus 5.5 พางาน 65.0% ให้ผ่านการทดสอบอย่างน้อย 95% ขณะที่ Kimi K3.1 Pro ทำได้ 31.5% ไม่ถึงครึ่ง
| เบนช์มาร์ก | Kimi K3.1 Pro | Claude Opus 5.5 | หมายเหตุ |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | Kimi รันในฮาร์เนส Claude Code; Opus ใช้ความพยายาม xhigh ตาม Anthropic |
| SWE-Marathon v1.1 | 51.7% | 46.3% | งานวิศวกรรมหลายชั่วโมง |
| DeepSWE v1.1 | 75.5% | 74.2% | แต่ละแล็บตั้งค่าเอง จัดเป็นเสมอ |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | 58.5% | เบนช์มาร์กภายในของ Moonshot |
| ProgramBench (คะแนนไบนารี) | 31.5% | 65.0% | สัดส่วนงานที่ได้อย่างน้อย 95% |
| Terminal-Bench Science 0.1 | 38.1% | 63.3% | ตารางของ Anthropic เองรายงาน Opus ที่ 58.7% |
| PostTrainBench v1.2 | 36.5% | 43.8% | Kimi รันบน H20 แทน H100 |
| BenchCAD พร้อมเครื่องมือ | 92.7% | 96.2% | รีคอนสตรักชัน 3D ผ่านโค้ด CAD |
รูปแบบนี้สอดคล้องกัน ให้ Kimi K3.1 Pro ทำงานวิศวกรรมที่นิยามชัดและใช้เวลามาก ก็จะทำต่อเนื่องได้ดี: ตัวอย่างโชว์เคสของ Moonshot ให้มันแก้ 36 ข้อผิดพลาดในคำนวณกล้ามเนื้อไหล่ของซิมูเลเตอร์การเดินของมนุษย์ตลอด 167 มิชชัน ด้าน Anthropic มีเคสแปล C เป็น Rust สำหรับ HAProxy ที่ผ่านการทดสอบถดถอยของ HAProxy เองเกือบทั้งหมด
เมื่อสเปกบาง Opus จะฉีกนำ ProgramBench เวิร์กโฟลว์วิจัยวิทยาศาสตร์ และการทดลองหลังการฝึก ล้วนต้องตีความโจทย์ก่อนลงมือ ซึ่งเป็นจุดที่ความอึดของ Kimi ในระยะยาวไม่ช่วยต่อ
สำหรับเอเจนต์โค้ดงานยาวที่นิยามชัด Kimi K3.1 Pro เป็นตัวเลือกจริงจัง; สำหรับรีเวิร์สเอนจิเนียริง โค้ดวิจัย และทิกเก็ตคลุมเครือ Opus 5.5 ปลอดภัยกว่า
เมื่อถอดเครื่องมือออก Opus 5.5 นำชัด ช่องว่างกว้างสุดคือ HLE-Diamond ชุดยากที่สุด 1,000 ข้อของ Humanity's Last Exam ที่ Opus ได้ 60.9% ต่อ 39.4% ของ Kimi
| เบนช์มาร์ก | Kimi K3.1 Pro | Claude Opus 5.5 | หมายเหตุ |
|---|---|---|---|
| HLE-Full | 51.1% | 59.8% | 2,500 คำถาม ไม่ใช้เครื่องมือ |
| HLE-Diamond | 39.4% | 60.9% | 1,000 คำถามที่ยากที่สุด |
| GPQA-Diamond | 94.2% | 93.9% | ใกล้เพดานคะแนน จัดเป็นเสมอ |
| MMMU-Pro | 84.1% | 87.7% | คำถามภาพและข้อความ |
| Kimi Hallu Bench (ยิ่งต่ำยิ่งดี) | 5.4% | 6.8% | ภายในของ Moonshot; อัตราเพี้ยนข้อมูลระดับข้อเท็จจริง |
ทั้งคู่เสมอบน GPQA-Diamond ซึ่งใกล้เพดานเกินกว่าจะชี้ขาด อัตราเพี้ยนต่ำของ Kimi มาจากสเตรสเทสต์ของ Moonshot เอง จึงควรมองเป็นสัญญาณว่างานด้านความถูกต้องเชิงข้อเท็จจริงได้ผล มากกว่าบทสรุปตัวต่อตัว สำหรับการให้เหตุผลแบบปิดหนังสือ Opus 5.5 แข็งแกร่งกว่า
เมื่อให้ทั้งคู่ใช้เครื่องมือ ผลการให้เหตุผลกลับทิศ บน Humanity's Last Exam พร้อมเครื่องมือ Kimi K3.1 Pro ได้ 70.0% เทียบกับ Opus 67.7% และนำหน้าในหลายแถวงานวิจัยและเอกสารของ Moonshot
| เบนช์มาร์ก | Kimi K3.1 Pro | Claude Opus 5.5 | หมายเหตุ |
|---|---|---|---|
| HLE-Full พร้อมเครื่องมือ | 70.0% | 67.7% | คำถามเดียวกัน อนุญาตใช้เครื่องมือ |
| BrowseComp | 92.1% | 90.8% | ข้อมูลบนเว็บที่ค้นหายาก |
| OfficeQA Pro v2 | 64.4 | 62.2 | วิเคราะห์ตัวเลขใน PDF การเงิน |
| Frontier Finance | 58.6 | 56.7 | เวิร์กโฟลว์การลงทุน ตั้งแต่สกรีนจนถึงกำไร |
| AutomationBench-AA | 73.3 | 69.5 | เวอร์ชัน Artificial Analysis ไม่ใช่ของ Zapier |
| OSWorld V2.1 | 79.6% | 81.8% | การใช้งานคอมพิวเตอร์เดสก์ท็อป |
| APEX-Agents | 67.2 | 73.5 | กระดานจัดอันดับ Mercor |
| AA-Briefcase v1.1 (Elo) | 1678 | 1803 | Artificial Analysis |
ชัยชนะของ Kimi มีน้อยแต่ต่อเนื่องในงานค้นหาและเอกสารการเงิน Opus ยังคงได้เปรียบในงานใช้คอมพิวเตอร์และกระดานจัดอันดับเอเจนต์จากบุคคลที่สาม ดังนั้น Kimi K3.1 Pro เหมาะกับเอเจนต์วิจัย ส่วน Opus 5.5 เหมาะกับเอเจนต์ใช้งานเดสก์ท็อปและงานออฟฟิศทั่วไป
ทั้งสองอ่านคอนเท็กซ์ได้ขนาดเท่ากัน และทั้งคู่ “คิด” ตลอดเวลา: ทั้ง Moonshot และ Anthropic ไม่ให้ปิดโหมด reasoning แต่ดีฟอลต์ต่างกัน Kimi K3.1 Pro รันที่ max โดยต้องตั้งเป็น low หรือ high เอง ขณะที่ Opus 5.5 ดีฟอลต์เป็น medium จึงสิ้นเปลืองการให้เหตุผลต่อคำขอมากกว่าหากไม่จูน
เพดานเอาต์พุตคือช่องว่างที่ใช้งานจริงมากกว่า Kimi K3.1 Pro สามารถส่งเอาต์พุตได้ขนาดเท่าหน้าต่างคอนเท็กซ์เต็มๆ ในครั้งเดียว ราว 8 เท่าของเพดานของ Opus 5.5 นอก Batch API ผู้พัฒนาเอเจนต์ที่ย้ายไป Opus ควรรู้ด้วยว่าการบังคับใช้เครื่องมือ (forced tool use) ตอนนี้จะคืนข้อผิดพลาด 400
ทั้งสองแล็บจำกัดความสามารถด้านไซเบอร์เชิงรุก แต่ทำคนละวิธี Moonshot ตัดข้อมูลที่เกี่ยวกับไซเบอร์ออกจากช่วงกลางการฝึกและ RL เพื่อเตรียมปล่อยน้ำหนักเปิด ทำให้คะแนนเบนช์มาร์กโจมตีภายในลดจาก 90.5% เหลือ 81.0% ส่วน Anthropic เก็บความสามารถไว้ใน Opus 5.5 และเปลี่ยนเส้นทางคำขอด้านความปลอดภัยไซเบอร์ส่วนใหญ่ไปยัง Opus 4.8 ในขั้นตอนเสิร์ฟ
บน ExploitBench Opus ได้ 91.0 เทียบกับ 74.7 ของ Kimi และ Moonshot ระบุชัดว่า K3.1 Pro ตั้งใจให้ตามหลังโมเดลเชิงพาณิชย์ระดับแนวหน้าในด้านไซเบอร์ ข้อแลกเปลี่ยนคือการควบคุม: เมื่อปล่อยน้ำหนักแล้ว สามารถรัน Kimi บนโครงสร้างพื้นฐานของตนเองได้ ซึ่ง Opus ไม่รองรับ
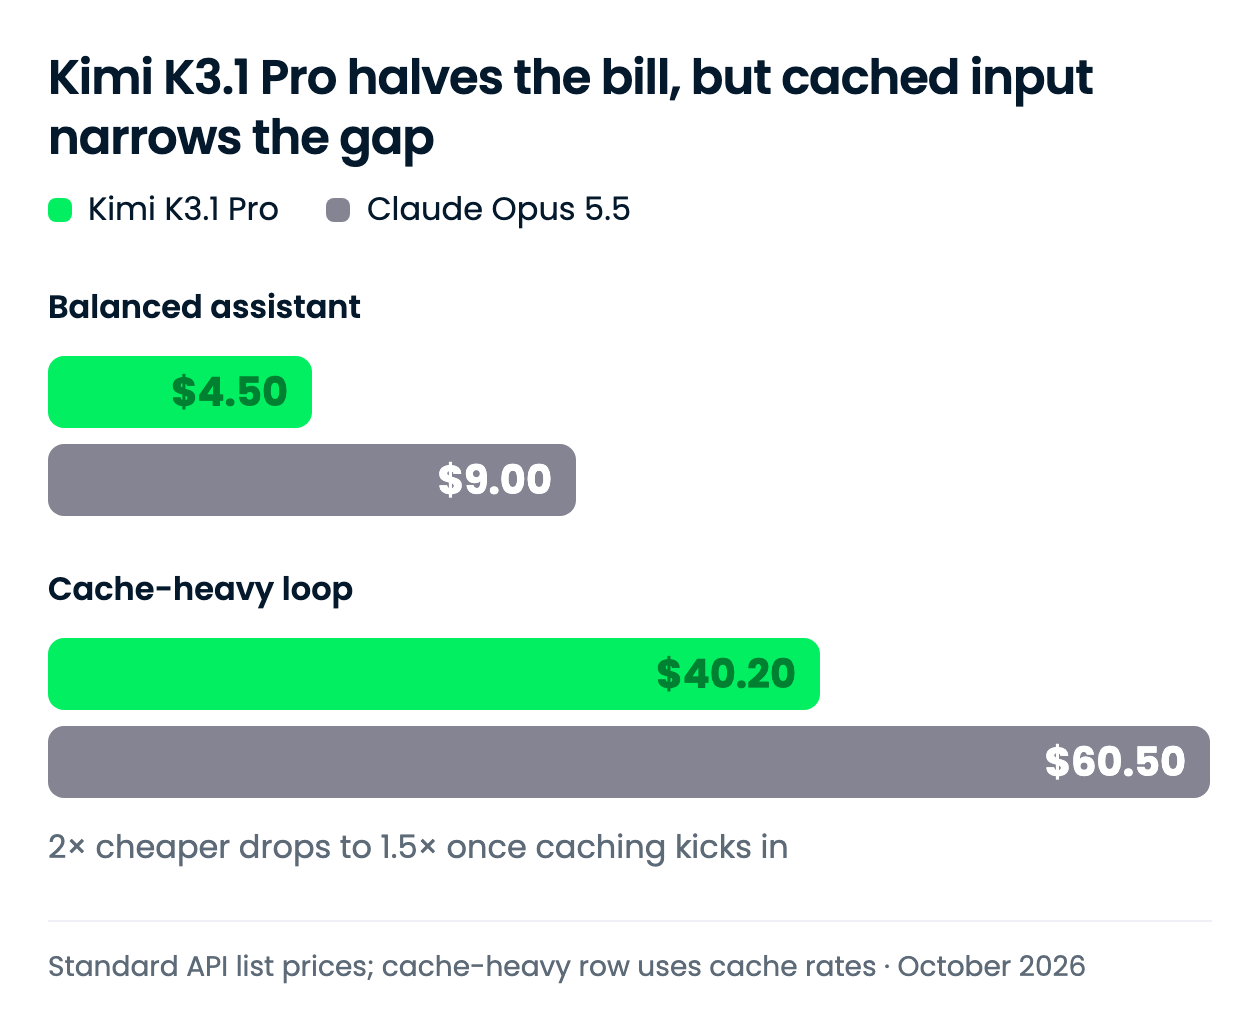
Kimi K3.1 Pro มีราคาครึ่งหนึ่งของ Opus 5.5 บนโทเค็นใหม่ การประหยัดจะหดลงเมื่อเวิร์กโหลดรันบนคอนเท็กซ์ที่แคชไว้ เพราะทั้งสองคิดราคาอ่านแคชเท่ากัน
ทุกอัตราเป็นราคาต่อ 1M โทเค็น อ้างอิงจากหน้าราคาอย่างเป็นทางการของ Moonshot และ Anthropic
| อัตรา | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| อินพุต ต่อ 1M โทเค็น | $2.00 | $4.00 |
| เอาต์พุต ต่อ 1M โทเค็น | $10.00 | $20.00 |
| อ่านอินพุตที่แคช ต่อ 1M โทเค็น | $0.20 | $0.20 |
| เขียนแคช TTL 5 นาที | $2.00 | $5.00 |
| เขียนแคช TTL 1 ชั่วโมง | $4.00 | $8.00 |
| ตัวเลือกเร็วขึ้น | K3.1 Pro Highspeed เร็วขึ้น 2–3 เท่า: $4.00 / $20.00 | โหมดเร็ว สูงสุด 2.5 เท่า: $8.00 / $40.00 |
ตัวคูณไม่คงที่: 0.5x บนอินพุต เอาต์พุต และการเขียนแคช 1 ชั่วโมง, 0.4x บนการเขียนแคช 5 นาที และ 1.0x บนการอ่านแคช ไม่มีผู้ให้บริการรายใดคิดเงินเพิ่มสำหรับคอนเท็กซ์ยาว
มีข้อสังเกต 2 ข้อจากตาราง: ตัวเลือก Highspeed ของ Kimi มีราคาเท่ากับ Opus มาตรฐาน Batch API ของ Anthropic ลดราคา Opus ครึ่งหนึ่งเหลือ $2 และ $10 ซึ่งเท่ากับอัตรามาตรฐานของ Kimi ขณะที่หน้าราคาของ Moonshot ไม่ระบุส่วนลดแบบแบตช์
เลือกเวิร์กโหลดรายเดือน 2 แบบ: ผู้ช่วยแบบสมดุลเพื่อยึดสเกล และลูปเอเจนต์ที่พึ่งพาแคชมาก เพราะราคาการแคชคือตรงที่สองตารางราคาต่างกัน
| เวิร์กโหลด | Kimi K3.1 Pro | Claude Opus 5.5 | ส่วนต่าง |
|---|---|---|---|
| ผู้ช่วยสมดุล: 1M อิน / 250K เอาต์ | $4.50 | $9.00 | $4.50 (Kimi ถูกกว่า 50%) |
| ลูปหนักแคช: พรีฟิกซ์ 100K เขียนครั้งเดียว อ่านแคช 1,000 ครั้ง บวกอินพุตใหม่ 5K / เอาต์พุต 1K ต่อคำขอ | $40.20 | $60.50 | $20.30 (Kimi ถูกกว่าราว 34%) |
แต่ละยอดเท่ากับ (ปริมาณ ÷ 1M) × อัตรา รวมอินพุต เอาต์พุต และรายการแคช แถวลูปหนักแคชใช้การเขียนแคช 5 นาที แถวสมดุลสะท้อนช่องว่างอัตรา 2 เท่าตรงๆ
แถวลูปหนักแคชคือสิ่งที่ควรวางแผน รอบโทเค็นที่แคชไว้ 100M มีค่า $20 กับทั้งสองโมเดล ดังนั้นมีเพียงโทเค็นใหม่และการเขียนแคชเท่านั้นที่ได้ส่วนลดของ Kimi ทำให้การประหยัดเหลือราวหนึ่งในสาม Anthropic ระบุว่าการอ่านแคชคิดเป็นสัดส่วนหลักของต้นทุนการโค้ดแบบเอเจนต์ จึงมีแนวโน้มว่าเอเจนต์ระยะยาวจะเข้าใกล้แถวนี้มากกว่าแถวแรก
ทั้งสองใช้ตัวแบ่งโทเค็นต่างกัน และยังไม่มีการเผยแพร่นับโทเค็นบนเวิร์กโหลดร่วมกัน จึงควรมองยอดรวมเหล่านี้เป็นการเทียบอัตรามากกว่าบิลจริง
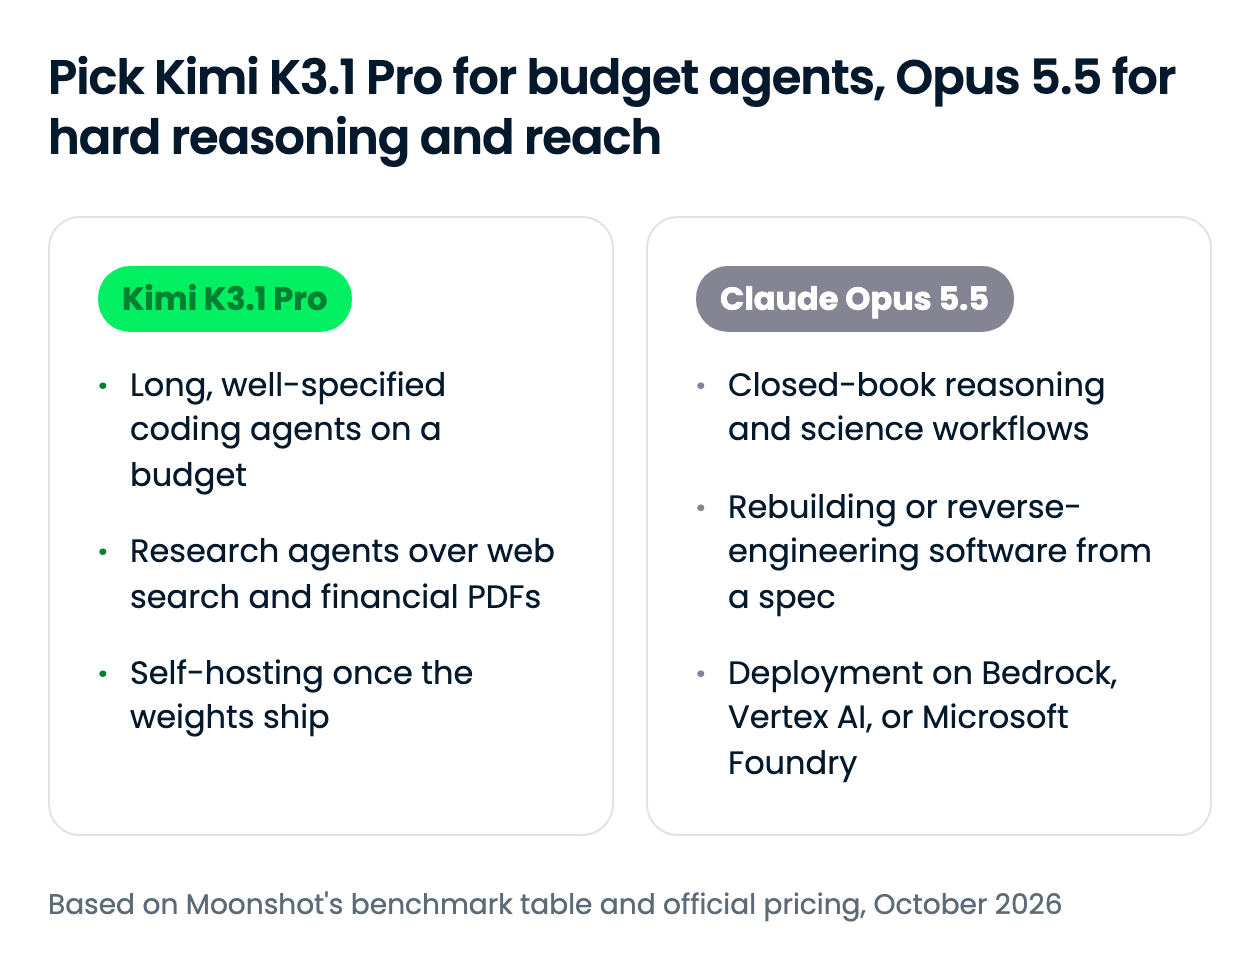
แกนตัดสินใจคือราคาเทียบกับความครอบคลุม: Kimi K3.1 Pro ลดอัตราต่อโทเค็นครึ่งหนึ่ง ขณะที่ Opus 5.5 ครอบคลุมกรณีให้เหตุผลที่ Kimi ตามหลัง และแพลตฟอร์มคลาวด์ที่ Kimi ยังไม่ยืนยัน หากเอเจนต์รันบนคอนเท็กซ์ที่แคชเป็นหลัก การประหยัดจะใกล้หนึ่งในสามมากกว่าครึ่ง
วันนี้สามารถเรียกใช้ทั้งสองผ่าน API ของแต่ละรายหรือผ่าน OpenRouter และ Opus 5.5 ยังรันบน Amazon Bedrock, Vertex AI และ Microsoft Foundry ด้วย
| ช่องทาง | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| แอปสำหรับผู้ใช้ทั่วไป | Kimi.com, แอปมือถือ Kimi, แอปเดสก์ท็อป Kimi Work | แอป Claude (Pro, Max, Team, Enterprise) |
| API ของผู้ให้บริการ | Kimi API (เข้ากันได้กับ OpenAI) | Claude API |
| แพลตฟอร์มคลาวด์ | ยังไม่พร้อมใช้งานบน Azure AI Foundry หรือ Amazon Bedrock ณ 29 ต.ค. 2026 | Amazon Bedrock, Vertex AI, Microsoft Foundry |
| เอเจนต์โค้ด | Kimi Code (ยังไม่พร้อมใน GitHub Copilot และ Cursor ณ 29 ต.ค. 2026) | Claude Code, Cursor, GitHub Copilot |
| เราเตอร์บุคคลที่สาม | OpenRouter | OpenRouter |
| น้ำหนักโมเดลเปิด | มีกำหนดภายใน 4 พฤศจิกายน 2026 | ไม่มี |
| รหัสโมเดล API | kimi-k3.1-pro |
claude-opus-5-5 |
ช่องว่างด้านการเข้าถึงคือปัจจัยตัดสินสำหรับหลายทีม: Opus 5.5 อยู่บนคลาวด์หลักทุกเจ้าและในเอเจนต์โค้ดกระแสหลัก ขณะที่ Kimi K3.1 Pro ยืนยันเพียงบนแพลตฟอร์มของ Moonshot เองและ OpenRouter จนกว่าน้ำหนักโมเดลจะมาถึง บน API ของผู้ให้บริการ รหัสโมเดลคือ kimi-k3.1-pro และ claude-opus-5-5; บน OpenRouter คือ moonshotai/kimi-k3.1-pro และ anthropic/claude-opus-5.5
เอ็นด์พอยต์แบบเข้ากันได้กับ OpenAI ของ OpenRouter ทำให้สองโมเดลนี้สลับกันได้ด้วยการเปลี่ยนสตริงเดียว ซึ่งเป็นวิธีที่ง่ายที่สุดในการทดสอบ A/B กับพรอมต์ของตนเอง
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",  # swap for "anthropic/claude-opus-5.5"
    messages=[{"role": "user", "content": "Find the race condition in this worker pool..."}],
)
print(response.choices[0].message.content)
บทเรียน API ของ Opus 5.5 ของเราเจาะลึกฝั่ง Claude และบทความอธิบาย OpenCode จะแสดงวิธีเสียบโมเดลใดๆ เข้าเอเจนต์โค้ดโอเพนซอร์ส
Kimi K3.1 Pro ทำได้ทัดเทียม Claude Opus 5.5 ในการโค้ดผ่านเทอร์มินัล และชนะในงานเอเจนต์ระยะยาวที่ใช้เครื่องมือมาก โดยมีส่วนลดราคาชัดเจน หากเอเจนต์ทำงานยาวๆ ที่นิยามชัดและใช้เครื่องมือ ให้เลือก Kimi; หากต้องให้เหตุผลล้วน ไล่ตามสเปกคลุมเครือ หรือจำเป็นต้องอยู่บน AWS, Google Cloud หรือ Azure ให้เลือก Opus
สิ่งที่น่าสนใจคือสองแล็บจัดการความเสี่ยงเดียวกันต่างวิธีกัน: Moonshot ตัดความสามารถไซเบอร์ออกจากน้ำหนักโมเดลก่อนเผยแพร่ ขณะที่ Anthropic เก็บไว้ในโมเดลและกั้นไว้ตอนเสิร์ฟ แนะนำให้ทดสอบ Kimi ผ่าน OpenRouter และกลับมาพิจารณาโฮสต์เองอีกครั้งเมื่อได้น้ำหนักและไลเซนส์ในเดือนพฤศจิกายน
หากอยากเริ่มสร้างด้วยโมเดลแบบนี้ แนะนำดูแทร็ก Associate AI Engineer for Developers ของเรา
เรียน AI กับ DataCamp!
แทร็ก
คอร์ส
ฝึกฝนและตรวจสอบความก้าวหน้าของคุณ
ดำเนินการต่อด้วย Google