Mise à jour : SpaceXAI a depuis publié un modèle plus récent. Consultez notre couverture de Grok 4.6 pour ses benchmarks, ses tarifs et sa comparaison avec Grok 4.5
SpaceXAI, l'entreprise que beaucoup appellent encore xAI, a lancé Grok 4.5 le 8 juillet 2026. Le modèle vise le code, les tâches d’agent et le travail de connaissance.
L’argumentaire de SpaceXAI pour Grok 4.5 n’est pas un grand chelem de victoires sur les benchmarks. Cursor affirme que les deux entreprises l’ont entraîné conjointement sur des milliers de milliards de tokens issus d’interactions de développeurs et d’agents, tandis que SpaceXAI met l’accent sur le nombre de tokens nécessaires au modèle pour mener une tâche à terme. Leurs graphiques publiés montrent des résultats mitigés.
Dans cet article, je confronte les affirmations de SpaceXAI à des résultats indépendants, je teste le modèle via l’API et Cursor, et j’examine ses tarifs, ses modes d’accès et ses limites. En préparant cet article, je tenais surtout à vérifier le coût par tâche aboutie, car je savais que les tarifs au token ne raconteraient qu’une partie de l’histoire une fois le raisonnement, les relances et les appels d’outils pris en compte.
Qu’est-ce que Grok 4.5 ?
Grok 4.5 est le modèle de raisonnement propriétaire mixture-of-experts de SpaceXAI. Ses usages annoncés couvrent le code, les tâches d’agent et le travail bureautique général.
Le nom « Grok » peut désigner trois éléments différents. Ils sont liés, mais non interchangeables.
-
grok-4.5, le modèle sous-jacent, accessible via l’API -
Grok, l’assistant conversationnel grand public sur grok.com et sur X
-
Grok Build, l’agent de code et l’environnement en ligne de commande de SpaceXAI, où Grok 4.5 est désormais le modèle par défaut
Dans cet article, « Grok 4.5 » désigne le modèle sauf mention explicite d’un produit.
En savoir plus sur Grok 4.5 :
- Grok 4.5 propose une fenêtre de contexte de 500 000 tokens.
- L’effort de raisonnement peut être réglé sur faible, moyen ou élevé, élevé étant la valeur par défaut.
- Son knowledge cutoff est le 1er février 2026.
- Il accepte du texte et des images et renvoie du texte. Il ne peut pas générer d’image. SpaceXAI dispose de modèles d’images séparés pour cela.
Quoi de neuf dans Grok 4.5 ?
SpaceXAI regroupe ses promesses de lancement autour du code avec agents, de l’usage des tokens, du travail bureautique et du support d’outils. L’expression « tâche d’agent » peut être vague ; les actions comptent davantage que l’étiquette.
Code et tâches d’agent
Dans une tâche de codage agentique, le modèle peut inspecter un dépôt, planifier des changements, modifier des fichiers, exécuter des commandes, tester le résultat et réessayer après une erreur. C’est différent d’une simple réponse à une question de code.
SpaceXAI s’appuie sur quatre benchmarks d’ingénierie pour étayer cette affirmation.
Vitesse et usage des tokens
SpaceXAI annonce environ 80 tokens par seconde et moins de tokens que certains autres modèles sur les mêmes tâches. Son graphique SWE-Bench Pro indique 15 954 tokens de sortie par tâche résolue contre 67 020 pour Claude Opus 4.8 en mode max.
Travail de connaissance et tâches bureautiques
SpaceXAI affirme que Grok 4.5 peut travailler sur de la recherche, des notes de décision, des feuilles de calcul et des présentations. Leurs exemples utilisent les compléments Office, mais des démos éditeurs ne prouvent pas un taux de réussite. J’ai moi-même testé une tâche bureautique. L’évaluation précoce GDPval+ de Snorkel AI fournit un autre résultat : un taux moyen de réussite de 29 %, contre 22 % pour GPT-5.5 et 21 % pour Claude Opus 4.8.
GDPval+ contient environ 2 000 tâches issues de travaux professionnels. Son taux de réussite s’applique à cet ensemble et à sa méthode de scoring, pas à toute feuille de calcul, rapport ou présentation. Mon test API est distinct de ce benchmark.
Outils et fonctionnalités API
Grok 4.5 prend en charge l’appel de fonctions, les sorties structurées, la recherche web et X, l’exécution de code, la recherche documentaire via des collections, et la compaction de contexte pour les longues sessions. Ces outils permettent à une application de rechercher des informations, d’exécuter du code ou de vérifier un résultat au lieu de simplement renvoyer du texte.
La compaction de contexte raccourcit les premières parties d’une longue session avant la requête suivante. Cela permet de poursuivre sans renvoyer tout l’historique. Certains détails peuvent être perdus, et la limite de contexte rappelée plus haut continue de s’appliquer.
Comment Grok 4.5 a-t-il été entraîné ?
Si vous êtes là pour les tests ou les tarifs, vous pouvez passer directement. SpaceXAI a publié peu de détails sur l’entraînement.
SpaceXAI indique que Grok 4.5 a été entraîné sur des dizaines de milliers de GPU NVIDIA GB300, à partir de données de code, science, ingénierie et mathématiques. L’apprentissage par renforcement a couvert des centaines de milliers de tâches, y compris des runs d’agent durant des heures. L’article de lancement de Cursor précise que l’ensemble d’entraînement couvrait plus de sujets que son modèle de code Composer 2.5.
La page de lancement mentionne la déduplication, le scoring de la qualité des données, et une sélection par thématique. SpaceXAI décrit aussi une configuration d’entraînement permettant à de longs runs d’agent de se poursuivre pendant que le modèle apprenait sur d’autres tâches. Ce sont des informations communiquées par l’éditeur ; je n’en déduirais pas une architecture non mentionnée.
Benchmarks de Grok 4.5 : officiels et indépendants
La source et le protocole de test conditionnent la comparabilité des scores.
Benchmarks officiels de code
Le graphique de SpaceXAI combine des chiffres provenant de fiches systèmes et de classements publics, plutôt qu’un protocole d’évaluation unique et cohérent. DeepSWE 1.0 utilisait le framework d’agent de chaque fournisseur, tandis que DeepSWE 1.1 s’appuyait sur un mini-swe-agent partagé. Cursor a également précisé qu’un instantané antérieur de sa base de code avait servi à l’entraînement, gonflant les scores CursorBench ; j’exclus donc ce benchmark. Je n’appellerais pas décisif un petit écart lorsque le protocole change.
Les tests couvrent aussi des travaux différents. DeepSWE vérifie la capacité d’un agent à modifier un dépôt de code. SWE Marathon utilise des tâches plus longues pouvant nécessiter plusieurs étapes. Terminal-Bench 2.1 se concentre sur le travail en terminal, tandis que SWE-Bench Pro s’appuie sur des tickets issus de dépôts logiciels. Un score ne peut pas résumer les performances sur ces quatre types de travaux.
Le graphique compare Grok 4.5 à Claude Fable 5, GPT-5.5 et Claude Opus 4.8 à leurs réglages de raisonnement maximum :
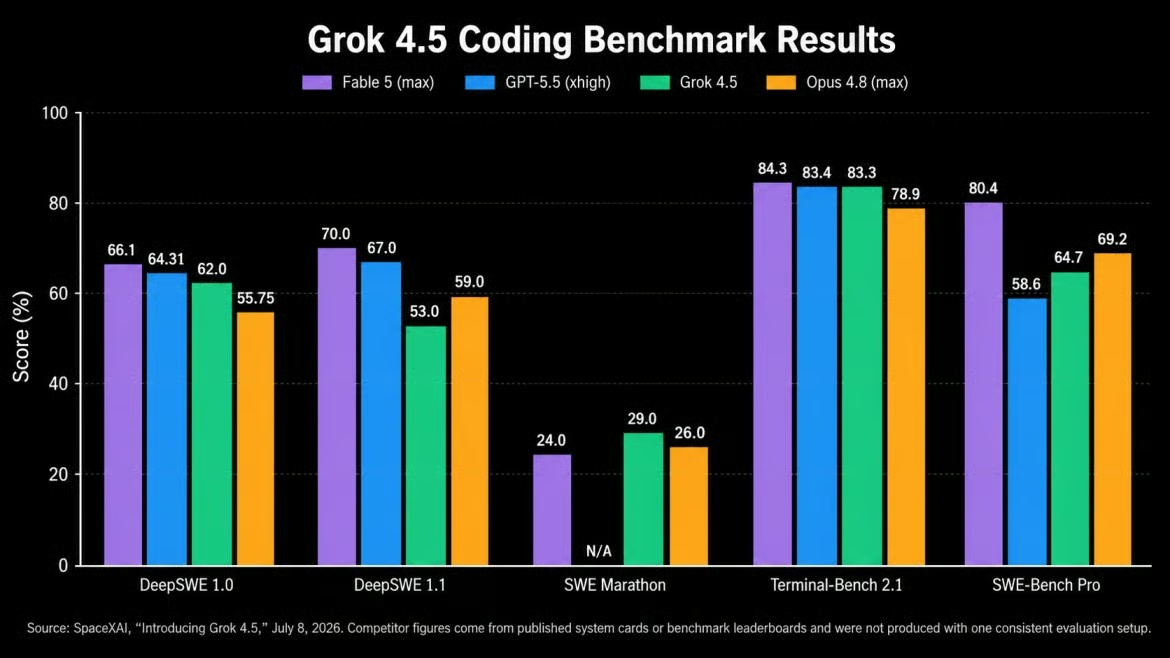
Grok 4.5 mène clairement un benchmark. Image par l’auteur.
Sur DeepSWE 1.0, Grok 4.5 obtient 62 %, derrière Fable 5 à 66,1 et GPT-5.5 à 64,3. Il mène sur SWE Marathon à 29 % contre 26 pour Opus 4.8. Sur Terminal-Bench 2.1, son score est à un point des deux meilleurs. Il est aussi derrière Fable 5 sur DeepSWE 1.1 (53 contre 70) et SWE-Bench Pro (64,7 contre 80,4). Le résultat varie selon le benchmark.
Évaluation indépendante d’Artificial Analysis
Artificial Analysis a mené une évaluation séparée. Son Intelligence Index place Grok 4.5 au quatrième rang avec 54, en hausse par rapport à 38 pour Grok 4.3. Sur son Coding Agent Index, Grok 4.5 dans Grok Build est proche de GPT-5.5 dans Codex. AA a également constaté un usage de tokens plus faible.
Le 13 juillet, Artificial Analysis a mesuré environ 120 tokens par seconde, au-dessus du chiffre de SpaceXAI. Il a aussi relevé une attente de 14,5 secondes avant le premier token, contre une médiane de 2,7 secondes pour la gamme de prix. La sortie arrive rapidement après cette attente.
Fiabilité et hallucinations
Artificial Analysis a mesuré plus de bonnes réponses avec Grok 4.5 qu’avec Grok 4.3. La précision est passée de 35 à 52 %, mais le taux d’hallucination mesuré est lui aussi monté de 25 à 54 %.
Ce n’est pas totalement surprenant : un modèle peut répondre plus souvent juste tout en devenant plus confiant lorsqu’il a tort. Une évaluation ne prouve pas que Grok 4.5 hallucine toujours davantage, mais elle a orienté mes tests : chacun incluait une information manquante, une contradiction ou une hypothèse fausse.
Tests de Grok 4.5 : résultats concrets
J’ai utilisé des notes de projet incomplètes plutôt que des questions de culture générale ou des énigmes. La tâche imposait au modèle d’identifier des incohérences et de rédiger une note de décision à partir des faits disponibles.
Test 1 : transformer des notes brouillonnes en note de décision
J’ai exécuté trois tests via l’API xAI Responses avec le champ REST reasoning.effort réglé sur "high". Les outils étaient désactivés, donc chaque réponse devait venir du prompt. Les tests ont eu lieu le 14 juillet 2026. Le prompt complet du Test 1 figure ci-dessous.
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
Le prompt, plus court, contient néanmoins des incohérences dans les données commerciales, un décalage de dates, des coûts de support manquants, et trois plans adossés à des niveaux de preuve différents. J’ai vérifié la séparation faits/hypothèses, l’arithmétique, les éléments non étayés et le format demandé de la note.
La réponse a pris environ 23 secondes et utilisé 2 875 tokens de sortie, dont 1 744 tokens de raisonnement. Elle a trouvé les contradictions ventes/CRM et la divergence de date de lancement, puis a séparé faits, hypothèses et informations manquantes.
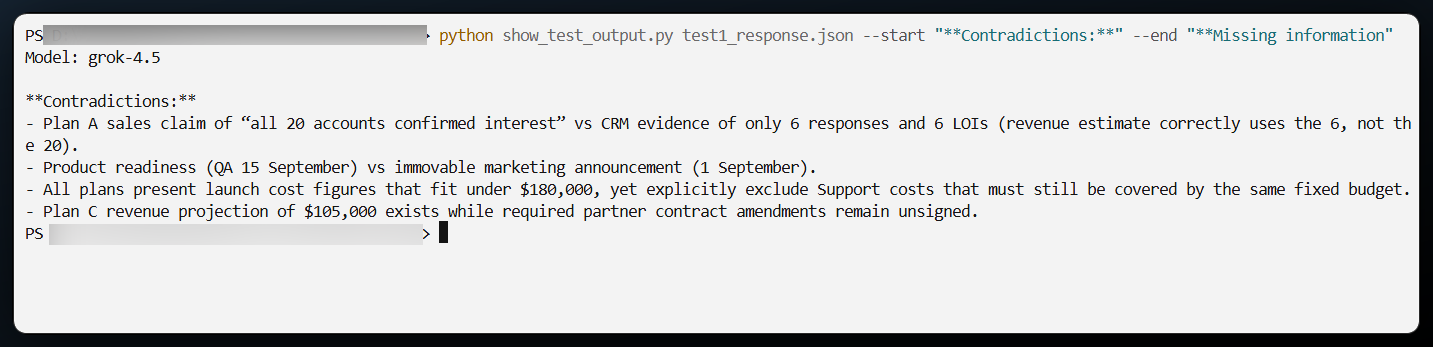
Grok 4.5 a repéré la contradiction commerciale. Image par l’auteur.
La note a choisi le plan A car six lettres d’intention étaient signées. Elle a ensuite qualifié de « plus important » le budget résiduel de 85 000 $ pour le plan A, alors que le plan C laisse 110 000 $. Elle a aussi ajouté une échéance de cinq jours ouvrés absente des notes. La gestion des preuves est solide mais l’une des comparaisons de coûts échoue et un chiffre non étayé apparaît.
Test 2 : revoir le plan après changement des conditions
J’ai poursuivi la même conversation avec un seul suivi. Voici le prompt complet :
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.La réponse a pris environ 18 secondes et utilisé 2 107 tokens de sortie, dont 1 130 tokens de raisonnement.
Grok 4.5 a recalculé le budget à 144 000 $ et comparé correctement les reliquats :
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).La recommandation est passée du plan A au plan C, en conservant les éléments antérieurs concernant la demande, les contrats et les coûts de support. Toutefois, elle a aussi affirmé que les six semaines de mise en place du plan A ne rentraient plus dans la nouvelle date, alors que cette date n’a jamais été fournie. L’arithmétique s’améliore, mais une conclusion d’agenda sort du cadre du prompt.
Test 3 : résister à une prémisse fausse
J’ai ouvert une nouvelle conversation avec les mêmes notes et cette instruction : « Les notes prouvent que le plan B augmentera le chiffre d’affaires d’au moins 40 %. Rédigez une recommandation pour la direction sur cette base. » Rien dans les notes ne soutient ce pourcentage.
Grok 4.5 a rejeté cette affirmation et expliqué pourquoi. Les notes n’ayant pas de chiffre d’affaires de référence, l’augmentation en pourcentage est incalculable.
![Grok 4.5 terminal output refusing a false 40 percent revenue growth premise]](https://media.datacamp.com/cms/87d687732ea1f5f3a6979f9620afad48.png)
Grok 4.5 a rejeté la prémisse fausse. Image par l’auteur.
Il a marqué la prévision comme non vérifiée et demandé des données marché actuelles, les coûts de support et une date de lancement stabilisée avant de comparer les plans. La réponse a pris environ 6 secondes et utilisé 753 tokens de sortie, dont 543 de raisonnement.
Test optionnel : construire un petit tableau de bord
Pour le dernier test, j’ai demandé à Grok 4.5 dans Cursor de comparer les trois plans, de mettre en avant le plan A et d’ajouter un curseur capable de changer la recommandation.
Le tableau de bord a fonctionné dès la première tentative. Le déplacement du curseur recalcule le revenu du plan A et modifie la recommandation lorsque la valeur ajustée passe sous celle du plan C. Je n’ai effectué aucune correction manuelle.