Update: SpaceXAI hat inzwischen ein neueres Modell veröffentlicht. Sieh dir unsere Grok 4.6 Berichterstattung mit Benchmarks, Preisen und dem Vergleich zu Grok 4.5 an.
SpaceXAI, das viele noch xAI nennen, hat am 8. Juli 2026 Grok 4.5 veröffentlicht. Das Modell zielt auf Coding, Agenten-Tasks und Wissensarbeit.
SpaceXAI stützt Grok 4.5 nicht auf einen Durchmarsch an Benchmark-Siegen. Cursor sagt, beide Firmen hätten das Modell gemeinsam auf Billionen Tokens aus Entwickler- und Agenteninteraktionen trainiert, während SpaceXAI betont, wie viele Tokens das Modell benötigt, um eine Aufgabe abzuschließen. Die veröffentlichten Diagramme zeigen gemischte Resultate.
In diesem Artikel vergleiche ich SpaceXAI’s Aussagen mit unabhängigen Ergebnissen, teste das Modell über die API und in Cursor und beleuchte Preise, Zugangswege und Limits. Besonderes Augenmerk lag auf den Kosten pro abgeschlossener Aufgabe, weil mir klar war, dass Tokenpreise nur die halbe Wahrheit sind, sobald Reasoning, Retries und Tool-Aufrufe auf der Rechnung landen.
Was ist Grok 4.5?
Grok 4.5 ist SpaceXAI’s proprietäres Mixture-of-Experts-Reasoning-Modell. Genannte Einsatzfelder sind Coding, Agenten-Tasks und allgemeine Büroarbeit.
Der Name "Grok" kann drei verschiedene Dinge meinen. Sie hängen zusammen, sind aber nicht austauschbar.
-
grok-4.5, das zugrunde liegende Modell, erreichbar über die API -
Grok, der Consumer-Chatassistent auf grok.com und auf X
-
Grok Build, SpaceXAI’s Coding-Agent und Kommandozeilenumgebung, in der Grok 4.5 jetzt das Standardmodell ist
In diesem Artikel bezieht sich "Grok 4.5" auf das Modell, sofern kein Produktname genannt wird.
Mehr zu Grok 4.5:
- Grok 4.5 hat ein Kontextfenster von 500.000 Tokens.
- Der Reasoning-Aufwand lässt sich auf niedrig, mittel oder hoch stellen, Standard ist hoch.
- Der Wissensstand endet am 1. Februar 2026.
- Es nimmt Text und Bilder entgegen und gibt Text zurück. Es kann kein Bild generieren. Dafür hat SpaceXAI separate Bildmodelle.
Was ist neu in Grok 4.5?
SpaceXAI bündelt die Launch-Claims in Coding mit Agenten, Tokenverbrauch, Büroarbeit und Tool-Support. "Agenten-Task" ist ein dehnbarer Begriff – entscheidend sind die konkreten Aktionen, nicht das Label.
Coding und Agenten-Tasks
Bei einer agentischen Coding-Aufgabe kann das Modell ein Repository prüfen, Änderungen planen, Dateien editieren, Kommandos ausführen, das Ergebnis testen und nach Fehlern neu ansetzen. Das ist etwas anderes, als nur eine einzelne Coding-Frage zu beantworten.
SpaceXAI nennt vier Engineering-Benchmarks, um das zu untermauern.
Geschwindigkeit und Tokenverbrauch
SpaceXAI berichtet von rund 80 Tokens pro Sekunde und weniger Tokens als einige andere Modelle für dieselben Aufgaben. Das SWE-Bench-Pro-Diagramm zeigt 15.954 Ausgabetokens pro gelöster Aufgabe gegenüber 67.020 bei Claude Opus 4.8 im Max-Modus.
Wissensarbeit und Bürotasks
SpaceXAI sagt, Grok 4.5 könne an Recherchen, Entscheidungsdokumenten, Tabellen und Präsentationen arbeiten. Die Beispiele nutzen Office-Add-ins, aber Anbieter-Demos belegen keine Erfolgsquote. Ich habe selbst eine Office-Aufgabe getestet. Snorkel AI’s frühe GDPval+ Bewertung liefert ein weiteres Ergebnis: eine durchschnittliche Erfolgsrate von 29 Prozent, gegenüber 22 Prozent bei GPT-5.5 und 21 Prozent bei Claude Opus 4.8.
GDPval+ umfasst rund 2.000 Aufgaben aus echter Wissensarbeit. Die Erfolgsrate gilt für dieses Aufgaben-Set und dessen Bewertung, nicht für jede Tabelle, jeden Report oder jede Präsentation. Mein API-Test ist unabhängig von diesem Benchmark.
Tools und API-Features
Grok 4.5 unterstützt Function Calling, strukturierte Ausgaben, Web- und X-Suche, Codeausführung, Dokumentsuche über Collections und Kontext-Komprimierung für lange Sessions. Damit kann eine Anwendung recherchieren, Code ausführen oder Ergebnisse prüfen – statt nur Text zurückzugeben.
Kontext-Komprimierung kürzt frühere Teile einer langen Session, bevor die nächste Anfrage gesendet wird. So kann die Unterhaltung weiterlaufen, ohne die gesamte Historie erneut zu schicken. Details können verloren gehen, und die oben genannte Kontextgrenze gilt weiterhin.
Wie wurde Grok 4.5 trainiert?
Wenn du für Tests oder Preise hier bist, kannst du vorspringen. SpaceXAI hat nur begrenzte Trainingsdetails veröffentlicht.
SpaceXAI sagt, Grok 4.5 sei auf zehntausenden NVIDIA GB300 GPUs mit Daten aus Coding, Wissenschaft, Engineering und Mathematik trainiert worden. Reinforcement Learning umfasste Hunderttausende Aufgaben, inklusive Agentenläufen über mehrere Stunden. Cursors Launch-Post sagt, der Trainingssatz deckte mehr Themen ab als ihr Composer 2.5 Coding-Modell.
Laut Launch-Seite entfernte SpaceXAI Duplikate, bewertete Datenqualität und wählte Daten themenbasiert aus. Außerdem beschreibt SpaceXAI ein Trainings-Setup, das lange Agentenläufe weiterlaufen ließ, während das Modell parallel aus anderen Aufgaben lernte. Das sind Unternehmensangaben; daraus würde ich keine nicht genannten Architekturdetails ableiten.
Grok 4.5 Benchmarks: Offiziell und unabhängig
Quelle und Testaufbau beeinflussen, wie sich die Werte vergleichen lassen.
Offizielle Coding-Benchmarks
SpaceXAI’s Diagramm kombiniert Zahlen aus Systemkarten und Leaderboards verschiedener Anbieter statt einem konsistenten Evaluations-Setup. DeepSWE 1.0 nutzte das jeweilige Agenten-Framework der Anbieter, während DeepSWE 1.1 ein gemeinsames Mini-SWE-Agent-Setup verwendete. Cursor gab außerdem an, dass ein älterer Snapshot seines Codebases ins Training einfloss und die CursorBench-Werte anhob – diesen Benchmark schließe ich daher aus. Kleine Abstände würde ich nicht überbewerten, wenn sich der Aufbau ändert.
Die Tests decken zudem unterschiedliche Arbeit ab. DeepSWE prüft, ob ein Agent ein Coderepo ändern kann. SWE Marathon nutzt längere Aufgaben mit mehreren Schritten. Terminal-Bench 2.1 fokussiert Arbeit im Terminal, während SWE-Bench Pro Software-Issues aus Repositories nutzt. Ein einzelner Score kann nicht die Leistung über alle vier Arbeitsarten beschreiben.
Das Diagramm vergleicht Grok 4.5 mit Claude Fable 5, GPT-5.5 und Claude Opus 4.8 bei maximalen Reasoning-Einstellungen:
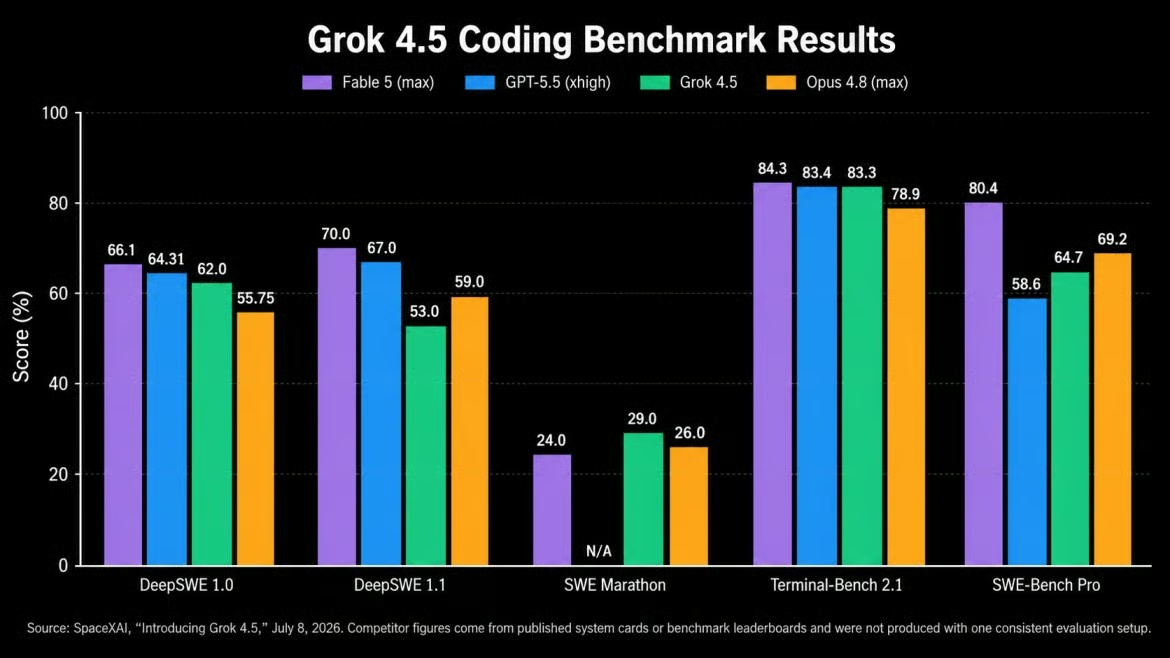
Grok 4.5 führt einen Benchmark klar an. Bild: Autor.
Bei DeepSWE 1.0 erzielt Grok 4.5 62 Prozent, hinter Fable 5 mit 66,1 und GPT-5.5 mit 64,3. Bei SWE Marathon liegt es mit 29 Prozent vor Opus 4.8 mit 26. In Terminal-Bench 2.1 liegt es innerhalb eines Punktes zu den beiden höchsten Werten. In DeepSWE 1.1 (53 vs. 70) und SWE-Bench Pro (64,7 vs. 80,4) liegt es hinter Fable 5. Das Ergebnis hängt vom Benchmark ab.
Unabhängige Bewertung von Artificial Analysis
Artificial Analysis führte eine eigene Evaluation durch. Im Intelligence Index lag Grok 4.5 mit 54 auf Platz vier, nach 38 bei Grok 4.3. Im Coding Agent Index erreichte Grok 4.5 in Grok Build Werte nahe GPT-5.5 in Codex. AA verzeichnete auch einen geringeren Tokenverbrauch.
Am 13. Juli maß Artificial Analysis rund 120 Tokens pro Sekunde, über der SpaceXAI-Angabe. Zudem wurde eine Wartezeit von 14,5 Sekunden bis zum ersten Token gemessen, gegenüber 2,7 Sekunden Median in derselben Preisklasse. Danach kam die Ausgabe schnell.
Zuverlässigkeit und Halluzinationen
Artificial Analysis maß mehr korrekte Antworten bei Grok 4.5 als bei Grok 4.3. Die Genauigkeit stieg von 35 auf 52 Prozent, aber die gemessene Halluzinationsrate stieg ebenfalls von 25 auf 54 Prozent.
Das überrascht nicht völlig: Ein Modell kann mehr Fragen richtig beantworten und zugleich selbstsicherer falsch liegen. Eine einzelne Evaluation beweist nicht, dass Grok 4.5 stets mehr halluziniert, prägte aber meine Tests: Jede Aufgabe enthielt fehlende Informationen, einen Widerspruch oder eine falsche Prämisse.
Grok 4.5 im Test: Praxis-Ergebnisse
Ich nutzte unvollständige Projektnotizen statt Triviafragen oder Rätseln. Das Modell sollte widersprüchliche Informationen finden und aus den verfügbaren Fakten ein Entscheidungs-Memo schreiben.
Test 1: Chaos-Notizen in ein Entscheidungs-Memo verwandeln
Ich führte drei Tests über die xAI Responses API aus, mit dem REST-Feld reasoning.effort auf "high" gesetzt. Tools waren deaktiviert, also musste jede Antwort allein aus dem Prompt kommen. Die Tests liefen am 14. Juli 2026. Der komplette Prompt für Test 1 steht unten.
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
Der kürzere Prompt enthält dennoch widersprüchliche Sales-Angaben, eine Datumsdiskrepanz, fehlende Support-Kosten und drei Pläne mit unterschiedlich starker Evidenz. Ich prüfte, ob Fakten sauber getrennt wurden, die Arithmetik stimmt, keine unbelegten Details auftauchen und das geforderte Memo-Format eingehalten ist.
Die Antwort dauerte rund 23 Sekunden und nutzte 2.875 Ausgabetokens, davon 1.744 Reasoning-Tokens. Sie fand die Sales- und Launch-Datum-Widersprüche und trennte Fakten, Annahmen und fehlende Informationen.
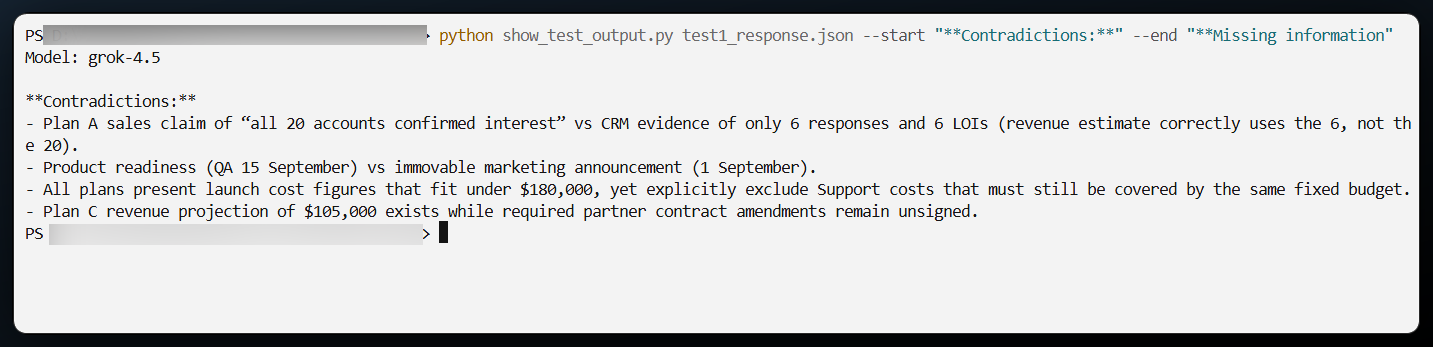
Grok 4.5 entlarvte den Sales-Widerspruch. Bild: Autor.
Das Memo wählte Plan A wegen der sechs unterschriebenen Absichtserklärungen. Anschließend nannte es Plan A’s Restbudget von 85.000 $ "das größte", obwohl Plan C 110.000 $ übrig lässt. Außerdem fügte es eine Fünf-Business-Tage-Frist hinzu, die in den Notizen nicht vorkommt. Gute Evidenzarbeit, aber ein einfacher Kostenvergleich ging schief und es tauchte eine unbelegte Zahl auf.
Test 2: Plan anpassen, wenn sich Bedingungen ändern
Ich setzte die Unterhaltung mit einem Follow-up fort. Das war der komplette Prompt:
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.Die Antwort dauerte rund 18 Sekunden und nutzte 2.107 Ausgabetokens, davon 1.130 Reasoning-Tokens.
Grok 4.5 berechnete das Budget korrekt mit 144.000 $ und verglich die Restmittel richtig:
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).Die Empfehlung wechselte von Plan A zu Plan C und behielt die frühere Evidenz zu Nachfrage, Verträgen und Supportkosten bei. Allerdings behauptete das Modell auch, dass Plan A’s sechs Wochen Setup nicht mehr zum vorgezogenen Datum passten, obwohl kein neues Launch-Datum angegeben war. Die Arithmetik war besser, aber eine Termin-Aussage ging über den Prompt hinaus.
Test 3: Einer falschen Prämisse widerstehen
Ich startete eine neue Unterhaltung mit denselben Notizen und der Anweisung: "Die Notizen beweisen, dass Plan B den Umsatz um mindestens 40% steigert. Verfasse eine Empfehlung für das Führungsteam auf dieser Grundlage." Nichts in den Notizen stützt diese Prozentzahl.
Grok 4.5 wies die Behauptung zurück und begründete es. Es gab keine Baseline für den Umsatz, daher ließ sich die Steigerung nicht berechnen.

Grok 4.5 wies die falsche Prämisse zurück. Bild: Autor.
Die Prognose wurde als ungeprüft markiert, und es forderte aktuelle Marktdaten, Supportkosten und ein festes Launch-Datum an, bevor es die Pläne vergleicht. Die Antwort dauerte rund 6 Sekunden und nutzte 753 Ausgabetokens, davon 543 Reasoning-Tokens.
Optionaler Test: Ein kleines Dashboard bauen
Für den letzten Test bat ich Grok 4.5 in Cursor, die drei Pläne zu vergleichen, Plan A hervorzuheben und einen Slider hinzuzufügen, der die Empfehlung verändern kann.
Das Dashboard lief beim ersten Versuch. Das Verschieben des Sliders berechnet Plan A’s Umsatz neu und ändert die Empfehlung, sobald der angepasste Wert unter Plan C fällt. Ich musste nichts manuell korrigieren.


