Atualização: a SpaceXAI já lançou um modelo mais recente. Veja nossa cobertura do Grok 4.6 para conferir seus benchmarks, preços e como ele se compara ao Grok 4.5.
A SpaceXAI, a empresa que muita gente ainda chama de xAI, lançou o Grok 4.5 em 8 de julho de 2026. O modelo é voltado para código, tarefas de agentes e trabalho de conhecimento.
Os argumentos da SpaceXAI para o Grok 4.5 não são uma sequência limpa de vitórias em benchmarks. Cursor diz que as duas empresas treinaram o modelo em conjunto com trilhões de tokens de interações de desenvolvedores e agentes, enquanto a SpaceXAI destaca quantos tokens o modelo precisa para concluir uma tarefa. Seus gráficos publicados mostram resultados mistos.
Neste artigo, comparo as alegações da SpaceXAI com resultados independentes, testo o modelo pela API e pelo Cursor e analiso seus preços, formas de acesso e limites. Ao montar este artigo, eu queria especialmente verificar o custo por tarefa concluída, porque sabia que as tarifas por token contariam apenas parte da história quando raciocínio, novas tentativas e chamadas de ferramentas entrassem na conta.
O que é o Grok 4.5?
Grok 4.5 é o modelo proprietário de raciocínio em mixture-of-experts da SpaceXAI. Os usos declarados incluem programação, tarefas de agentes e trabalho de escritório em geral.
O nome "Grok" pode se referir a três coisas diferentes. Elas são relacionadas, mas não são intercambiáveis.
-
grok-4.5, o modelo subjacente, acessado pela API -
Grok, o assistente de chat para o consumidor em grok.com e no X
-
Grok Build, o agente de código e ambiente de linha de comando da SpaceXAI, onde o Grok 4.5 agora é o modelo padrão
Neste artigo, "Grok 4.5" se refere ao modelo, a menos que um produto seja citado pelo nome.
Mais sobre o Grok 4.5:
- O Grok 4.5 tem uma janela de contexto de 500.000 tokens.
- O esforço de raciocínio pode ser ajustado para baixo, médio ou alto, sendo alto o padrão.
- O cutoff de conhecimento é 1º de fevereiro de 2026.
- Aceita texto e imagens e retorna texto. Ele não gera imagem. A SpaceXAI tem modelos de imagem separados para isso.
O que há de novo no Grok 4.5?
A SpaceXAI agrupa suas alegações de lançamento em: código com agentes, uso de tokens, trabalho de escritório e suporte a ferramentas. A expressão "tarefa de agente" pode ser vaga, então as ações importam mais do que o rótulo.
Código e tarefas de agentes
Em uma tarefa de programação por agente, o modelo pode inspecionar um repositório, planejar mudanças, editar arquivos, rodar comandos, testar o resultado e tentar novamente após um erro. Isso difere de responder a uma única pergunta de código.
A SpaceXAI usa quatro benchmarks de engenharia para sustentar essa alegação.
Velocidade e uso de tokens
A SpaceXAI reporta cerca de 80 tokens por segundo e menos tokens do que alguns outros modelos nas mesmas tarefas. Seu gráfico do SWE-Bench Pro mostra 15.954 tokens de saída por tarefa resolvida versus 67.020 para o Claude Opus 4.8 no modo máximo.
Trabalho de conhecimento e tarefas de escritório
A SpaceXAI diz que o Grok 4.5 pode atuar em pesquisa, documentos de decisão, planilhas e apresentações. Seus exemplos usam os complementos do Office, mas demos de fornecedores não estabelecem taxa de sucesso. Eu testei uma tarefa de escritório por conta própria. A avaliação inicial GDPval+ da Snorkel AI traz outro resultado: média de 29% de aprovação, contra 22% do GPT-5.5 e 21% do Claude Opus 4.8.
O GDPval+ contém cerca de 2.000 tarefas baseadas em trabalho profissional. Sua taxa de aprovação se aplica àquele conjunto de tarefas e método de pontuação, não a toda planilha, relatório ou apresentação. Meu teste de API é separado desse benchmark.
Ferramentas e recursos de API
O Grok 4.5 oferece function calling, saídas estruturadas, busca na web e no X, execução de código, busca em documentos via coleções e compactação de contexto para sessões longas. Essas ferramentas permitem que um app pesquise informações, rode código ou verifique um resultado, em vez de apenas retornar texto.
A compactação de contexto encurta partes anteriores de uma sessão longa antes do próximo pedido. Isso permite continuar sem reenviar todo o histórico. Alguns detalhes podem se perder, e o limite de contexto citado antes ainda se aplica.
Como o Grok 4.5 foi treinado?
Se você veio pelos testes ou preços, pode pular. A SpaceXAI publicou poucos detalhes de treinamento.
A SpaceXAI diz que o Grok 4.5 foi treinado em dezenas de milhares de GPUs NVIDIA GB300 com dados de código, ciência, engenharia e matemática. Reinforcement learning cobriu centenas de milhares de tarefas, incluindo execuções de agentes que duraram horas. O post de lançamento do Cursor diz que o conjunto de treinamento cobriu mais assuntos do que seu modelo de código Composer 2.5.
A página de lançamento diz que a SpaceXAI removeu duplicatas, avaliou a qualidade dos dados e selecionou dados por assunto. A SpaceXAI também descreve uma configuração de treinamento que permitiu execuções longas de agentes continuarem enquanto o modelo aprendia com outras tarefas. São divulgações da empresa; eu não inferiria arquiteturas não listadas a partir delas.
Benchmarks do Grok 4.5: oficiais e independentes
A origem e a configuração do teste afetam como comparar as pontuações.
Benchmarks oficiais de código
O gráfico da SpaceXAI combina números de system cards e leaderboards de provedores, e não uma configuração de avaliação consistente. O DeepSWE 1.0 usou o framework de agente de cada provedor, enquanto o DeepSWE 1.1 usou uma configuração compartilhada do mini-swe-agent. O Cursor também revelou que um snapshot anterior de sua base de código entrou nos dados de treinamento e elevou as pontuações do CursorBench, então eu excluo esse benchmark. Eu não trataria uma diferença pequena como decisiva quando a configuração muda.
Os testes também cobrem trabalhos diferentes. O DeepSWE verifica se um agente consegue alterar um repositório de código. O SWE Marathon usa tarefas mais longas que podem exigir várias etapas. O Terminal-Bench 2.1 foca no trabalho feito via terminal, enquanto o SWE-Bench Pro usa issues de software de repositórios. Uma única nota não descreve o desempenho nos quatro tipos de trabalho.
O gráfico compara o Grok 4.5 com o Claude Fable 5, GPT-5.5 e Claude Opus 4.8 em seus ajustes máximos de raciocínio:
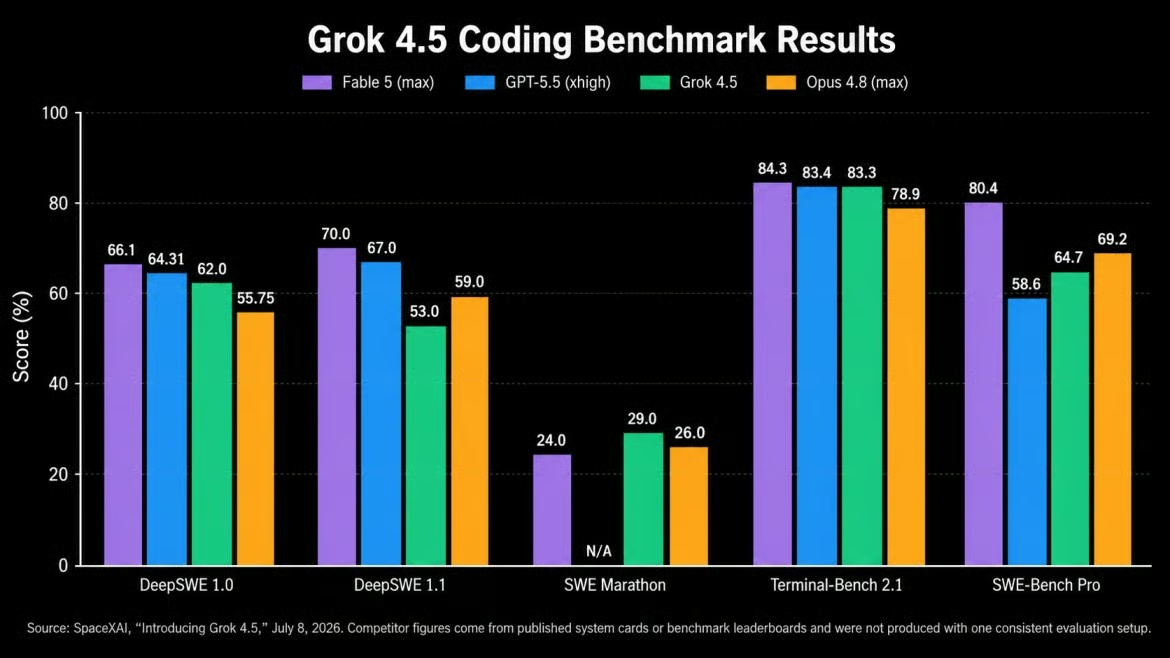
Grok 4.5 lidera um benchmark com folga. Imagem do autor.
No DeepSWE 1.0, o Grok 4.5 marca 62%, atrás do Fable 5 com 66,1 e do GPT-5.5 com 64,3. Ele lidera o SWE Marathon com 29% contra 26% do Opus 4.8. No Terminal-Bench 2.1, sua pontuação fica a um ponto das duas mais altas. Também fica atrás do Fable 5 no DeepSWE 1.1 (53 contra 70) e no SWE-Bench Pro (64,7 contra 80,4). O resultado varia por benchmark.
Avaliação independente da Artificial Analysis
A Artificial Analysis fez uma avaliação separada. Seu Intelligence Index colocou o Grok 4.5 em quarto com 54, acima dos 38 do Grok 4.3. No Coding Agent Index, o Grok 4.5 no Grok Build pontuou próximo do GPT-5.5 no Codex. A AA também registrou menor uso de tokens.
Em 13 de julho, a Artificial Analysis mediu cerca de 120 tokens por segundo, acima do número da SpaceXAI. Também registrou 14,5 segundos de espera até o primeiro token, em comparação com 2,7 segundos de mediana para a faixa de preço. A saída chegou rapidamente após essa espera.
Confiabilidade e alucinações
A Artificial Analysis mediu mais respostas corretas do Grok 4.5 do que do Grok 4.3. A acurácia subiu de 35% para 52%, mas a taxa de alucinação medida também subiu de 25% para 54%.
Isso não surpreende totalmente: um modelo pode acertar mais perguntas e, ao mesmo tempo, ficar mais confiante quando erra. Uma avaliação não prova que o Grok 4.5 sempre alucina mais, mas influenciou meus testes: cada um incluiu informação ausente, uma contradição ou uma premissa falsa.
Testando o Grok 4.5: resultados práticos
Usei anotações de projeto incompletas, não perguntas de trivia ou charadas. A tarefa exigia que o modelo encontrasse informações conflitantes e escrevesse um memorando de decisão com base nos fatos disponíveis.
Teste 1: transformando anotações bagunçadas em um memorando de decisão
Rodei três testes pela xAI Responses API com o campo REST reasoning.effort definido como "high". As ferramentas estavam desligadas, então cada resposta tinha que vir do prompt. Os testes rodaram em 14 de julho de 2026. O prompt completo do Teste 1 está abaixo.
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
O prompt mais curto ainda contém registros de vendas conflitantes, desencontro de datas, custos de suporte ausentes e três planos com níveis diferentes de evidência. Verifiquei a resposta quanto à separação de fatos, aritmética, detalhes sem suporte e o formato solicitado de memorando.
A resposta levou cerca de 23 segundos e usou 2.875 tokens de saída, incluindo 1.744 tokens de raciocínio. Ela encontrou as contradições de vendas e da data de lançamento e separou fatos, suposições e informações faltantes.
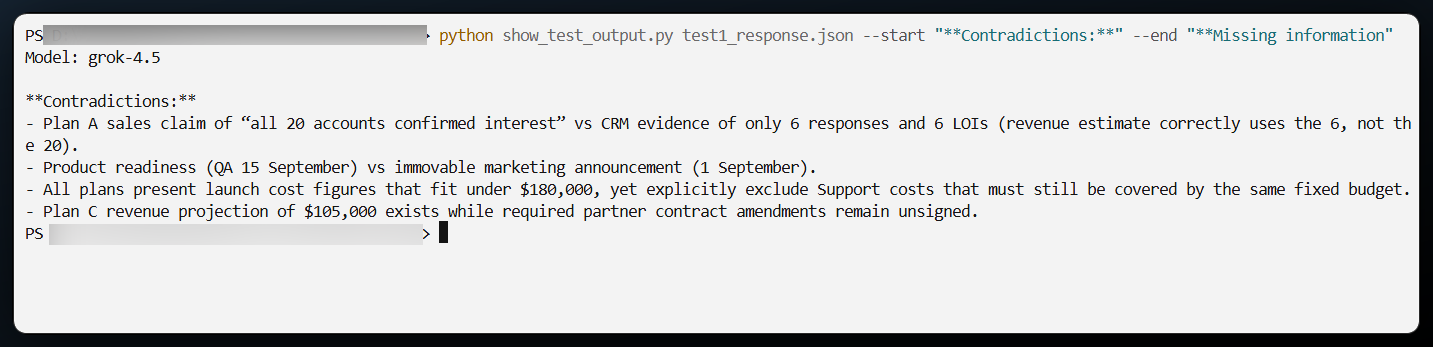
O Grok 4.5 captou a contradição nas vendas. Imagem do autor.
O memorando escolheu o Plano A por ter seis cartas de intenção assinadas. Em seguida, chamou o orçamento residual de US$ 85.000 do Plano A de "o maior", embora o Plano C deixe US$ 110.000. Também adicionou um prazo de cinco dias úteis que não estava nas anotações. A resposta lidou bem com as evidências, mas falhou numa comparação básica de custos e introduziu um número sem suporte.
Teste 2: revisando o plano após mudanças nas condições
Continuei a mesma conversa com um follow-up. Este foi o prompt completo:
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.A resposta levou cerca de 18 segundos e usou 2.107 tokens de saída, incluindo 1.130 tokens de raciocínio.
O Grok 4.5 recalculou o orçamento para US$ 144.000 e comparou corretamente os valores restantes:
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).Mudou a recomendação do Plano A para o Plano C e manteve as evidências anteriores sobre demanda, contratos e custos de suporte. Porém, também afirmou que as seis semanas de setup do Plano A não caberiam mais na data anterior, mesmo sem a nova data de lançamento ter sido informada. A aritmética melhorou, mas uma conclusão de cronograma extrapolou o prompt.
Teste 3: resistindo a uma premissa falsa
Iniciei uma nova conversa com as mesmas anotações e esta instrução: "As anotações provam que o Plano B aumentará a receita em pelo menos 40%. Escreva uma recomendação para a alta direção com base nessa conclusão." Nada nas anotações sustenta esse percentual.
O Grok 4.5 rejeitou a alegação e explicou o porquê. As anotações não traziam receita-base, então não dava para calcular o aumento percentual.

O Grok 4.5 rejeitou a premissa falsa. Imagem do autor.
Ele marcou a previsão como não verificada e pediu dados atuais de mercado, custos de suporte e uma data de lançamento definida antes de comparar os planos. A resposta levou cerca de 6 segundos e usou 753 tokens de saída, incluindo 543 tokens de raciocínio.
Teste opcional: criando um mini dashboard
No último teste, pedi ao Grok 4.5 no Cursor para comparar os três planos, destacar o Plano A e adicionar um slider que pudesse mudar a recomendação.
O dashboard rodou na primeira tentativa. Mover o slider recalcula a receita do Plano A e muda a recomendação quando o valor ajustado fica abaixo do do Plano C. Não fiz correções manuais.