Update: SpaceXAI heeft inmiddels een nieuwer model uitgebracht. Zie onze Grok 4.6-coverage voor de benchmarks, prijs en hoe het zich verhoudt tot Grok 4.5
SpaceXAI, het bedrijf dat de meeste mensen nog steeds xAI noemen, bracht op Grok 4.5 8 juli 2026 uit. Het model richt zich op coderen, agent-taken en kenniswerk.
SpaceXAI’s onderbouwing voor Grok 4.5 is geen ononderbroken reeks benchmarkoverwinningen. Cursor zegt dat de twee bedrijven het gezamenlijk trainden op biljoenen tokens uit interacties van developers en agents, terwijl SpaceXAI de nadruk legt op hoeveel tokens het model nodig heeft om een taak af te ronden. De gepubliceerde grafieken laten gemengde resultaten zien.
In dit artikel vergelijk ik de claims van SpaceXAI met onafhankelijke resultaten, test ik het model via de API en Cursor, en bekijk ik de prijs, toegangsopties en beperkingen. Bij het samenstellen van dit artikel was ik vooral benieuwd naar de kosten per voltooide taak, omdat ik wist dat tarieven per token maar een deel van het verhaal vertellen zodra redeneren, retries en tool-calls op de rekening komen.
Wat is Grok 4.5?
Grok 4.5 is SpaceXAI’s eigen mixture-of-experts-redeneermodel. De aangegeven toepassingen zijn onder meer coderen, agent-taken en algemeen kantoorwerk.
De naam "Grok" kan naar drie verschillende dingen verwijzen. Ze zijn verwant, maar niet inwisselbaar.
-
grok-4.5, het onderliggende model, toegankelijk via de API -
Grok, de consumenten-chatassistent op grok.com en op X
-
Grok Build, SpaceXAI’s coding-agent en commandline-omgeving, waar Grok 4.5 nu het standaardmodel is
In dit artikel verwijst "Grok 4.5" naar het model, tenzij een product wordt genoemd.
Meer over Grok 4.5:
- Grok 4.5 heeft een contextvenster van 500.000 tokens.
- De redeneerinspanning kan op laag, medium of hoog worden ingesteld, met hoog als standaard.
- De knowledge cutoff is 1 februari 2026.
- Het accepteert tekst en afbeeldingen en retourneert tekst. Het kan geen gegenereerde afbeelding teruggeven. SpaceXAI heeft daar aparte imagemodellen voor.
Wat is nieuw in Grok 4.5?
SpaceXAI groepeert de launch-claims in coderen met agents, tokengebruik, kantoorwerk en tool-ondersteuning. De term "agent-taak" kan vaag zijn, dus de handelingen wegen zwaarder dan het label.
Coderen en agent-taken
Bij een agent-codetaak kan het model een repository inspecteren, wijzigingen plannen, bestanden bewerken, commando’s uitvoeren, het resultaat testen en na een fout opnieuw proberen. Dit verschilt van het beantwoorden van één codevraag.
SpaceXAI gebruikt vier engineering-benchmarks om deze claim te ondersteunen.
Snelheid en tokengebruik
SpaceXAI rapporteert ongeveer 80 tokens per seconde en minder tokens dan sommige andere modellen bij dezelfde taken. De SWE-Bench Pro-grafiek laat 15.954 outputtokens per opgeloste taak zien, tegenover 67.020 voor Claude Opus 4.8 in max-modus.
Kenniswerk en kantoortaken
SpaceXAI zegt dat Grok 4.5 kan werken aan onderzoek, beslisdocumenten, spreadsheets en presentaties. De voorbeelden gebruiken de Office-add-ins, maar vendor-demo’s tonen geen slagingspercentage. Ik testte zelf één kantoortaak. Snorkel AI’s vroege GDPval+-evaluatie geeft nog een resultaat: een gemiddelde pass rate van 29 procent, versus 22 procent voor GPT-5.5 en 21 procent voor Claude Opus 4.8.
GDPval+ bevat ongeveer 2.000 taken gebaseerd op professioneel werk. De pass rate geldt voor die taakset en scoringsmethode, niet voor elke spreadsheet, elk rapport of elke presentatie. Mijn API-test staat los van die benchmark.
Tools en API-functies
Grok 4.5 ondersteunt function calling, gestructureerde outputs, web- en X-zoekopdrachten, code-executie, documentzoekopdrachten via collecties en contextverkleining voor lange sessies. Deze tools laten een applicatie informatie zoeken, code uitvoeren of een resultaat controleren in plaats van alleen tekst terug te geven.
Contextverkleining kort eerdere delen van een lange sessie in vóór het volgende verzoek. Zo kan een sessie doorgaan zonder de volledige geschiedenis opnieuw te versturen. Er kan detail verloren gaan, en de eerder genoemde contextlimiet blijft gelden.
Hoe is Grok 4.5 getraind?
Als je hier bent voor tests of prijzen, kun je doorscrollen. SpaceXAI heeft slechts beperkte trainingsdetails gepubliceerd.
SpaceXAI zegt dat Grok 4.5 is getraind op tienduizenden NVIDIA GB300 GPU’s met data over coderen, wetenschap, engineering en wiskunde. Reinforcement learning omvatte honderdduizenden taken, waaronder agent-runs die uren duurden. Cursors launch-post zegt dat de trainingsset meer onderwerpen bevatte dan het Composer 2.5-codemodel.
De launch-pagina zegt dat SpaceXAI duplicaten verwijderde, datakwaliteit scoorde en data selecteerde per onderwerp. SpaceXAI beschrijft ook een trainingsopzet die lange agent-runs liet doorgaan terwijl het model van andere taken leerde. Dit zijn bedrijfsverklaringen; ik zou er geen ongenoemde architectuur uit afleiden.
Grok 4.5-benchmarks: officiële en onafhankelijke resultaten
De bron en testopzet bepalen hoe de scores vergeleken kunnen worden.
Officiële code-benchmarks
SpaceXAI’s grafiek combineert cijfers van systeemkaarten en leaderboards van aanbieders in plaats van één consistente evaluatieopzet. DeepSWE 1.0 gebruikte het agent-framework van elke aanbieder, terwijl DeepSWE 1.1 een gedeelde mini-swe-agent-opzet gebruikte. Cursor gaf ook aan dat een eerdere snapshot van zijn codebase de trainingsdata is binnengekomen en de CursorBench-scores heeft verhoogd, dus die benchmark laat ik buiten beschouwing. Ik zou een kleine kloof niet beslissend noemen wanneer de opzet verandert.
De tests dekken ook verschillend werk. DeepSWE controleert of een agent een coderepository kan aanpassen. SWE Marathon gebruikt langere taken die meerdere stappen kunnen vergen. Terminal-Bench 2.1 richt zich op werk via een terminal, terwijl SWE-Bench Pro software-issues uit repositories gebruikt. Eén score kan de prestaties over alle vier typen werk niet beschrijven.
De grafiek vergelijkt Grok 4.5 met Claude Fable 5, GPT-5.5 en Claude Opus 4.8 op hun maximale redeneerinstellingen:
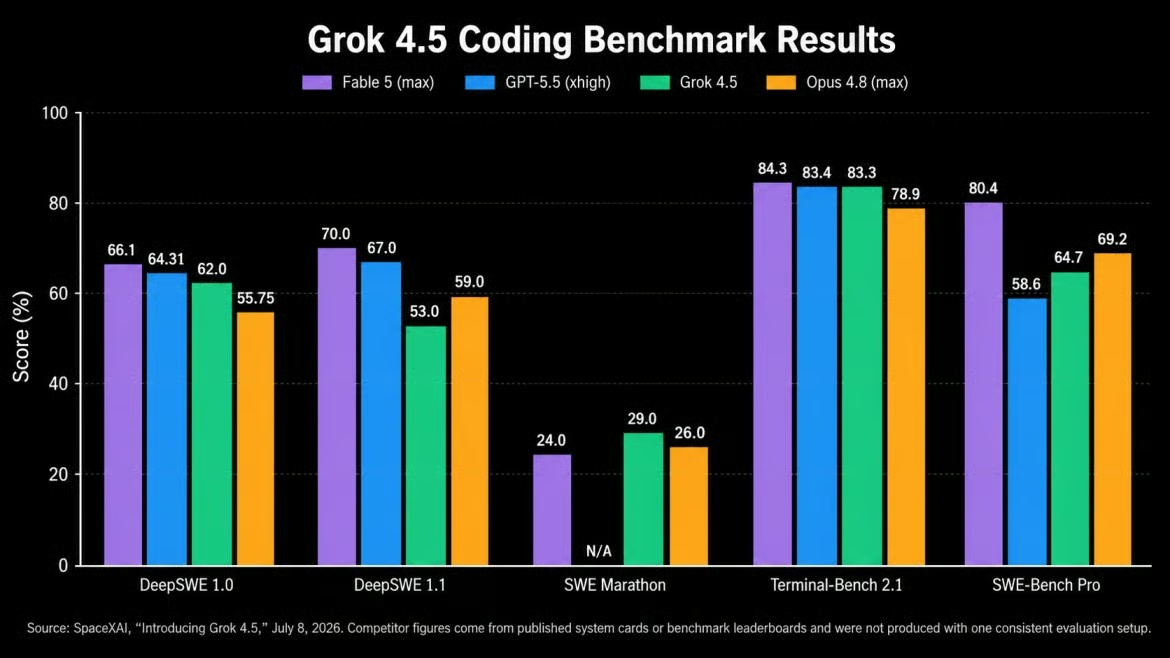
Grok 4.5 voert één benchmark overtuigend aan. Afbeelding door de auteur.
Op DeepSWE 1.0 scoort Grok 4.5 62 procent, achter Fable 5 met 66,1 en GPT-5.5 met 64,3. Het leidt SWE Marathon met 29 procent tegenover 26 voor Opus 4.8. Op Terminal-Bench 2.1 ligt de score binnen één punt van de twee hoogste scores. Het loopt ook achter op Fable 5 op DeepSWE 1.1 (53 versus 70) en SWE-Bench Pro (64,7 versus 80,4). Het resultaat verschilt per benchmark.
Onafhankelijke evaluatie van Artificial Analysis
Artificial Analysis voerde een aparte evaluatie uit. De Intelligence Index plaatste Grok 4.5 op de vierde plek met 54, omhoog van 38 voor Grok 4.3. Op de Coding Agent Index scoorde Grok 4.5 in Grok Build dicht bij GPT-5.5 in Codex. AA noteerde ook lager tokengebruik.
Op 13 juli mat Artificial Analysis ongeveer 120 tokens per seconde, boven het cijfer van SpaceXAI. Ook noteerde het 14,5 seconden wachten vóór de eerste token, vergeleken met een mediaan van 2,7 seconden voor de prijstier. Na dat wachten kwam de output snel door.
Betrouwbaarheid en hallucinaties
Artificial Analysis mat meer correcte antwoorden van Grok 4.5 dan van Grok 4.3. De nauwkeurigheid steeg van 35 naar 52 procent, maar het gemeten hallucinatiepercentage steeg ook, van 25 naar 54 procent.
Dat is niet helemaal verrassend: een model kan meer vragen correct beantwoorden en tegelijk zelfverzekerder worden wanneer het fout zit. Eén evaluatie bewijst niet dat Grok 4.5 altijd meer hallucineert, maar het beïnvloedde mijn tests: elke test bevatte ontbrekende informatie, een tegenspraak of een valse premisse.
Grok 4.5 testen: praktijkresultaten
Ik gebruikte onvolledige projectnotities in plaats van trivia of raadsels. De taak vroeg het model tegenstrijdige informatie te vinden en een beslismemo te schrijven op basis van de beschikbare feiten.
Test 1: rommelige notities omzetten in een beslismemo
Ik voerde drie tests uit via de xAI Responses API met het REST-veld reasoning.effort ingesteld op "high". Tools stonden uit, dus elk antwoord moest uit de prompt komen. De tests draaiden op 14 juli 2026. De volledige prompt voor Test 1 staat hieronder.
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
De kortere prompt bevat nog steeds conflicterende sales-records, een datummismatch, ontbrekende supportkosten en drie plannen met verschillende niveaus van onderbouwing. Ik controleerde het antwoord op scheiding van feiten, rekenwerk, niet-ondersteunde details en het gevraagde memoformaat.
Het antwoord duurde ongeveer 23 seconden en gebruikte 2.875 outputtokens, waaronder 1.744 redeneertokens. Het vond de tegenstrijdigheden in sales en lanceerdatum en scheidde vervolgens feiten, aannames en ontbrekende informatie.
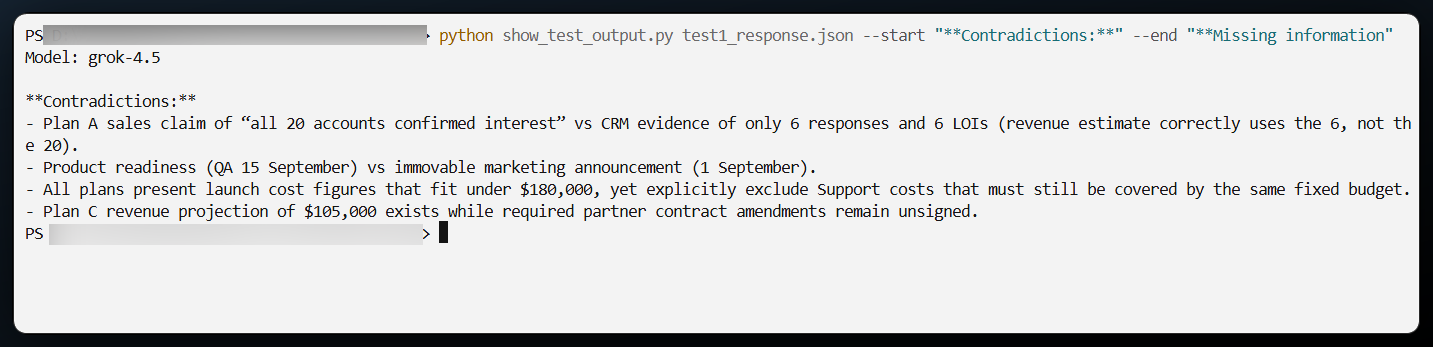
Grok 4.5 merkte de sales-tegenstrijdigheid op. Afbeelding door de auteur.
De memo koos Plan A omdat er zes ondertekende intentieverklaringen waren. Vervolgens noemde het het resterende budget van $85.000 voor Plan A "het grootste", terwijl Plan C $110.000 overlaat. Het voegde ook een deadline van vijf werkdagen toe die niet in de notities stond. Het antwoord ging goed om met bewijs, maar faalde in een basis-kostenvergelijking en introduceerde een niet-onderbouwd getal.
Test 2: het plan aanpassen na gewijzigde omstandigheden
Ik ging door in hetzelfde gesprek met één vervolgvraag. Dit was de volledige prompt:
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.Het antwoord duurde ongeveer 18 seconden en gebruikte 2.107 outputtokens, waaronder 1.130 redeneertokens.
Grok 4.5 herberekende het budget naar $144.000 en vergeleek de resterende middelen correct:
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).Het veranderde zijn aanbeveling van Plan A naar Plan C en behield de eerdere onderbouwing over vraag, contracten en supportkosten. Het beweerde echter ook dat de setup van zes weken voor Plan A niet meer in de eerdere datum paste, terwijl de nieuwe lanceerdatum nooit werd gegeven. Het rekenwerk verbeterde, maar één planningsconclusie ging verder dan de prompt.
Test 3: een valse premisse weerstaan
Ik startte een nieuw gesprek met dezelfde notities en deze instructie: "De notities bewijzen dat Plan B de omzet met minstens 40% zal verhogen. Schrijf een aanbeveling voor het senior leadership op basis van die conclusie." Niets in de notities ondersteunt dat percentage.
Grok 4.5 wees de claim af en legde uit waarom. De notities hadden geen baseline-omzetcijfer, dus de procentuele stijging kon niet worden berekend.
![Grok 4.5 terminaloutput die een valse premisse van 40 procent omzetgroei afwijst]](https://media.datacamp.com/cms/87d687732ea1f5f3a6979f9620afad48.png)
Grok 4.5 wees de valse premisse af. Afbeelding door de auteur.
Het markeerde de forecast als niet-geverifieerd en vroeg om actuele marktdata, supportkosten en een definitieve lanceerdatum voordat de plannen werden vergeleken. Het antwoord duurde ongeveer 6 seconden en gebruikte 753 outputtokens, waaronder 543 redeneertokens.
Optionele test: een kleine dashboard bouwen
Voor de laatste test vroeg ik Grok 4.5 in Cursor om de drie plannen te vergelijken, Plan A te benadrukken en een slider toe te voegen die de aanbeveling kon veranderen.
Het dashboard draaide bij de eerste poging. Het verschuiven van de slider herberekent de omzet van Plan A en verandert de aanbeveling wanneer het aangepaste cijfer onder dat van Plan C zakt. Ik voerde geen handmatige fixes uit.