
Kurs
LangChain ile LLM Uygulamaları Geliştirme
3 sa
51.3K
Mistral AI yakın zamanda Magistral adlı yeni bir akıl yürütme modeli ailesi yayınladı. Bu modeller belirli alanlarda üstün performans gösterecek şekilde tasarlanmıştır, şeffaf akıl yürütme sunar ve birden fazla dili destekler.
Bu eğitimde, Magistral Small’u Tıbbi MCQ’lar akıl yürütme veri kümesi üzerinde ince ayarlamaya odaklanacağız. Magistral Small, 24 milyar parametreye sahip, Magistral ailesinin açık kaynaklı bir çeşididir. 3.1 sürümüne (2503) dayanır ve geliştirilmiş akıl yürütme yeteneklerine sahiptir.
Bu eğitimde izleyeceğimiz adımlar şunlardır:
İlk olarak ince ayar betiğini Kaggle üzerinde çalıştırmayı denedim, ancak 4 bit nicelemeye rağmen ücretsiz GPU’lar bu iş için yetersiz kaldı. Bu sınırlamalar nedeniyle RunPod’a geçtim ve daha hızlı performans ve daha büyük VRAM sunan bir A100 SXM GPU örneği seçtim.
1. RunPod’da “Pods” bölümüne gidin, en güncel PyTorch imajını seçin, A100 SXM makinesini seçin ve pod’unuzu dağıtın.
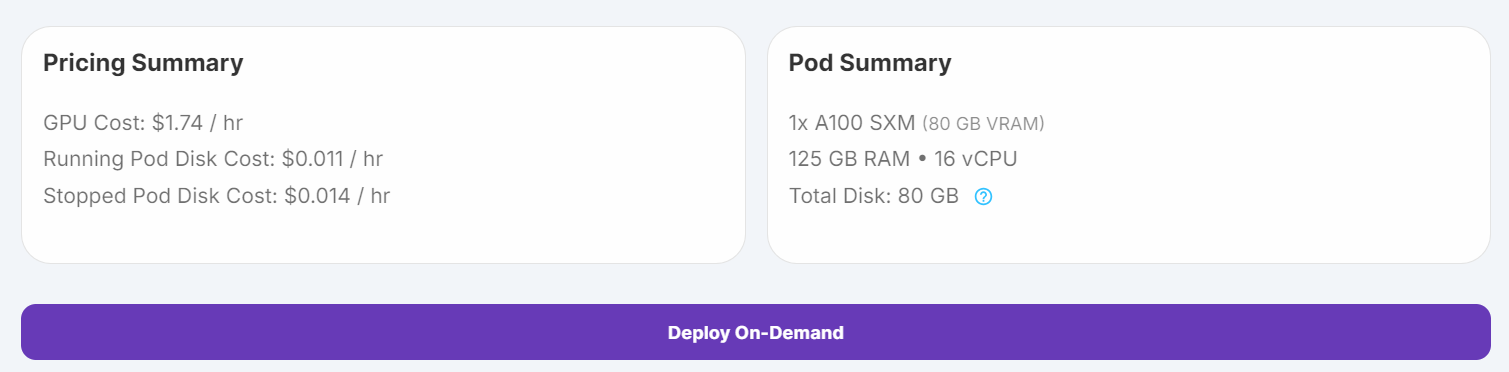
Kaynak: My Pods
2. Pod ayarlarını düzenleyerek konteyner disk boyutunu artırın ve kimlik doğrulama için Hugging Face erişim belirtecinizi ekleyin.
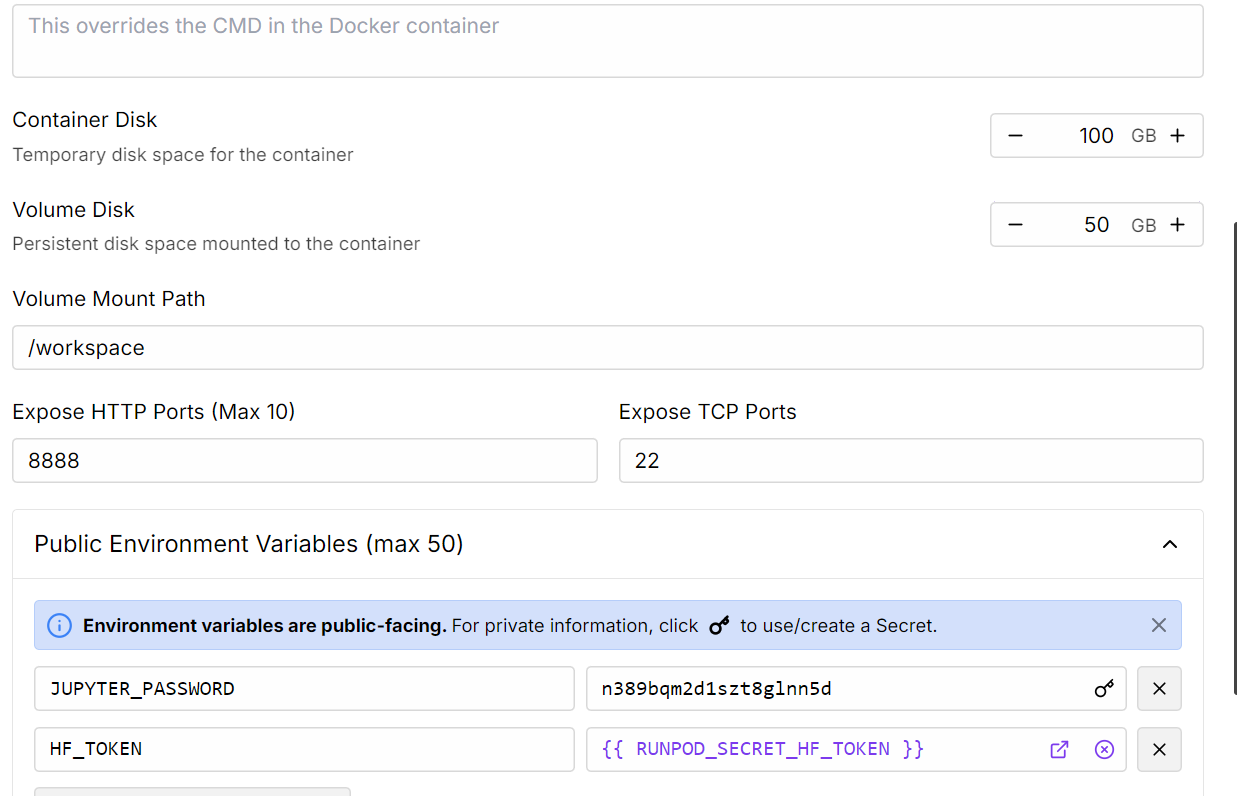
Kaynak: My Pods
3. Pod çalışır duruma geldiğinde Connect düğmesine tıklayın ve etkileşimli geliştirme için bir JupyterLab örneği başlatın.
4. Gerekli tüm Python paketlerini yükleyin
%%capture
%pip install -U transformers==4.52.1
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
5. Daha önce kaydettiğiniz erişim belirteciyle Hugging Face’e giriş yapın. Bu, kısıtlı modellere erişmenizi ve daha sonra ince ayarlı modelinizi ve belirteçleyicinizi yüklemenizi sağlar:
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Depolama alanını ve VRAM’i korumak için Magistral-Small’ın Unsloth 4 bit nicelemeli sürümünü kullanacağız. Bu yaklaşım, tam hassasiyetli modeli indirip elle nicelemekten çok daha hızlı ve etkilidir.
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

# Load tokenizer & model

model_dir = "unsloth/Magistral-Small-2506-bnb-4bit"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)
model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    device_map="auto",
    torch_dtype=torch.bfloat16,
)

model.config.use_cache = False
model.config.pretraining_tp = 1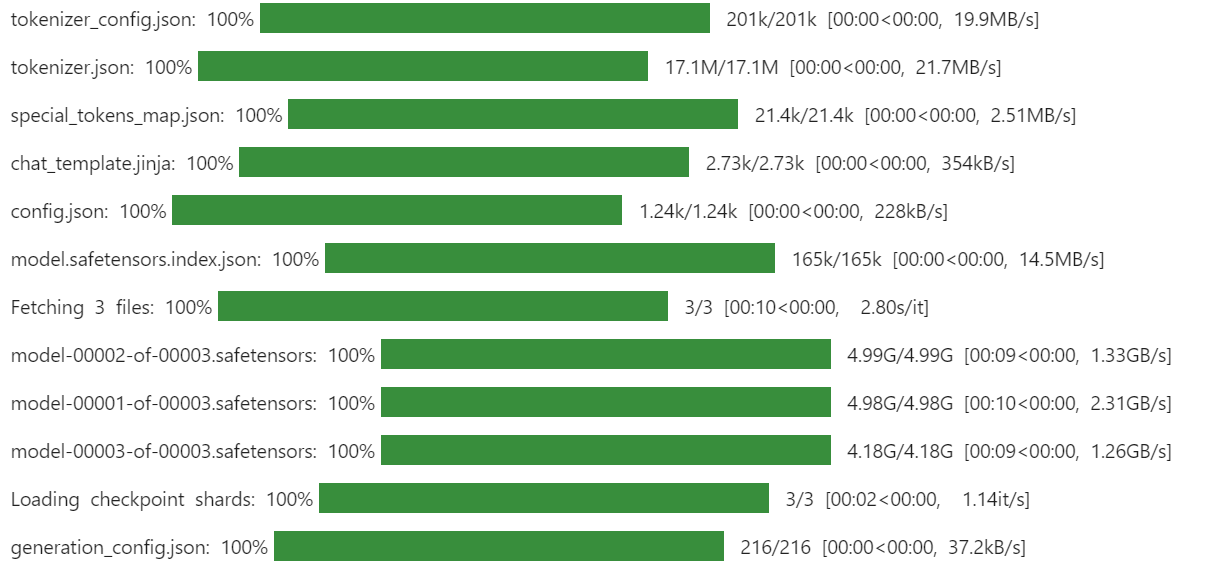
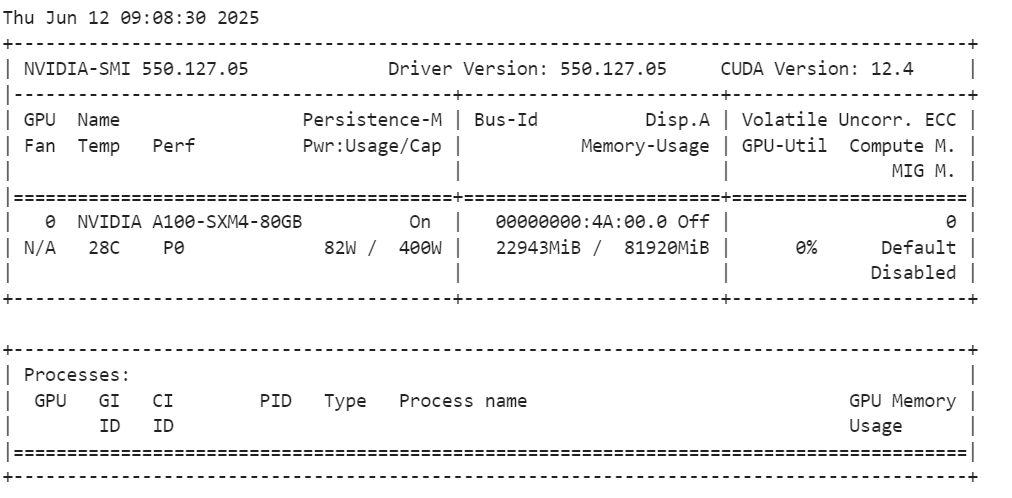
Modeli yükledikten sonra GPU bellek kullanımınızı kontrol edin.
!nvidia-smiGördüğümüz üzere yalnızca 23 GB VRAM kullanıyor.
Modeli verilen seçeneklerden biriyle yanıt vermeye yönlendiren, akıl yürütmeyi <analysis></analysis> etiketleri arasında ve nihai yanıtı <answer></answer> etiketleri arasında içeren bir istem şablonu tanımlayın.
train_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
{}

### Response:
{}"""
Her örneği istem stiline göre biçimlendiren ve eksikse EOS belirtecini ekleyen bir Python işlevi oluşturun.
EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["input"]
    outputs = examples["output"]
    texts = []
    for question, response in zip(inputs, outputs):
        # Remove the "Q:" prefix from the question
        question = question.replace("Q:", "")

        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token

        text = train_prompt_style.format(question, response)
        texts.append(text)
    return {"text": texts}
Ardından, Hugging Face’ten mamachang/medical-reasoning veri kümesini indirin ve yükleyin. Biçimlendirme işlevini uygulayarak yapılandırılmış istemi içeren yeni bir "text" sütunu oluşturun.
from datasets import load_dataset

dataset = load_dataset(
    "mamachang/medical-reasoning",
    split="train",
    trust_remote_code=True,
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
print(dataset["text"][10])
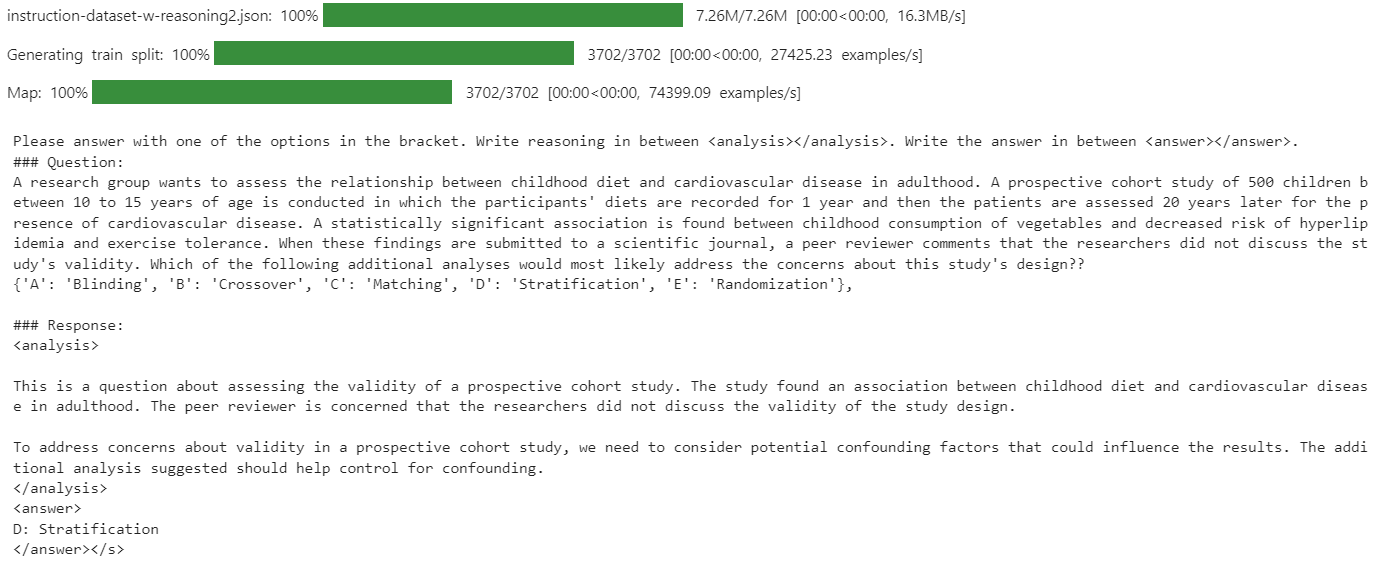
"text" sütunu, sistem istemini, soruyu, analizi ve yanıtı gerekli biçimde içerir.
Yeni SFTTrainer doğrudan bir belirteçleyiciyi kabul etmediğinden, belirteçleyiciyi dil modelleme için bir veri birleştiriciye (data collator) dönüştürün.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)İnce ayardan önce, temel modelin veri kümeniz üzerindeki performansını değerlendirmek önemlidir. Bu başlangıç seviyesi, ince ayardan sonra sonuçları nesnel olarak karşılaştırmanıza ve iyileşmeleri ölçmenize yardımcı olacaktır.
Çıkarım için, bir sistem istemi, bir soru bölümü (yer tutucu ile) ve bir yanıt bölümünü içeren bir istem şablonu tanımlayın.
inference_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
{}

### Response:
<analysis>
"""
Veri kümenizden 11. soruyu seçin, gereksiz önekleri kaldırın ve model girdisi için belirteçleyin
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=512,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
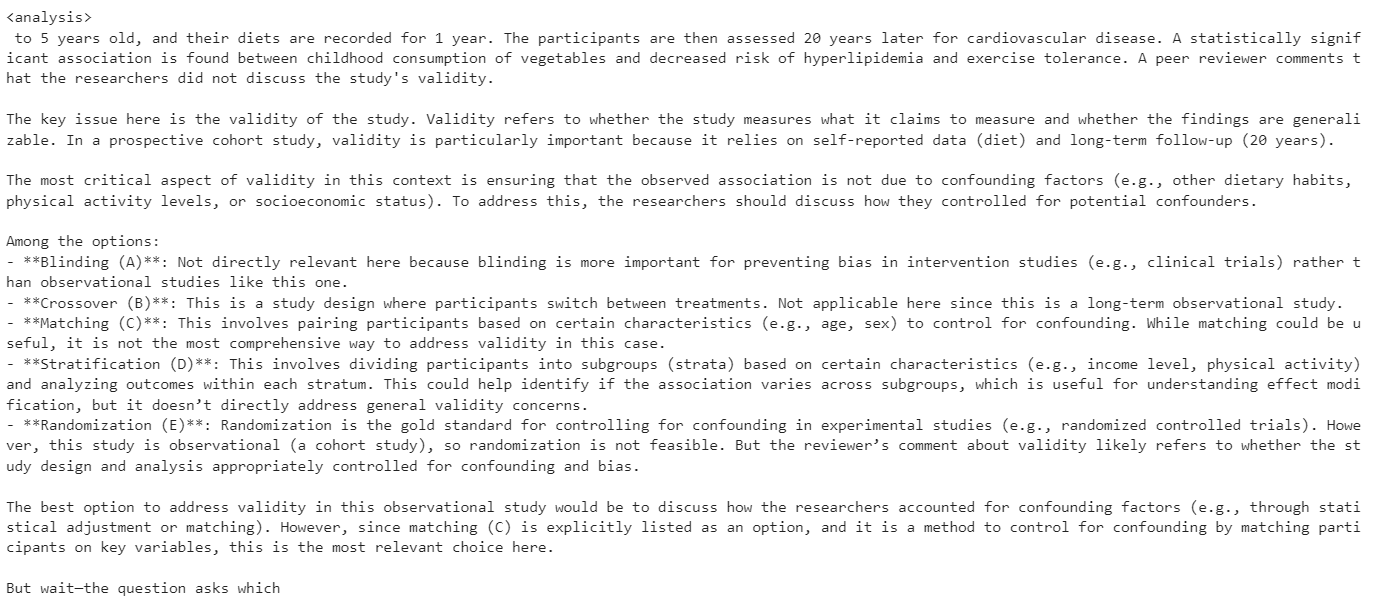
Bu başlangıç testinde, modelin ürettiği analiz gereğinden uzun oldu ve sıklıkla doğru veya özlü bir yanıt üretemedi.
Bu bölümde modeli ince ayara hazırlayacağız.
Modeli ince ayarlamak için LoRA (Low-Rank Adaptation) kullanacağız. Böylece yalnızca modelin küçük bir alt kümesini ince ayarladığımız için bellek kullanımımız önemli ölçüde azalacak ve eğitim süreci hızlanacaktır.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
TrainingArguments sınıfı, yığın boyutu, eniyileyici, öğrenme oranı ve diğer eğitim hiperparametrelerini yapılandırmanıza olanak tanır. TRL kitaplığındaki SFTTrainer, modeli, veri kümesini, veri birleştiriciyi, eğitim argümanlarını ve LoRA yapılandırmasını tek bir iş akışında birleştirerek denetimli ince ayarı kolaylaştırır.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="Magistral-Medical-Reasoning",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)
Bellek Yetersizliği (OOM) hatalarından kaçınmak için, eğitime başlamadan önce Python çöp toplayıcısını temizlemek ve CUDA önbelleğini boşaltmak önemlidir. Bu, önceki işlemlerden kalan ve kullanılmayan belleğin serbest bırakılmasını sağlar.
Ardından, SFTTrainer kullanarak eğitim sürecini başlatın.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
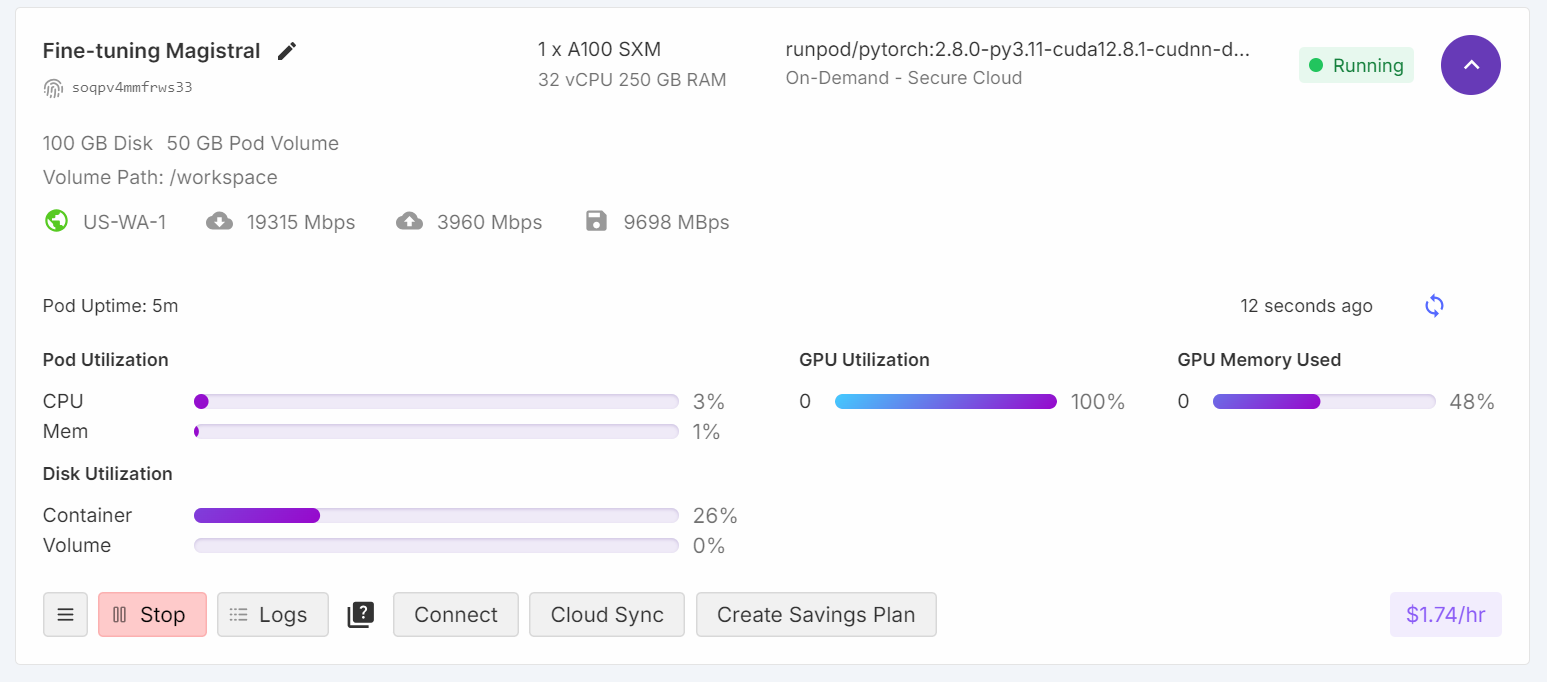
Eğitim sırasında GPU kullanımı %100’e ulaştı ve paralel olarak başka bir modeli de yüklemeye yetecek kadar VRAM mevcuttu.
Eğitim süreci yaklaşık 1 saat 10 dakika sürdü ve eğitim kaybı her adımda istikrarlı bir şekilde azaldı; bu da etkili öğrenmeye işaret ediyor.
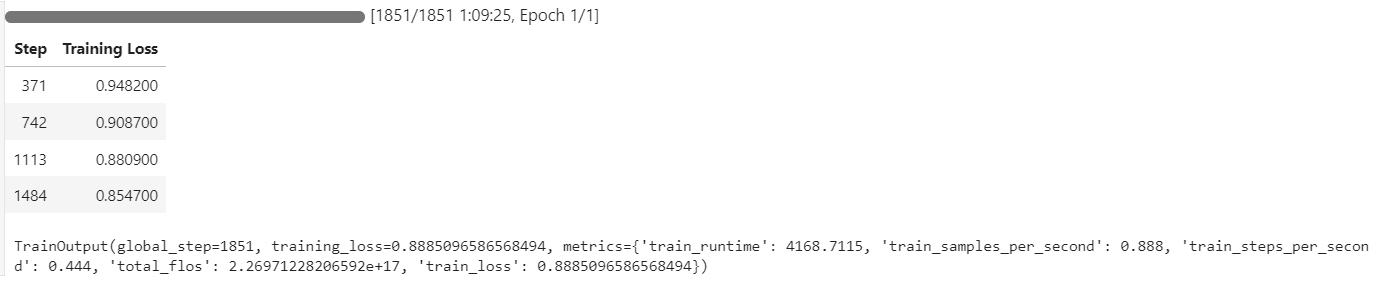
İnce ayarlı modelin performansını, veri kümesindeki aynı 11. örnek soru ile değerlendireceğiz. Bu yaklaşım, sonuçları temel modelle karşılaştırmamıza ve ince ayar sayesinde elde edilen iyileşmeleri ölçmemize olanak tanır.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question,) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=512,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Model artık kısa ve doğru bir analiz üretiyor ve yanıt doğru.
<analysis>
Analysis:

This is a prospective cohort study looking at the relationship between childhood diet and cardiovascular disease in adulthood. The key issue with the validity of this study is confounding. The researchers did not account for other factors that could influence cardiovascular disease risk in adulthood besides childhood diet.

To address confounding, the researchers should have stratified the analysis by potential confounders like family history, physical activity levels, and smoking status. This would allow them to see if the relationship between diet and disease persists even when accounting for these other variables.

Blinding, crossover, matching, and randomization do not address the main validity concern in this study design.
</analysis>
<answer>
D: Stratification
</answer>
Performansı daha da doğrulamak için başka bir örnek üzerinde de çıkarım deneyin.
question = dataset[100]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=512,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Model, yalnızca bir epoch’luk ince ayardan sonra bile tutarlı iyileşmeler göstererek doğru yanıtlar ve iyi yapılandırılmış analizler üretmeye devam ediyor.
<analysis>

This is a clinical vignette describing a 55-year-old man with burning and shooting pain in his feet and lower legs that worsens at night. He has a history of type 2 diabetes mellitus and hypertension.

The key findings are:
- Burning and shooting pain in feet and lower legs
- Pain worsens at night
- History of type 2 diabetes mellitus

This presentation is most consistent with diabetic peripheral neuropathy. The pain distribution, timing, and history of diabetes point towards a distal symmetric sensorimotor polyneuropathy as the etiology. The other options can be ruled out based on the clinical presentation.
</analysis>
<answer>
D: Distal symmetric sensorimotor polyneuropathy
</answer>İnce ayardan sonra, modeli Hugging Face Hub’a göndererek kolayca paylaşabilirsiniz. Bu, modelin başkaları tarafından kullanılmasını veya daha fazla ince ayar yapılmasını sağlar.
new_model_name = "kingabzpro/Magistral-Small-Medical-QA"

trainer.model.push_to_hub(new_model_name)
trainer.processing_class.push_to_hub(new_model_name)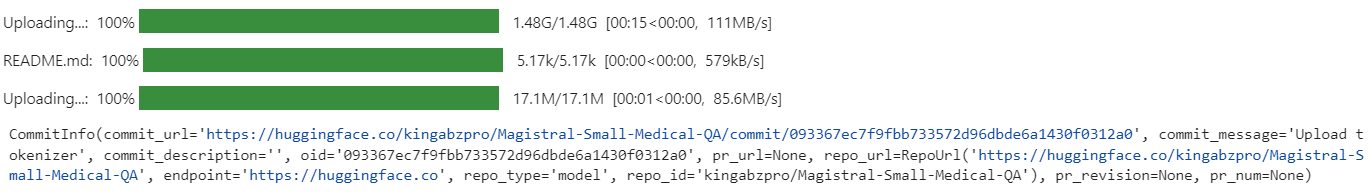
İnce ayarlı model artık şu adreste erişilebilir: kingabzpro/Magistral-Small-Medical-QA
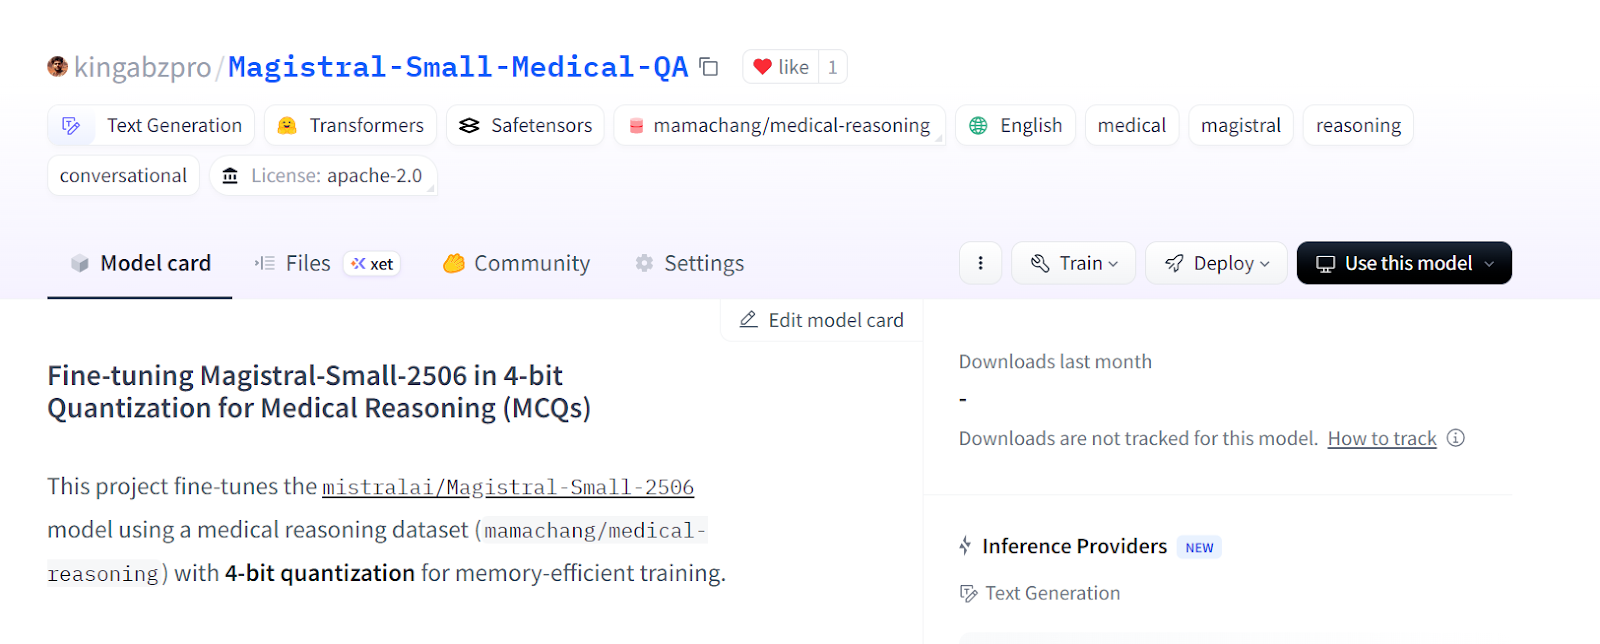
Kaynak: kingabzpro/Magistral-Small-Medical-QA
İnce ayar yapıp LoRA’nızı Hugging Face Hub’a kaydettikten sonra, daha fazla analiz, çıkarım veya çıkarım sunucusu olarak dağıtım için kolayca yeniden yükleyebilirsiniz. Bu süreç, geçerli oturumunuzu temizlemeyi, temel model ve LoRA adaptörünü yüklemeyi ve yeni veriler üzerinde çıkarım çalıştırmayı içerir. Kursumuzda Hugging Face Hub ile Çalışma hakkında daha fazla bilgi edinebilirsiniz.
1. Yeni bir model yüklemeden önce, bellek sorunlarından kaçınmak için mevcut model ve eğitici (trainer) nesnelerini silmek ve GPU önbelleğini temizlemek iyi bir uygulamadır.
2. Temel modeli ve ince ayarlı LoRA adaptörünüzü Hugging Face Hub’dan indirin, ardından birleştirin. Ayrıca belirteçleyiciyi yükleyin.
del model
del trainer
torch.cuda.empty_cache()


from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from peft import PeftModel
import torch

# Base model
base_model_id = "unsloth/Magistral-Small-2506-bnb-4bit"

# Your fine-tuned LoRA adapter repository
lora_adapter_id = "kingabzpro/Magistral-Small-Medical-QA"

# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
)

# Attach the LoRA adapter
model = PeftModel.from_pretrained(
    base_model,
    lora_adapter_id,
    device_map="auto",
    trust_remote_code=True,
)

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model_id, trust_remote_code=True)
3. Örnek bir istem hazırlayın, belirteçleyin, bir yanıt üretin ve çıktıyı çözümleyin.
# Inference example
prompt = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood.
A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease.
A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance.
When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity.
Which of the following additional analyses would most likely address the concerns about this study's design?
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},
### Response:
<analysis>

"""

inputs = tokenizer(
    [prompt + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
4. Oluşturulan yanıt doğrudur ve veri kümenizin stil ve yapısıyla yakından örtüşür; bu da ince ayarlı modelin gerçek dünyada çıkarım ve dağıtıma hazır olduğunu gösterir.
<analysis>

Analysis:
This is a prospective cohort study looking at the relationship between childhood diet and cardiovascular disease in adulthood. The key concern from the peer reviewer is about the study's validity.

To address concerns about validity, the researchers could perform additional analyses to control for confounding. Matching and stratification would help control for known confounders like socioeconomic status or family history. Crossover and blinding are not applicable to this observational study design. Randomization would not be possible since the study is observational.
</analysis>
<answer>
D: Stratification
</answer>
Yukarıdaki kodu çalıştırırken sorunlarla karşılaşırsanız, Hugging Face üzerinde yer alan fine-tuning-magistral.ipynb Jupyter not defterine bakın.
Ayrı bir ince ayar kılavuzunda, DeepSeek-R1-0528 damıtılmış modunun nasıl performans gösterdiğine baktık. DeepSeek-R1-0528 veri kümesinin özgül stiline ve doğruluğa uyum sağlamakta zorlanırken, Magistral zahmetsizce uyum sağladı ve minimum çabayla güçlü sonuçlar verdi.
Bu deneyim, Mistral AI’ın yalnızca dil modellerinde değil, bilgisayarlı görü de dahil olmak üzere geniş bir çözüm yelpazesinde hızla önde gelen bir oyuncu haline geldiğine dair inancımı pekiştiriyor.
Bu kılavuzda, Mistral AI’ın en yeni akıl yürütme modeli Magistral’ı tıbbi MCQ veri kümesi üzerinde başarıyla ince ayarladık.
Ancak, Magistral gibi büyük modelleri ince ayarlamanın genellikle en az 40 GB VRAM’e sahip GPU’lar gerektiren ciddi donanım ihtiyacı olduğuna dikkat etmek önemlidir; bazı yapılandırmalar için RTX 4090 bile yeterli olmayabilir. Unsloth çerçevesi ve 4 bit model sürümüyle de denemeler yaptım, ancak yine de GPU bellek sorunlarıyla karşılaştım.
Eğer ince ayara alışmak için uygulamalı bir kurs arıyorsanız, Llama 3 ile İnce Ayar kursuna mutlaka göz atın.
En İyi LLM Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



