Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
10.7K
Le même jour que le lancement de GLM-5.3 Flash, l’équipe Qwen d’Alibaba a ouvert les poids de Qwen3.8-Flash-Next, un modèle multimodal à mélange d’experts (MoE) qui fait office d’aperçu anticipé de l’architecture de la future famille Qwen4.
Cela reprend la démarche de Qwen3-Next pour Qwen3.5 : publier les changements d’architecture avant la gamme complète afin que la communauté puisse les analyser en premier.
Le sujet clé ici, c’est le coût. Grâce à une nouvelle architecture très efficace, Qwen3.8-Flash-Next coûte environ un neuvième du budget de son prédécesseur, Qwen3.7-Plus, pour l’entraînement. Et sans sacrifier la performance : il devance même des poids lourds comme Claude Opus 4.6 Max sur des tests majeurs de code comme SWE-bench.
Dans cet article, nous passons en revue tout ce qui change avec Qwen3.8-Flash-Next : architecture, fonctionnalités et benchmarks. Pour un guide détaillé sur le téléchargement et l’exécution locale du modèle, consultez notre tutoriel Qwen3.8-Flash-Next. Pour situer ce modèle parmi d’autres modèles chinois, lisez notre guide sur Qwen3.8-Max et notre tutoriel pour exécuter DeepSeek-V4-Flash-0731 en local. Nous vous recommandons aussi de découvrir la nouvelle version Qwen3.8-Omni-Flash.
Qwen3.8-Flash-Next est un modèle MoE multimodal de l’équipe Qwen d’Alibaba, publié le 26 août 2026, positionné comme un cheval de bataille économique plutôt qu’un vaisseau amiral haut de gamme.
Il se situe en dessous des modèles de classe Max en intelligence mais écrase presque tout le monde sur le prix, ce qui est l’ADN de la ligne « Flash ».
Le modèle prend en charge nativement une fenêtre de contexte de 262 144 jetons, extensible à 1 000 000 de jetons avec YaRN (méthode [Yet another RoPE extensioN], une technique d’encodage positionnel qui étire la fenêtre de contexte d’un modèle, lui permettant d’ingérer de très longs textes tout en conservant sa performance d’origine).
Il gère texte, image et vidéo via une API unique, l’une des raisons pour lesquelles il a été qualifié de « coup de cœur de la communauté du jour au lendemain » dans les récapitulatifs d’août 2026.
Ce qui compte pour les praticiens, c’est le rapport benchmark/par dollar.
Qwen3.8-Flash-Next dépasse son homologue 27B sur tous les benchmarks publiés et surpasse Claude Opus 4.6 Max sur la plupart des évaluations pratiques de code et d’agents, tout en n’activant que 6B de paramètres par jeton. Comme il préfigure l’architecture Qwen4, ses choix de conception indiquent clairement la direction prise par Alibaba.
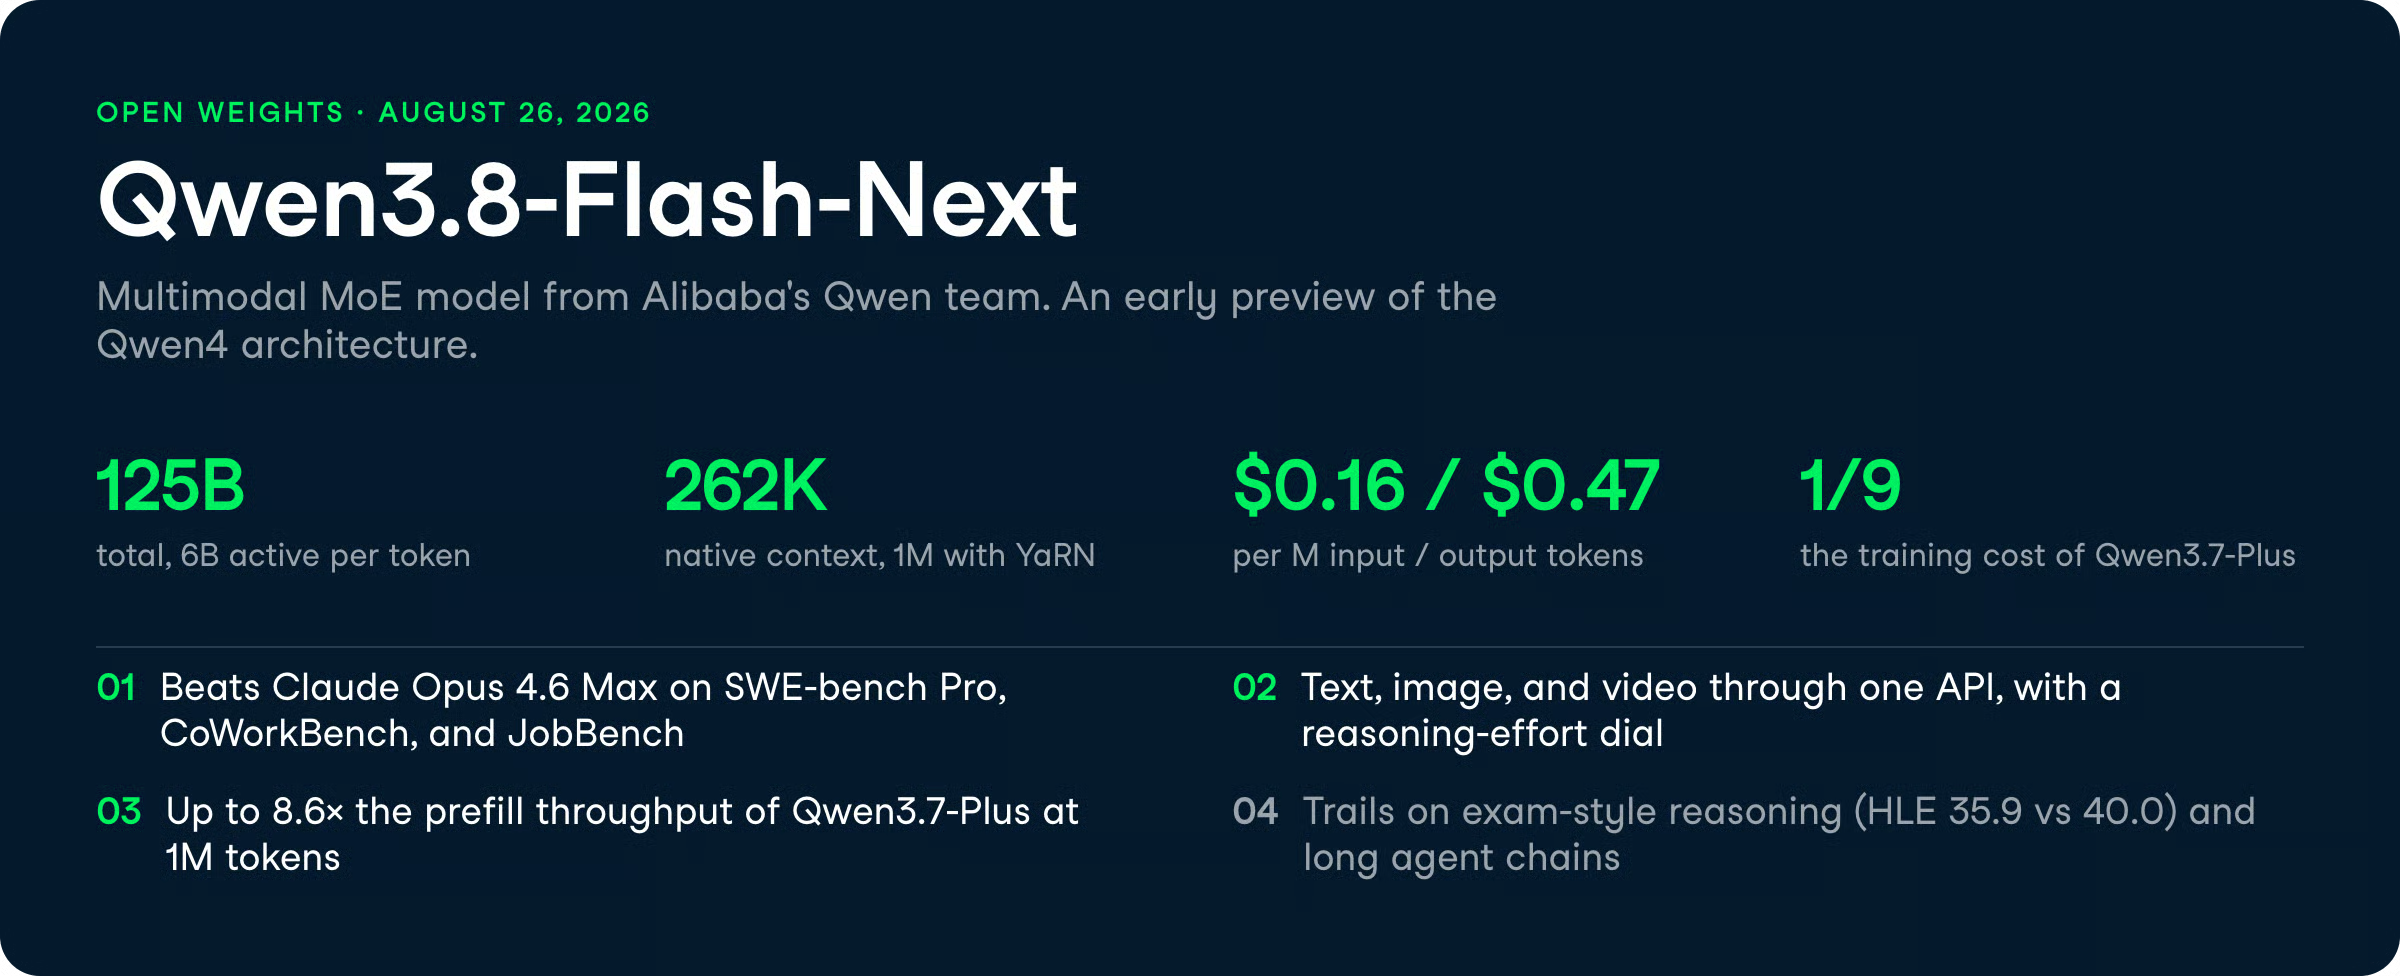
Qwen3.8-Flash-Next améliore le modèle sur quatre axes : attention, résiduel, embedding et optimisation.
Ci-dessous, nous décryptons ce que chaque changement vous apporte concrètement, au-delà de la théorie.
Le gain pratique majeur concerne la vitesse sur les entrées longues.
Qwen3.8-Flash-Next adopte une conception d’attention hybride : il compresse la majeure partie de l’historique de contexte pour économiser l’espace, puis utilise un mécanisme ciblé de « Sparse Attention » pour retrouver à la demande les détails les plus pertinents.
Les accélérations à 1 million de jetons sont massives : jusqu’à 7,6× plus rapide en traitement d’invite (prefill) et 4,9× plus rapide en génération (decode). Dans une configuration serveur typique avec préfixes en cache, le débit global grimpe de 8,6× par rapport à Qwen3.7-Plus.
Pour ceux qui opèrent du retrieval à gros volume ou des agents de code à l’échelle d’un dépôt, cette différence de débit fait toute la différence.
Vous payez pour du calcul, et cette conception fait chuter la facture précisément sur les longues séquences autrefois coûteuses.
Qwen utilise une astuce élégante appelée N-gram Embedding pour ajouter 51 milliards de paramètres quasiment gratuitement. Au lieu d’examiner un seul jeton, le modèle regarde le jeton courant et ses voisins récents, ce qui lui offre une vaste « mémoire de motifs locaux ».
Comme le modèle sait à l’avance quoi consulter, ces 51B paramètres supplémentaires résident en mémoire système (RAM), pas sur le GPU. Ils sont sollicités automatiquement en arrière-plan : ils n’occupent donc pas durablement la VRAM et n’alourdissent pas le calcul par jeton.
Vous obtenez l’intelligence d’un modèle bien plus grand sans payer la « taxe VRAM » habituelle.
Qwen3.8-Flash-Next traite texte, image et vidéo via une seule interface, et ses capacités en vision surpassent largement sa gamme de prix.
Il bat nettement Claude Opus 4.6 Max sur les usages mobiles (84,5 vs 62,0 sur AndroidWorld) et la compréhension visuelle en conditions réelles (88,5 vs 73,9 sur RealWorldQA).
Il excelle aussi en mathématiques visuelles, avec jusqu’à 95,7 sur MathVision (loin devant les 65,5 d’Opus).
Si votre flux de travail implique l’analyse de captures d’écran, de graphiques ou d’IU d’applications, Qwen offre un réel avantage sur Claude à ce niveau de prix.
L’API propose un réglage reasoning effort avec trois niveaux (élevé, moyen, faible) pour arbitrer entre profondeur de raisonnement, latence et coût.
Le modèle intègre aussi un module de prédiction multi-jetons, qui anticipe plusieurs étapes pour accélérer la génération en charge réelle.
La conséquence pratique, c’est le contrôle.
Vous réduisez l’effort pour des trafics volumineux et sensibles au coût, et vous l’augmentez pour des tâches d’agents complexes, le tout avec le même identifiant de modèle.
Sur l’ensemble des chiffres publiés, Qwen3.8-Flash-Next mène sur la plupart des benchmarks de code et d’agents, tout en restant derrière sur quelques évaluations de type examen.
Il surpasse partout son homologue 27B, avec les plus grands écarts sur le travail agentique.
Toutes les comparaisons ci-dessous proviennent du tableau de publication de Qwen, sauf mention contraire.
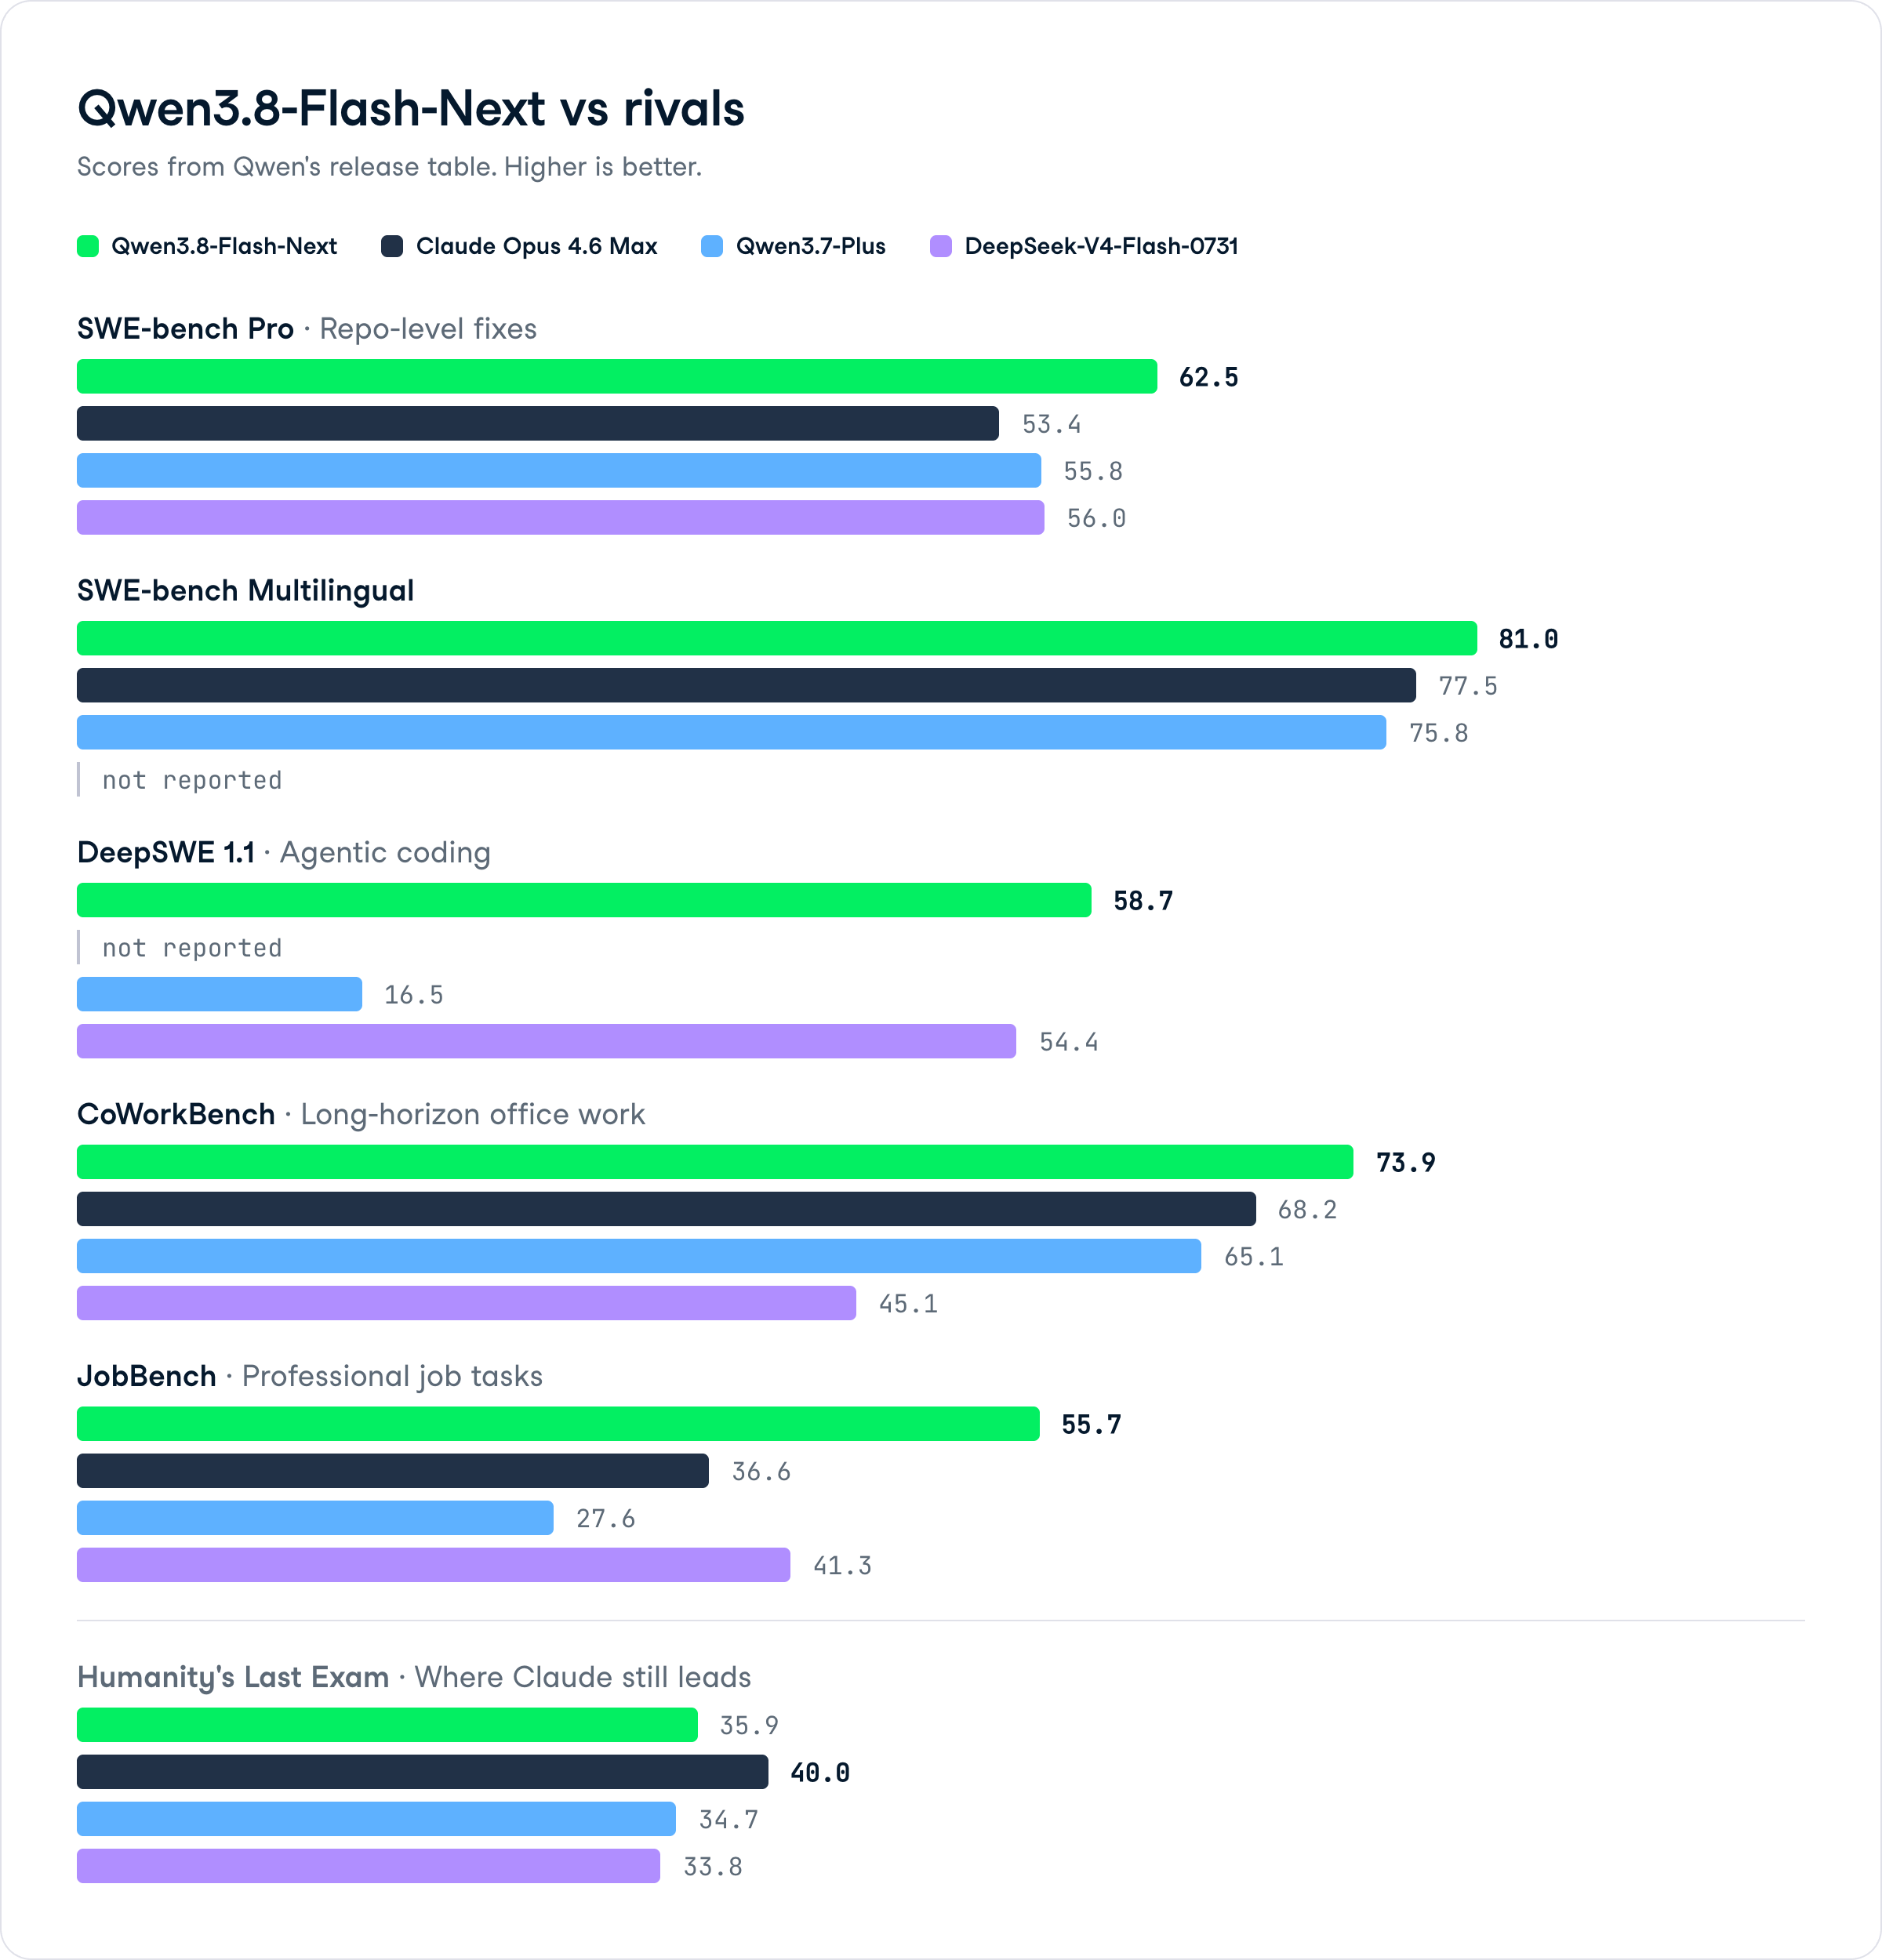
SWE-bench Pro mesure de vraies corrections logicielles au niveau dépôt. Qwen3.8-Flash-Next y obtient 62,5, devant les 53,4 de Claude Opus 4.6 Max et les 55,8 de Qwen3.7-Plus.
Sur SWE-bench Multilingual, qui évalue des correctifs dans plusieurs langues, il atteint 81,0 contre 77,5 pour Opus 4.6 Max.
Ce sont les chiffres qui portent la sortie.
Qu’un modèle avec 6B d’actifs batte un Claude de classe Max au niveau dépôt explique l’attention qu’il a suscitée.
DeepSWE 1.1 évalue le codage agentique via des harnais comme Claude Code et mini-SWE-agent. Qwen3.8-Flash-Next y score 58,7, contre 42,2 pour son homologue 27B et 16,5 pour Qwen3.7-Plus.
DeepSeek-V4-Flash-0731 est à 54,4 sur ce test.
Lorsque nous avons exécuté DeepSeek-V4-Flash-0731 en agent de code dans notre tutoriel, il a construit un site d’analytics boursiers complet à partir d’une seule invite en environ 20 minutes, générant à environ 33 jetons/seconde.
L’écart DeepSWE entre les deux modèles suggère que Qwen3.8-Flash-Next devrait bien tenir dans des boucles similaires de codage agentique.
Côté agents, le modèle affiche de solides performances sur plusieurs évaluations :
L’écart sur JobBench est particulièrement marquant.
Sur des tâches de workflow professionnel, Qwen3.8-Flash-Next devance de près de 20 points un Claude de classe Max, un résultat qui mérite un pilote pour l’automatisation en entreprise.
En raisonnement général, Qwen3.8-Flash-Next atteint 91,7 sur GPQA Diamond (raisonnement scientifique), juste devant les 91,3 de Claude Opus 4.6 Max, et 91,9 sur LiveCodeBench v6 (codage compétitif) contre 88,8 pour Opus 4.6 Max.
Il ne gagne pas partout.
Sur Humanity’s Last Exam (HLE), test de raisonnement pluridisciplinaire, il obtient 35,9 contre 40,0 pour Claude Opus 4.6 Max. Sur Agents’ Last Exam Pass@1, DeepSeek-V4-Flash-0731 le devance 25,2 à 24,3.
Le constat se retrouve sur les suivis indépendants : Qwen3.8-Flash-Next mène sur le code pratique et le travail agentique, tandis que Claude garde l’avantage sur certains examens de raisonnement.
Qwen3.8-Flash-Next-Base remporte 8 benchmarks de pré-entraînement sur 14 face aux modèles de base Qwen3.8-27B et au bien plus grand Qwen3.7-Plus.
Il mène sur MMLU-Pro (73,23), SuperGPQA (51,36), BBH (90,87), GSM8K (93,29), EvalPlus (78,76), SWEBench-Pretrain (50,99), MGSM (89,33) et MMMLU (84,86).
Fait marquant : il y parvient avec 6B de paramètres activés, contre 17B actifs et 397B au total pour Qwen3.7-Plus, tout en restant à moins d’un point sur MMLU, MMLU-Redux, GPQA, MATH et MultiPL-E.
Les 51B de paramètres N-gram embedding sont adressés de façon déterministe et n’entrent jamais dans le budget matmul par jeton : c’est donc une efficacité réelle, pas un artifice de comptage.
Voici comment le modèle se compare à Claude Opus 4.6 Max, à son prédécesseur Qwen3.7-Plus, et à DeepSeek-V4-Flash-0731 sur les évaluations phares.
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62,5 | 53,4 | 55,8 | 56,0 |
| SWE-bench Multilingual | 81,0 | 77,5 | 75,8 | -- |
| DeepSWE 1.1 | 58,7 | -- | 16,5 | 54,4 |
| CoWorkBench | 73,9 | 68,2 | 65,1 | 45,1 |
| JobBench | 55,7 | 36,6 | 27,6 | 41,3 |
| GPQA Diamond | 91,7 | 91,3 | 90,3 | 90,8 |
| LiveCodeBench v6 | 91,9 | 88,8 | 89,6 | 90,6 |
| HLE | 35,9 | 40,0 | 34,7 | 33,8 |
Les poids de Qwen3.8-Flash-Next sont disponibles dès maintenant en modèle à poids ouverts sur Hugging Face et ModelScope.
La version production, avec contexte 1M par défaut et outils intégrés, est servie comme Qwen3.8-Flash sur QwenCloud sous l’ID de modèle qwen3.8-flash.
Le prix est son argument le plus fort :
À titre de comparaison, notre fiche Qwen3.8-Max indique 2,00 $ en entrée et 6,00 $ en sortie par million de jetons ; Flash-Next est donc plus de 10× moins cher que son propre grand frère sur l’entrée.
QwenCloud prend en charge les APIs Chat Completions et Responses compatibles OpenAI, ainsi qu’une interface compatible Anthropic : l’intégration dans Claude Code, Codex et Qwen Code ne demande que des ajustements minimes.
Notez qu’au moment de l’annonce, l’API était indiquée comme « à venir ». Vérifiez QwenCloud pour la disponibilité en temps réel.
GLM-5.3-Flash est l’autre modèle économique lancé le même jour, et c’est le rival le plus direct à comparer.
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| Architecture | 125B au total / 6B actifs | 320B au total / 18B actifs |
| Contexte natif | 262K (1M avec YaRN) | 1M de jetons |
| DeepSWE v1.1 | 58,7 | 63,4 |
| SWE-bench Pro | 62,5 | Non publié |
| Prix entrée | 0,16 $/1M | ~0,075 $/1M (promo) |
| Multimodal | Oui | Oui |
GLM-5.3-Flash mène sur DeepSWE v1.1 (63,4 vs 58,7) et affiche 84,3 sur Terminal-Bench 2.1, un benchmark pour lequel Qwen ne publie pas de chiffres.
Il propose aussi un prix d’entrée plus bas pendant sa période promotionnelle et une fenêtre de contexte 1M en natif, sans recourir à YaRN.
Qwen3.8-Flash-Next mène sur SWE-bench Pro (62,5), CoWorkBench (73,9) et JobBench (55,7), là où GLM ne publie pas d’équivalents. Qwen active aussi bien moins de paramètres par jeton (6B vs 18B), ce qui le rend nettement moins coûteux à auto-héberger et plus rapide à servir à l’échelle.
En résumé, GLM affiche de meilleurs scores sur les benchmarks directement partagés. Qwen domine sur les évaluations de workflow bureautique et professionnel, et c’est le meilleur choix si vous exploitez votre propre infrastructure. Pour une analyse complète de GLM-5.3-Flash, consultez notre guide dédié.
Qwen3.8-Flash-Next illustre la stratégie d’Alibaba : faire de l’efficacité-coût le terrain de jeu.
Dépasser Claude Opus 4.6 Max sur SWE-bench Pro, CoWorkBench et JobBench avec 6B de paramètres actifs, à 0,16 $ par million de jetons en entrée, constitue une proposition solide pour ceux qui font tourner du code ou des agents à gros volume.
Nous en ferions un excellent choix par défaut pour des pipelines outillés et intensifs en code, avec deux réserves.
La communauté signale une instabilité occasionnelle sur des chaînes d’agents très longues et une fragilité lorsque les outils renvoient du JSON non standard ; le modèle est aussi moins conservateur en matière de sécurité que la série Claude, ce qui nécessite un prompting soigné pour les contenus limites.
Les résultats sur HLE et Agents’ Last Exam montrent aussi qu’il n’est pas le meilleur choix pour les exercices de raisonnement les plus difficiles.
En tant qu’aperçu précoce de l’architecture Qwen4, le duo GDN + QSA et les N-gram Embeddings sont à surveiller, car ils serviront de base à toute la famille Qwen4.
Si Alibaba maintient ce rapport benchmark/par dollar au niveau vaisseau amiral, la discussion tarifaire en pointe pourrait changer.
Si vous souhaitez bâtir des workflows d’agents et de code autour de ce type de modèles, commencez par notre parcours de compétences AI Agent Fundamentals pour assimiler les concepts clés.
Meilleures formations DataCamp
Cours
Cours
Cours
blog
Kurtis Pykes
15 min
blog
Kurtis Pykes
9 min
blog
Zoumana Keita
15 min
Tutoriel
Tutoriel
Laiba Siddiqui
14 min
Tutoriel
Josef Waples
8 min