Kurs
KI-gestütztes Programmieren für Entwickler
1 Std. 30 Min.
10.7K
Am selben Tag wie der Launch von GLM-5.3 Flash hat Alibabas Qwen-Team die Gewichte von Qwen3.8-Flash-Next geöffnet – ein multimodales Mixture-of-Experts- (MoE) Modell und zugleich ein früher Vorgeschmack auf die Architektur der kommenden Qwen4-Familie.
Das spiegelt wider, was Qwen3-Next für Qwen3.5 getan hat: Die Architekturänderungen vor der kompletten Modellreihe veröffentlichen, damit die Community sie zuerst unter die Lupe nehmen kann.
Die große Story hier ist der Preis. Dank einer hoch effizienten neuen Architektur kostet Qwen3.8-Flash-Next in etwa ein Neuntel der Trainingskosten seines Vorgängers Qwen3.7-Plus. Dabei geht keine Leistung verloren – im Gegenteil: Es schlägt Schwergewichte wie Claude Opus 4.6 Max bei wichtigen Coding-Tests wie SWE-bench.
In diesem Artikel zeige ich dir alles Neue an Qwen3.8-Flash-Next: Architektur, Features und Benchmarks. Für eine Schritt-für-Schritt-Anleitung zum lokalen Download und Betrieb lies unser Qwen3.8-Flash-Next Tutorial. Wenn du Kontext zu anderen chinesischen Modellen möchtest, sieh dir unseren Guide zu Qwen3.8-Max und das Tutorial zum lokalen Ausführen von DeepSeek-V4-Flash-0731 an. Außerdem lohnt sich ein Blick auf den neuen Qwen3.8-Omni-Flash-Release.
Qwen3.8-Flash-Next ist ein multimodales MoE-Modell vom Qwen-Team bei Alibaba, veröffentlicht am 26. August 2026. Es ist als kosteneffizientes Arbeitstier positioniert, nicht als Top-Flaggschiff.
Bei der Intelligenz liegt es unterhalb der Max-Klasse, aber beim Preis unterbietet es fast alles – genau dafür steht die "Flash"-Linie.
Das Modell unterstützt nativ ein Kontextfenster mit 262.144 Tokens, erweiterbar auf 1.000.000 Tokens mit YaRN (Yet another RoPE extensioN – eine Positional-Embedding-Technik, die das Kontextfenster streckt, sodass riesige Texteingaben verarbeitet werden können, ohne die ursprüngliche Leistung zu verlieren).
Es verarbeitet Text, Bild und Video über eine einzige API – einer der Gründe, warum es in den August-2026-Übersichten als "Overnight-Community-Liebling" bezeichnet wurde.
Worauf es für Praktiker ankommt, ist das Verhältnis aus Benchmark und Kosten.
Qwen3.8-Flash-Next schlägt sein eigenes 27B-Geschwister bei jedem veröffentlichten Benchmark und übertrifft Claude Opus 4.6 Max bei den meisten praxisnahen Coding- und Agenten-Tests, obwohl nur 6B Parameter pro Token aktiviert werden. Als Vorschau auf die Qwen4-Architektur zeigt das Design, wohin Alibaba als Nächstes steuert.
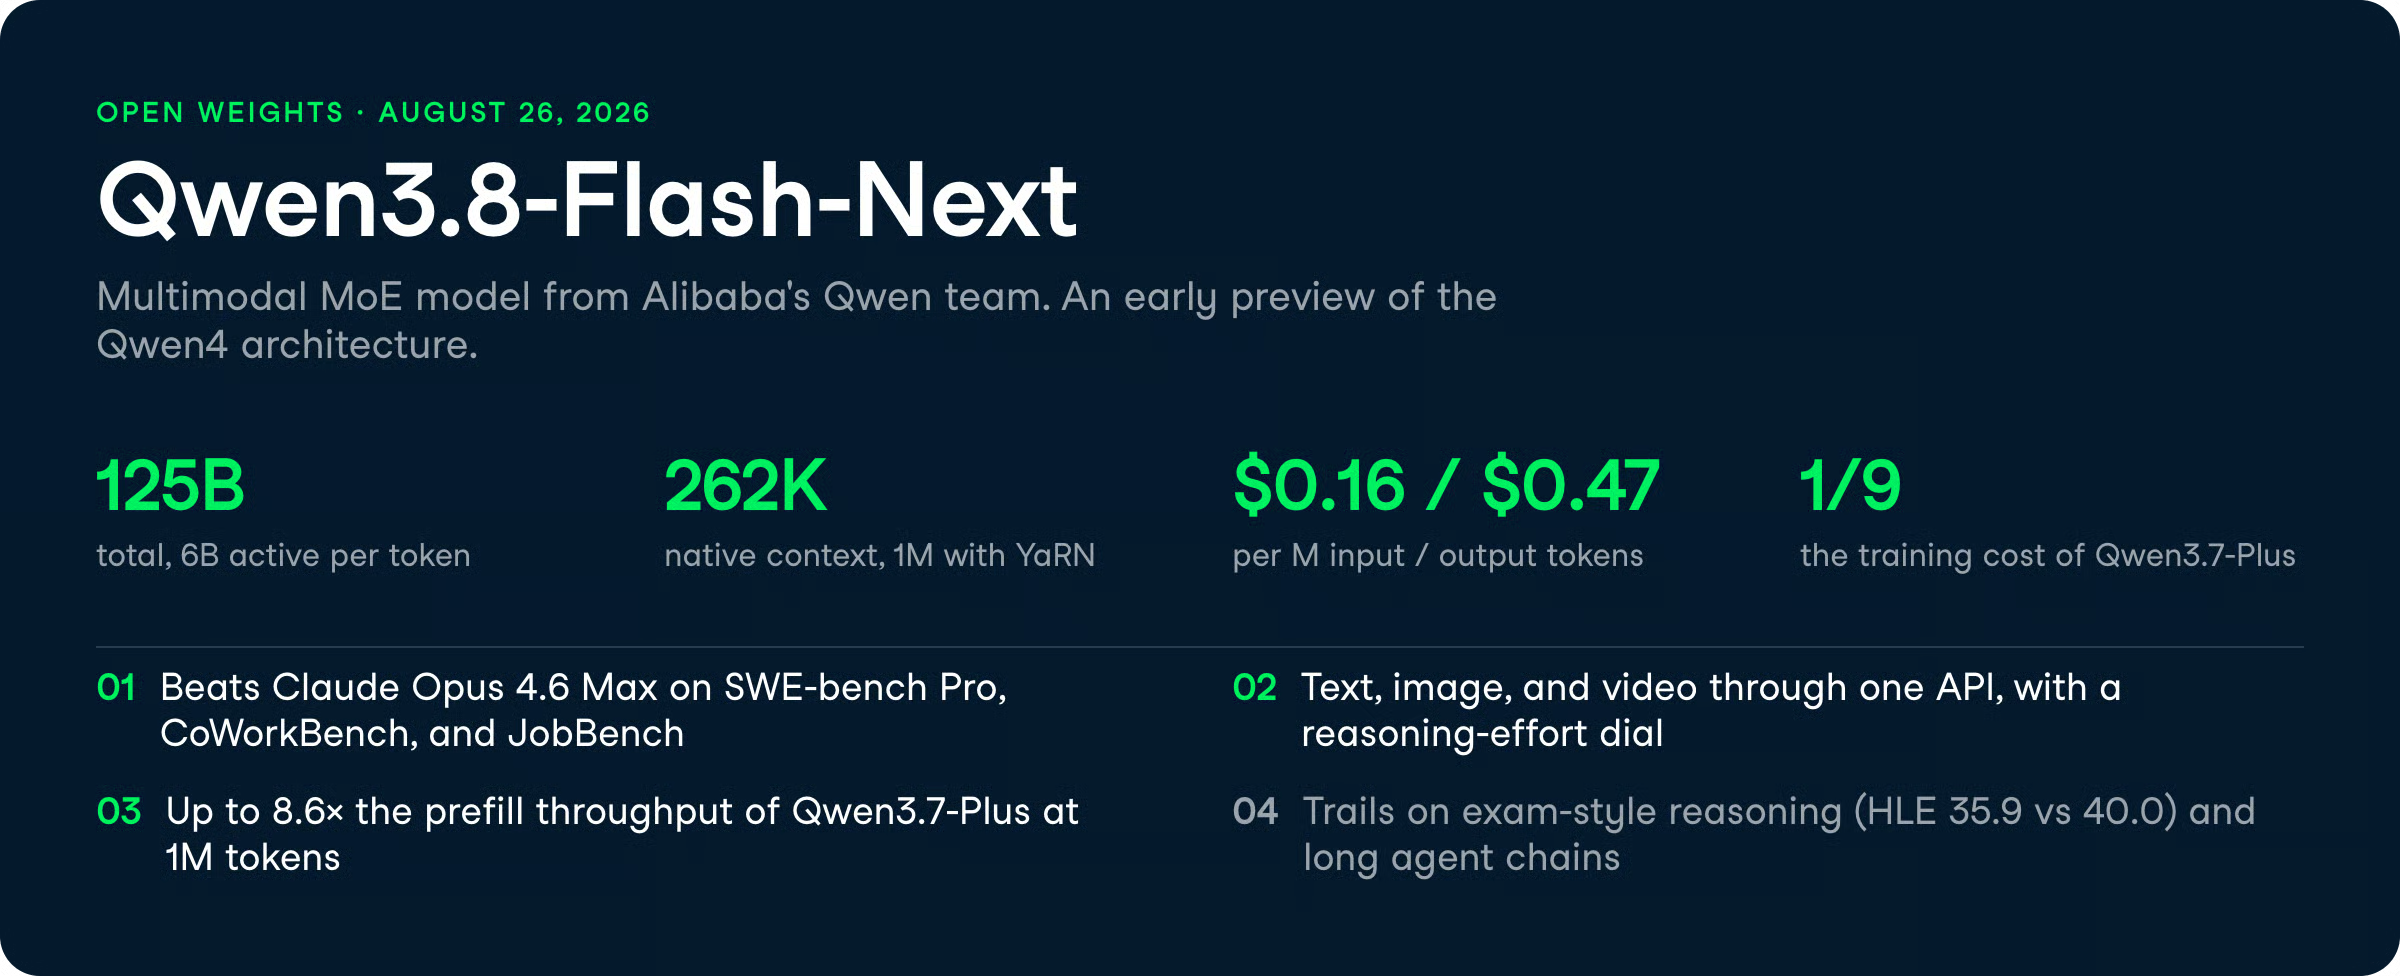
Qwen3.8-Flash-Next bringt Upgrades entlang von vier Achsen: Attention, Residual, Embedding und Optimierung.
Im Folgenden erkläre ich, was dir jede Änderung konkret bringt – nicht nur, was sie ist.
Der größte praktische Gewinn ist die Geschwindigkeit bei langen Eingaben.
Qwen3.8-Flash-Next nutzt ein hybrides Attention-Design: Der Großteil des Kontexthistorie wird komprimiert, um Speicher zu sparen, und eine gezielte "Sparse Attention" holt bei Bedarf nur die relevanten Details zurück.
Die Beschleunigungen bei 1 Million Tokens sind enorm: bis zu 7,6× schnelleres Prompt-Processing (Prefill) und 4,9× schnellere Generierung (Decode). In einem typischen Serving-Setup mit gecachten Präfixen steigt der Gesamtdurchsatz um 8,6× gegenüber Qwen3.7-Plus.
Für alle, die hochvolumiges Retrieval oder Coding-Agenten auf Repo-Ebene betreiben, ist genau dieser Durchsatz der entscheidende Hebel.
Du zahlst für Compute, und dieses Design senkt die Kosten genau bei den langen Sequenzen, die bisher berüchtigt teuer waren.
Qwen nutzt einen cleveren Trick namens N-gram Embedding und fügt praktisch kostenlos 51 Milliarden Parameter hinzu. Statt nur ein einzelnes Token zu betrachten, schaut das Modell auf das aktuelle Token plus dessen jüngste Nachbarn – das verleiht ihm ein großes "Lokalpattern-Gedächtnis".
Weil das Modell vorab weiß, was es nachschlagen muss, liegen diese zusätzlichen 51B Parameter im normalen Systemspeicher (RAM), nicht auf der GPU. Sie werden automatisch im Hintergrund geladen, belegen also nicht dauerhaft VRAM und erhöhen nicht die Rechenkosten pro Token.
Du bekommst die Denkleistung eines deutlich größeren Modells, ohne die übliche VRAM-Strafe zu zahlen.
Qwen3.8-Flash-Next verarbeitet Text, Bilder und Video über ein einziges Interface – und seine Vision-Fähigkeiten liegen deutlich über seiner Preisklasse.
Es schlägt Claude Opus 4.6 Max bei Mobile-Use-Tests (84,5 vs. 62,0 auf AndroidWorld) und bei realweltlichem visuellen Verständnis (88,5 vs. 73,9 auf RealWorldQA).
Auch bei visueller Mathematik dominiert es, mit bis zu 95,7 Punkten auf MathVision (klar vor Opus mit 65,5).
Wenn dein Workflow Screenshots, Diagramme oder App-UIs parst, bietet Qwen zu diesem Preis echte Vorteile gegenüber Claude.
Die API bietet dir einen reasoning effort-Regler mit drei Stufen (hoch, mittel, niedrig). So tauschst du tiefes Nachdenken gegen niedrigere Latenz und günstigere Anfragen.
Außerdem ist ein Multi-Token-Prediction-Modul eingebaut, das mehrere Schritte im Voraus prognostiziert und die Generierung in realen Workloads beschleunigt.
Kurz gesagt: Kontrolle.
Du kannst das Reasoning für hohes Volumen und Kostenfokus herunterdrehen und für komplexe, agentische Aufgaben hochfahren – alles mit derselben Model-ID.
Über die veröffentlichten Zahlen hinweg führt Qwen3.8-Flash-Next bei den meisten Coding- und Agenten-Benchmarks und liegt bei einigen prüfungsähnlichen Reasoning-Tests zurück.
Es schlägt sein 27B-Geschwister überall, mit den größten Abständen bei agentischer Arbeit.
Alle Vergleiche unten stammen aus Qwens eigener Veröffentlichungstabelle, sofern nicht anders angegeben.
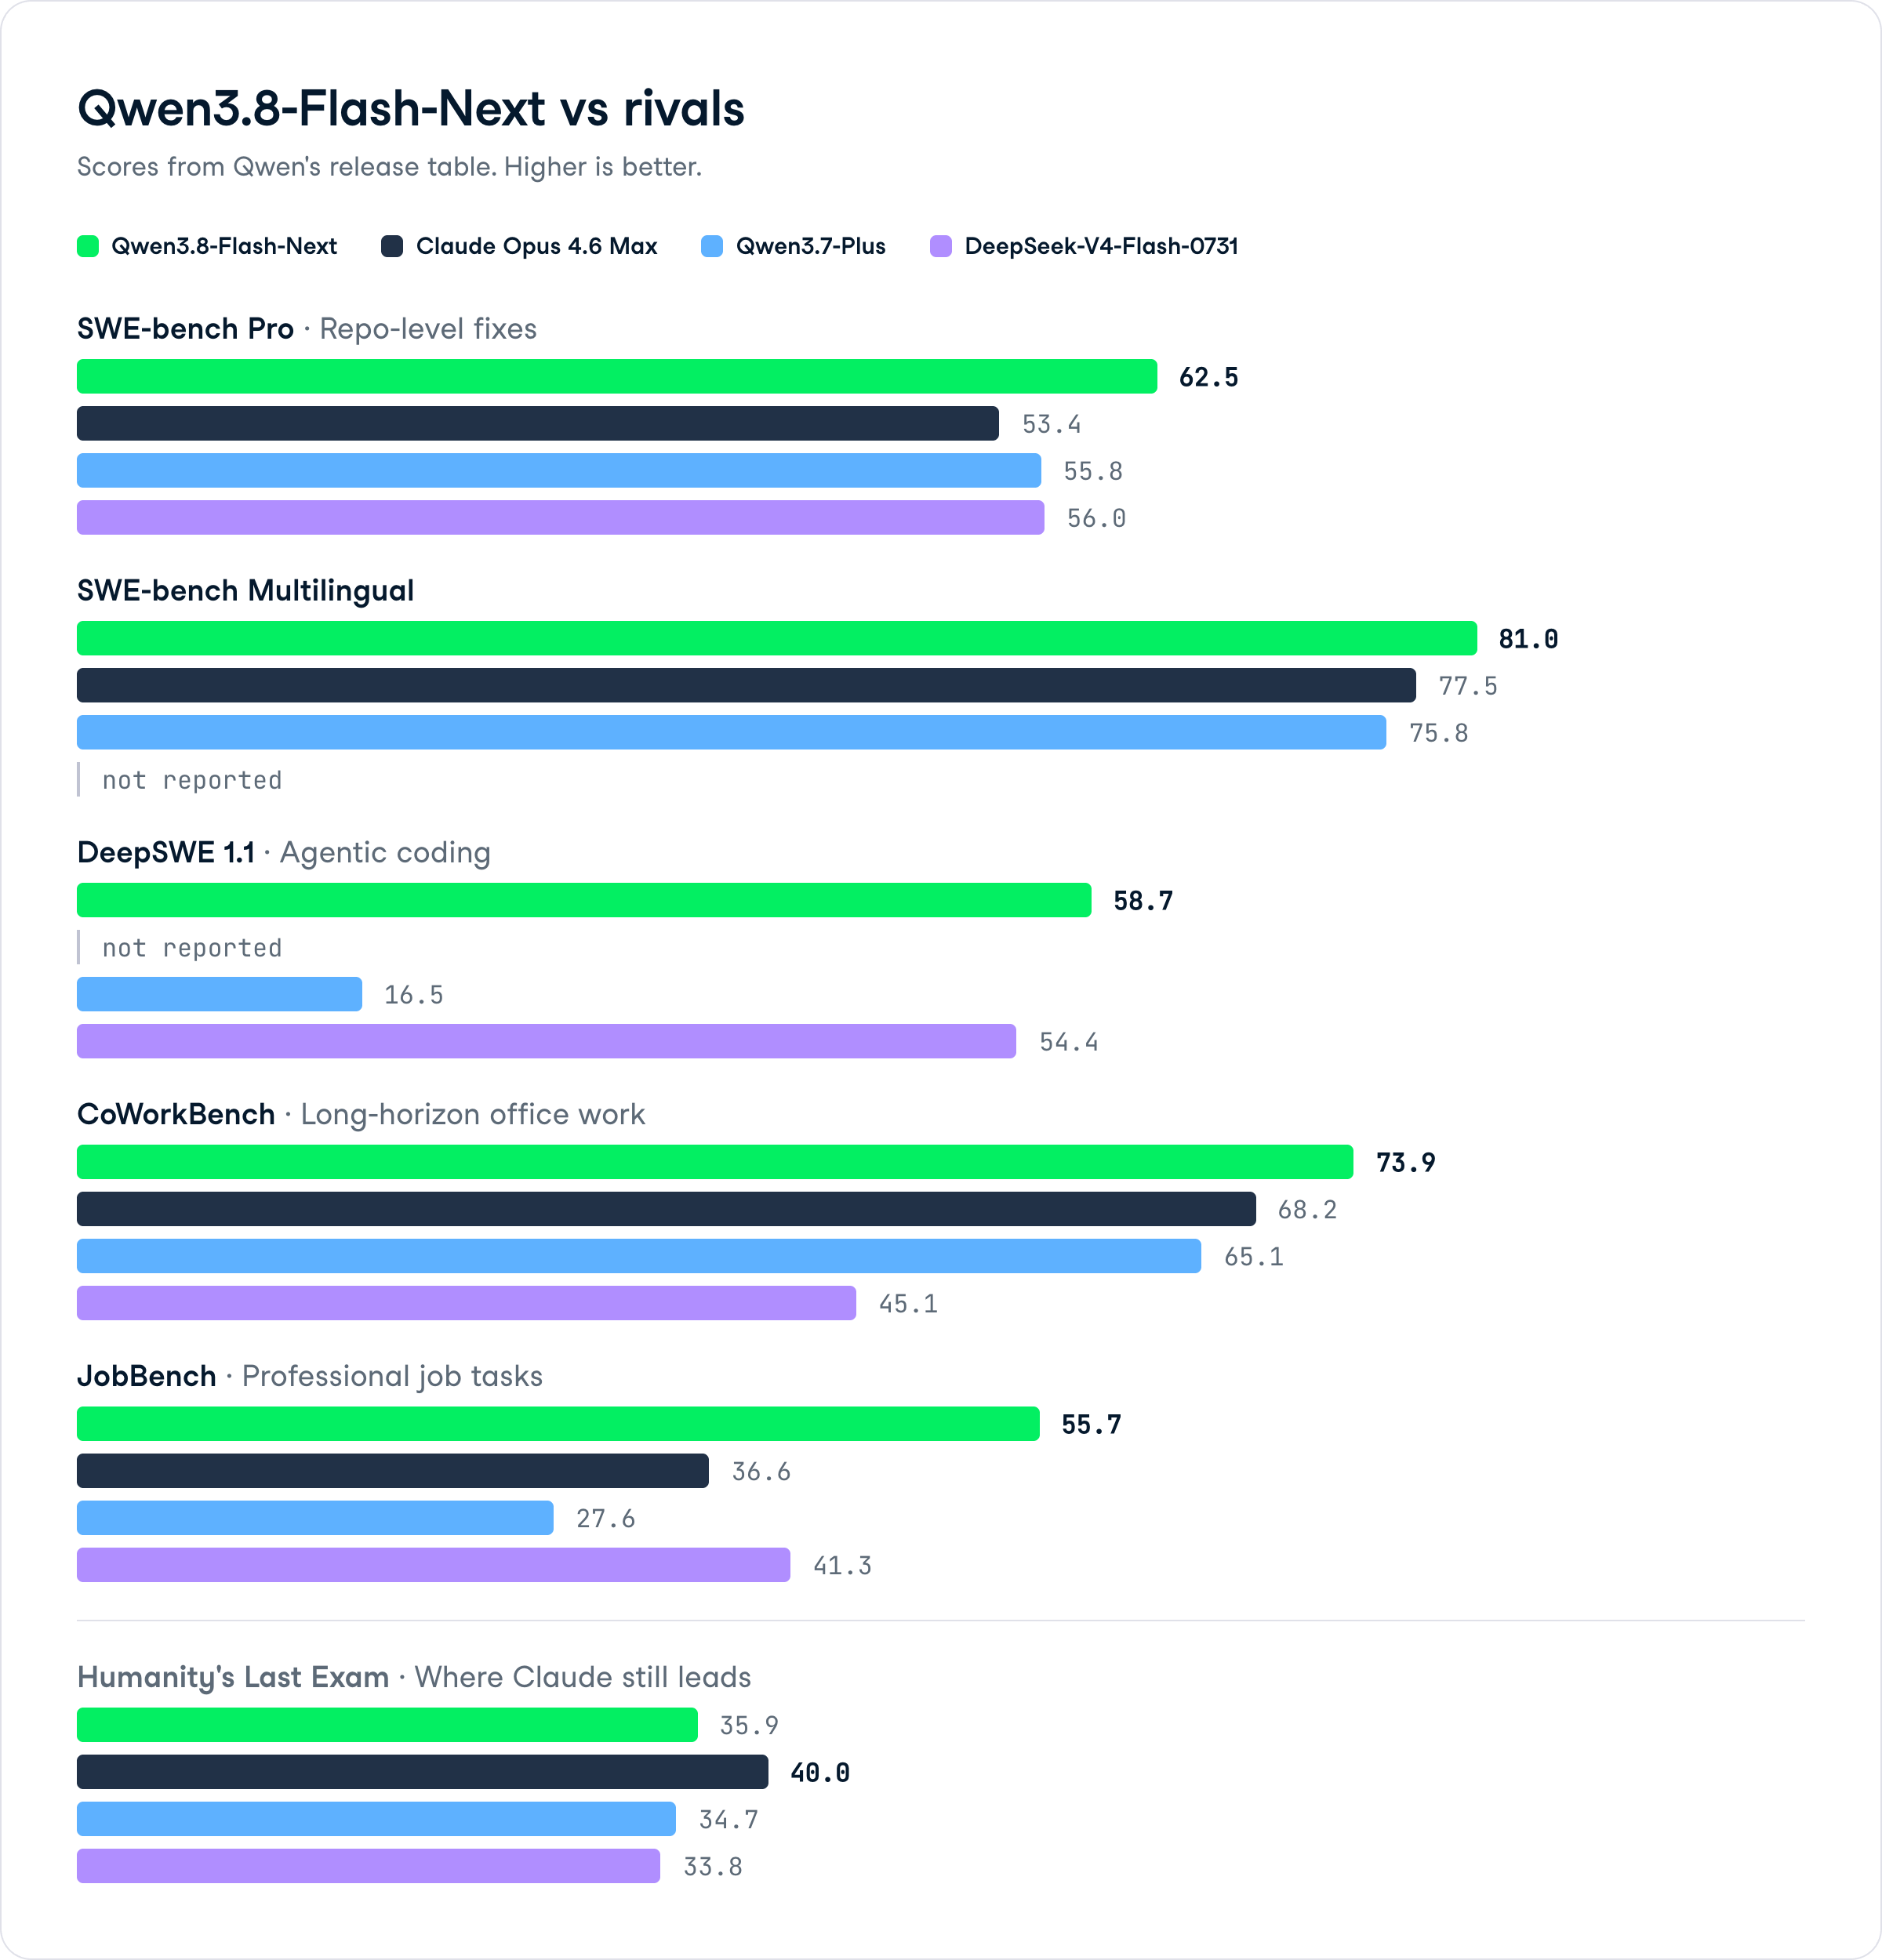
SWE-bench Pro misst reale Software-Fixes auf Repository-Ebene. Qwen3.8-Flash-Next erzielt 62,5 und liegt damit vor Claude Opus 4.6 Max mit 53,4 und Qwen3.7-Plus mit 55,8.
Bei SWE-bench Multilingual, das Fixes über Sprachen hinweg testet, erreicht es 81,0 gegenüber 77,5 von Opus 4.6 Max.
Das sind die Zahlen, die das Release tragen.
Dass ein Modell mit 6B aktiven Parametern ein Claude der Max-Klasse bei Engineering auf Repo-Ebene schlägt, ist der Grund für die große Aufmerksamkeit.
DeepSWE 1.1 bewertet agentisches Coding über Harnesses wie Claude Code und mini-SWE-agent. Qwen3.8-Flash-Next erzielt 58,7 gegenüber 42,2 seines 27B-Geschwisters und 16,5 von Qwen3.7-Plus.
DeepSeek-V4-Flash-0731 liegt hier bei 54,4.
Als wir DeepSeek-V4-Flash-0731 als Coding-Agent in unserem Tutorial laufen ließen, baute es in rund 20 Minuten aus einem einzigen Prompt eine komplette Stock-Analytics-Website und generierte Chat mit etwa 33 Tokens pro Sekunde.
Die DeepSWE-Differenz zwischen den beiden Modellen deutet darauf hin, dass Qwen3.8-Flash-Next in ähnlichen agentischen Coding-Loops stark performen dürfte.
Auf der Agentenseite liefert das Modell starke Werte über mehrere Evaluierungen:
Der Abstand bei JobBench fällt besonders auf.
Bei professionellen Workflow-Aufgaben liegt Qwen3.8-Flash-Next fast 20 Punkte vor einem Claude der Max-Klasse – ein Ergebnis, das es für Enterprise-Automatisierung unbedingt testenswert macht.
Beim allgemeinen Reasoning erreicht Qwen3.8-Flash-Next 91,7 auf GPQA Diamond (wissenschaftliches Reasoning), knapp vor 91,3 von Claude Opus 4.6 Max, und 91,9 auf LiveCodeBench v6 (kompetitives Coding) gegenüber 88,8 bei Opus 4.6 Max.
Es gewinnt jedoch nicht überall.
Bei Humanity's Last Exam (HLE), das multidisziplinäres Reasoning testet, erhält es 35,9 gegenüber 40,0 bei Claude Opus 4.6 Max. Bei Agents' Last Exam Pass@1 liegt DeepSeek-V4-Flash-0731 mit 25,2 knapp vor 24,3.
Das Muster zeigt sich auch in unabhängigen Trackern: Qwen3.8-Flash-Next führt bei praktischem Coding und Agentenarbeit, während Claude bei einigen prüfungsähnlichen Reasoning-Benchmarks vorne bleibt.
Qwen3.8-Flash-Next-Base gewinnt 8 von 14 Pretraining-Benchmarks gegen die Basismodelle von Qwen3.8-27B und das deutlich größere Qwen3.7-Plus.
Es führt bei MMLU-Pro (73,23), SuperGPQA (51,36), BBH (90,87), GSM8K (93,29), EvalPlus (78,76), SWEBench-Pretrain (50,99), MGSM (89,33) und MMMLU (84,86).
Bemerkenswert ist, dass es das mit 6B aktivierten Parametern gegen 17B aktiv und 397B gesamt bei Qwen3.7-Plus schafft und bei MMLU, MMLU-Redux, GPQA, MATH und MultiPL-E jeweils innerhalb eines Punkts bleibt.
Die 51B N-gram-Embedding-Parameter werden deterministisch adressiert und fließen nie in das per-Token-Matmul-Budget ein – das ist echte Effizienz und kein Parameterzähl-Trick.
So schneidet das Modell im Vergleich zu Claude Opus 4.6 Max, seinem Vorgänger Qwen3.7-Plus und DeepSeek-V4-Flash-0731 bei den wichtigsten Evaluierungen ab.
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 53.4 | 55.8 | 56.0 |
| SWE-bench Multilingual | 81.0 | 77.5 | 75.8 | -- |
| DeepSWE 1.1 | 58.7 | -- | 16.5 | 54.4 |
| CoWorkBench | 73.9 | 68.2 | 65.1 | 45.1 |
| JobBench | 55.7 | 36.6 | 27.6 | 41.3 |
| GPQA Diamond | 91.7 | 91.3 | 90.3 | 90.8 |
| LiveCodeBench v6 | 91.9 | 88.8 | 89.6 | 90.6 |
| HLE | 35.9 | 40.0 | 34.7 | 33.8 |
Die Qwen3.8-Flash-Next-Gewichte sind jetzt als Open-Weight-Modell auf Hugging Face und ModelScope verfügbar.
Die Produktionsversion mit standardmäßig 1M Kontext und integrierten Tools wird als Qwen3.8-Flash auf QwenCloud unter der Modell-ID qwen3.8-flash bereitgestellt.
Bei den Preisen spielt das Modell seine größte Stärke aus:
Zum Vergleich: Unsere Qwen3.8-Max-Übersicht listet dieses Modell mit 2,00 $ Input und 6,00 $ Output pro Million Tokens. Flash-Next unterbietet damit sein eigenes Max-Geschwister beim Input um mehr als den Faktor 10.
QwenCloud unterstützt OpenAI-kompatible Chat Completions und Responses APIs sowie eine Anthropic-kompatible Schnittstelle, sodass es mit minimalen Konfigurationsänderungen in Claude Code, Codex und Qwen Code eingesetzt werden kann.
Beachte: Zum Zeitpunkt der Ankündigung war die API als "coming soon" angegeben. Prüfe daher QwenCloud für den Live-Status.
GLM-5.3-Flash ist das andere Budget-Modell mit demselben Launch-Tag – und der direkteste Rivale im Vergleich.
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| Architektur | 125B gesamt / 6B aktiv | 320B gesamt / 18B aktiv |
| Natives Kontextfenster | 262K (1M mit YaRN) | 1M Tokens |
| DeepSWE v1.1 | 58.7 | 63.4 |
| SWE-bench Pro | 62.5 | Nicht veröffentlicht |
| Input-Preis | 0,16 $/1M | ~0,075 $/1M (Promo) |
| Multimodal | Ja | Ja |
GLM-5.3-Flash liegt bei DeepSWE v1.1 vorne (63,4 vs. 58,7) und erzielt 84,3 auf Terminal-Bench 2.1, einem Benchmark, für den Qwen keine Zahlen veröffentlicht.
Es bietet zudem während des Promotionszeitraums einen niedrigeren Input-Preis und ein 1M-Token-Kontextfenster nativ, ganz ohne YaRN.
Qwen3.8-Flash-Next führt bei SWE-bench Pro (62,5), CoWorkBench (73,9) und JobBench (55,7), wo GLM keine vergleichbaren Zahlen publiziert. Qwen aktiviert außerdem deutlich weniger Parameter pro Token (6B vs. 18B), was Self-Hosting spürbar günstiger macht und den Betrieb im Scale beschleunigt.
Zusammengefasst: GLM hat auf den direkt geteilten Benchmarks die stärkeren publizierten Zahlen. Qwen liegt bei Office- und Professional-Workflow-Evals vorne und ist die bessere Wahl, wenn du eigene Infrastruktur betreibst. Für die komplette GLM-5.3-Flash-Analyse sieh dir unseren ausführlichen Guide an.
Qwen3.8-Flash-Next ist Alibabas klare Ansage: Der Wettbewerb wird über Kosteneffizienz entschieden.
Claude Opus 4.6 Max bei SWE-bench Pro, CoWorkBench und JobBench mit 6B aktiven Parametern zu schlagen – und das für 0,16 $ pro Million Input-Tokens – ist ein starkes Angebot für alle, die hochvolumige Coding- oder Agenten-Workloads fahren.
Ich würde es als starken Default für toolgetriebene und codinglastige Pipelines sehen – mit zwei Vorbehalten.
Aus der Community kommen Berichte über gelegentliche Instabilität bei sehr langen agentischen Ketten und Brüchigkeit, wenn Tools nicht standardkonformes JSON zurückgeben. Außerdem ist das Modell bei Safety weniger konservativ als die Claude-Reihe – grenze heiklere Inhalte daher sorgfältig per Prompting ein.
Die HLE- und Agents'-Last-Exam-Ergebnisse zeigen ebenfalls, dass es nicht das richtige Modell für die härtesten, prüfungsähnlichen Reasoning-Aufgaben ist.
Als früher Ausblick auf die Qwen4-Architektur sind der GDN+QSA-Hybrid und die N-gram-Embedding-Ansätze spannend, denn auf ihnen wird die gesamte Qwen4-Familie aufbauen.
Wenn Alibaba dieses Benchmark-pro-Dollar-Verhältnis bis zur Flaggschiff-Klasse halten kann, verändert das die Preisdebatte an der Frontlinie.
Wenn du agentische und Coding-Workflows um Modelle wie dieses bauen willst, starte am besten mit unserem AI Agent Fundamentals Skill Track, um die Kernkonzepte schnell draufzuhaben.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Zoumana Keita
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Josef Waples
3 Min.