Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.8K
No mesmo dia do lançamento do GLM-5.3 Flash, o time Qwen da Alibaba abriu os pesos do Qwen3.8-Flash-Next, um modelo multimodal de mixture-of-experts (MoE) que também funciona como um prévia da arquitetura por trás da próxima família Qwen4.
Isso repete o que o Qwen3-Next fez para o Qwen3.5: liberar as mudanças de arquitetura antes da linha completa de modelos para a comunidade explorar primeiro.
O grande destaque aqui é o custo. Graças a uma nova arquitetura altamente eficiente, o Qwen3.8-Flash-Next custa cerca de um nono do que foi necessário para treinar seu antecessor, o Qwen3.7-Plus. E sem abrir mão de potência: ele supera pesos pesados como o Claude Opus 4.6 Max em testes importantes de código, como o SWE-bench.
Neste artigo, eu apresento tudo o que há de novo no Qwen3.8-Flash-Next, passando por sua arquitetura e recursos e analisando os benchmarks. Para um passo a passo de como baixar e rodar o modelo localmente, leia nosso tutorial do Qwen3.8-Flash-Next. Se você quer contexto sobre outros modelos chineses, confira nosso guia do Qwen3.8-Max e nosso tutorial sobre rodar o DeepSeek-V4-Flash-0731 localmente. Também recomendo ver o novo Qwen3.8-Omni-Flash.
Qwen3.8-Flash-Next é um modelo MoE multimodal do time Qwen da Alibaba, lançado em 26 de agosto de 2026, posicionado como um motor de trabalho com ótimo custo-benefício, e não como um flagship topo de linha.
Ele fica abaixo dos modelos classe Max em inteligência, mas bate quase todos em preço, que é a proposta da linha "Flash".
O modelo oferece nativamente uma janela de contexto de 262.144 tokens, extensível para 1.000.000 de tokens com YaRN (método [Yet another RoPE extensioN], uma técnica de codificação posicional que estica a janela de contexto do modelo, permitindo lidar com entradas enormes mantendo o desempenho original).
Ele processa texto, imagem e vídeo por uma única API, um dos motivos de ter sido chamado de "queridinho da comunidade da noite para o dia" nos resumos de lançamentos de agosto de 2026.
O que torna este lançamento relevante para quem está na prática é a relação benchmark-por-dólar.
O Qwen3.8-Flash-Next supera seu irmão de 27B em todos os benchmarks publicados e tem desempenho melhor que o Claude Opus 4.6 Max na maioria das avaliações práticas de código e agentes, ativando apenas 6B parâmetros por token. Como é uma prévia da arquitetura Qwen4, as escolhas aqui sinalizam para onde a Alibaba está indo.
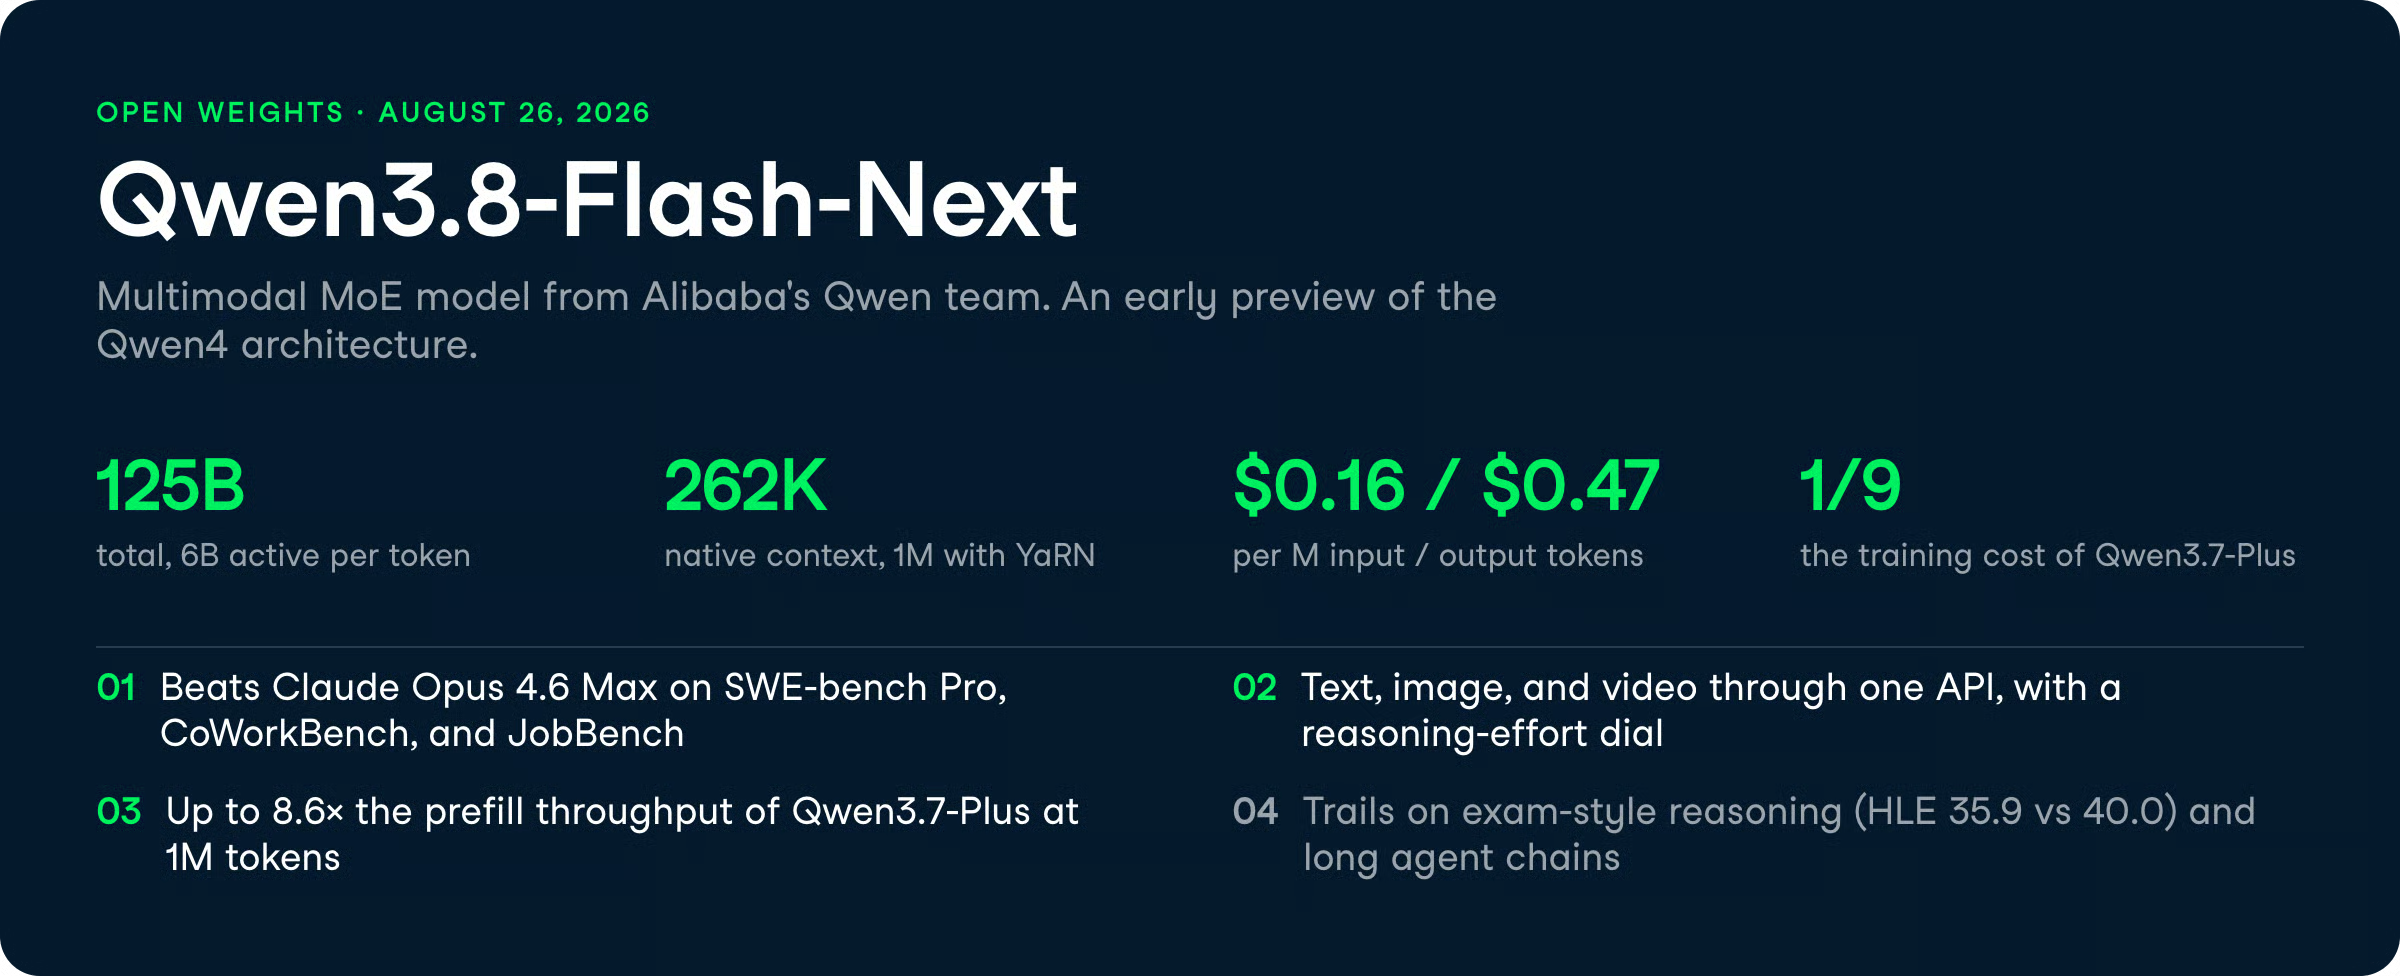
Qwen3.8-Flash-Next evolui o modelo em quatro frentes: atenção, residual, embedding e otimização.
Abaixo, explico o que cada mudança entrega para você como usuário, e não apenas o que ela é.
O maior ganho prático é velocidade em entradas longas.
Qwen3.8-Flash-Next usa um design híbrido de atenção, em que comprime a maior parte do histórico de contexto para economizar espaço e utiliza uma ferramenta direcionada de "Sparse Attention" para recuperar apenas os detalhes mais relevantes quando necessário.
Os ganhos de velocidade em 1 milhão de tokens são enormes: até 7,6x mais rápido no processamento do prompt (prefill) e 4,9x mais rápido na geração (decode). Em um setup típico com prefixos em cache, o throughput geral salta 8,6x em comparação ao Qwen3.7-Plus.
Para quem roda busca em alto volume ou agentes de código em escala de repositório, essa diferença de throughput é o recurso.
Você paga por compute, e esse design reduz a conta justamente nas sequências longas que costumavam ser notoriamente caras.
O Qwen usa um truque interessante chamado N-gram Embedding para adicionar 51 bilhões de parâmetros essencialmente de graça. Em vez de olhar só um token por vez, ele considera o token atual mais seus vizinhos recentes, dando ao modelo uma grande "memória de padrões locais".
Como o modelo sabe de antemão o que buscar, esses 51B parâmetros extras ficam na memória do sistema (RAM), não na GPU. Eles são puxados automaticamente em segundo plano, o que significa que não ocupam VRAM de forma permanente nem aumentam o custo de compute por token.
Você ganha a inteligência de um modelo bem maior sem pagar o "imposto" usual de VRAM.
Qwen3.8-Flash-Next lida com texto, imagem e vídeo por uma única interface, e suas capacidades de visão entregam muito acima da sua faixa de preço.
Ele supera com folga o Claude Opus 4.6 Max em testes de uso mobile (84,5 vs 62,0 no AndroidWorld) e entendimento visual do mundo real (88,5 vs 73,9 no RealWorldQA).
Também vai muito bem em matemática visual, chegando a 95,7 no MathVision (bem à frente dos 65,5 do Opus).
Se o seu fluxo envolve interpretar capturas de tela, gráficos ou UIs de aplicativos, o Qwen oferece uma vantagem real sobre o Claude nesse patamar de preço.
A API traz um ajuste de reasoning effort com três níveis (alto, médio e baixo), permitindo trocar profundidade de raciocínio por menor latência e requisições mais baratas.
O modelo também incorpora um módulo de predição multi-token, que basicamente prevê vários passos à frente para acelerar a geração em workloads reais.
O ganho prático é controle.
Você pode reduzir o raciocínio para tráfego de alto volume e sensível a custo, e aumentar para tarefas agentivas mais complexas, tudo usando o mesmo ID de modelo.
No geral, o Qwen3.8-Flash-Next lidera na maioria dos benchmarks de código e agentes, ficando atrás em algumas avaliações de raciocínio no estilo prova.
Ele vence seu irmão de 27B em tudo, com as maiores diferenças em trabalho agentivo.
Todas as comparações abaixo vêm da própria tabela de lançamento do Qwen, salvo indicação em contrário.
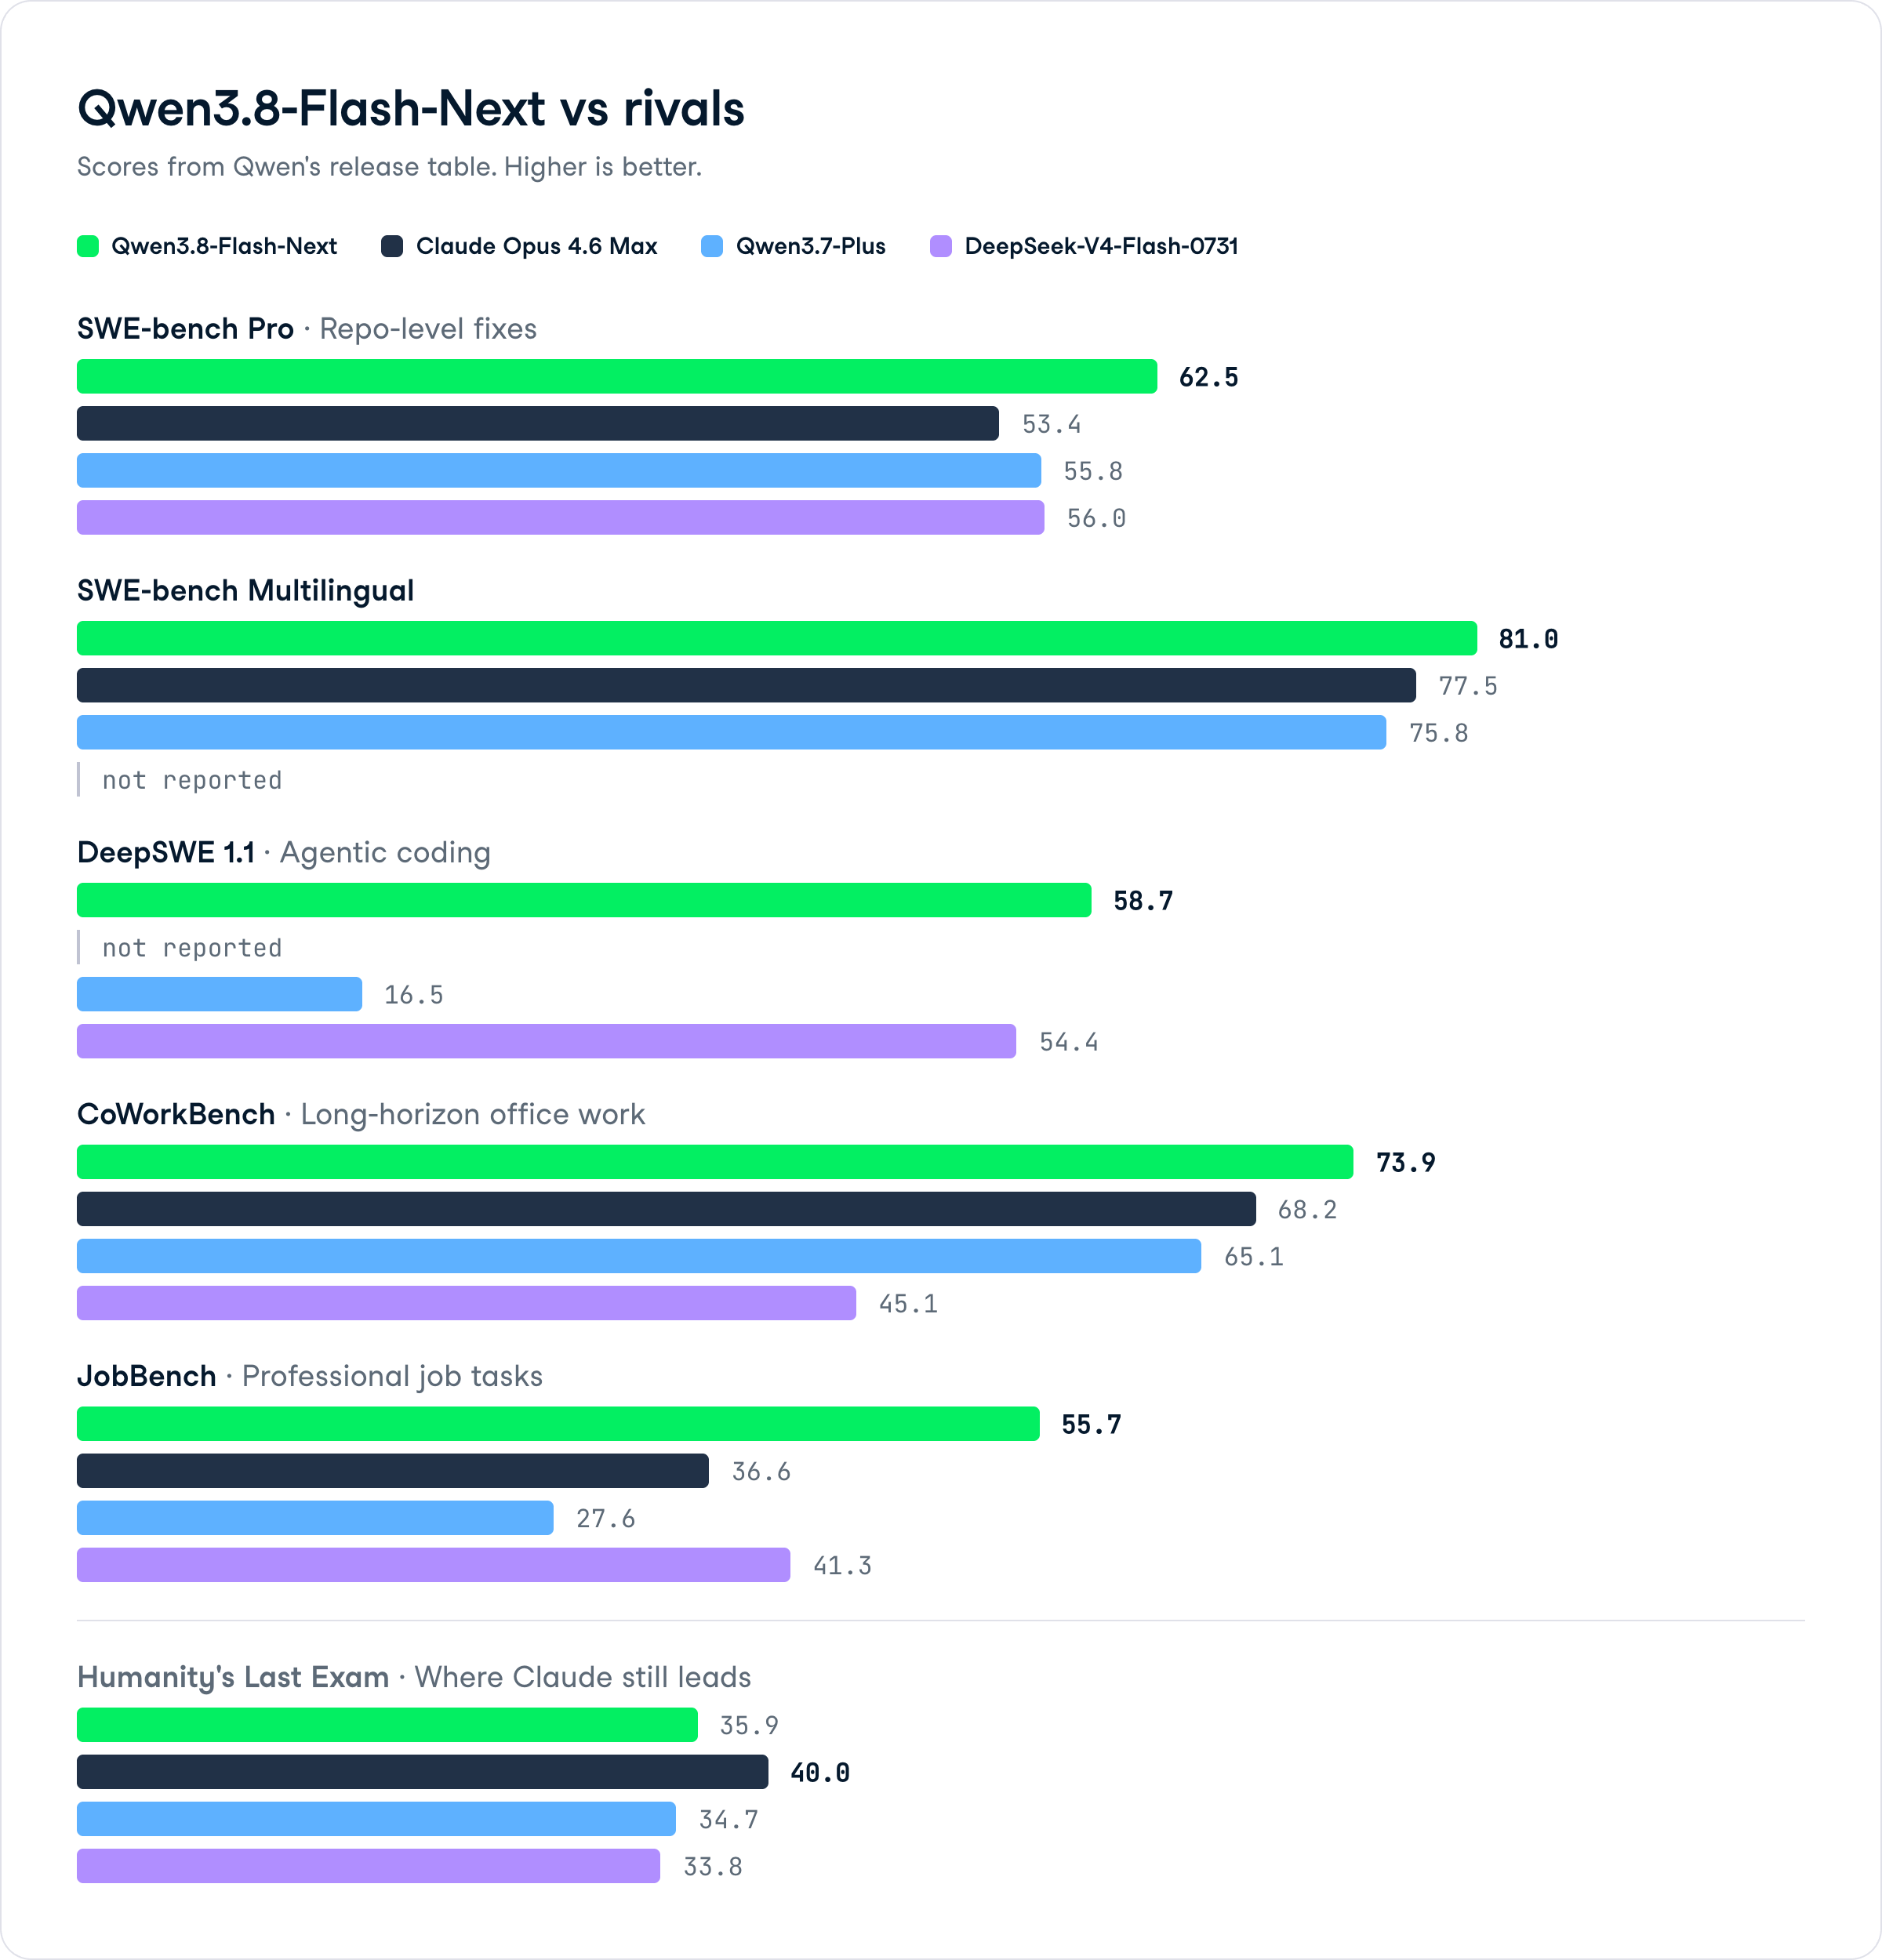
O SWE-bench Pro mede correções reais em nível de repositório, e o Qwen3.8-Flash-Next marca 62,5, à frente dos 53,4 do Claude Opus 4.6 Max e dos 55,8 do Qwen3.7-Plus.
No SWE-bench Multilingual, que testa correções em vários idiomas, ele chega a 81,0 contra 77,5 do Opus 4.6 Max.
Esses são os números que sustentam o lançamento.
Um modelo com 6B ativos superar um Claude de nível Max em engenharia no nível de repositório é o motivo de tanta atenção.
O DeepSWE 1.1 avalia codificação agentiva por meio de frameworks como Claude Code e mini-SWE-agent, e o Qwen3.8-Flash-Next marca 58,7 contra 42,2 do seu irmão de 27B e 16,5 do Qwen3.7-Plus.
O DeepSeek-V4-Flash-0731 fica em 54,4 aqui.
Quando rodamos o DeepSeek-V4-Flash-0731 como agente de código em nosso tutorial, ele construiu um site completo de analytics de ações a partir de um único prompt em cerca de 20 minutos, gerando chat a aproximadamente 33 tokens por segundo.
A diferença no DeepSWE entre os dois modelos sugere que o Qwen3.8-Flash-Next deve se sair bem em loops similares de codificação agentiva.
No lado agentivo, o modelo apresenta números fortes em várias avaliações:
O destaque é o gap no JobBench.
Em tarefas de workflow profissional, o Qwen3.8-Flash-Next marca quase 20 pontos acima de um Claude de nível Max, o tipo de resultado que vale testar para automação corporativa.
Em raciocínio geral, o Qwen3.8-Flash-Next chega a 91,7 no GPQA Diamond (raciocínio científico), ligeiramente à frente dos 91,3 do Claude Opus 4.6 Max, e 91,9 no LiveCodeBench v6 (programação competitiva) contra 88,8 do Opus 4.6 Max.
Mas ele não vence em tudo.
No Humanity's Last Exam (HLE), que testa raciocínio multidisciplinar, marca 35,9 contra 40,0 do Claude Opus 4.6 Max. No Agents' Last Exam Pass@1, o DeepSeek-V4-Flash-0731 leva a melhor por 25,2 a 24,3.
O padrão se repete em trackers independentes: o Qwen3.8-Flash-Next lidera em código prático e trabalho com agentes, enquanto o Claude mantém vantagem em alguns benchmarks de raciocínio no estilo prova.
O Qwen3.8-Flash-Next-Base vence 8 de 14 benchmarks de pré-treinamento contra os modelos base do Qwen3.8-27B e do bem maior Qwen3.7-Plus.
Ele lidera em MMLU-Pro (73,23), SuperGPQA (51,36), BBH (90,87), GSM8K (93,29), EvalPlus (78,76), SWEBench-Pretrain (50,99), MGSM (89,33) e MMMLU (84,86).
O impressionante é fazer isso com 6B parâmetros ativados contra 17B ativos e 397B totais do Qwen3.7-Plus, ficando a menos de um ponto dele em MMLU, MMLU-Redux, GPQA, MATH e MultiPL-E.
Os 51B parâmetros de N-gram embedding são endereçados de forma determinística e nunca entram no orçamento de matmul por token, então é eficiência real, não truque de contagem de parâmetros.
Veja como o modelo se compara ao Claude Opus 4.6 Max, ao seu antecessor Qwen3.7-Plus e ao DeepSeek-V4-Flash-0731 nos principais testes.
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62,5 | 53,4 | 55,8 | 56,0 |
| SWE-bench Multilingual | 81,0 | 77,5 | 75,8 | -- |
| DeepSWE 1.1 | 58,7 | -- | 16,5 | 54,4 |
| CoWorkBench | 73,9 | 68,2 | 65,1 | 45,1 |
| JobBench | 55,7 | 36,6 | 27,6 | 41,3 |
| GPQA Diamond | 91,7 | 91,3 | 90,3 | 90,8 |
| LiveCodeBench v6 | 91,9 | 88,8 | 89,6 | 90,6 |
| HLE | 35,9 | 40,0 | 34,7 | 33,8 |
Os pesos do Qwen3.8-Flash-Next estão disponíveis agora como modelo de pesos abertos no Hugging Face e no ModelScope.
A versão de produção, com 1M de contexto por padrão e ferramentas integradas, é servida como Qwen3.8-Flash no QwenCloud sob o ID de modelo qwen3.8-flash.
O preço é onde este modelo mais briga:
Para comparação, nossa cobertura do Qwen3.8-Max lista esse modelo a US$ 2,00 na entrada e US$ 6,00 na saída por milhão de tokens, então o Flash-Next custa mais de 10x menos que o Max da própria linha na entrada.
O QwenCloud é compatível com as APIs de Chat Completions e Responses da OpenAI e também com uma interface compatível com a Anthropic, então ele se integra ao Claude Code, Codex e Qwen Code com mudanças mínimas de configuração.
Observação: no anúncio, a API foi listada como "em breve"; verifique no QwenCloud a disponibilidade em tempo real.
O GLM-5.3-Flash é o outro modelo econômico lançado no mesmo dia e é o rival mais direto para comparação lado a lado.
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| Arquitetura | 125B total / 6B ativos | 320B total / 18B ativos |
| Contexto nativo | 262K (1M com YaRN) | 1M tokens |
| DeepSWE v1.1 | 58,7 | 63,4 |
| SWE-bench Pro | 62,5 | Não publicado |
| Preço de entrada | US$ 0,16/1M | ~US$ 0,075/1M (promo) |
| Multimodal | Sim | Sim |
O GLM-5.3-Flash lidera no DeepSWE v1.1 (63,4 vs 58,7) e marca 84,3 no Terminal-Bench 2.1, um benchmark para o qual o Qwen não publica números.
Ele também tem preço de entrada menor durante a janela promocional e uma janela de contexto de 1M de tokens nativa, sem precisar de YaRN.
O Qwen3.8-Flash-Next lidera no SWE-bench Pro (62,5), CoWorkBench (73,9) e JobBench (55,7), onde o GLM não publica números equivalentes. O Qwen também ativa bem menos parâmetros por token (6B vs 18B), o que o torna significativamente mais barato para self-host e mais rápido para servir em escala.
Resumindo: o GLM tem números mais fortes nos benchmarks que ambos publicam. O Qwen lidera nas avaliações de escritório e workflow profissional e é a melhor escolha se você roda sua própria infraestrutura. Para um guia completo do GLM-5.3-Flash, veja nosso material.
O Qwen3.8-Flash-Next é a Alibaba deixando claro que eficiência de custo é o campo de batalha.
Superar o Claude Opus 4.6 Max no SWE-bench Pro, CoWorkBench e JobBench com 6B parâmetros ativos, a US$ 0,16 por milhão de tokens de entrada, é uma proposta séria para quem roda workloads de código ou agentes em alto volume.
Eu o trataria como um forte padrão para pipelines orientados a ferramentas e intensivos em código, com duas ressalvas.
Relatos da comunidade apontam instabilidade ocasional em cadeias agentivas muito longas e fragilidade quando ferramentas retornam JSON fora do padrão, e o modelo é menos conservador em segurança do que a série Claude, exigindo prompts cuidadosos para conteúdo no limite.
Os resultados no HLE e no Agents' Last Exam também mostram que ele não é o modelo ideal para o raciocínio mais difícil no estilo prova.
Como prévia da arquitetura Qwen4, os designs híbridos GDN + QSA e N-gram Embedding merecem atenção, pois serão a base da família Qwen4 completa.
Se a Alibaba mantiver essa relação benchmark-por-dólar no nível flagship, a conversa sobre preços na fronteira muda.
Se você quer construir workflows agentivos e de código em torno de modelos como este, recomendo começar pela nossa trilha de habilidades AI Agent Fundamentals para acelerar nos conceitos essenciais.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Richie Cotton
7 min
blog
Josep Ferrer
8 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan