Last chance! 50% off DataCamp Premium
Sale ends in
Trong thống kê và khoa học dữ liệu, phân phối Poisson là công cụ quan trọng để mô hình hóa các sự kiện rời rạc xảy ra trong một khoảng cố định. Được đặt theo tên nhà toán học người Pháp Siméon Denis Poisson, phân phối xác suất này giúp phân tích và dự đoán các sự kiện hiếm, nhờ đó có giá trị đối với những người làm dữ liệu trong nhiều lĩnh vực.
Nếu bạn mới làm quen với thống kê, khóa học Giới thiệu về Thống kê của chúng tôi cung cấp nền tảng vững chắc để nắm bắt các khái niệm này. Với những ai sẵn sàng thực sự học lý thuyết xác suất, khóa học Nền tảng Xác suất trong Python mang đến cái nhìn toàn diện về các khái niệm xác suất, bao gồm cả phân phối Poisson.
Phân phối Poisson là phân phối xác suất rời rạc biểu thị xác suất một số lượng sự kiện nhất định xảy ra trong một khoảng thời gian hoặc không gian cố định. Nó giả định các sự kiện xảy ra với một tốc độ trung bình đã biết và độc lập với thời điểm kể từ lần xảy ra gần nhất. Để hiểu phân phối Poisson, trước hết hữu ích khi phân biệt giữa các phân phối rời rạc và liên tục.
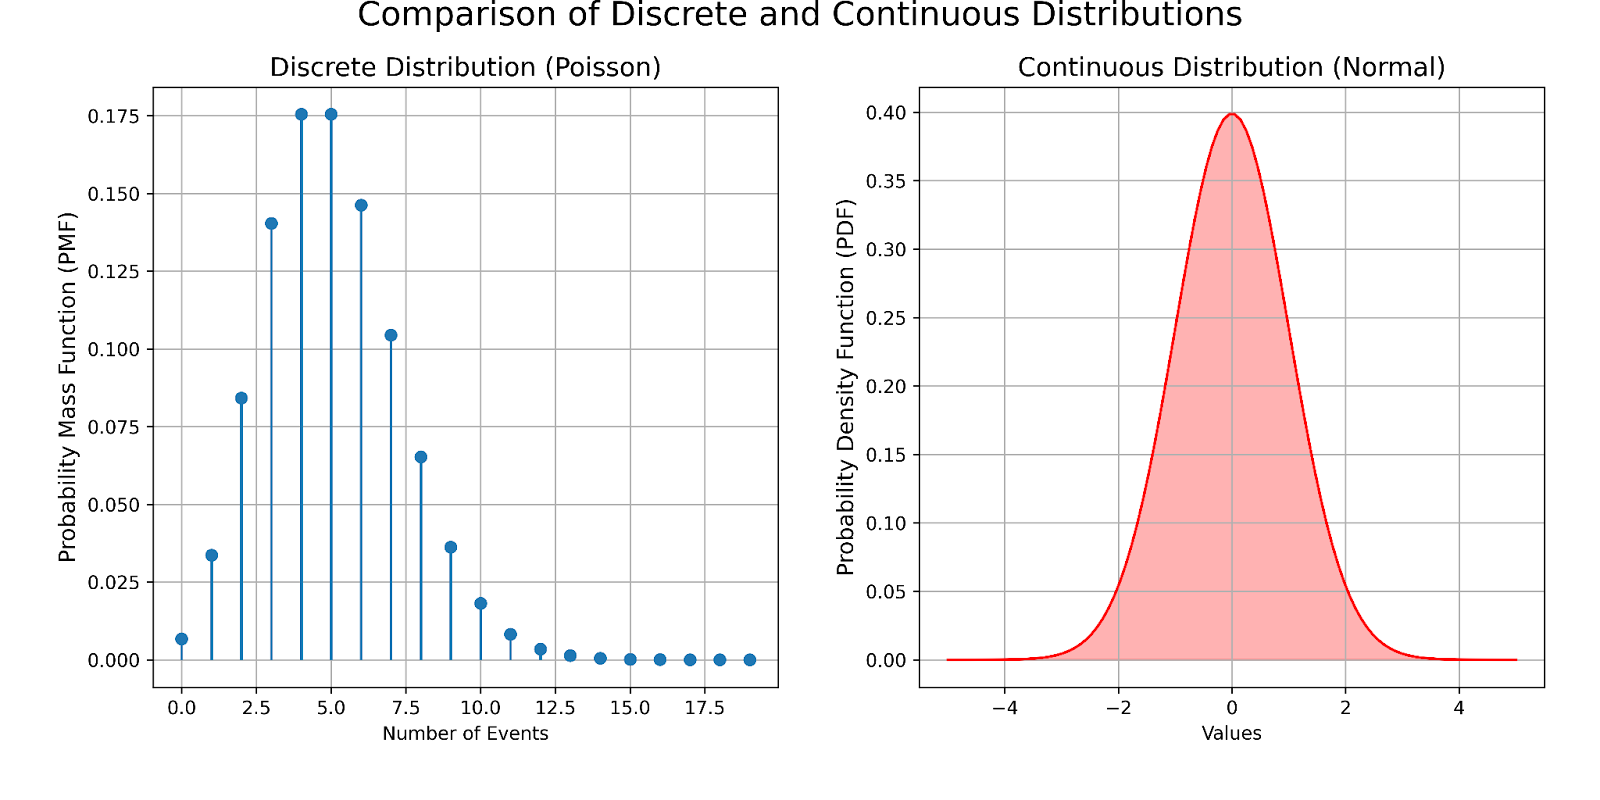
Phân phối Poisson so với một phân phối liên tục. Hình minh họa bởi Tác giả
Một số ví dụ về phân phối xác suất rời rạc bao gồm các phân phối Bernoulli và nhị thức.
Phân phối chuẩn, hay Gaussian, là ví dụ điển hình của phân phối liên tục.
Hãy xem một số đặc điểm quan trọng của phân phối Poisson.
Đặc trưng then chốt của phân phối Poisson là khả năng mô hình hóa các sự kiện trong một khoảng cố định. Khoảng này có thể là thời gian (ví dụ, số khách hàng đến mỗi giờ) hoặc không gian (ví dụ, số lỗi trên mỗi mét vuông vải). Mô hình giả định:
Một trong những tính chất nổi bật nhất của phân phối Poisson là kỳ vọng (giá trị kỳ vọng) bằng với phương sai. Cả hai đều được biểu diễn bởi tham số λ (lambda), biểu thị số sự kiện trung bình trong khoảng. Tính chất này là độc nhất và giúp xác định liệu một tập dữ liệu có tuân theo phân phối Poisson hay không. Về mặt toán học, có thể biểu diễn bằng phương trình sau:
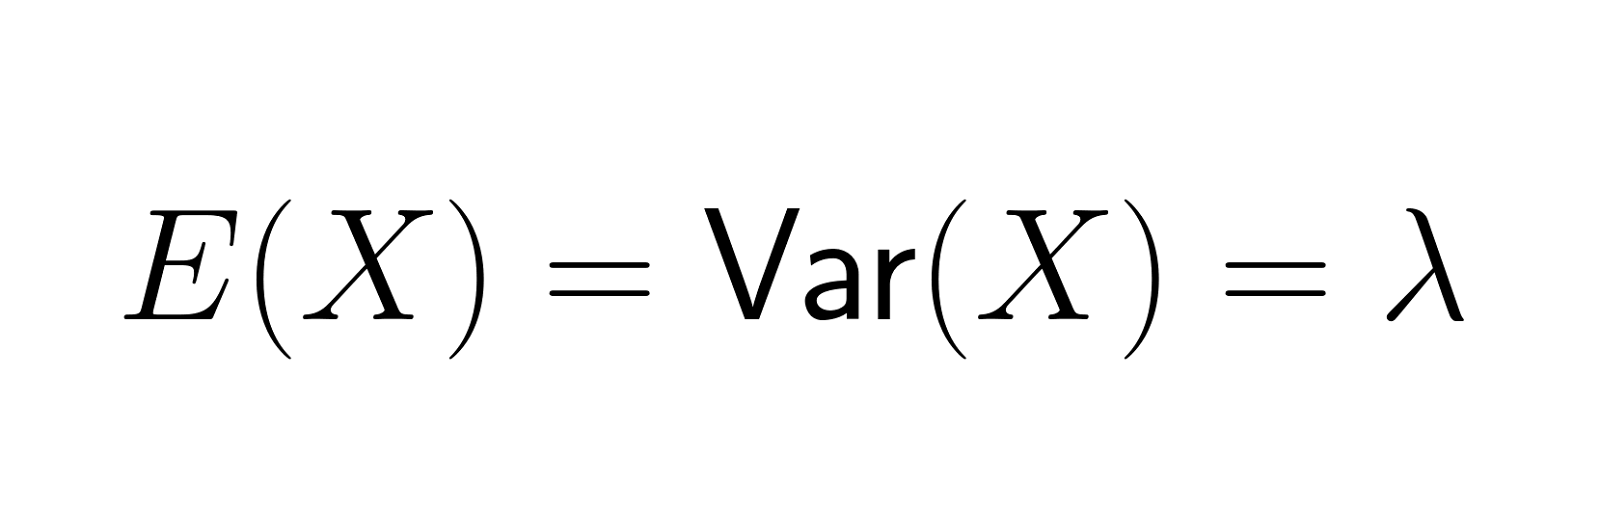
Sự bằng nhau này ngụ ý rằng khi số sự kiện kỳ vọng tăng thì độ biến thiên của số lần xảy ra thực tế cũng tăng theo.
Hình dạng của phân phối Poisson thay đổi theo giá trị của λ. Hình minh họa sau cho thấy λ ảnh hưởng đến độ lệch và tính đối xứng của phân phối như thế nào:
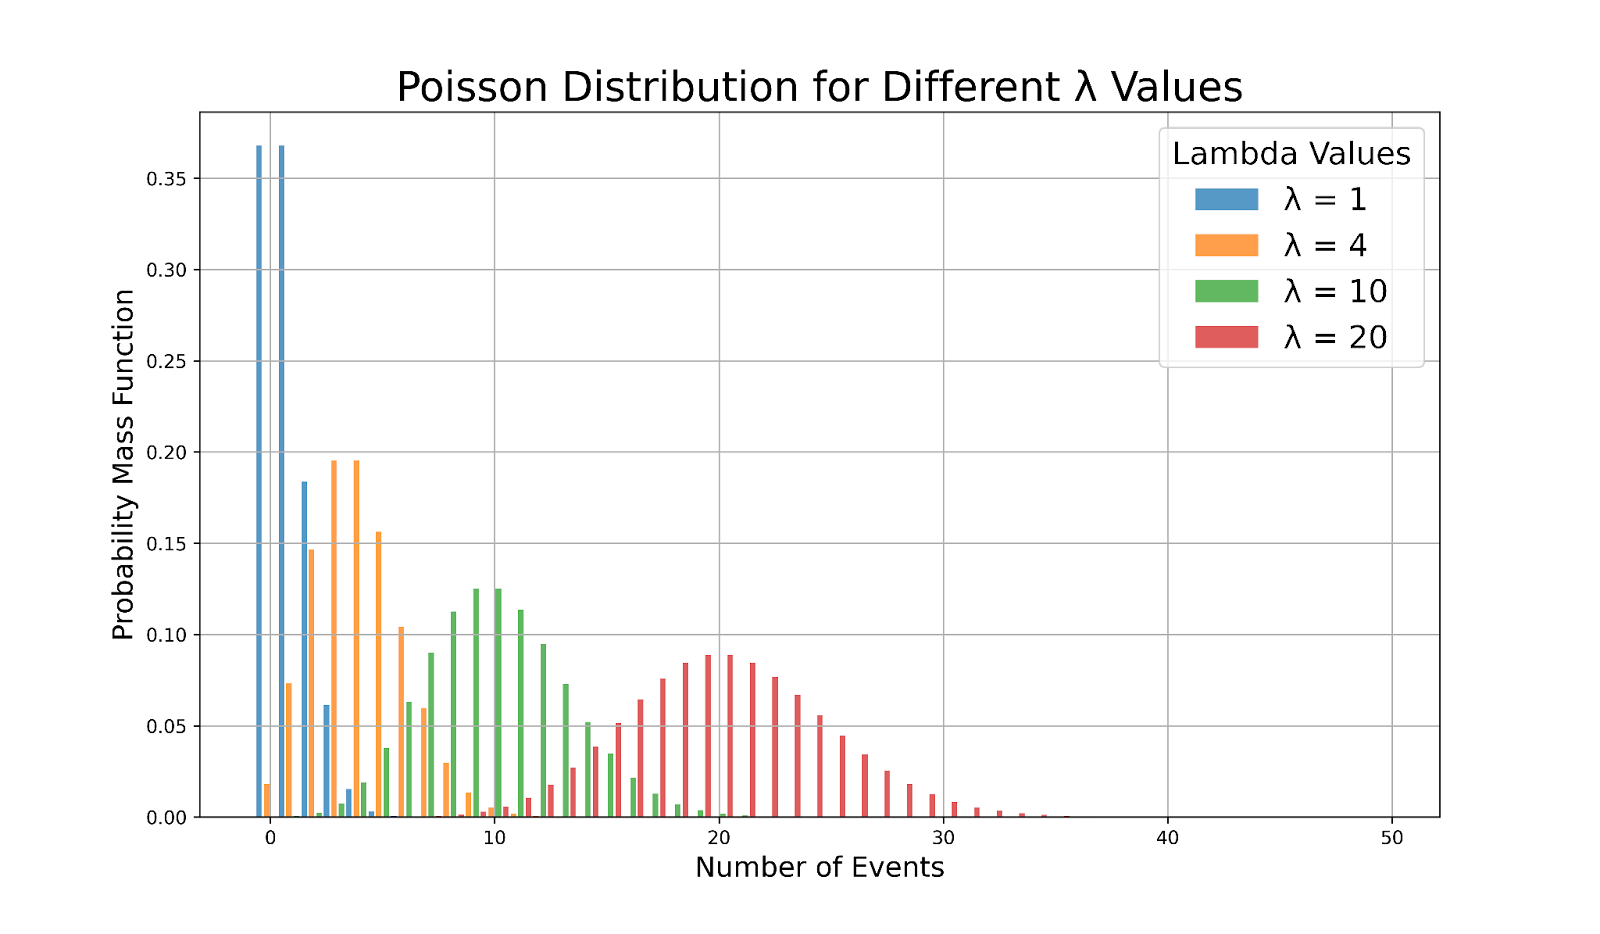
Các phân phối Poisson với các giá trị lambda khác nhau. Hình minh họa bởi Tác giả
Sự thay đổi hình dạng này ảnh hưởng đến cách chúng ta diễn giải xác suất và suy luận từ dữ liệu có phân phối Poisson. Chẳng hạn, một phân phối đối xứng giúp đơn giản hóa nhiều dạng phân tích như kiểm định giả thuyết và ước lượng khoảng tin cậy, vì phân phối dữ liệu có tính dự đoán và cân bằng hơn.
Hãy xem công thức của phân phối Poisson.
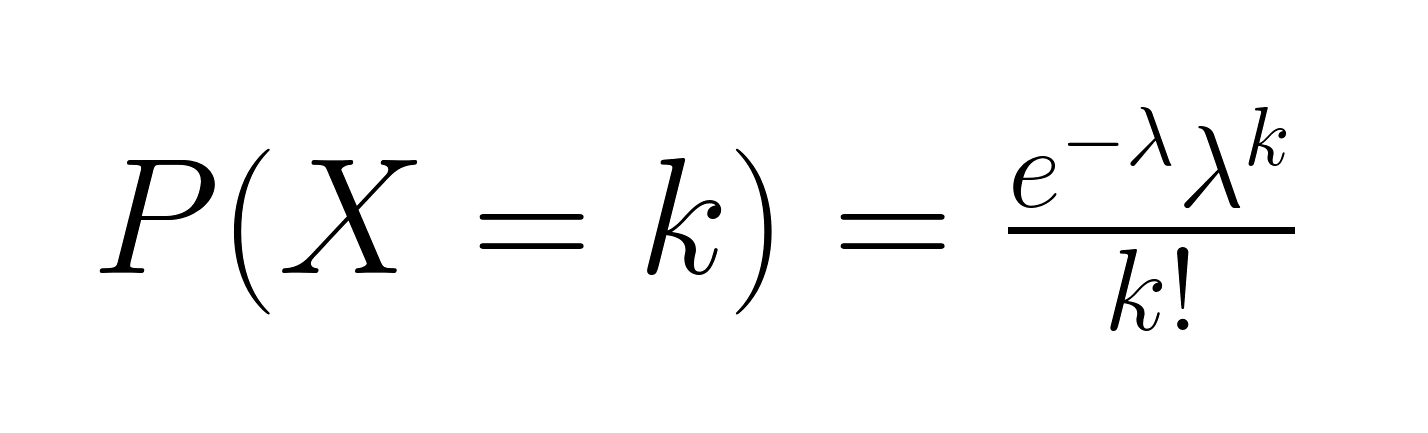
Vế trái (LHS) của công thức phân phối Poisson, P(X = k), biểu thị xác suất chính xác k sự kiện xảy ra trong một khoảng cố định. Ở đây, X là số sự kiện và k là con số cụ thể ta quan tâm. Nói cách khác, vế trái cho biết xác suất nào đang được tính.
Tử số ở vế phải (RHS), e-λλk gồm hai phần. λk cho thấy mức độ khả dĩ để k sự kiện xảy ra dựa trên tốc độ trung bình λ. Hạng tử e-λ tính đến tính ngẫu nhiên của các sự kiện, đảm bảo xác suất giảm khi số sự kiện lệch khỏi tốc độ kỳ vọng.
Mẫu số ở vế phải (RHS), k! điều chỉnh theo số cách mà x sự kiện có thể xảy ra. Ký hiệu giai thừa tính số sắp xếp có thể, đảm bảo xác suất phản ánh thực tế là thứ tự xảy ra không quan trọng.
Nếu bạn thực sự muốn tự tin sử dụng Python cho machine learning, hãy bắt đầu lộ trình nghề nghiệp Nhà khoa học Machine Learning với Python, nơi bạn được luyện tập các kỹ thuật nâng cao với bộ dữ liệu thực.
Hãy xem một số ứng dụng thực tế của phân phối Poisson. Nếu bạn quan tâm đến hoạch định năng lực và tối ưu hóa hiệu năng, khóa học Mô hình Hỗn hợp trong R của chúng tôi đề cập đến các ứng dụng nâng cao của các phân phối xác suất, bao gồm cả hỗn hợp Poisson.
Trong lý thuyết hàng chờ, phân phối Poisson mô hình hóa lượng khách hàng đến các điểm dịch vụ. Ví dụ, một ngân hàng có thể dùng phân phối này để dự đoán có bao nhiêu khách sẽ đến trong một giờ, giúp tối ưu hóa nhân sự và giảm thời gian chờ.
Các nhà dịch tễ học thường sử dụng phân phối Poisson để mô hình hóa sự xuất hiện của các bệnh hiếm. Ứng dụng này giúp ước lượng số ca kỳ vọng trong một quần thể, hoặc phát hiện các đợt bùng phát bất thường bằng cách so sánh số ca quan sát được với phân phối Poisson kỳ vọng. Nếu bạn quan tâm đến dịch tễ học, bạn có thể nghe tập podcast Khoa học Dữ liệu, Dịch tễ học và Y tế Công cộng với Maëlle Salmon.
Kỹ sư giao thông và nhà phân tích mạng sử dụng phân phối Poisson để mô hình hóa số phương tiện đi qua một trạm kiểm, số gói dữ liệu đến máy chủ, hoặc số cuộc gọi đến tổng đài.
Khi làm việc với phân phối Poisson, điều cốt yếu là cân nhắc các yếu tố liên quan đến hiệu năng, những ngộ nhận phổ biến và các mô hình thay thế để đảm bảo kết quả chính xác. Có vài khía cạnh đáng để khám phá:
Nhiều yếu tố ảnh hưởng đến hiệu quả mô hình hóa phân phối Poisson, đặc biệt khi xử lý các trường hợp cực đoan:
Hiểu sai các yếu tố then chốt có thể dẫn đến mô hình sai lệch:
Trong một số trường hợp, các phân phối thay thế có thể đem lại kết quả tốt hơn:
Hiểu phân phối Poisson giúp nâng cao đáng kể phân tích thống kê và diễn giải dữ liệu, đặc biệt khi phân tích các sự kiện hiếm hoặc dữ liệu đếm. Bằng cách nắm rõ các tính chất, ứng dụng và giới hạn của nó, những người làm dữ liệu có thể cải thiện quá trình ra quyết định và xây dựng mô hình chính xác hơn.
Khi bạn tiến xa hơn trong khoa học dữ liệu, hãy cân nhắc mở rộng kiến thức về các khái niệm thống kê và ứng dụng thực tiễn của chúng. Với những ai làm việc với R, khóa học Giới thiệu về Thống kê trong R và lộ trình kỹ năng Nền tảng Thống kê với R cung cấp cái nhìn tổng quan toàn diện về các nguyên lý thống kê chủ chốt, bao gồm thực hành với các phân phối như Poisson. Với những ai thích làm việc với Python, khóa học Giới thiệu về Thống kê trong Python của chúng tôi mang đến trải nghiệm thực hành triển khai các khái niệm thống kê, bao gồm tối ưu hóa hiệu năng. Tiếp tục rèn luyện kỹ năng thống kê sẽ giúp bạn giải quyết các thách thức dữ liệu phức tạp và rút ra những hiểu biết có ý nghĩa trong công việc.
Vinod Chugani bắt đầu sự nghiệp tại Tokyo với vai trò Trưởng bàn giao dịch bán hàng Quỹ phòng hộ trẻ nhất của JPMorgan, sau đó lập kỷ lục doanh số cá nhân tại Lehman Brothers, rồi xây dựng một doanh nghiệp phân phối điện tử tại 30 quốc gia vượt mốc doanh thu 100 triệu đô la Singapore trước khi chuyển hướng sang dữ liệu. Tốt nghiệp Kinh tế Duke và là cựu học viên NYC Data Science Academy, anh là một trong ba người nhận học bổng trong hơn 100 ứng viên cho khóa học Building AI Applications của Hugo Bowne-Anderson trên Maven. Hiện nay, anh viết cho DataCamp, KDnuggets, Machine Learning Mastery và Statology về các chủ đề từ thống kê đến AI hành động, và cố vấn cho các chuyên gia dữ liệu tại NYC Data Science Academy với hơn 1.000 buổi kèm 1-1 đã thực hiện.
Phân phối Poisson là một mô hình thống kê dự đoán một sự kiện hiếm có thể xảy ra bao nhiêu lần trong một khoảng thời gian hoặc khu vực xác định. Nó đặc biệt hữu ích khi xử lý các sự kiện xảy ra ngẫu nhiên nhưng với tốc độ trung bình có thể dự đoán. Phân phối này giúp chúng ta hiểu các khuôn mẫu trong những hiện tượng tưởng như ngẫu nhiên, từ số khách hàng đến cửa hàng trong một giờ đến số vụ thiên thạch va chạm trên bề mặt một hành tinh trong một thế kỷ.
Bạn nên dùng phân phối Poisson khi mô hình hóa các kịch bản mà sự kiện xảy ra ngẫu nhiên và độc lập với tốc độ không đổi trong một khoảng cho trước, như số email nhận được trong một giờ hoặc số cuộc gọi tại tổng đài trong một ca làm việc.
Phân phối Poisson được dùng cho dữ liệu đếm rời rạc với số sự kiện có thể nhỏ, trong khi phân phối chuẩn thường mô hình hóa dữ liệu liên tục và trở thành xấp xỉ tốt cho Poisson khi tốc độ sự kiện (λ) lớn.
Phân phối Poisson đếm số sự kiện trong một khoảng cố định, trong khi phân phối mũ đo thời gian giữa các sự kiện liên tiếp trong một quá trình Poisson. Chúng có liên hệ toán học với nhau — biết tốc độ xảy ra trong Poisson giúp xác định thang đo của phân phối mũ.
Không. Phân phối Poisson đặc biệt hữu ích để mô hình hóa số lượng sự kiện rời rạc xảy ra độc lập trong một khoảng hoặc vùng cố định, và giả định tốc độ trung bình không đổi. Nó không phù hợp cho dữ liệu mà các sự kiện ảnh hưởng lẫn nhau hoặc xảy ra với tốc độ không cố định.
Trong phân phối Poisson, λ (lambda) biểu thị số sự kiện kỳ vọng trong khoảng. Nó đồng thời là trung bình và phương sai của phân phối.
Để tạo phân phối Poisson trong Python, bạn chủ yếu dùng mô-đun random của thư viện NumPy. Hàm np.random.poisson() sinh mẫu ngẫu nhiên từ phân phối Poisson, nơi bạn chỉ định tốc độ trung bình (lambda) và số lượng mẫu muốn lấy. Sau đó, bạn có thể dùng các mẫu này để vẽ biểu đồ tần suất, tính xác suất hoặc thực hiện phân tích thống kê. Để tính xác suất chính xác hơn, mô-đun stats của thư viện SciPy cung cấp các hàm như stats.poisson.pmf() cho hàm khối xác suất và stats.poisson.cdf() cho hàm phân phối tích lũy.
Để tạo phân phối Poisson trong R, bạn có thể sử dụng các hàm tích hợp trong gói thống kê cơ bản của R. R cung cấp các hàm để sinh số ngẫu nhiên, tính xác suất và vẽ phân phối Poisson. Các hàm chính gồm rpois() để sinh số ngẫu nhiên, dpois() cho mật độ xác suất, ppois() cho xác suất tích lũy và qpois() cho các phân vị. Bạn có thể dùng các hàm này cùng khả năng vẽ của R để tạo và trực quan hóa phân phối Poisson.
Trong khi phân phối Poisson mô tả xác suất số lượng sự kiện xảy ra trong một khoảng cố định, hồi quy Poisson là phương pháp thống kê dùng để mô hình hóa dữ liệu đếm và hiểu cách các biến khác nhau ảnh hưởng đến các số đếm này. Trong hồi quy Poisson, biến phản hồi được giả định tuân theo phân phối Poisson, và logarit của giá trị kỳ vọng của nó được mô hình hóa như một tổ hợp tuyến tính của các biến dự báo. Mối quan hệ này cho phép các nhà nghiên cứu phân tích cách các yếu tố tác động đến tốc độ xảy ra sự kiện.
Học cùng DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
