
Khóa học
Giới thiệu trực quan dữ liệu với Seaborn
4 giờ
185.4K
Trực quan hóa dữ liệu là thành phần then chốt để diễn giải các bộ dữ liệu phức tạp.
Trong thế giới lập trình Python, Seaborn nổi bật như một thư viện mạnh mẽ để tạo ra các đồ họa thống kê trực quan và giàu thông tin như histogram và biểu đồ đường.
Seaborn xây dựng trên khả năng của Matplotlib, cải thiện giao diện và cung cấp nhiều lựa chọn hơn để trực quan hóa dữ liệu, đặc biệt phục vụ phân tích thống kê. Khả năng tích hợp mượt mà với Pandas DataFrame khiến Seaborn trở thành lựa chọn ưa thích của các nhà khoa học dữ liệu và nhà phân tích.
Trong hướng dẫn chi tiết này, chúng ta sẽ tập trung vào một trong những biểu đồ được dùng phổ biến nhất trong Seaborn—histogram.
sns.histplotHàm sns.histplot trong Seaborn được thiết kế để vẽ histogram, vốn rất cần thiết để khảo sát phân phối của dữ liệu liên tục. Hàm này linh hoạt và hỗ trợ tùy biến sâu, giúp bạn rút ra được những insight có ý nghĩa từ dữ liệu dễ dàng hơn.
Đây là một trong nhiều hàm có sẵn từ thư viện Seaborn. Hãy xem tờ ghi chú dưới đây để có cái nhìn nhanh.
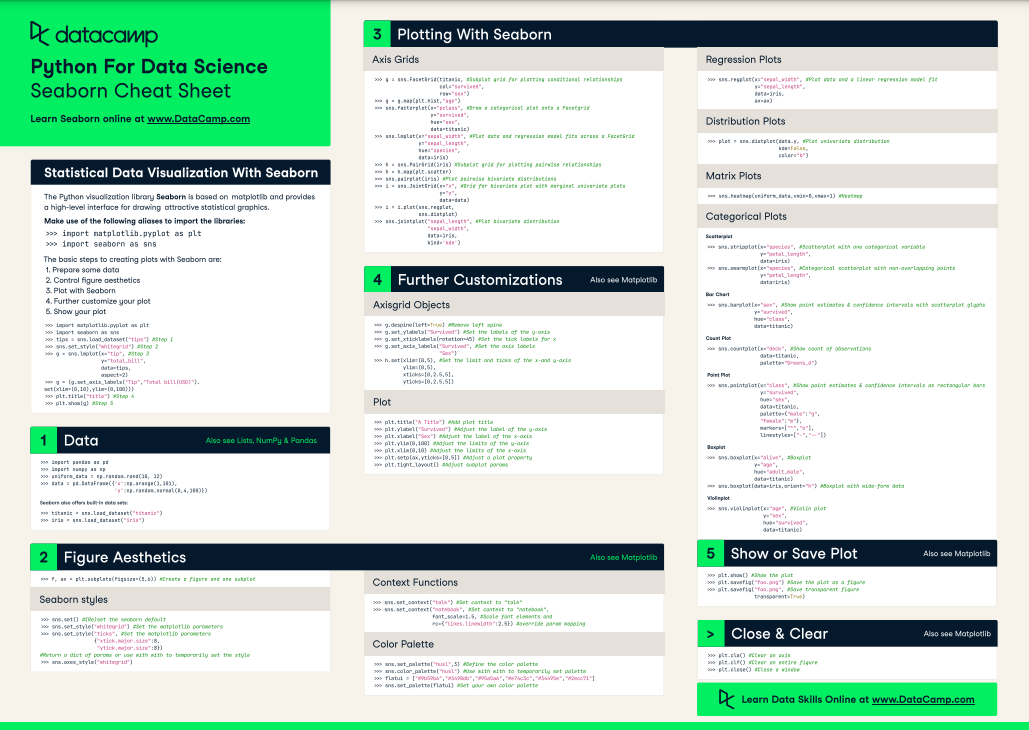
Seaborn cho khoa học dữ liệu - tờ ghi chú nhanh - nguồn
Trước khi đi vào trực quan hóa dữ liệu, chúng ta cần thiết lập môi trường. Việc này bao gồm import các thư viện cần thiết, trong đó Seaborn là trọng tâm. Thông thường, Seaborn được import với bí danh sns cho tiện.
Bên cạnh Seaborn, các thư viện thiết yếu khác thường gồm NumPy cho phép toán số học, pandas để xử lý dữ liệu và Matplotlib cho các tùy biến bổ sung.
import seaborn as sns
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
Đây đều là các thư viện thiết yếu cung cấp công cụ cần có để tạo và thao tác trực quan hóa dữ liệu trong Python. Chúng là những thư viện được sử dụng nhiều nhất đối với nhà phân tích và nhà khoa học dữ liệu.
Nếu bạn mới bắt đầu học Python, tôi gợi ý bạn thử khóa Introduction to Python của chúng tôi. Để học sâu hơn về pandas, NumPy và Matplotlib, hãy xem các khóa Data Manipulation with pandas, Introduction to NumPy và Introduction to Data Visualization with Matplotlib.
Chúng ta sẽ dùng bộ dữ liệu Giá nhà Boston, có thể nạp từ thư viện Scikit-Learn. Bộ dữ liệu này cung cấp giá trị nhà ở các khu vực khác nhau của Boston cùng nhiều thuộc tính như tỷ lệ tội phạm, số phòng trung bình, v.v.
from sklearn.datasets import load_boston
boston = load_boston()
df = pd.DataFrame(boston.data, columns=boston.feature_names)
df['MEDV'] = boston.target
Việc có dữ liệu phù hợp cho histogram chính là yếu tố quyết định chất lượng biểu đồ. Ở đây, chúng ta dùng một biến liên tục: giá trị trung vị của nhà do chủ sở hữu ở (MEDV) tại Boston.
Vì histogram thường thể hiện phân phối của một biến duy nhất, chúng ta sẽ chọn một cột từ DataFrame.
Mới làm quen với Scikit-Learn? Hãy thử hướng dẫn về Machine Learning với Python của chúng tôi. Nếu bạn muốn biết thêm, khóa Supervised Learning with scikit-learn sẽ giúp bạn nắm các kiến thức nền tảng.
Trước khi bắt đầu, dưới đây là một vài điều kiện tiên quyết cơ bản để xây dựng histogram với Seaborn:
Chúng ta sẽ bắt đầu bằng cách đi qua một số cú pháp và tham số thường gặp của hàm `sns.histplot`.
Cú pháp cơ bản để tạo một histogram bằng `sns.histplot` khá trực quan.
Các tham số chính gồm:
data: Tập dữ liệu, thường là một Pandas DataFrame.x: Biến dùng để vẽ histogram.color: Chỉ định màu các cột.alpha: Độ trong suốt của các cột.bins: Số lượng thùng (nhóm cột) sử dụng.binwidth: Độ rộng của mỗi thùng.kde: Boolean để thêm biểu đồ ước lượng mật độ hạt nhân (Kernel Density Estimate).hue: Phân biệt các tập con dữ liệu dựa trên một biến khác.Hàm này nhận rất nhiều tham số và đối số, nhưng chúng ta sẽ tập trung vào những tham số cần cho bộ dữ liệu của mình.
Hãy tạo một histogram cơ bản để trực quan hóa phân phối giá nhà trung vị (MEDV).
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Lệnh này sẽ hiển thị histogram cho cột MEDV.
Dưới đây là biểu đồ được tạo ra từ đoạn mã trên:
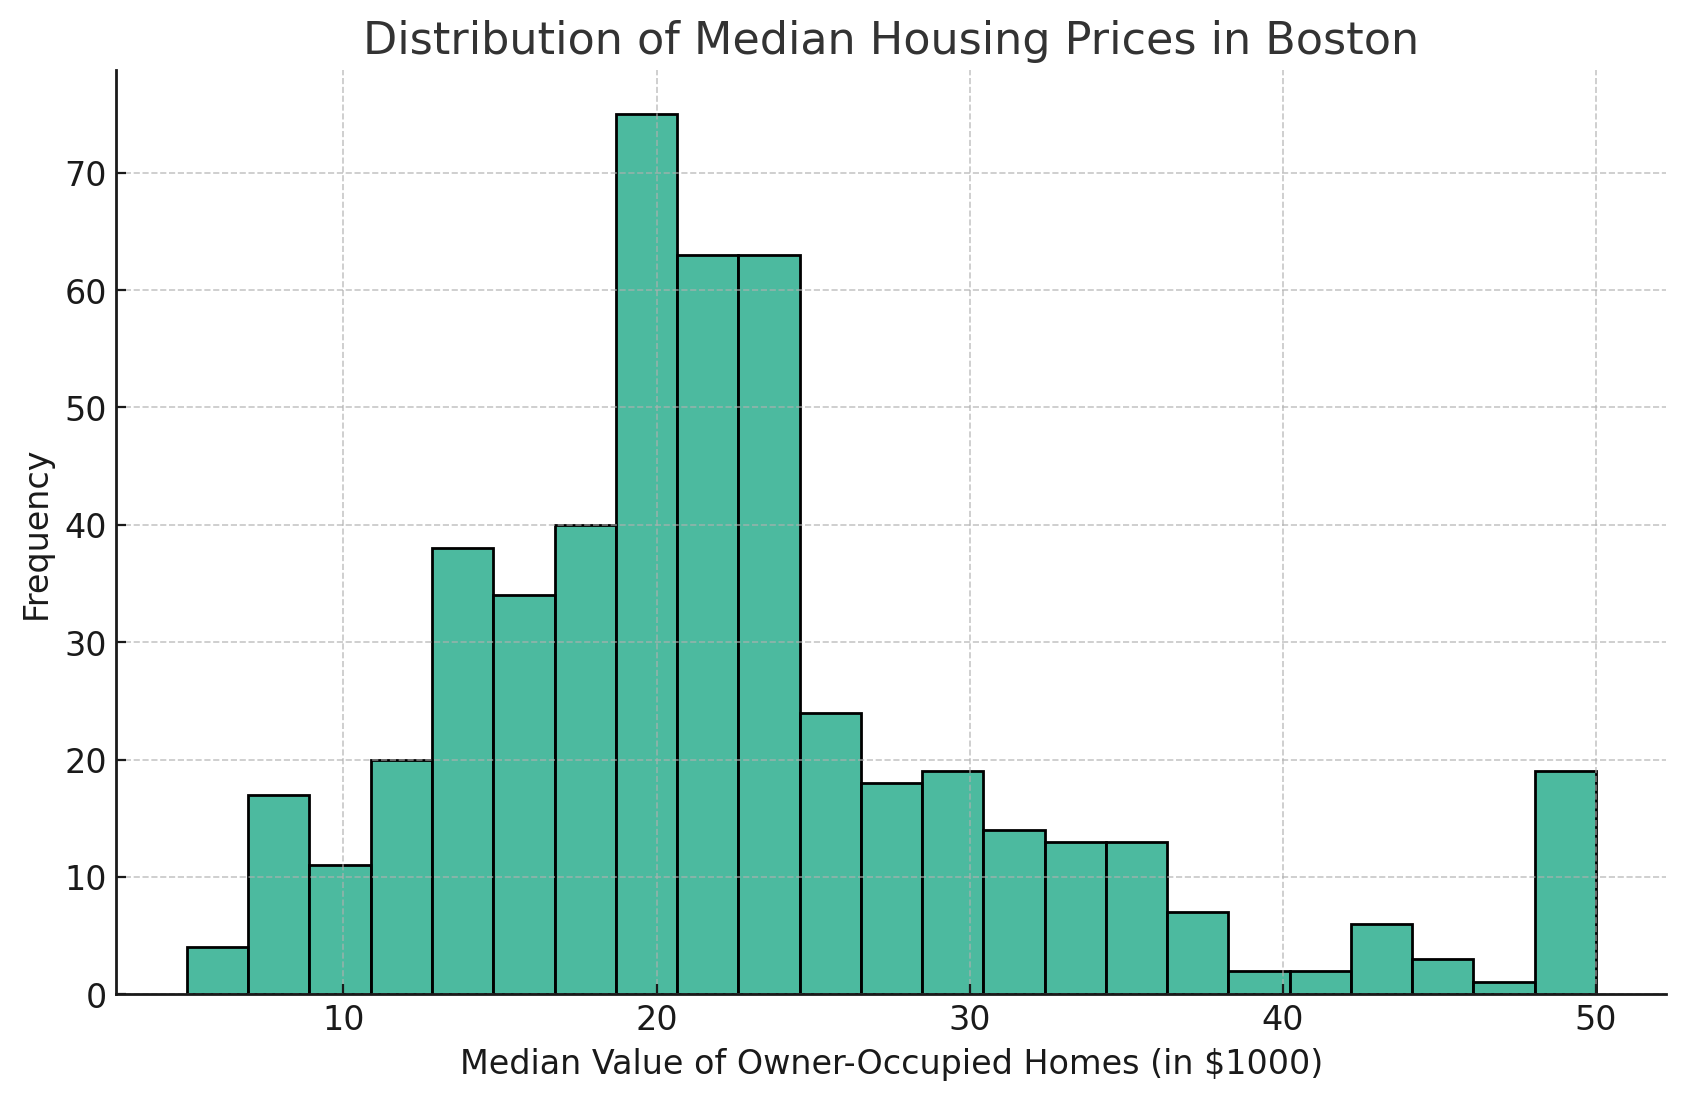
Đây là biểu đồ histogram thể hiện phân phối của giá nhà trung vị (MEDV) trong bộ dữ liệu Boston. Histogram cung cấp biểu diễn trực quan về tần suất phân phối các giá trị trung vị của nhà do chủ sở hữu ở.
Điều chỉnh số lượng thùng có thể giúp hiểu rõ hơn về phân phối. Số thùng lớn hơn có thể bộc lộ nhiều chi tiết hơn, trong khi số thùng ít hơn giúp đơn giản hóa trực quan hóa.
Để tăng số thùng, bạn có thể thay đổi tham số bins.
Ví dụ:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', bins=30)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
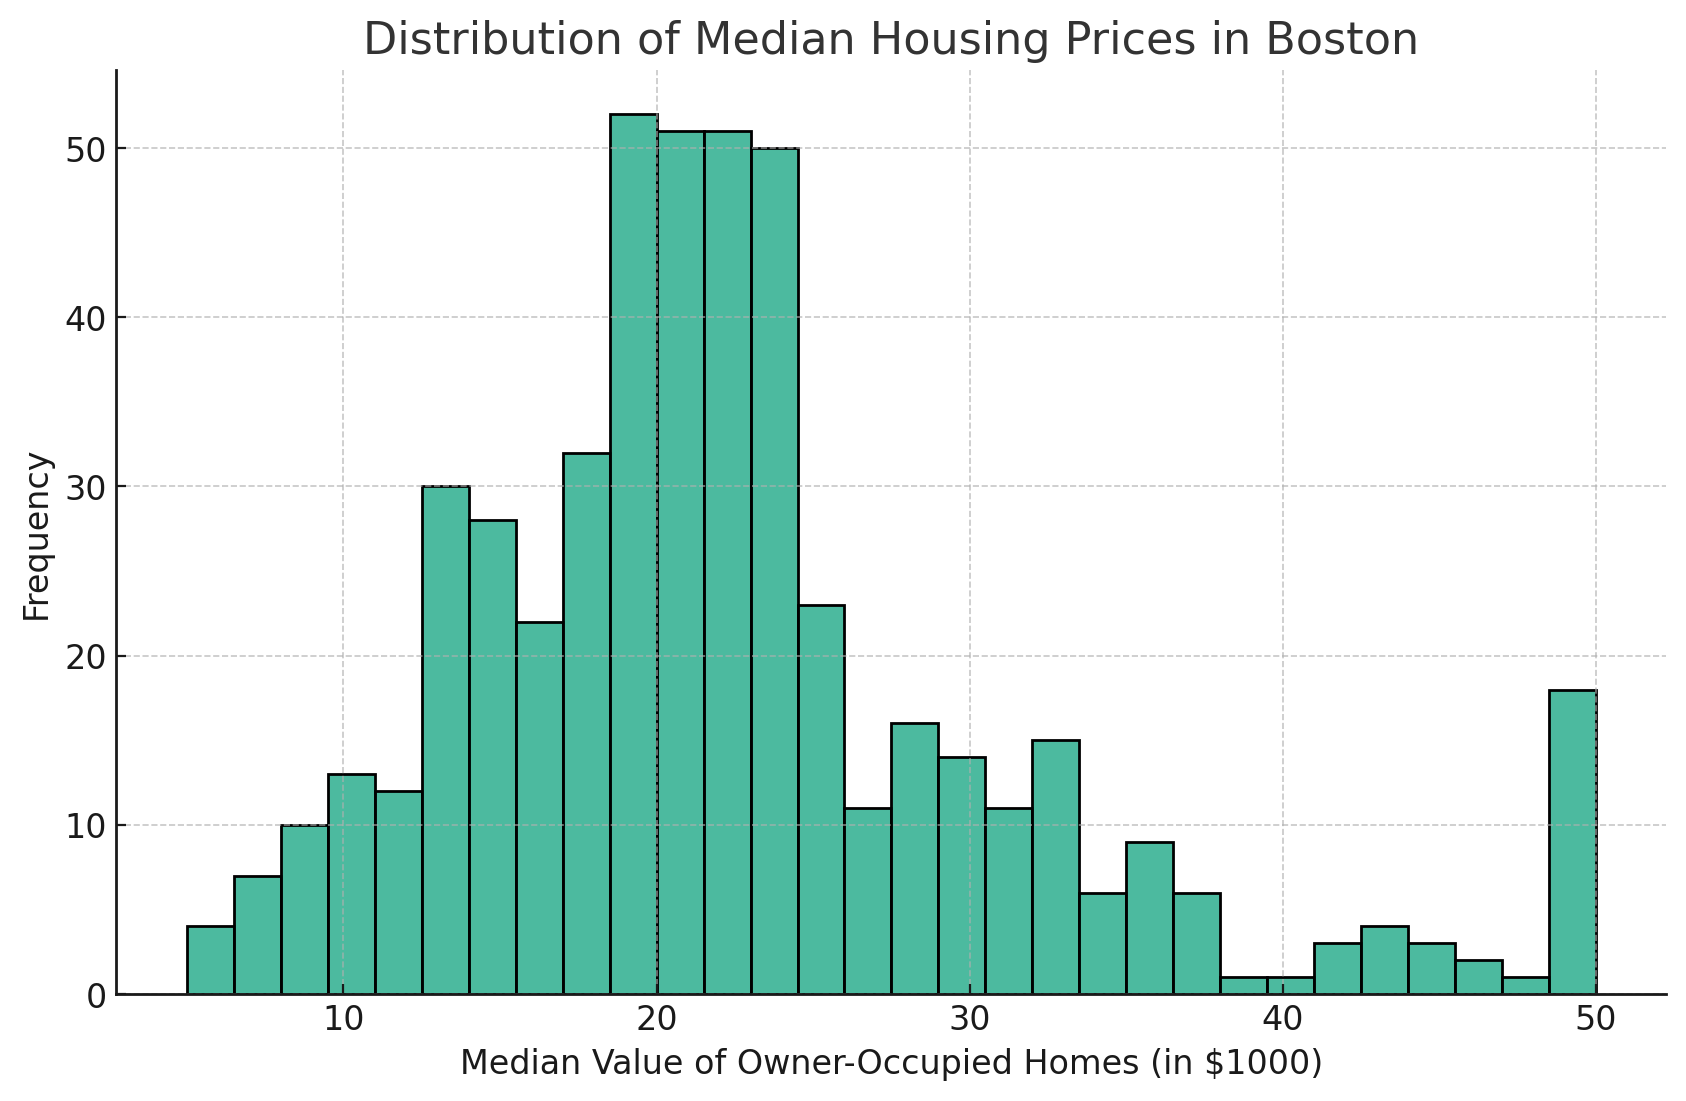
Như bạn có thể thấy từ histogram Seaborn ở trên, số lượng cột đã tăng lên theo giá trị tôi đặt, trong trường hợp này là 30. Đây là cách tốt để đi sâu vào chi tiết, tăng độ phân giải cho dữ liệu của bạn.
Tùy biến yếu tố thẩm mỹ, như đổi màu cột và độ trong suốt, có thể giúp histogram nhiều thông tin hơn và bắt mắt hơn.
Trong ví dụ dưới đây, tôi dựng lại histogram ban đầu với màu tím thay cho màu mặc định.
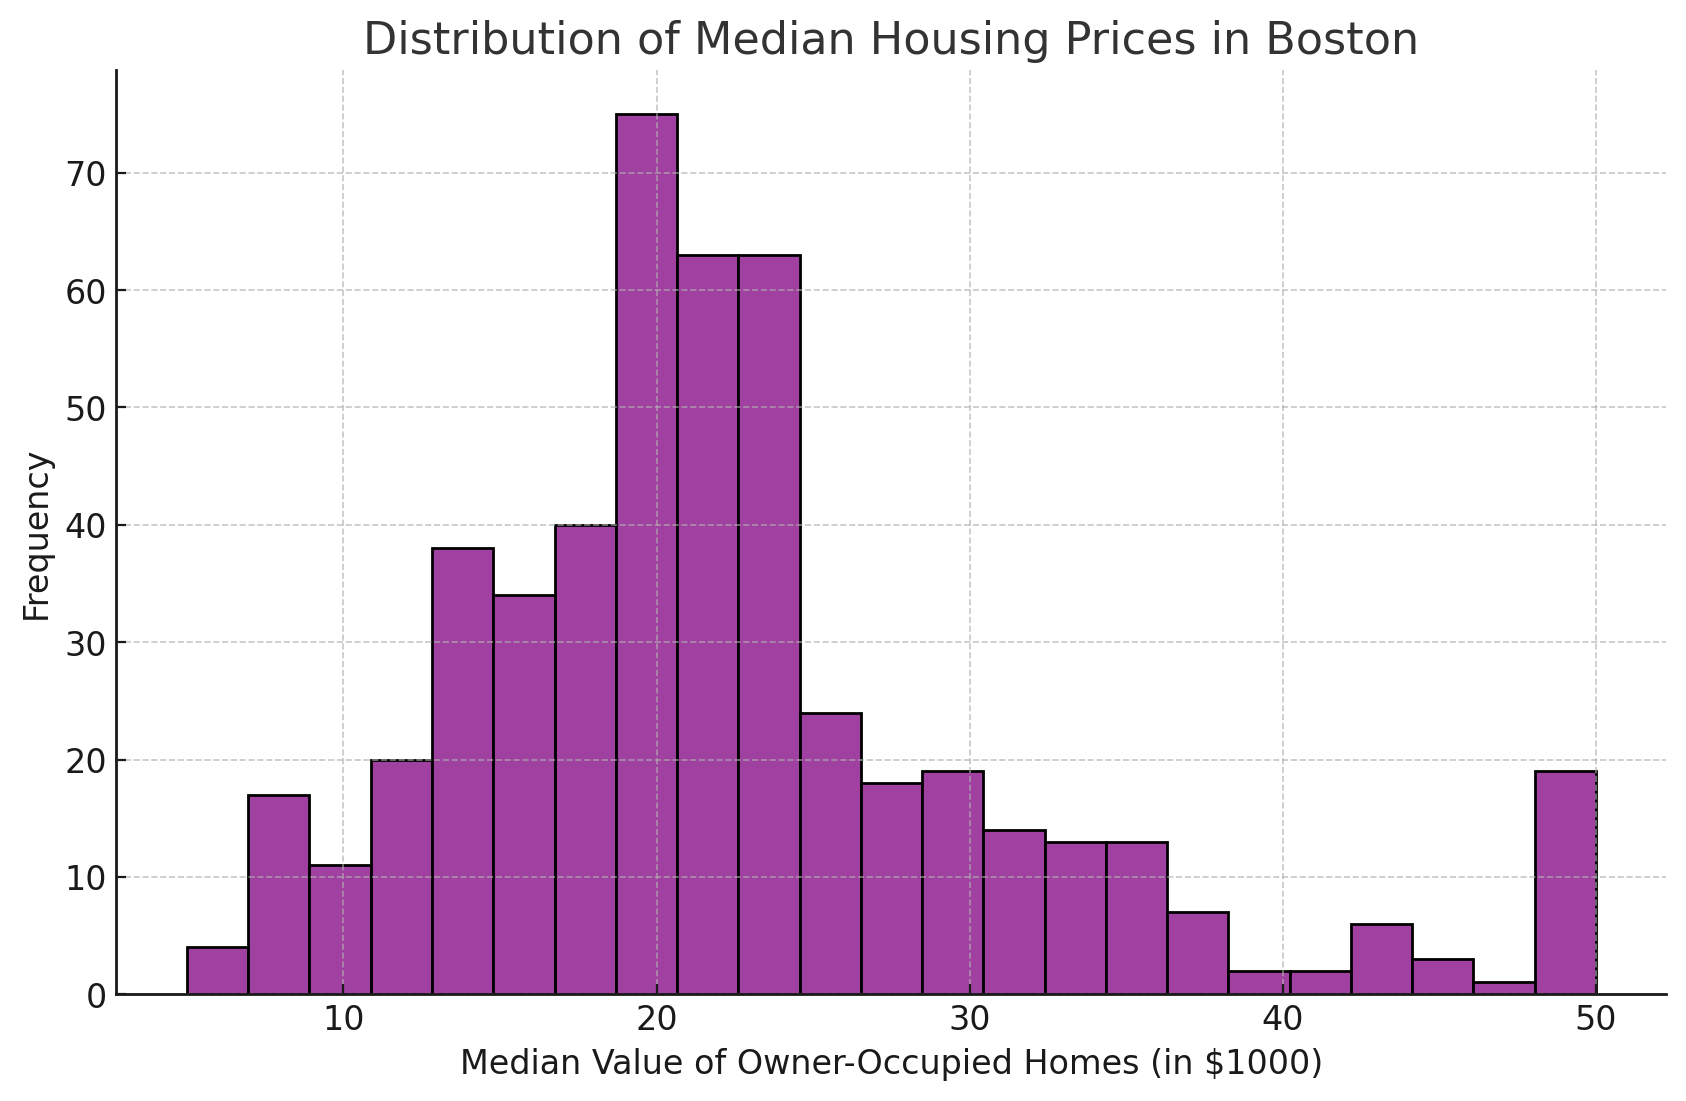
Đây là đoạn mã tôi dùng để tạo biểu đồ trên.
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', color='purple')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
KDE cung cấp ước lượng mượt mà cho phân phối dữ liệu. Nó đặc biệt hữu ích để phát hiện các mẫu trong dữ liệu.
Đường cong mượt này giúp hình dung xu hướng tổng thể.
Để làm điều này, chúng ta sử dụng tham số kde trong hàm:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', kde=True)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Điều này sẽ tạo thêm một đường cong đẹp cho histogram, như hình dưới.
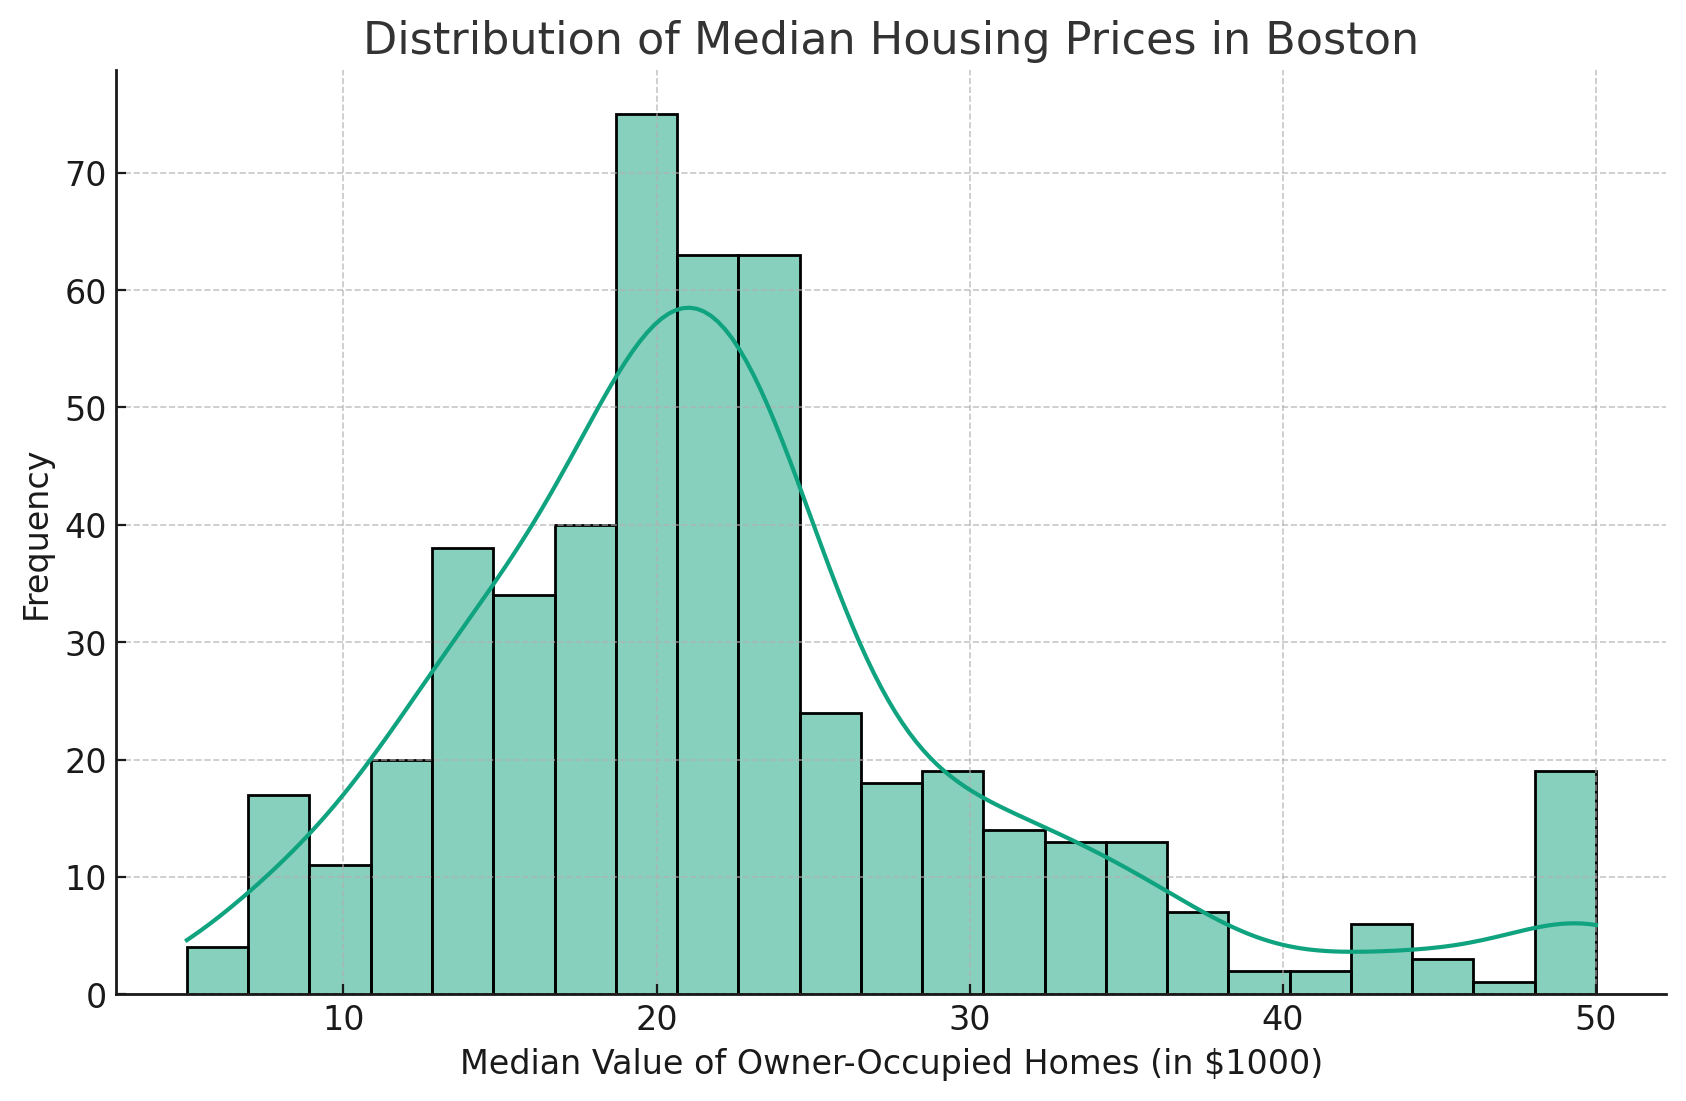
Việc thêm đường KDE mang lại ước lượng mượt mà hơn về phân phối.
Tham số hue cho phép so sánh các danh mục khác nhau trong cùng một histogram.
Tham số này giúp chúng ta phân biệt các danh mục khác nhau trong cùng histogram, cung cấp phép so sánh trực quan giữa các phân phối.
Nói đơn giản, nó lấy một cột phân loại từ DataFrame và phân biệt dữ liệu bằng các màu khác nhau.
Ví dụ, nếu chúng ta có cột 'CHAS' trong DataFrame, chỉ ra căn nhà nằm dọc sông Charles (1) hay không (0), ta có thể dùng tham số 'hue' để so sánh phân phối giá nhà trung vị của các căn gần sông so với các căn không gần sông.
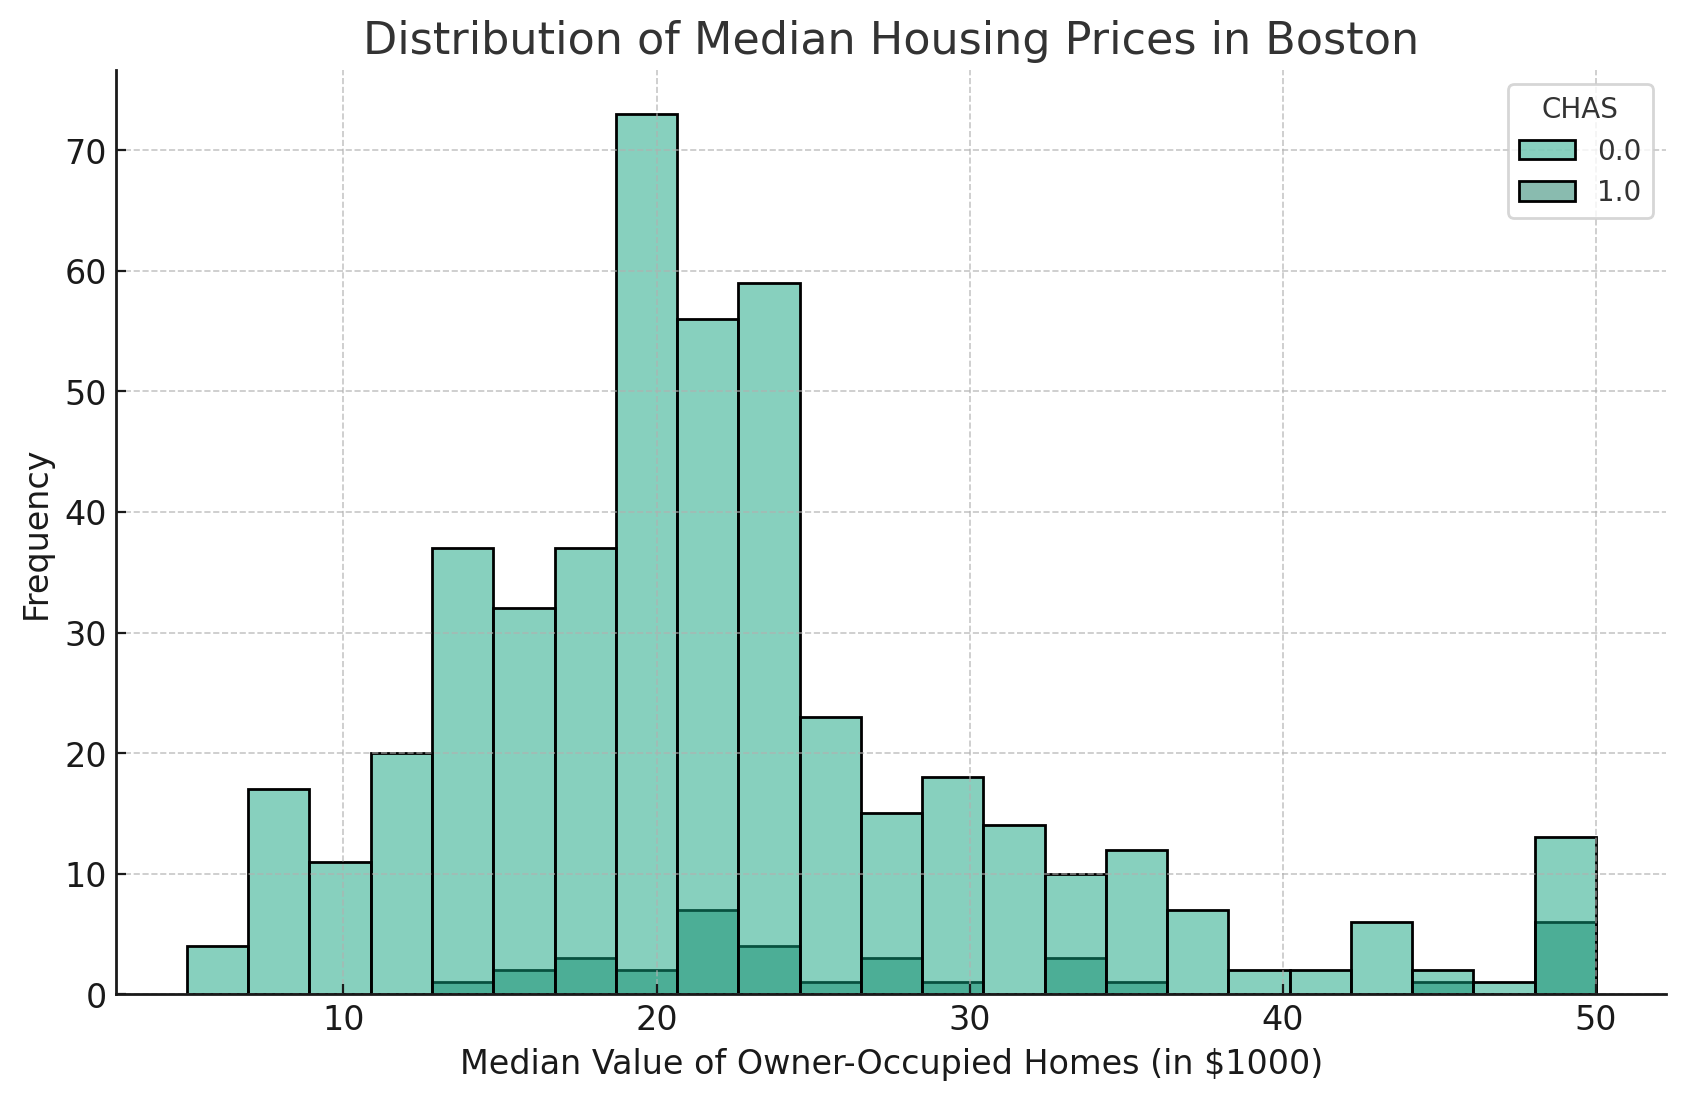
Mã sẽ như sau:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', hue='CHAS')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Điều này sẽ tạo ra một histogram trong đó phân phối của MEDV đối với các căn nhà giáp sông Charles (CHAS=1) được phân biệt với các căn không giáp sông (CHAS=0), mỗi nhóm được hiển thị bằng một màu khác nhau.
Khi xây dựng histogram bằng Seaborn, có một số khía cạnh cần lưu ý như dưới đây:
Chọn số lượng thùng tối ưu là chìa khóa để tạo histogram giàu thông tin. Mặc dù nhiều thùng hơn có thể cung cấp chi tiết hơn, nhưng cũng có thể dẫn đến quá khớp và thể hiện sai dữ liệu.
Ngược lại, quá ít thùng có thể làm quá đơn giản hóa phân phối.
Một cách để chọn số thùng phù hợp là dùng quy tắc kinh nghiệm gọi là Quy tắc Scott (Scott's Rule). Quy tắc này tính toán kích thước thùng lý tưởng dựa trên số lượng điểm dữ liệu trong bộ dữ liệu.
Dù quan trọng là cung cấp đủ chi tiết trong histogram, đảm bảo trực quan hóa vẫn rõ ràng và dễ diễn giải cũng rất quan trọng.
Thêm quá nhiều yếu tố, như đường KDE hoặc quá nhiều màu, có thể khiến biểu đồ rối và khó hiểu.
Tốt nhất là cân bằng giữa việc thêm các yếu tố hữu ích và giữ sự đơn giản.
Loại dữ liệu được trực quan hóa cũng ảnh hưởng đến việc chọn các tham số histogram phù hợp.
Ví dụ, các biến liên tục sẽ cần kích cỡ thùng khác so với biến phân loại.
Điều quan trọng là cân nhắc bản chất của dữ liệu khi tạo histogram để đảm bảo chúng đại diện chính xác cho phân phối.
Tuy nhiên, Seaborn chỉ là một trong số các thư viện trực quan hóa dữ liệu trong Python. Nếu bạn thích, bạn cũng có thể tạo histogram bằng Matplotlib.
Seaborn là một thư viện mạnh mẽ để tạo trực quan hóa trong Python, và hàm `histplot` cho phép tạo histogram một cách dễ dàng. Chỉ bằng cách thay đổi các tham số trong hàm, bạn có thể điều chỉnh diện mạo biểu đồ để đạt mức độ chi tiết và thẩm mỹ mong muốn.
Hãy ghi nhớ các mẹo về histogram Seaborn đã nêu: luôn cân nhắc loại dữ liệu, chọn kích thước thùng phù hợp và cân bằng giữa chi tiết và độ rõ khi tạo histogram với Seaborn.
Bạn muốn tìm hiểu thêm về Seaborn và các khả năng trực quan hóa dữ liệu mạnh mẽ khác? Khóa Introduction to Data Visualization with Seaborn của chúng tôi là lựa chọn tuyệt vời cho người mới bắt đầu.
Bắt đầu hành trình với Seaborn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
