
Last chance! 50% off DataCamp Premium
Sale ends in
Bạn đã bao giờ chạy t-test, nhận được một p-value rõ ràng, rồi chợt nhận ra mình chưa hề kiểm tra dữ liệu có phân phối chuẩn hay không?
Các phép kiểm định thống kê không cho bạn biết khi giả định của chúng bị vi phạm. Chúng chỉ trả về giá trị. Vấn đề là các kiểm định như t-test và ANOVA giả định dữ liệu của bạn tuân theo phân phối chuẩn. Nếu không phải vậy, bạn đang xây dựng kết luận trên nền tảng thiếu vững chắc.
Các kiểm định tính chuẩn giúp bạn xác minh giả định đó. Có cả phương pháp trực quan và thống kê để làm điều này, và biết nên dùng phương pháp nào - cũng như cách đọc kết quả - sẽ giúp bạn tự tin bảo vệ kết quả của mình.
Trong bài này, tôi sẽ hướng dẫn bạn các phương pháp trực quan và thống kê phổ biến nhất để kiểm tra tính chuẩn, chỉ bạn cách chạy chúng trong Python và R, và giải thích cần làm gì khi dữ liệu không vượt qua kiểm định.
Chắc hẳn bạn đã thấy đường cong hình chuông trước đây - nhưng đây là ý nghĩa thực tế của nó với dữ liệu của bạn.
Phân phối chuẩn là một mô hình trong đó hầu hết các giá trị tập trung quanh trung tâm, và càng ra xa hai phía thì số giá trị càng ít. Khi vẽ, bạn sẽ được một đường cong hình chuông đối xứng. Bên trái phản chiếu bên phải.
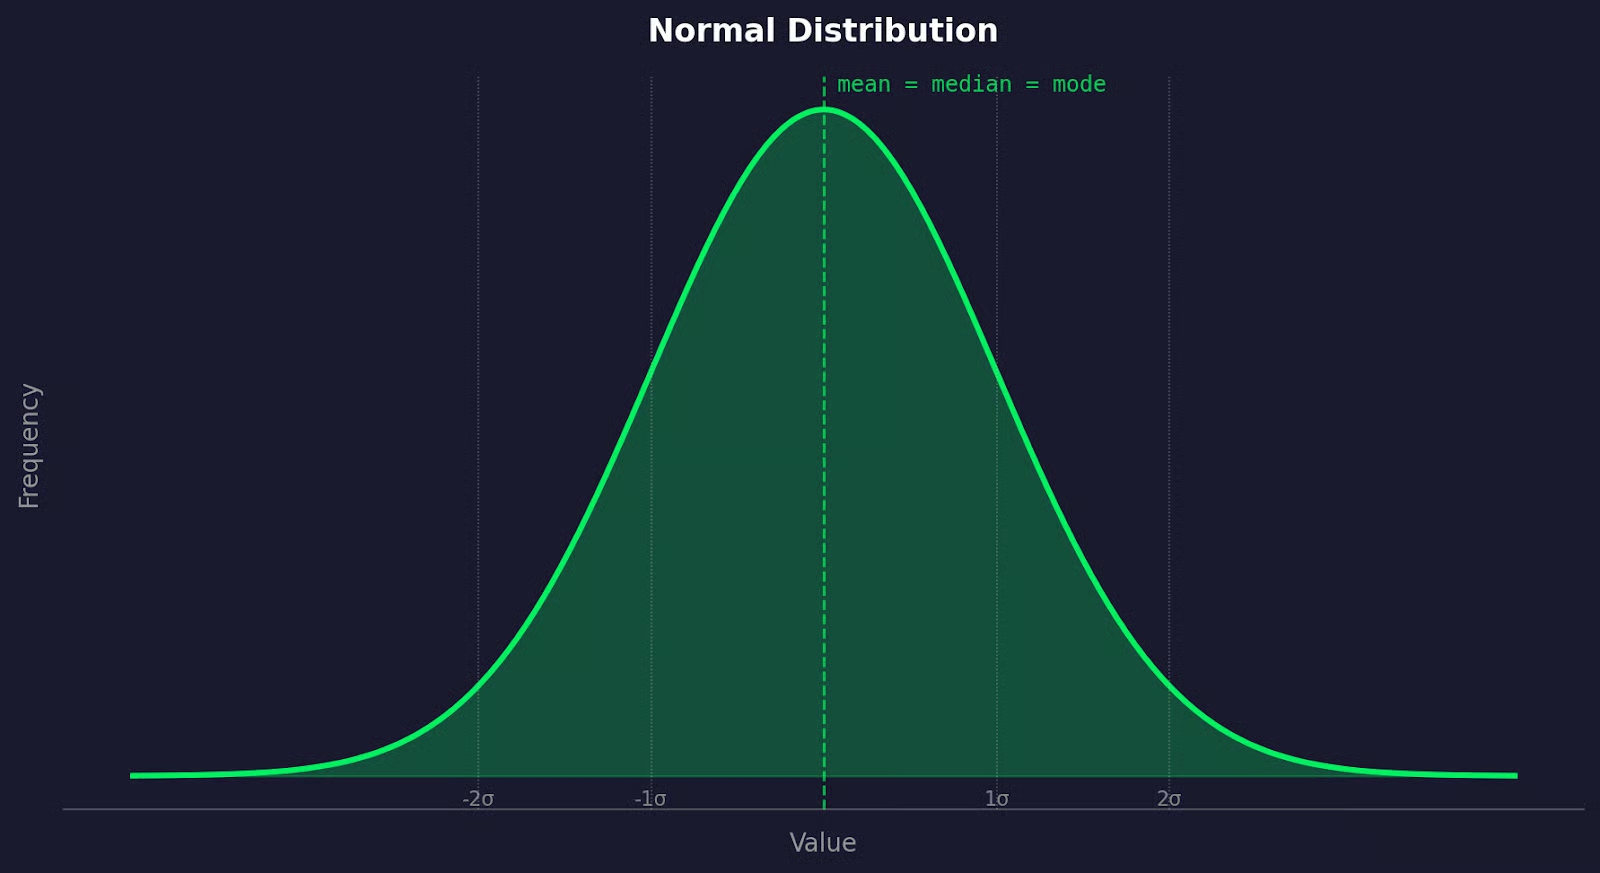
Biểu đồ phân phối chuẩn
Điểm độc đáo của phân phối chuẩn là trung bình, trung vị và mode đều trùng tại một điểm - chính giữa hình chuông. Không có độ lệch trái hay phải. Nói cách khác, dữ liệu cân bằng.
Điều này xuất hiện liên tục trong dữ liệu đo lường thực tế. Chiều cao con người, huyết áp, dung sai sản xuất, điểm kiểm tra - tất cả có xu hướng tuân theo phân phối chuẩn khi bạn thu thập đủ mẫu. Biến thiên tự nhiên trong các hệ thống sinh học và vật lý thường tạo ra hình dạng này.
Tuy vậy, không phải mọi dữ liệu đều như vậy. Thu nhập lệch phải. Thời gian phản hồi website có đuôi dài.
Trong thực tế, mọi thứ có thể sai lệch nghiêm trọng nếu bạn giả định tính chuẩn mà không kiểm tra.
Vấn đề khi không kiểm tra tính chuẩn là hầu hết các kiểm định thống kê phổ biến - t-test, ANOVA - đều là kiểm định tham số.
Tức là chúng được xây dựng dựa trên các giả định về phân phối của dữ liệu. Tính chuẩn là một trong số đó. Khi giả định này bị phá vỡ, phần toán học của kiểm định cũng bị ảnh hưởng. Bạn vẫn sẽ nhận được kết quả, nhưng có thể dẫn đến kết luận sai.
Kiểm định tham số hoạt động bằng cách đưa ra giả định toán học về tổng thể mà mẫu của bạn xuất phát. Khi các giả định đúng, các kiểm định này hữu ích và chính xác. Khi không, p-value trở nên kém tin cậy và bạn không thể đưa ra kết luận chính xác.
Đó là lúc kiểm định phi tham số phát huy tác dụng.
Các kiểm định như Mann-Whitney U hoặc Kruskal-Wallis không giả định tính chuẩn - chúng làm việc với thứ hạng thay vì giá trị thô. Chúng linh hoạt hơn, nhưng cũng kém hữu ích hơn khi dữ liệu của bạn chuẩn. Vì vậy chuyển sang chúng một cách không cần thiết không phải là lời giải.
Vấn đề thực sự mà nhiều người mới học khoa học dữ liệu mắc phải là bỏ qua bước kiểm tra này.
Kiểm tra tính chuẩn chỉ cần vài dòng code. Không kiểm tra đồng nghĩa bạn đang hoặc là tin tưởng mù quáng vào dữ liệu - hoặc không hề nghĩ về nó.
Trước khi chạy bất kỳ kiểm định chính thức nào, hãy vẽ dữ liệu của bạn. Hình ảnh sẽ cho bạn biết rất nhiều về thứ bạn đang xử lý.
Histogram cho bạn thấy hình dạng của phân phối.
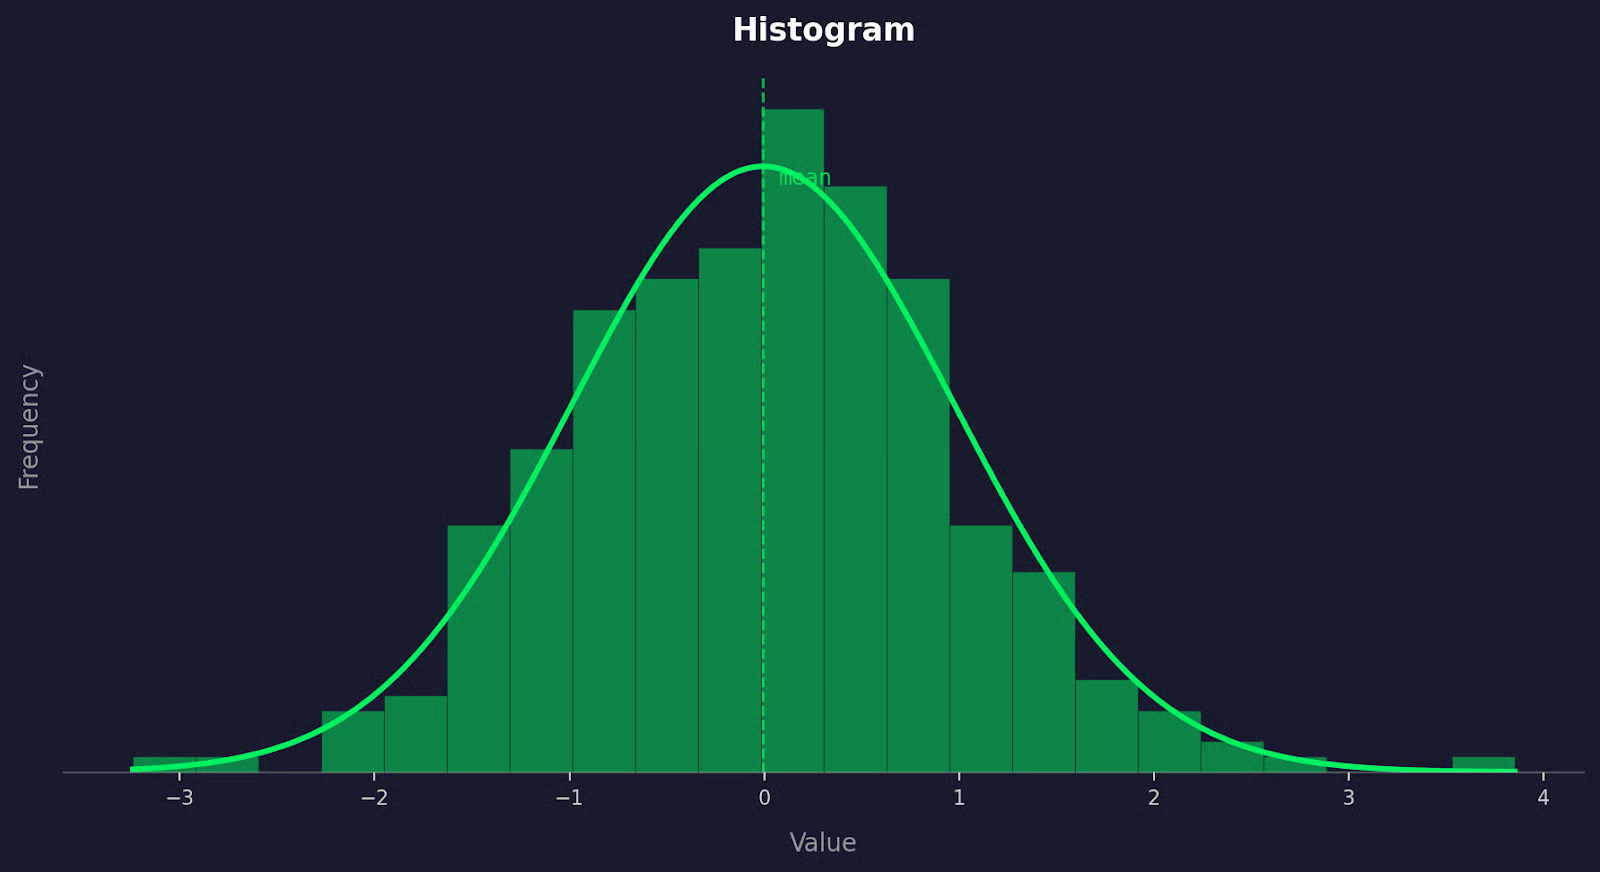
Ví dụ histogram
Nếu dữ liệu có phân phối chuẩn, histogram sẽ giống hình chuông - cao ở giữa, thuôn đối xứng về hai phía. Điều bạn cần để ý là độ lệch (skewness): đuôi dài kéo về bên phải nghĩa là lệch dương, đuôi kéo về bên trái là lệch âm. Dấu hiệu này cho thấy dữ liệu có thể không chuẩn.
Vấn đề với histogram là hình dạng phụ thuộc vào kích thước bin:
Hãy thử vài kích thước bin trước khi kết luận.
Một đồ thị Q-Q (quantile-quantile) so sánh các phân vị của dữ liệu với phân vị của một phân phối chuẩn lý thuyết.
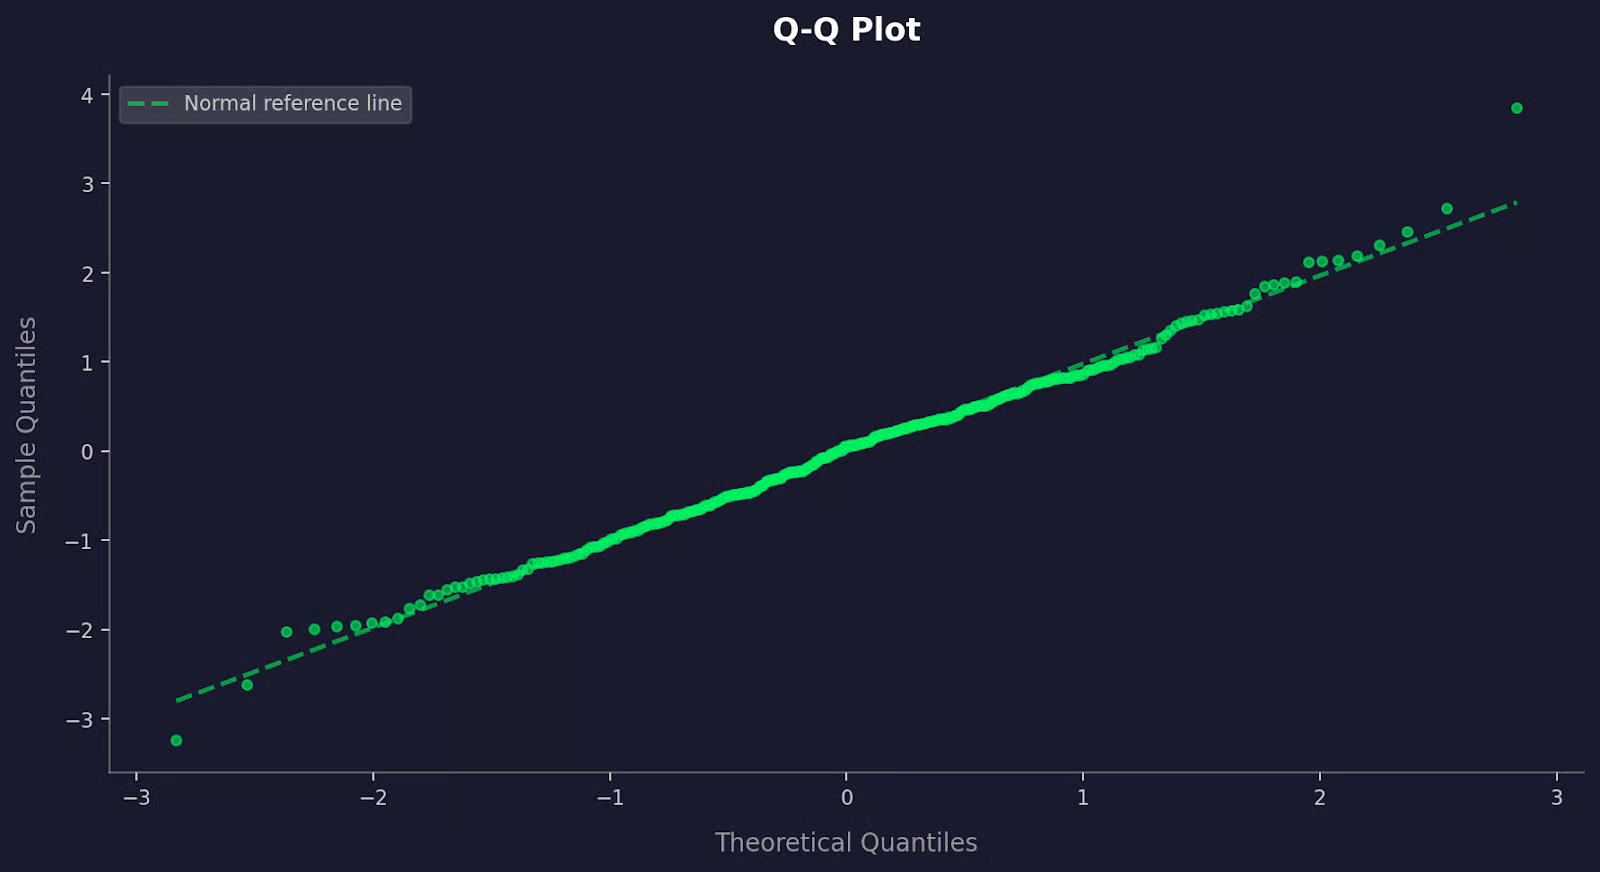
Ví dụ đồ thị Q-Q
Nếu dữ liệu chuẩn, các điểm sẽ nằm dọc theo một đường chéo thẳng. Sai lệch khỏi đường đó cho bạn biết nơi tính chuẩn bị phá vỡ. Điểm cong lên ở hai đầu gợi ý đuôi nặng. Đường cong hình chữ S gợi ý có độ lệch.
Đồ thị Q-Q chính xác hơn histogram trong việc phát hiện sai lệch tinh vi khỏi chuẩn - đặc biệt ở phần đuôi, nơi histogram thường bỏ sót.
Box plot cho bạn thấy trung vị, mức độ phân tán và ngoại lệ trong một khung nhìn.
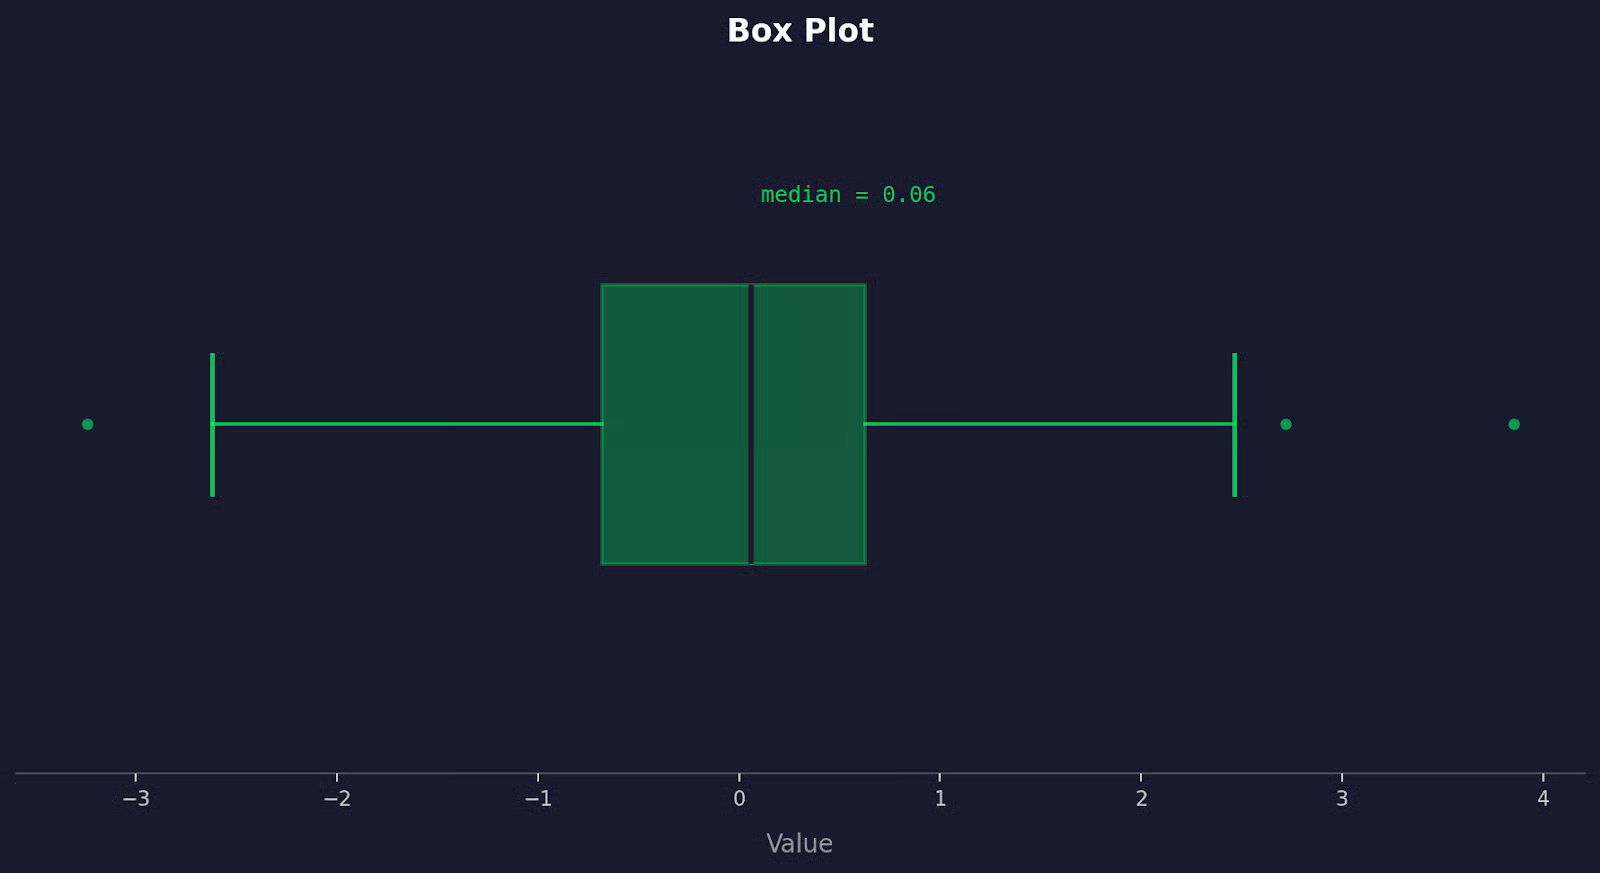
Ví dụ box plot
Một tập dữ liệu phân phối chuẩn tạo ra box plot có trung vị nằm gần giữa hộp, và râu kéo dài xấp xỉ bằng nhau về hai phía. Nếu trung vị lệch tâm, hoặc một râu dài hơn nhiều so với râu kia, đó là lệch. Các chấm ngoài râu là ngoại lệ.
Vấn đề chung với biểu đồ trực quan là tính chủ quan. Hai người có thể nhìn cùng một histogram và bất đồng. Hãy dùng chúng để cảm nhận dữ liệu trước, sau đó xác nhận bằng kiểm định chính thức.
Không có một kiểm định tính chuẩn nào tốt nhất cho mọi tình huống. Lựa chọn phù hợp phụ thuộc vào kích thước mẫu và điều bạn muốn phát hiện.
Shapiro-Wilk là lựa chọn hàng đầu cho mẫu nhỏ đến trung bình, thường lên đến vài trăm quan sát.
Nó đo lường mức độ dữ liệu của bạn khớp với phân phối chuẩn bằng cách so sánh giá trị quan sát với kỳ vọng nếu dữ liệu là chuẩn. Được sử dụng rộng rãi, dễ hiểu và có mặt trong mọi thư viện thống kê lớn. Với hầu hết nhà phân tích, đây là kiểm định nên dùng đầu tiên.
Hạn chế chính là nó trở nên quá nhạy với kích thước mẫu lớn. Nó dễ gắn cờ những sai lệch rất nhỏ, hầu như không có ý nghĩa thực tiễn, là có ý nghĩa thống kê.
Kiểm định Kolmogorov-Smirnov (KS) so sánh phân phối tích lũy của mẫu với một phân phối lý thuyết - ở đây là chuẩn.
Nó tổng quát hơn Shapiro-Wilk và có thể kiểm tra so với bất kỳ phân phối nào, không chỉ chuẩn. KS kém mạnh hơn Shapiro-Wilk trong kiểm tra tính chuẩn, nghĩa là ít khả năng phát hiện sai lệch tinh vi. Nó cũng yêu cầu bạn chỉ định tham số phân phối trước, điều này gây thiên lệch nếu bạn ước lượng từ chính dữ liệu đó.
Hãy dùng khi bạn cần một kiểm tra nhanh, đa dụng - không phải kiểm định chính để đánh giá tính chuẩn.
Anderson-Darling là biến thể của KS, nhưng với một khác biệt quan trọng: nó gán trọng số lớn hơn cho phần đuôi của phân phối.
Điều này giúp nó bắt tốt hơn các sai lệch xuất hiện ở cực trị - đuôi nặng, ngoại lệ, hoặc hành vi phi chuẩn mà KS có thể bỏ lỡ. Nếu trường hợp sử dụng của bạn nhạy với hành vi ở đuôi, Anderson-Darling là lựa chọn tốt.
D'Agostino-Pearson tiếp cận theo cách khác.
Thay vì so sánh trực tiếp các phân phối, nó đo hai đặc tính của dữ liệu: độ lệch (bất đối xứng) và độ nhọn (kurtosis - mức độ nặng/nhẹ của đuôi).
Nó kết hợp cả hai thành một thống kê kiểm định. Điều này giúp nó giỏi trong việc chỉ ra vì sao dữ liệu có thể không chuẩn - chứ không chỉ là có hay không. Nó hoạt động tốt nhất với mẫu lớn, nơi ước lượng độ lệch và độ nhọn đáng tin cậy.
Jarque-Bera cũng sử dụng độ lệch và độ nhọn, tương tự D'Agostino-Pearson.
Phổ biến trong kinh tế lượng và phân tích chuỗi thời gian. Giống D'Agostino-Pearson, nó cần mẫu đủ lớn để cho kết quả tin cậy. Với mẫu nhỏ, kiểm định không quá đáng tin. Nếu bạn làm trong bối cảnh tài chính hay kinh tế, bạn sẽ thường gặp kiểm định này.
Tóm lại, hãy bắt đầu với Shapiro-Wilk cho mẫu nhỏ và kết hợp với đồ thị Q-Q. Dùng Anderson-Darling khi hành vi đuôi quan trọng, và D'Agostino-Pearson khi bạn muốn hiểu bản chất của sai lệch.
Mỗi kiểm định tính chuẩn là một kiểm định giả thuyết.
Giả thuyết không trong mọi kiểm định tính chuẩn là dữ liệu của bạn có phân phối chuẩn. Kiểm định đặt câu hỏi: với những gì quan sát được, giả thuyết không có khả năng đúng đến mức nào?
Câu trả lời là một p-value:
Nghe có vẻ đơn giản, nhưng nhiều người mắc lỗi ở đây.
Một p-value thấp không cho biết dữ liệu của bạn phi chuẩn đến mức nào - chỉ cho biết có phát hiện sự khác biệt. Với mẫu lớn, các kiểm định tính chuẩn trở nên cực kỳ nhạy. Chúng sẽ gắn cờ những sai lệch nhỏ đến mức không ảnh hưởng thực sự đến phân tích.
Vấn đề ngược lại cũng tồn tại. Với mẫu nhỏ, ngay cả dữ liệu lệch rõ ràng cũng có thể cho p > 0,05 vì kiểm định không đủ mạnh để phát hiện sai lệch.
Ý nghĩa thống kê và ý nghĩa thực tiễn không phải là một.
P-value cho bạn biết có tồn tại sai lệch khỏi chuẩn hay không. Nó không cho biết sai lệch đó có quan trọng với phân tích cụ thể của bạn không. Luôn kết hợp kết quả kiểm định với đồ thị Q-Q - nếu các điểm bám sát đường, dữ liệu của bạn có lẽ đủ chuẩn, bất kể p-value nói gì.
Mô-đun scipy.stats của Python có mọi thứ bạn cần để chạy các kiểm định tính chuẩn chỉ với vài dòng code.
Cho mọi ví dụ dưới đây, tôi sẽ dùng cùng một tập dữ liệu - 100 mẫu rút từ phân phối chuẩn - để bạn có thể chạy mã và theo dõi.
import numpy as np
from scipy import stats

np.random.seed(42)
data = np.random.normal(loc=0, scale=1, size=100)Dùng shapiro() như kiểm tra đầu tiên, đặc biệt với tập dữ liệu nhỏ.
stat, p_value = stats.shapiro(data)
print(f"Statistic: {stat:.4f}, p-value: {p_value:.4f}")
Bạn sẽ nhận được như sau:
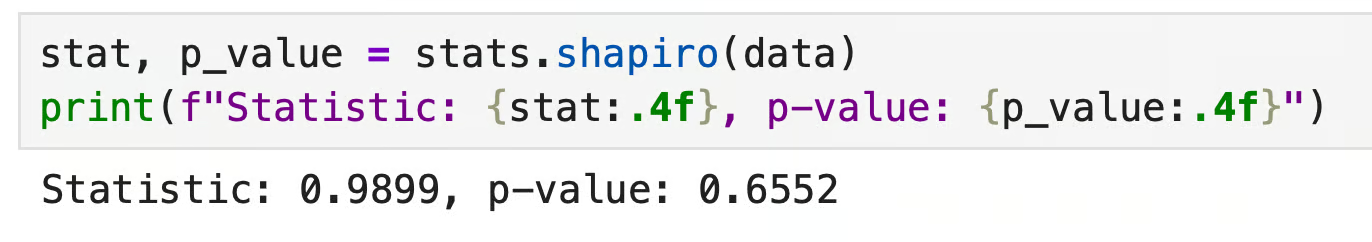
Kết quả kiểm định Shapiro-Wilk trong Python
P-value lớn hơn 0,05 đáng kể, nên chúng ta không bác bỏ tính chuẩn. Dữ liệu có vẻ chuẩn - điều hợp lý vì ta đã tạo từ phân phối chuẩn.
kstest() so sánh mẫu của bạn với một phân phối có tên. Với tính chuẩn, truyền "norm" cùng với trung bình và độ lệch chuẩn của mẫu.
stat, p_value = stats.kstest(data, 'norm', args=(data.mean(), data.std()))
print(f"Statistic: {stat:.4f}, p-value: {p_value:.4f}")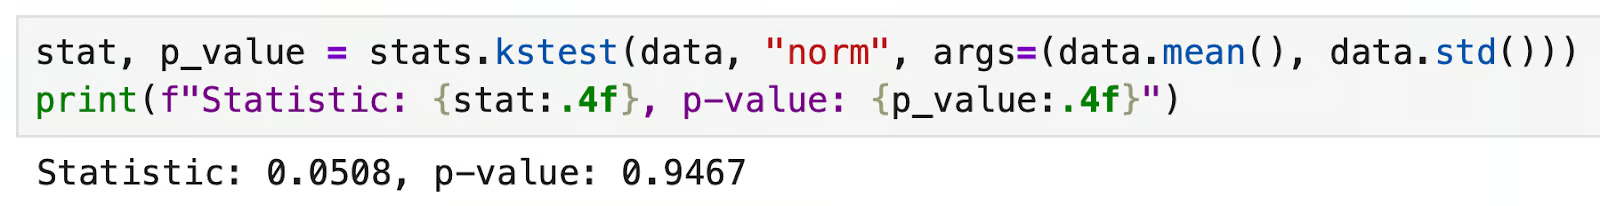
Kết quả kiểm định Kolmogorov-Smirnov trong Python
Một lần nữa, p > 0,05 - không có bằng chứng chống lại tính chuẩn.
Với kiểm định này trong Python, luôn truyền trung bình và độ lệch chuẩn một cách tường minh thông qua args. Nếu bỏ qua, kstest() mặc định dùng chuẩn tắc (mean=0, std=1), điều này sẽ cho kết quả kém tin cậy trừ khi dữ liệu của bạn đã được chuẩn hóa.
normaltest() kiểm tra tính chuẩn bằng cách kết hợp độ lệch và độ nhọn. Nó hoạt động tốt nhất với mẫu lớn.
stat, p_value = stats.normaltest(data)
print(f"Statistic: {stat:.4f}, p-value: {p_value:.4f}")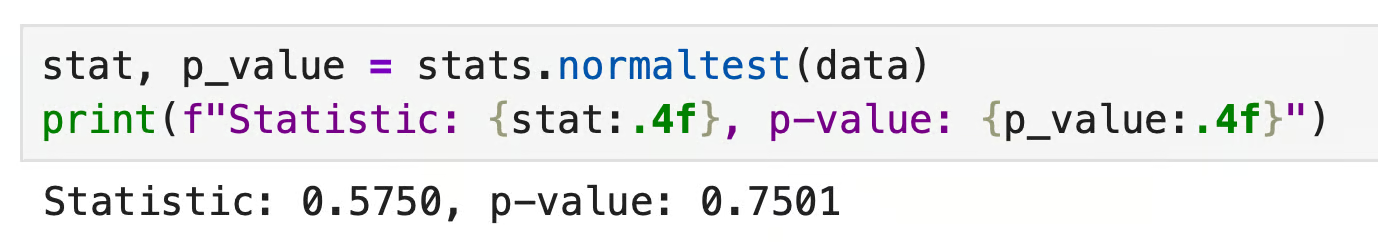
Kết quả kiểm định D'Agostino-Pearson trong Python
Lại p > 0,05. Dữ liệu vượt qua cả ba kiểm định ở đây, điều dễ hiểu - tôi tạo ra nó để chuẩn. Trong thực tế, bạn sẽ thường thấy các kiểm định bất đồng, đặc biệt gần ngưỡng 0,05. Khi đó, hãy dựa vào đồ thị Q-Q để quyết định.
R có sẵn các hàm để kiểm tra tính chuẩn. Không cần thêm gói cho những thứ cơ bản.
Tương tự ví dụ Python, tôi sẽ dùng cùng một tập dữ liệu: 100 mẫu từ phân phối chuẩn.
set.seed(42)
data <- rnorm(100, mean = 0, sd = 1)shapiro.test() là lựa chọn hàng đầu cho mẫu nhỏ đến trung bình. Chỉ cần truyền vào vector dữ liệu của bạn:
shapiro.test(data)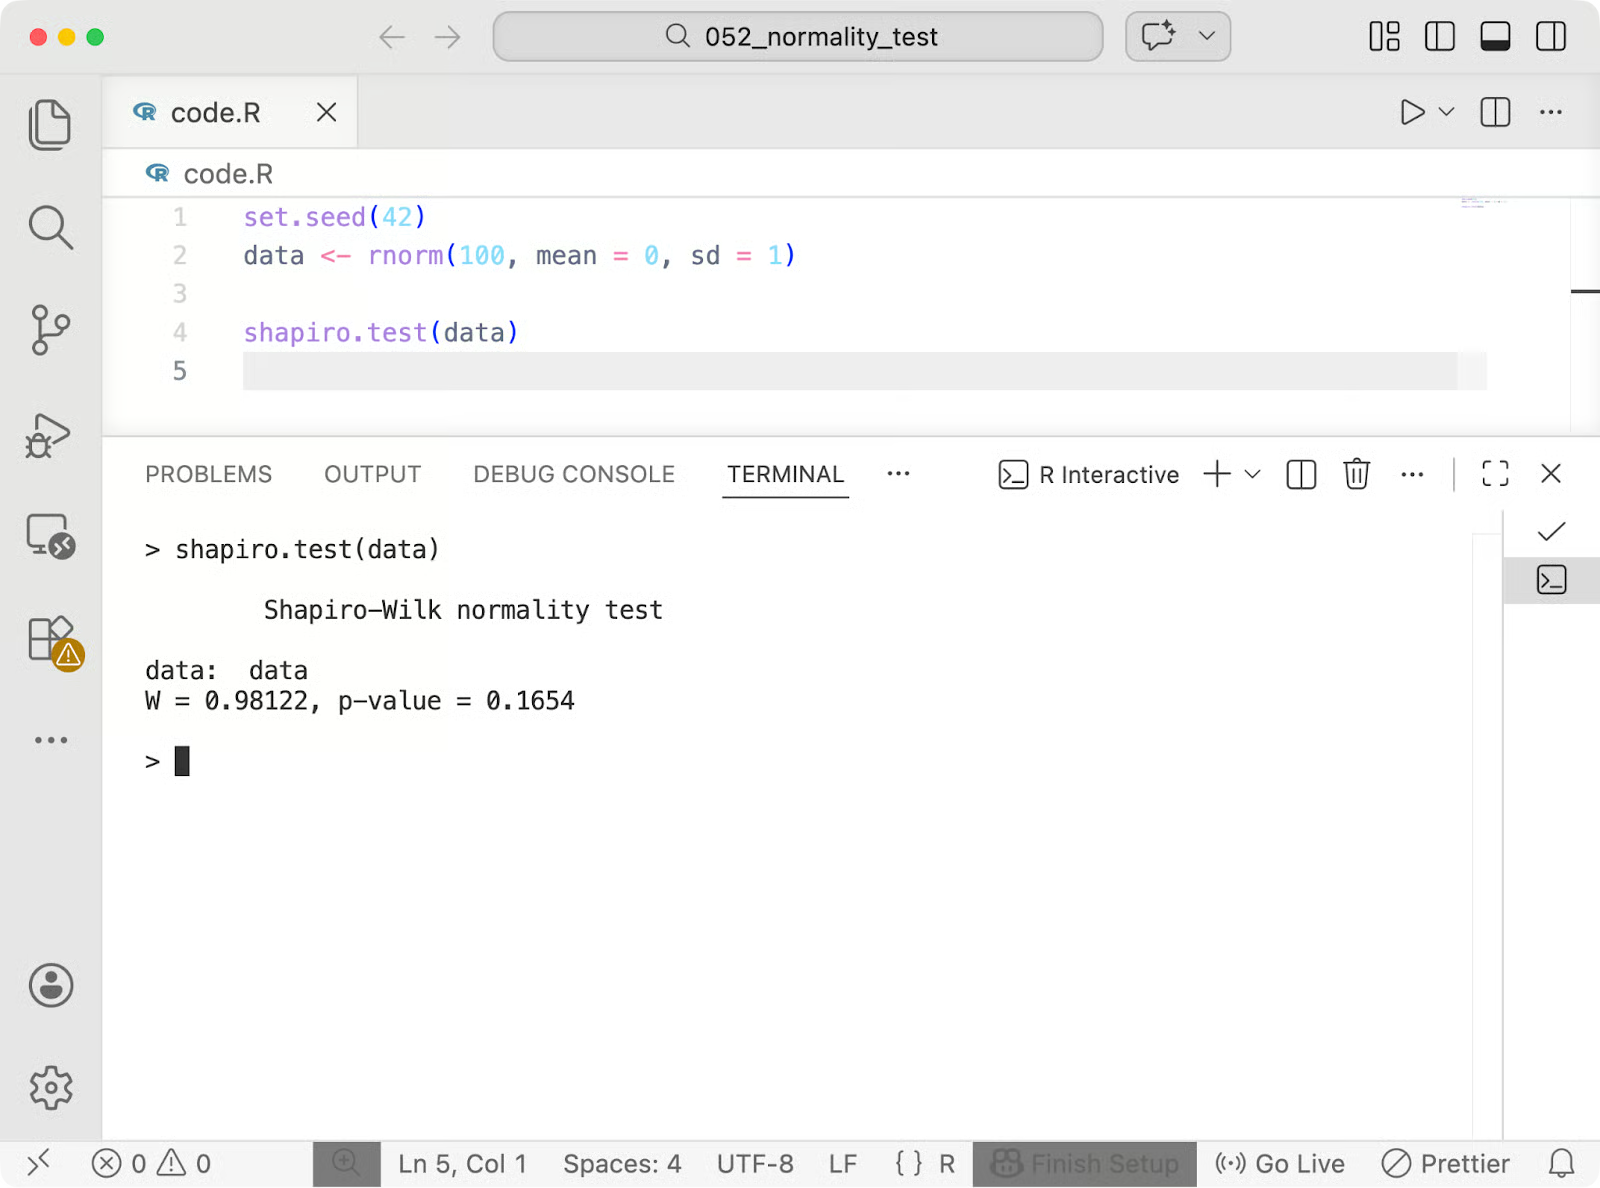
Kết quả kiểm định Shapiro-Wilk trong R
p > 0,05 - không có bằng chứng chống lại tính chuẩn. Thống kê W dao động từ 0 đến 1, giá trị gần 1 cho thấy dữ liệu bám sát phân phối chuẩn.
ks.test() so sánh mẫu của bạn với một phân phối lý thuyết. Với tính chuẩn, chỉ định "pnorm" và truyền trung bình cùng độ lệch chuẩn của mẫu.
ks.test(data, "pnorm", mean(data), sd(data))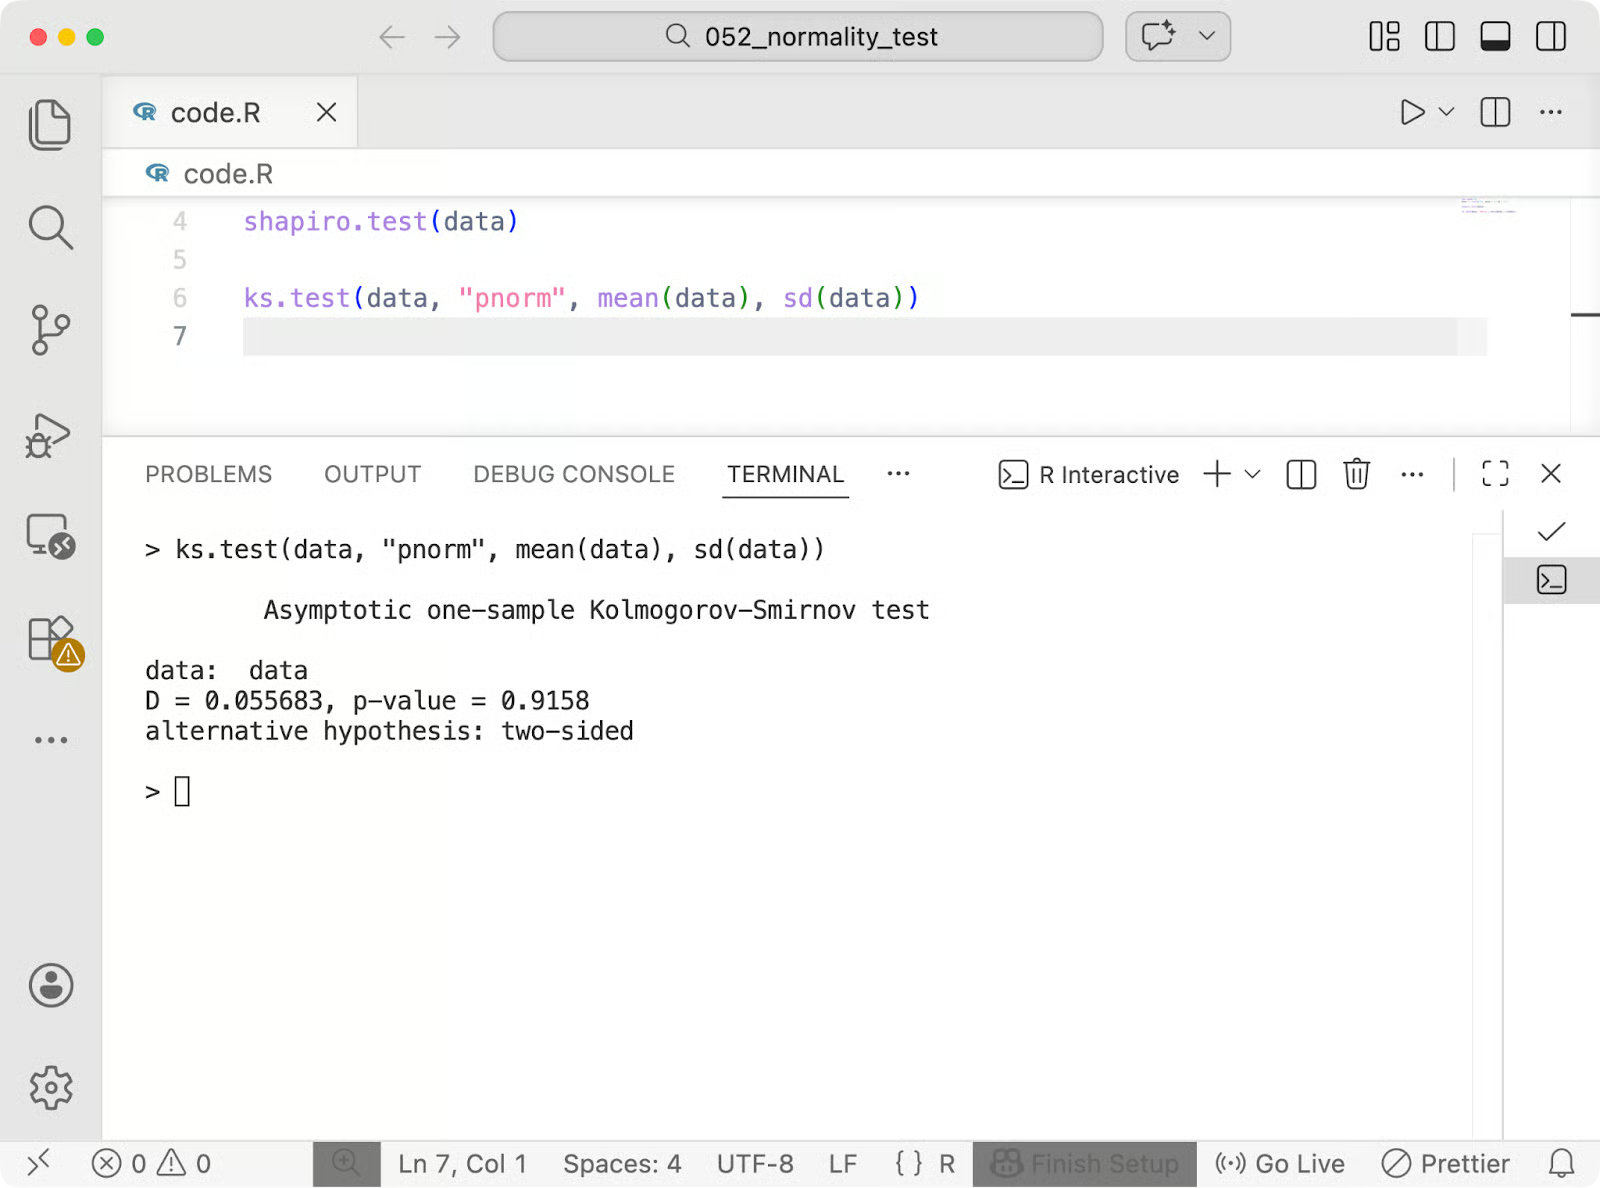
Kết quả kiểm định Kolmogorov-Smirnov trong R
Lại p > 0,05. Kiểm định này trong R có lưu ý giống Python: luôn truyền mean(data) và sd(data). Bỏ qua sẽ mặc định dùng chuẩn tắc, khiến kết quả lệch trừ khi dữ liệu đã được chuẩn hóa.
Hai hàm có sẵn của R là qqnorm() và qqline() cho bạn đồ thị Q-Q chỉ với hai dòng code.
qqnorm(data, main = "Q-Q Plot")
qqline(data, col = "steelblue", lwd = 2)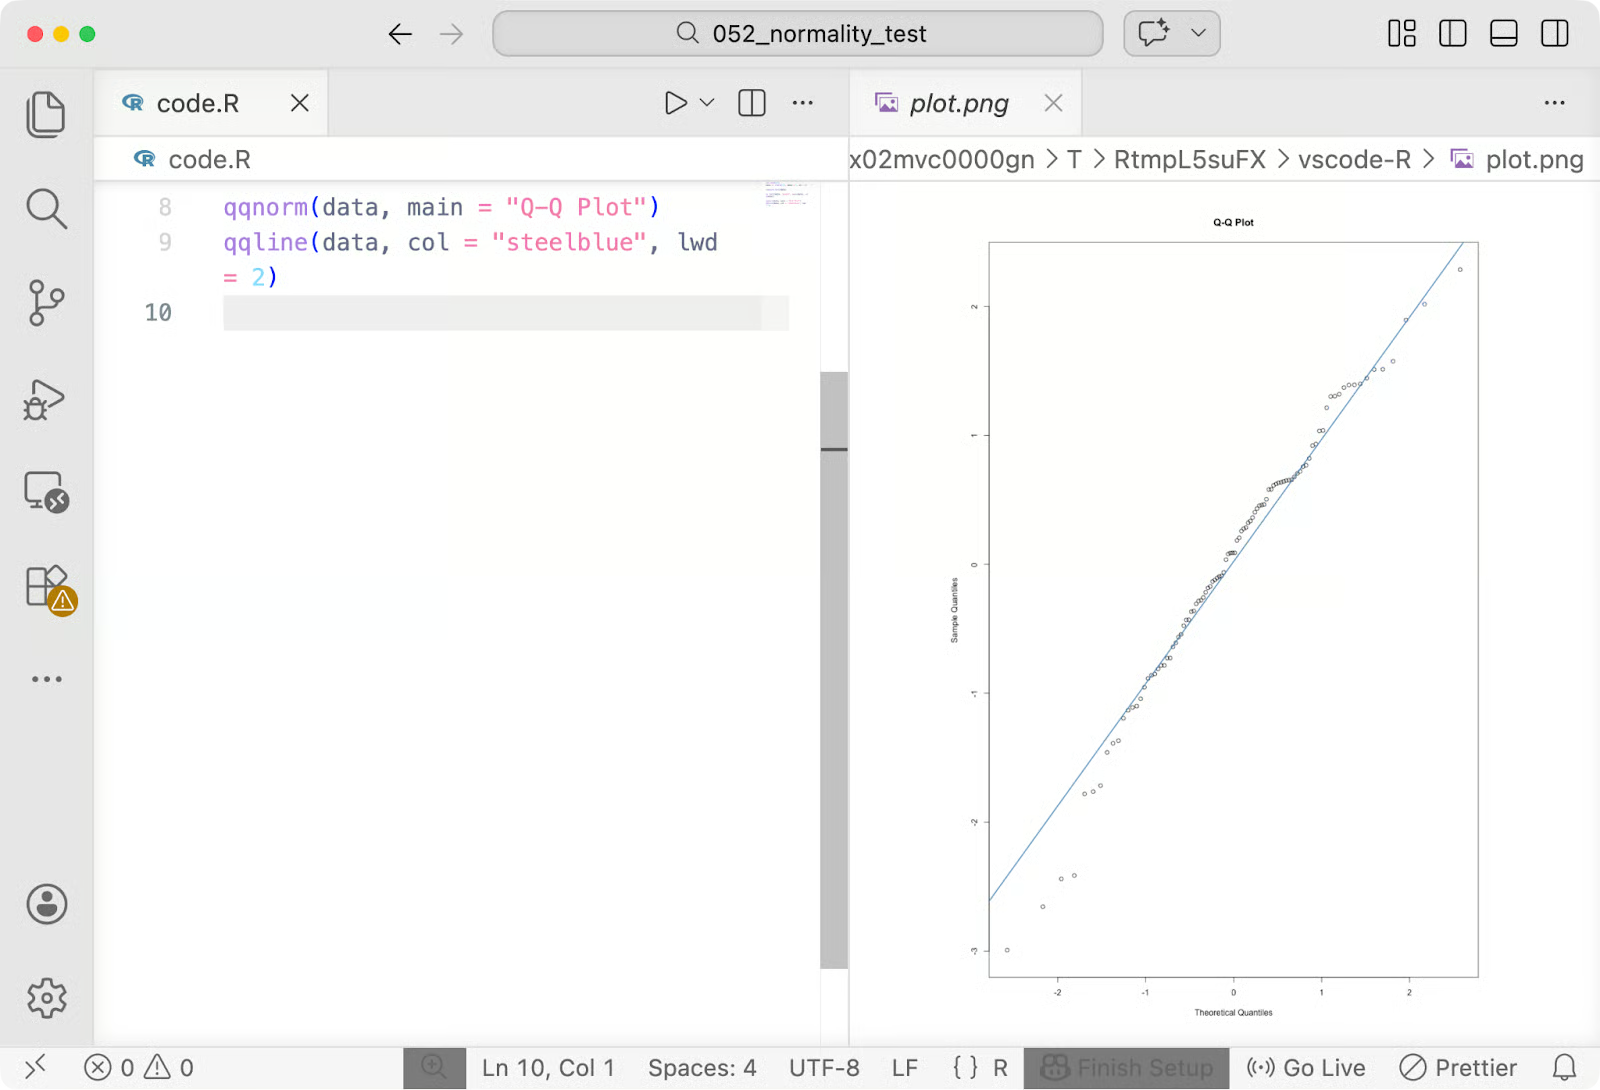
Đồ thị Q-Q trong R
qqnorm() vẽ các phân vị mẫu của bạn so với phân vị chuẩn lý thuyết. qqline() vẽ đường tham chiếu. Các điểm bám sát đường nghĩa là dữ liệu hành xử như chuẩn. Sai lệch ở hai đầu báo hiệu vấn đề ở đuôi cần xem xét.
Nếu dữ liệu không vượt qua kiểm định tính chuẩn, bạn có vài lựa chọn tốt.
Đôi khi cách sửa là biến đổi dữ liệu để nó hành xử như chuẩn, rồi chạy lại các kiểm định ban đầu trên giá trị đã biến đổi.
Biến đổi log là lựa chọn phổ biến nhất. Nó hiệu quả với dữ liệu lệch phải - như thu nhập, thời gian phản hồi, hay đo lường sinh học có đuôi dài bên phải. Hàm trong Python là np.log(data), và tương đương trong R là log(data).
Biến đổi căn bậc hai là lựa chọn nhẹ hơn cho độ lệch vừa phải, và hữu ích khi dữ liệu có số 0 (vì không thể lấy log của 0). Dùng np.sqrt(data) trong Python hoặc sqrt(data) trong R.
Sau khi biến đổi, hãy chạy lại kiểm định tính chuẩn. Nếu dữ liệu đã biến đổi đạt, tiếp tục với kiểm định tham số - chỉ cần nhớ diễn giải kết quả theo thang đo đã biến đổi.
Nếu biến đổi không hiệu quả hoặc không hợp lý với dữ liệu của bạn, hãy chuyển sang kiểm định phi tham số. Chúng không giả định tính chuẩn - chúng xếp hạng dữ liệu thay vì làm việc với giá trị thô.
Cả hai đều có trong scipy.stats (mannwhitneyu() và kruskal()) và trong gói cơ bản của R (wilcox.test() và kruskal.test()).
Với mẫu đủ lớn, bạn thường có thể bỏ qua mối lo về tính chuẩn.
Định lý giới hạn trung tâm nói rằng khi kích thước mẫu tăng, phân phối lấy mẫu của trung bình sẽ tiệm cận chuẩn - bất kể phân phối gốc như thế nào. Trong thực tế, điều này có nghĩa là các kiểm định tham số thường đáng tin với mẫu lớn ngay cả khi dữ liệu nền không hoàn toàn chuẩn.
Kiểm tra tính chuẩn rất dễ - bạn đã thấy chỉ cần một dòng code. Tuy vậy, vẫn có vài cách để làm sai.
Dưới đây là một số lỗi thường gặp của người mới học khoa học dữ liệu:
Tóm lại, kiểm tra tính chuẩn chỉ là một phép kiểm tra trong số nhiều phép với dữ liệu của bạn. Hãy dùng nó như một đầu vào, không phải lời kết luận cuối cùng.
Không phải lúc nào cũng cần kiểm tra tính chuẩn. Nếu bạn đang chạy deadline, biết khi nào có thể bỏ qua sẽ giúp tiết kiệm thời gian mà không ảnh hưởng kết quả.
Khi bạn có mẫu lớn, định lý giới hạn trung tâm đảm bảo phân phối lấy mẫu của trung bình xấp xỉ chuẩn, bất kể hình dạng dữ liệu thô. Các kiểm định tham số thường đáng tin trong tình huống này, nên chạy kiểm định tính chuẩn chính thức không mang lại nhiều giá trị.
Một số phương pháp thống kê cũng bền vững với sự phi chuẩn. Các kỹ thuật như hồi quy tuyến tính thường hoạt động tốt khi kích thước mẫu hợp lý và vi phạm không quá nghiêm trọng. (Hồi quy tuyến tính vẫn giả định tính chuẩn ở phần dư.)
Khi bạn đang rà soát mẫu hình, xây dựng trực giác, hoặc quyết định biến nào cần nghiên cứu sâu hơn, một histogram hoặc đồ thị Q-Q nhanh là đủ. Kiểm định chính thức dành cho phân tích xác nhận - khi kết luận của bạn cần vững vàng.
Hãy nhớ kiểm tra tính chuẩn tồn tại để bảo vệ bạn khỏi đưa ra kết luận sai. Nếu bạn ở ngữ cảnh mà kết luận sai không gây hậu quả thực, hoặc phương pháp của bạn không phụ thuộc vào tính chuẩn, kiểm định là tùy chọn.
Kiểm tra tính chuẩn nhằm xác định liệu các giả định của bạn đủ đúng để tin vào kết quả hay không.
Không có tập dữ liệu nào hoàn hảo chuẩn. Mục tiêu là hiểu dữ liệu của bạn hành xử ra sao và chọn phương pháp phù hợp. Đồ thị Q-Q cho bạn biết nơi có sai lệch. Kiểm định chính thức cho biết liệu chúng có thể phát hiện được về mặt thống kê hay không. Kết hợp cả hai sẽ cho bức tranh rõ ràng hơn từng cái riêng lẻ.
Kiểm định phù hợp phụ thuộc bối cảnh. Dùng Shapiro-Wilk cho mẫu nhỏ, Anderson-Darling khi phần đuôi quan trọng, các lựa chọn phi tham số khi không thể giả định tính chuẩn. Và đôi khi - với mẫu lớn hoặc phương pháp bền vững - không cần kiểm định nào cả.
Bạn thấy khái niệm p-value rối rắm? Hãy đọc bài Kiểm định giả thuyết thật dễ của chúng tôi để đảm bảo bạn diễn giải đúng.
Học cùng DataCamp
Khóa học
Khóa học
Khóa học
