
कोर्स
Python में Hypothesis Testing
4 घंटा
61.6K
क्या आपने कभी t-test चलाया, एक साफ p-value मिली, और फिर एहसास हुआ कि आपने यह जाँचा ही नहीं कि आपका डेटा सामान्य वितरण का पालन करता है या नहीं?
सांख्यिकीय परीक्षण आपको यह नहीं बताते कि उनकी मान्यताएँ कब टूटती हैं। वे बस मान निकालकर दे देते हैं। दिक्कत यह है कि t-test और ANOVA जैसे परीक्षण मानते हैं कि आपका डेटा सामान्य वितरण का अनुसरण करता है। अगर ऐसा नहीं है, तो आप अपनी निष्कर्षों की नींव कमजोर रख रहे हैं।
सामान्यता परीक्षण आपको उस मान्यता की पुष्टि करने का तरीका देते हैं। यह करने के लिए दृश्य और सांख्यिकीय दोनों विधियाँ हैं, और किसका उपयोग कब करना है—और परिणाम कैसे पढ़ने हैं—यह जानना ही आपको अपने निष्कर्षों पर आत्मविश्वास से खड़े होने देता है।
इस लेख में, मैं आपको सामान्यता जाँचने की सबसे आम दृश्य और सांख्यिकीय विधियों से परिचित कराऊँगा, normality पर चर्चा करूँगा, दिखाऊँगा कि उन्हें Python और R में कैसे चलाते हैं, और यह भी समझाऊँगा कि जब आपका डेटा परीक्षण में पास नहीं होता तो क्या करना चाहिए।
आपने संभवतः घंटी-आकार के वक्र को पहले देखा होगा—लेकिन इसका आपके डेटा के लिए असल मतलब क्या है, यह यहाँ है।
सामान्य वितरण वह पैटर्न है जहाँ अधिकांश मान केंद्र के आसपास जमा होते हैं, और जैसे-जैसे आप दोनों दिशाओं में दूर जाते हैं, मान कम होते जाते हैं। इसे प्लॉट करें, और आपको सममित, घंटी-आकार का वक्र मिलता है। बायाँ हिस्सा दाएँ हिस्से का प्रतिबिंब होता है।
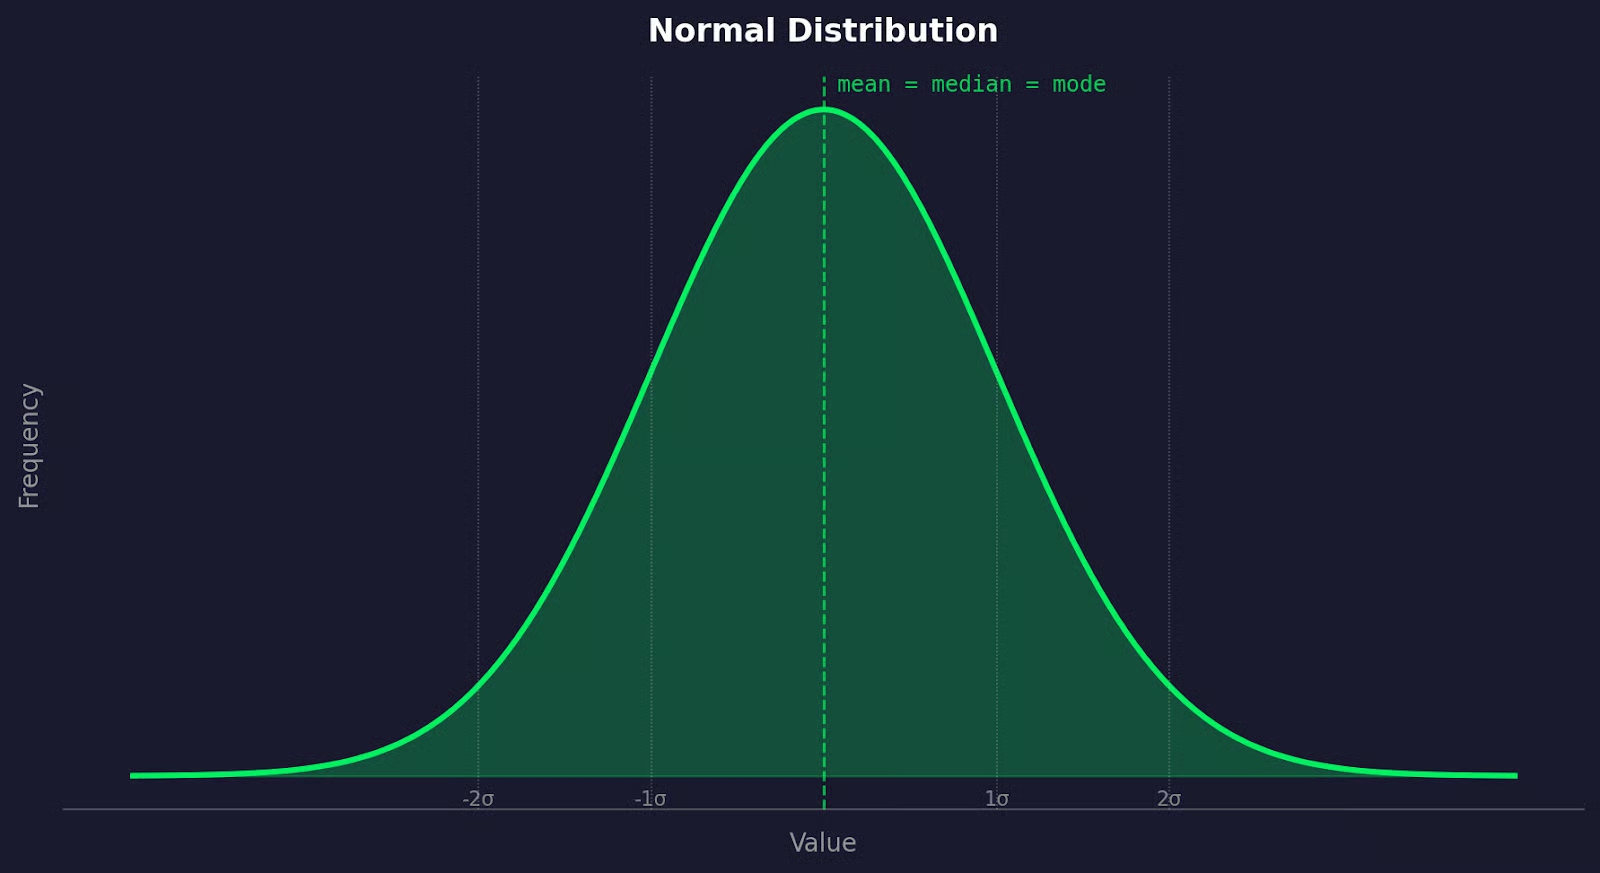
सामान्य वितरण का प्लॉट
सामान्य वितरण की खासियत यह है कि औसत (mean), माध्यिका (median), और बहुलक (mode)—तीनों एक ही बिंदु पर आते हैं, यानी घंटी के केंद्र पर। बाएँ या दाएँ किसी तरफ झुकाव नहीं होता। दूसरे शब्दों में, डेटा संतुलित होता है।
यह वास्तविक दुनिया के मापन डेटा में बार-बार दिखता है। मानव कद, रक्तचाप रीडिंग, मैन्युफैक्चरिंग टॉलरेंस, टेस्ट स्कोर—पर्याप्त नमूने इकट्ठे करें तो ये सब सामान्य वितरण का पालन करने की प्रवृत्ति रखते हैं। जैविक और भौतिक प्रणालियों में प्राकृतिक भिन्नता प्रायः इसी आकार को जन्म देती है।
फिर भी, सारा डेटा ऐसा नहीं बर्ताव करता। आय (income) डेटा दाईं ओर झुका होता है। वेबसाइट प्रतिक्रिया समय में लंबे टेल्स होते हैं।
वास्तविक दुनिया में, बिना जाँच के सामान्यता मान लेना भारी गलती करा सकता है।
सामान्यता जाँचने की समस्या न करने की यह है कि अधिकतर आम सांख्यिकीय परीक्षण—t-test, ANOVA—पैरामीट्रिक परीक्षण होते हैं।
इसका मतलब है कि वे आपके डेटा के वितरण के बारे में मान्यताओं पर आधारित होते हैं। सामान्यता उनमें से एक है। जब वह मान्यता टूटती है, तो परीक्षण की गणित भी साथ ही टूटती है। आपको परीक्षण से परिणाम तो मिल जाएगा, लेकिन वह आपको गलत निष्कर्षों तक पहुँचा सकता है।
पैरामीट्रिक परीक्षण उस जनसंख्या के बारे में गणितीय मान्यताएँ बनाते हैं, जिससे आपका नमूना आता है। जब वे मान्यताएँ सही होती हैं, तो ये परीक्षण उपयोगी और सटीक होते हैं। जब नहीं होतीं, तो आपकी p-values अविश्वसनीय हो जाती हैं और आप सटीक निष्कर्ष नहीं निकाल सकते।
यहीं नॉन-पैरामीट्रिक परीक्षण काम आते हैं।
Mann-Whitney U या Kruskal-Wallis जैसे परीक्षण सामान्यता नहीं मानते—वे कच्चे मानों की जगह रैंकों के साथ काम करते हैं। ये अधिक लचीले हैं, लेकिन जब आपका डेटा सामान्य हो तो इनकी उपयोगिता अपेक्षाकृत कम होती है। इसलिए बिना वजह उन पर स्विच करना समाधान नहीं है।
वास्तविक समस्या जो कई नए डेटा वैज्ञानिक करते हैं, वह है इस जाँच को पूरी तरह छोड़ देना।
सामान्यता परीक्षण के लिए कुछ पंक्तियों का कोड ही पर्याप्त है। जाँच न करना मतलब या तो आप अपने डेटा पर आँख मूँदकर भरोसा कर रहे हैं—या उसके बारे में सोच ही नहीं रहे हैं।
किसी भी औपचारिक परीक्षण से पहले, अपना डेटा प्लॉट करें। विज़ुअल्स आपको आपके डेटा के बारे में बहुत कुछ बता देंगे।
हिस्टोग्राम आपको आपके वितरण का आकार दिखाता है।
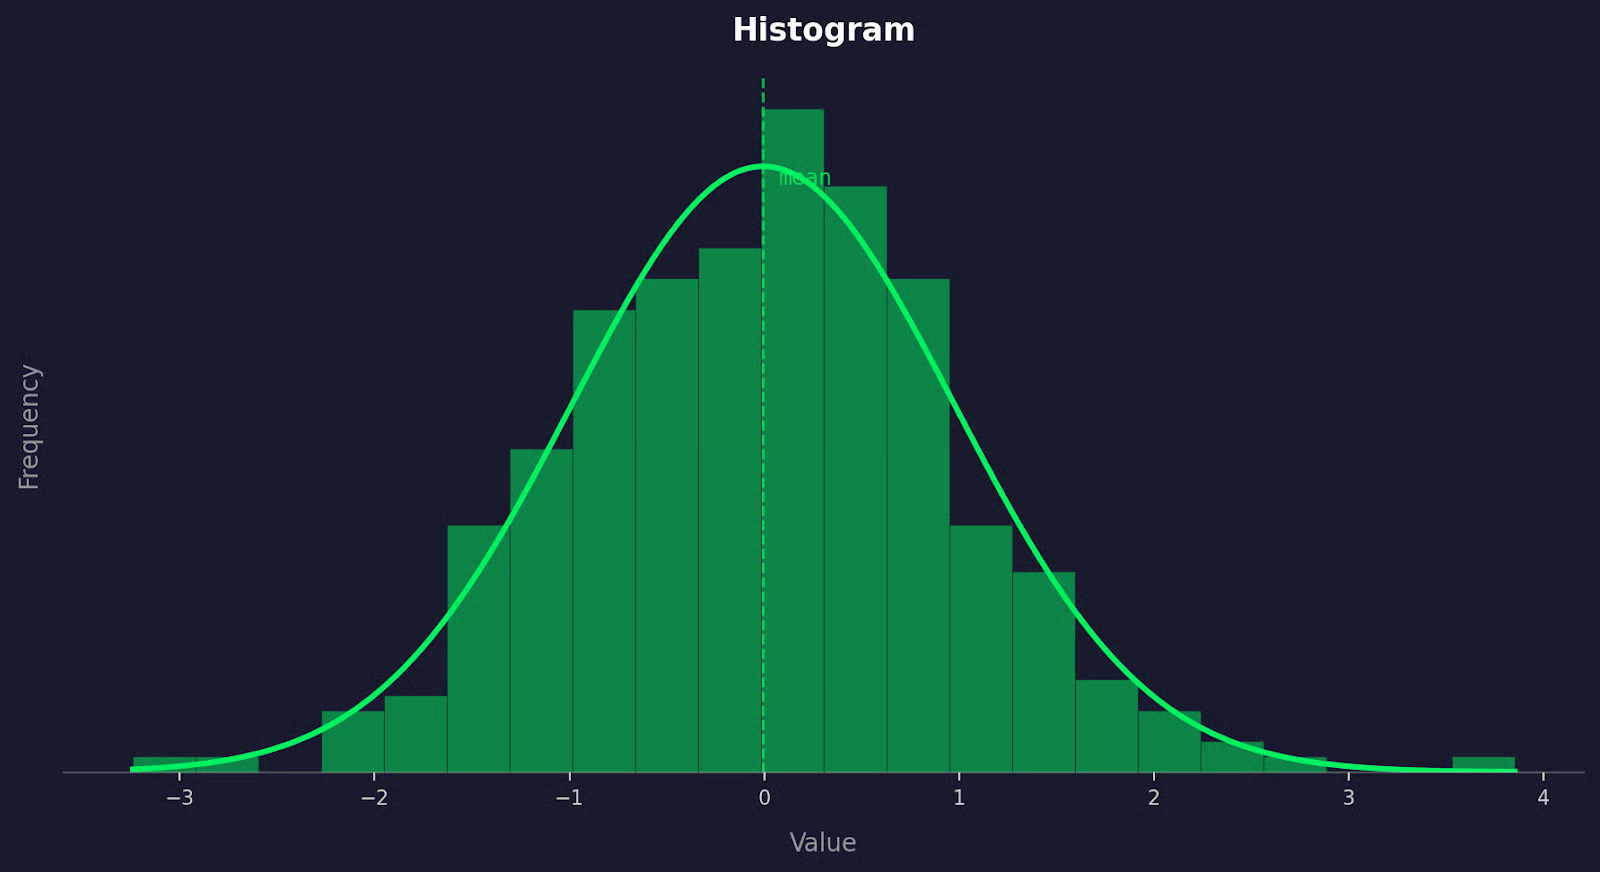
उदाहरण हिस्टोग्राम
यदि आपका डेटा सामान्य रूप से वितरित है, तो हिस्टोग्राम घंटी-आकार जैसा दिखेगा—बीच में ऊँचा, और दोनों ओर सममित रूप से पतला होता हुआ। यहाँ जिस चीज़ पर ध्यान देना है वह है skewness (झुकाव): दाईं ओर लंबी पूँछ का मतलब सकारात्मक झुकाव, बाईं ओर की पूँछ का मतलब नकारात्मक झुकाव। किसी भी तरह, यह संकेत है कि आपका डेटा सामान्य न हो।
हिस्टोग्राम की समस्या यह है कि उसका आकार बिन आकार पर निर्भर करता है:
निष्कर्ष निकालने से पहले हमेशा कुछ अलग-अलग बिन आकार आज़माएँ।
Q-Q प्लॉट (क्वांटाइल-क्वांटाइल प्लॉट) आपके डेटा के क्वांटाइल्स की सैद्धांतिक सामान्य वितरण के क्वांटाइल्स से तुलना करता है।
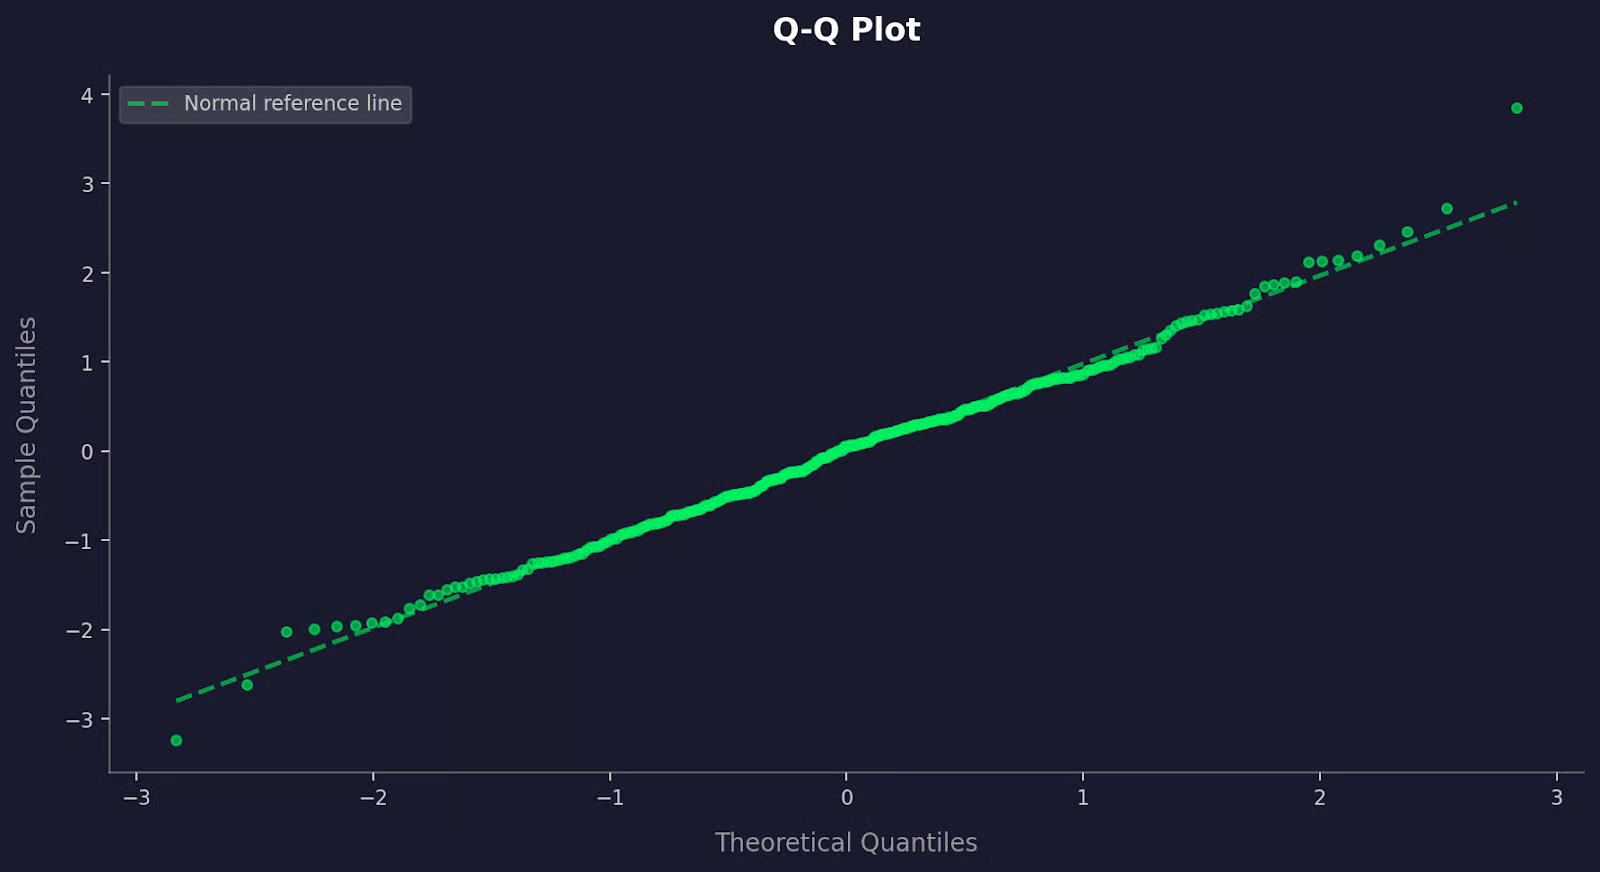
उदाहरण Q-Q प्लॉट
यदि आपका डेटा सामान्य है, तो बिंदु एक सीधी विकर्ण रेखा के साथ आते हैं। उस रेखा से विचलन बताते हैं कि सामान्यता कहाँ टूट रही है। सिरों पर बिंदुओं का ऊपर की ओर मुड़ना भारी टेल्स का संकेत देता है। S-आकार का वक्र झुकाव की ओर इशारा करता है।
Q-Q प्लॉट्स सामान्यता से हल्के विचलनों को पहचानने में हिस्टोग्राम से अधिक सटीक होते हैं—खासकर टेल्स में, जहाँ हिस्टोग्राम अक्सर चीजें छोड़ देते हैं।
बॉक्स प्लॉट आपको एक ही दृश्य में माध्यिका, फैलाव और अपवाद मान (outliers) दिखाता है।
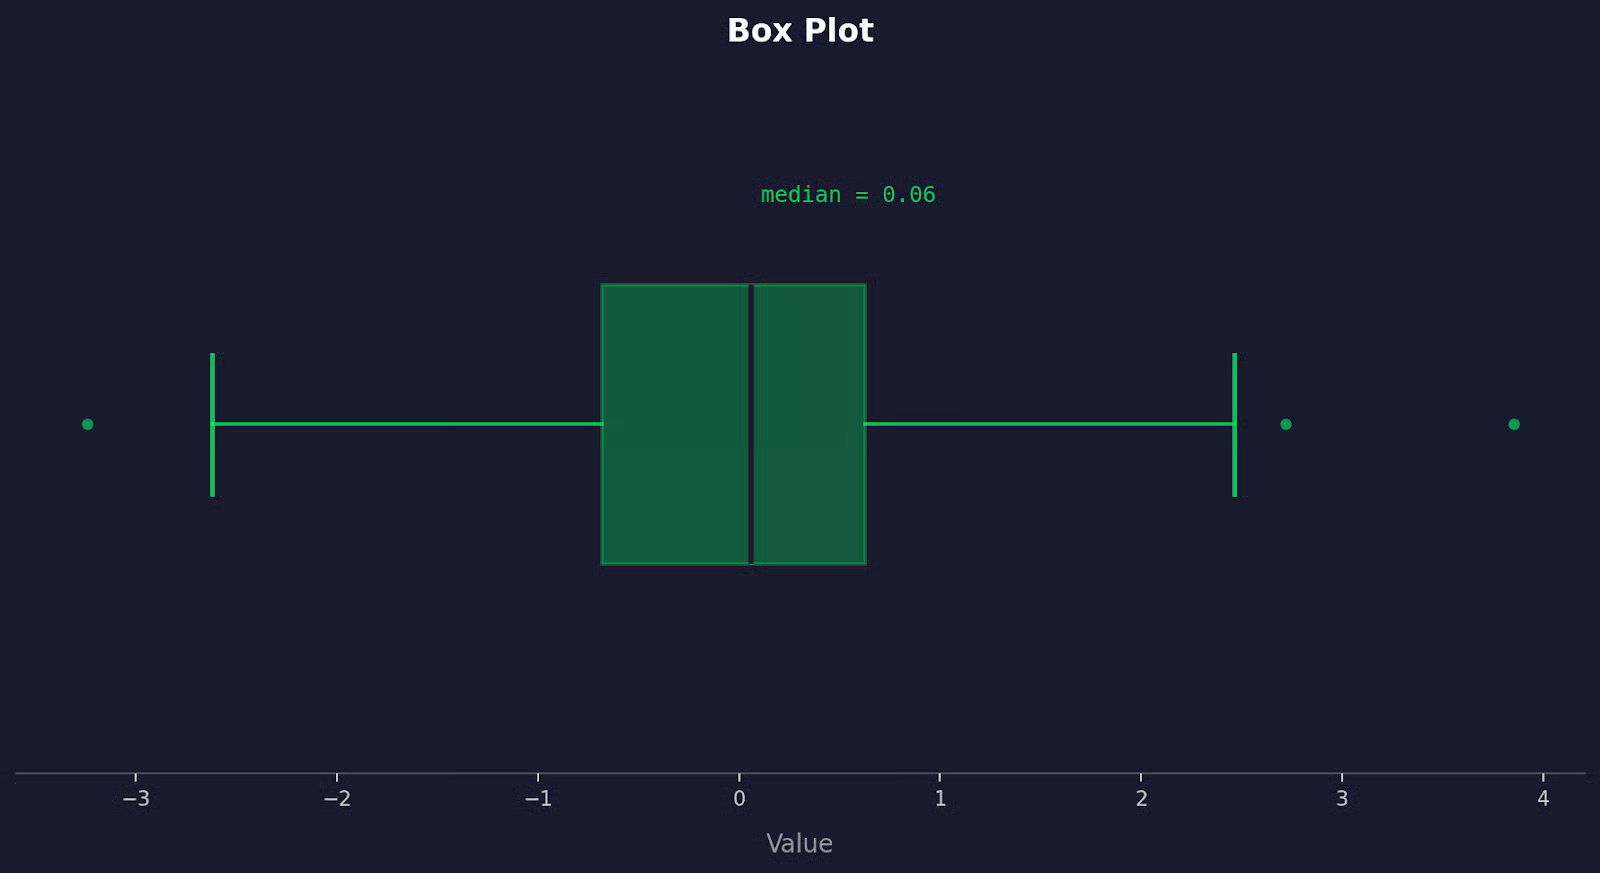
उदाहरण बॉक्स प्लॉट
सामान्य रूप से वितरित डेटासेट ऐसा बॉक्स प्लॉट देता है जिसमें माध्यिका बॉक्स के लगभग केंद्र में बैठती है, और व्हिस्कर्स दोनों ओर लगभग समान लंबाई तक फैले होते हैं। यदि माध्यिका केंद्र से हटकर है, या एक व्हिस्कर दूसरे से बहुत लंबा है—यह झुकाव है। व्हिस्कर्स के बाहर बिंदु अपवाद मान होते हैं।
विज़ुअल्स की सामान्य दिक्कत यह है कि वे व्यक्तिपरक होते हैं। दो लोग एक ही हिस्टोग्राम देखकर असहमत हो सकते हैं। पहले अपने डेटा की समझ बनाने के लिए इन्हें उपयोग करें, फिर औपचारिक परीक्षण से पुष्टि करें।
हर स्थिति में समान रूप से बेहतर काम करने वाला एकल सामान्यता परीक्षण नहीं है। सही चुनाव आपके सैंपल साइज़ और आप क्या पकड़ना चाहते हैं, इस पर निर्भर करता है।
Shapiro-Wilk परीक्षण छोटे से मध्यम सैंपल्स के लिए प्राथमिक पसंद है, आम तौर पर कुछ सौ प्रेक्षणों तक।
यह आपके डेटा को सामान्य वितरण से कितनी नज़दीकी से मेल खाता है, यह मापता है—देखे गए मानों की तुलना उन मानों से करके, जो आप सामान्य डेटा मानने पर अपेक्षित करते। यह व्यापक रूप से इस्तेमाल किया जाता है, भली-भाँति समझा गया है, और हर प्रमुख स्टैट्स लाइब्रेरी में उपलब्ध है। अधिकांश विश्लेषकों के लिए, यह पहला परीक्षण है जिसकी ओर रुख किया जाता है।
इसकी मुख्य सीमा यह है कि बड़े सैंपल साइज़ पर यह अति-संवेदनशील हो जाता है। यह बहुत छोटे, व्यवहार में महत्वहीन विचलनों को भी सांख्यिकीय रूप से महत्वपूर्ण बताता है।
Kolmogorov-Smirnov (KS) परीक्षण आपके सैंपल के संचयी वितरण की सैद्धांतिक वितरण—यहाँ सामान्य—से तुलना करता है।
यह Shapiro-Wilk से अधिक सामान्य है और किसी भी वितरण के विरुद्ध जाँच सकता है, केवल सामान्य के विरुद्ध नहीं। सामान्यता जाँचने में KS परीक्षण Shapiro-Wilk से कम शक्तिशाली है, यानी सूक्ष्म विचलन पकड़ने की संभावना कम है। यह आपको पहले से वितरण के पैरामीटर बताने को भी कहता है, जो यदि आप उसी डेटा से आँकते हैं तो पक्षपात ला सकता है।
जब एक त्वरित, सामान्य प्रयोजन जाँच चाहिए हो तभी उपयोग करें—इसे अपना प्राथमिक सामान्यता परीक्षण न बनायें।
Anderson-Darling परीक्षण KS परीक्षण का एक रूपांतर है, पर एक अहम अंतर के साथ: यह वितरण के टेल्स को अधिक वज़न देता है।
यह इसे उन विचलनों को पकड़ने में बेहतर बनाता है जो चरम भागों में दिखते हैं—भारी टेल्स, अपवाद मान, या गैर-सामान्य बर्ताव जिसे KS परीक्षण छोड़ सकता है। यदि आपके उपयोग-केस में टेल बर्ताव संवेदनशील है, तो Anderson-Darling एक अच्छा चुनाव है।
D'Agostino-Pearson परीक्षण अलग तरीका अपनाता है।
वितरणों की सीधी तुलना करने की बजाय, यह आपके डेटा के दो गुण मापता है: skewness (असममिति) और kurtosis (टेल्स कितनी भारी या हल्की हैं)।
यह दोनों को एक संयुक्त परीक्षण सांख्यिकी में समेटता है। इससे यह केवल यह नहीं बताता कि आपका डेटा सामान्य है या नहीं, बल्कि यह भी संकेत देता है कि सामान्य न होने का कारण क्या हो सकता है। यह बड़े सैंपल्स में सबसे अच्छा काम करता है, जहाँ skewness और kurtosis के आकलन भरोसेमंद होते हैं।
Jarque-Bera परीक्षण भी skewness और kurtosis का उपयोग करता है, D'Agostino-Pearson की तरह।
यह इकोनोमेट्रिक्स और टाइम सीरीज़ विश्लेषण में आम है। D'Agostino-Pearson की तरह, भरोसेमंद परिणामों के लिए इसे भी पर्याप्त बड़ा सैंपल चाहिए। छोटे सैंपल्स में यह परीक्षण बहुत भरोसेमंद नहीं रहता। यदि आप वित्त या अर्थशास्त्र संदर्भ में काम कर रहे हैं, तो आप इसे अक्सर देखेंगे।
सार रूप में, छोटे सैंपल्स के लिए Shapiro-Wilk से शुरू करें और Q-Q प्लॉट के साथ जोड़ें। टेल बर्ताव महत्वपूर्ण हो तो Anderson-Darling लें, और विचलन की प्रकृति समझनी हो तो D'Agostino-Pearson का उपयोग करें।
हर सामान्यता परीक्षण एक परिकल्पना परीक्षण होता है।
किसी भी सामान्यता परीक्षण में शून्य परिकल्पना (null hypothesis) यह होती है कि आपका डेटा सामान्य रूप से वितरित है। परीक्षण फिर पूछता है: डेटा में जो दिख रहा है, उसे देखते हुए यह शून्य परिकल्पना सच होने की कितनी संभावना है?
जवाब p-value के रूप में आता है:
सुनने में सरल है, पर लोग अक्सर यहीं गलती करते हैं।
कम p-value यह नहीं बताती कि आपका डेटा कितना गैर-सामान्य है—बस यह कि कोई अंतर पकड़ा गया है। बड़े सैंपल्स में सामान्यता परीक्षण बेहद संवेदनशील हो जाते हैं। वे इतने छोटे विचलनों को भी फ़्लैग कर देंगे जिनका आपके विश्लेषण पर कोई वास्तविक असर नहीं होगा।
उलटी समस्या भी है। छोटे सैंपल्स में, स्पष्ट रूप से झुके हुए डेटा में भी p > 0.05 आ सकता है क्योंकि परीक्षण में विचलन पकड़ने की शक्ति कम होती है।
सांख्यिकीय महत्व और व्यावहारिक महत्व एक ही चीज़ नहीं हैं।
p-value आपको बताती है कि सामान्यता से प्रस्थान मौजूद है या नहीं। यह नहीं बताती कि वह प्रस्थान आपके विशिष्ट विश्लेषण के लिए मायने रखता है या नहीं। हमेशा अपने परीक्षण परिणाम को Q-Q प्लॉट के साथ देखें—यदि बिंदु रेखा का क़रीबी अनुसरण करते हैं, तो p-value कुछ भी कहे, आपका डेटा संभवतः पर्याप्त रूप से सामान्य है।
Python का scipy.stats मॉड्यूल कुछ पंक्तियों के कोड में सामान्यता परीक्षण चलाने के लिए हर चीज़ देता है।
नीचे के सभी उदाहरणों के लिए, मैं एक ही डेटासेट उपयोग करूँगा—सामान्य वितरण से खींचे गए 100 नमूने—ताकि आप कोड चला कर साथ-साथ चल सकें।
import numpy as np
from scipy import stats

np.random.seed(42)
data = np.random.normal(loc=0, scale=1, size=100)छोटे डेटासेट्स में विशेषकर, पहली जाँच के रूप में shapiro() का उपयोग करें।
stat, p_value = stats.shapiro(data)
print(f"Statistic: {stat:.4f}, p-value: {p_value:.4f}")
आउटपुट कुछ ऐसा मिलता है:
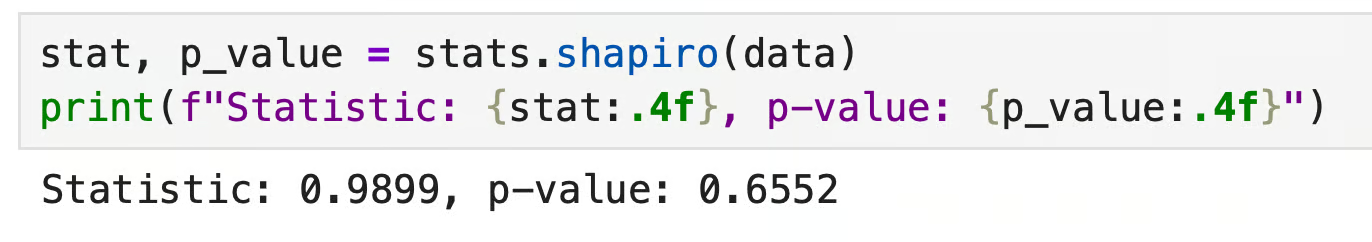
Python में Shapiro-Wilk’s परीक्षण का आउटपुट
p-value 0.05 से काफी ऊपर है, इसलिए हम सामान्यता को अस्वीकार नहीं करते। डेटा सामान्य दिख रहा है—जो समझ में आता है, क्योंकि हमने इसे सामान्य वितरण से जनरेट किया है।
kstest() आपके सैंपल की तुलना किसी नामित वितरण से करता है। सामान्यता के लिए, सैंपल का mean और standard deviation के साथ "norm" पास करें।
stat, p_value = stats.kstest(data, 'norm', args=(data.mean(), data.std()))
print(f"Statistic: {stat:.4f}, p-value: {p_value:.4f}")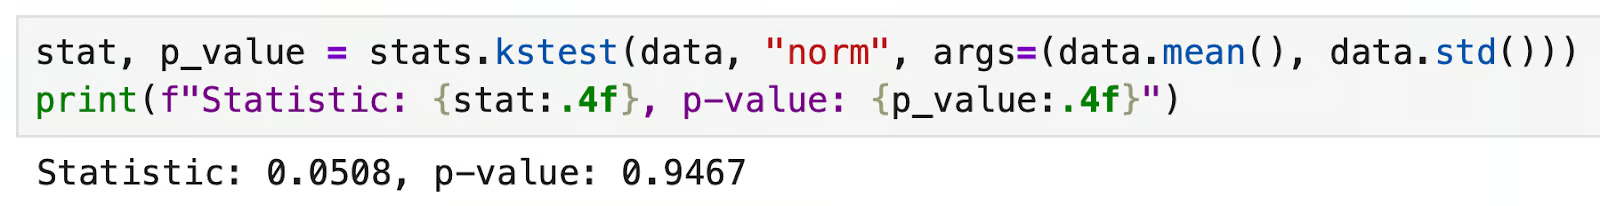
Python में Kolmogorov-Smirnov परीक्षण का आउटपुट
फिर से, p > 0.05—सामान्यता के विरुद्ध कोई साक्ष्य नहीं।
Python में इस परीक्षण के साथ, हमेशा mean और standard deviation को args के माध्यम से स्पष्ट रूप से पास करें। यदि आप इसे छोड़ देते हैं, तो kstest() एक मानक सामान्य (mean=0, std=1) मान लेता है, जो तब तक अविश्वसनीय परिणाम देगा जब तक आपका डेटा पहले से मानकीकृत न हो।
normaltest() संयुक्त रूप से skewness और kurtosis जाँचकर सामान्यता का परीक्षण करता है। यह बड़े सैंपल्स के साथ सबसे बेहतर काम करता है।
stat, p_value = stats.normaltest(data)
print(f"Statistic: {stat:.4f}, p-value: {p_value:.4f}")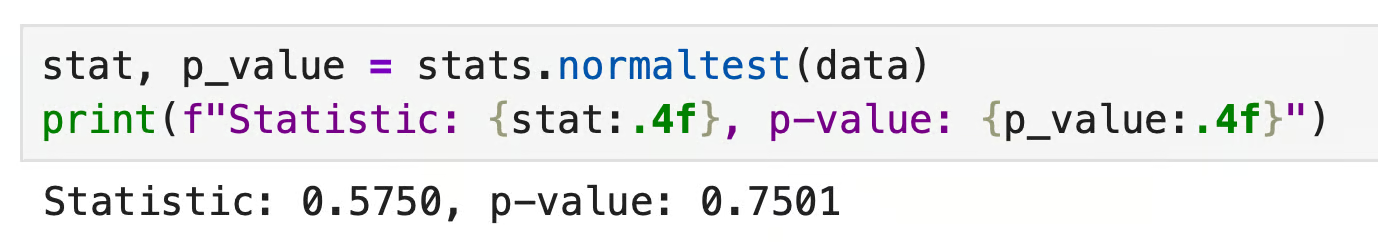
Python में D'Agostino-Pearson परीक्षण का आउटपुट
यहाँ भी p > 0.05। डेटा तीनों परीक्षणों में पास करता है, और यह अपेक्षित है—मैंने इसे सामान्य होने के लिए ही जनरेट किया है। व्यवहार में, आप अक्सर इन परीक्षणों में असहमति देखेंगे, खासकर 0.05 की दहलीज के आसपास। जब ऐसा हो, तो निर्णय के लिए अपने Q-Q प्लॉट पर भरोसा करें।
R में सामान्यता जाँचने के लिए बिल्ट-इन फ़ंक्शन्स हैं। बुनियादी कामों के लिए अतिरिक्त पैकेजों की जरूरत नहीं।
Python उदाहरणों की तरह, मैं यहाँ भी वही डेटासेट उपयोग करूँगा: सामान्य वितरण से 100 नमूने।
set.seed(42)
data <- rnorm(100, mean = 0, sd = 1)shapiro.test() छोटे से मध्यम सैंपल्स के लिए प्राथमिक विकल्प है। अपने डेटा के वेक्टर को बस इसमें पास करें:
shapiro.test(data)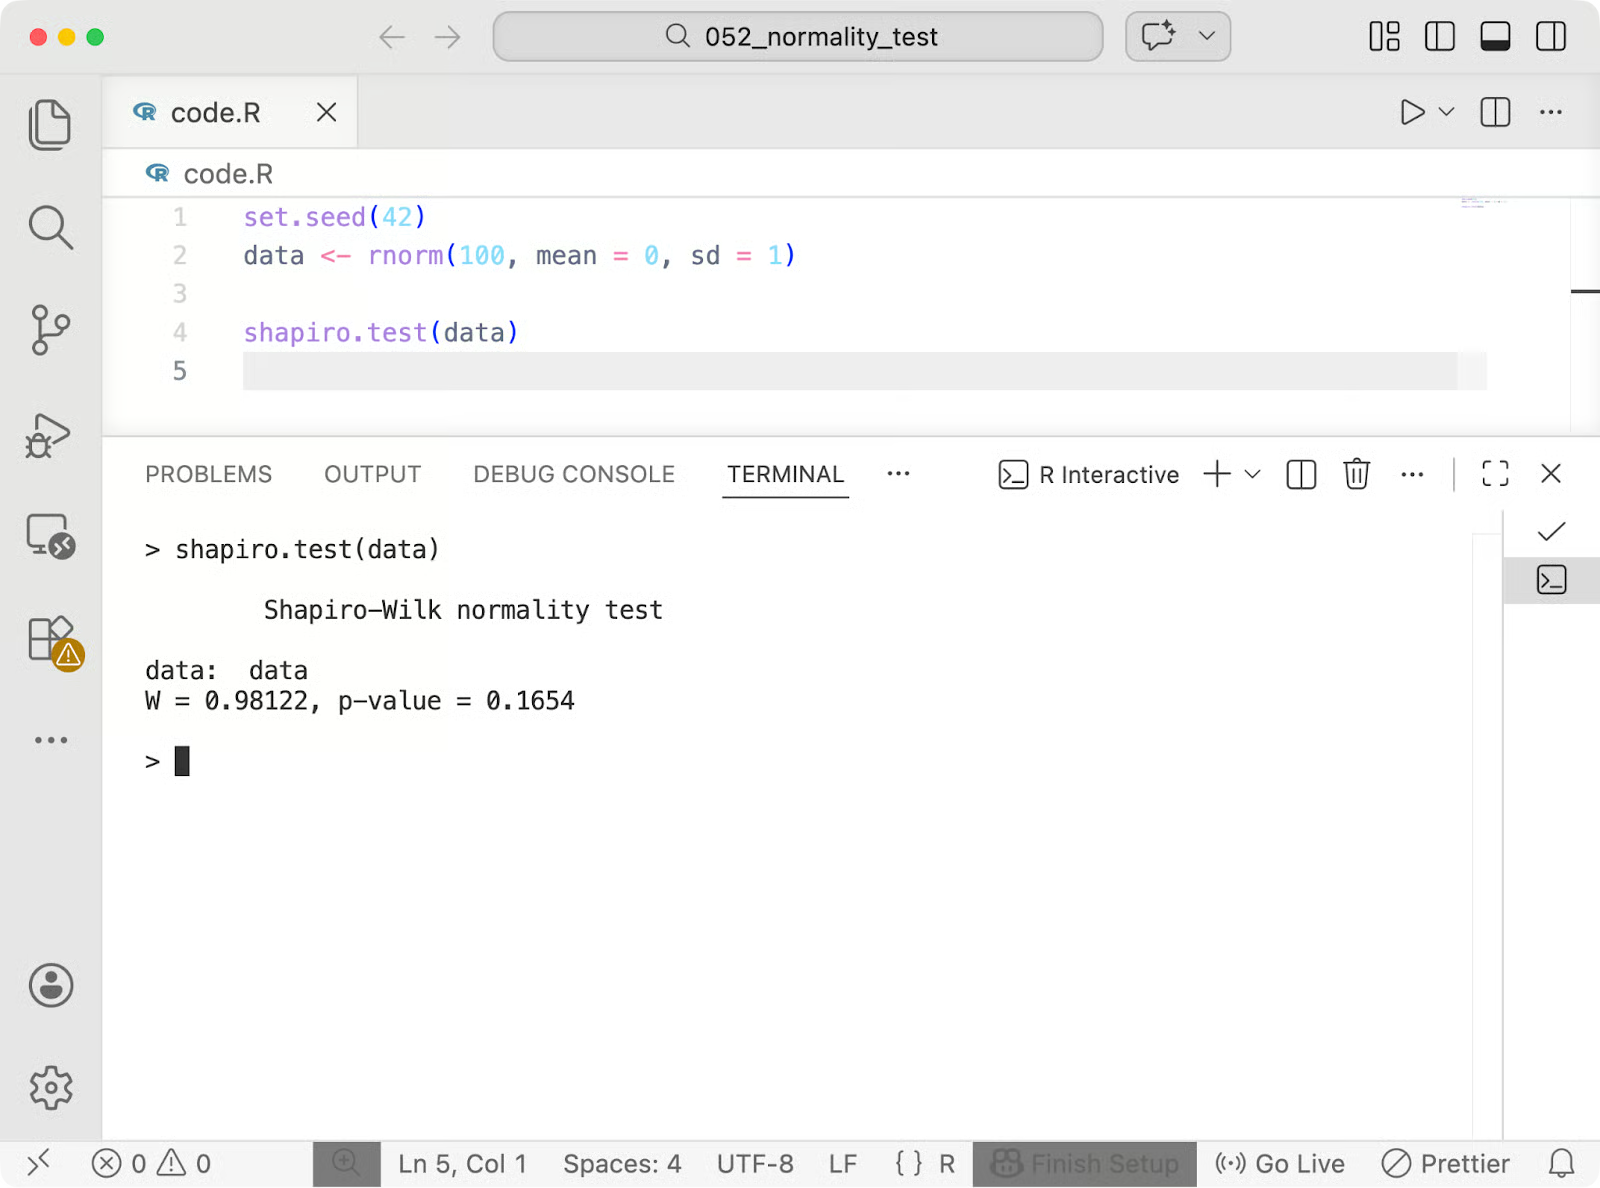
R में Shapiro-Wilk परीक्षण का आउटपुट
p > 0.05 - सामान्यता के विरुद्ध कोई साक्ष्य नहीं। W सांख्यिकीय मान 0 से 1 के बीच होता है, जहाँ 1 के निकट मान दर्शाते हैं कि डेटा सामान्य वितरण का अच्छे से अनुसरण करता है।
ks.test() आपके नमूने की तुलना एक सैद्धांतिक वितरण से करता है। सामान्यता के लिए, "pnorm" निर्दिष्ट करें और नमूने का माध्य और मानक विचलन पास करें।
ks.test(data, "pnorm", mean(data), sd(data))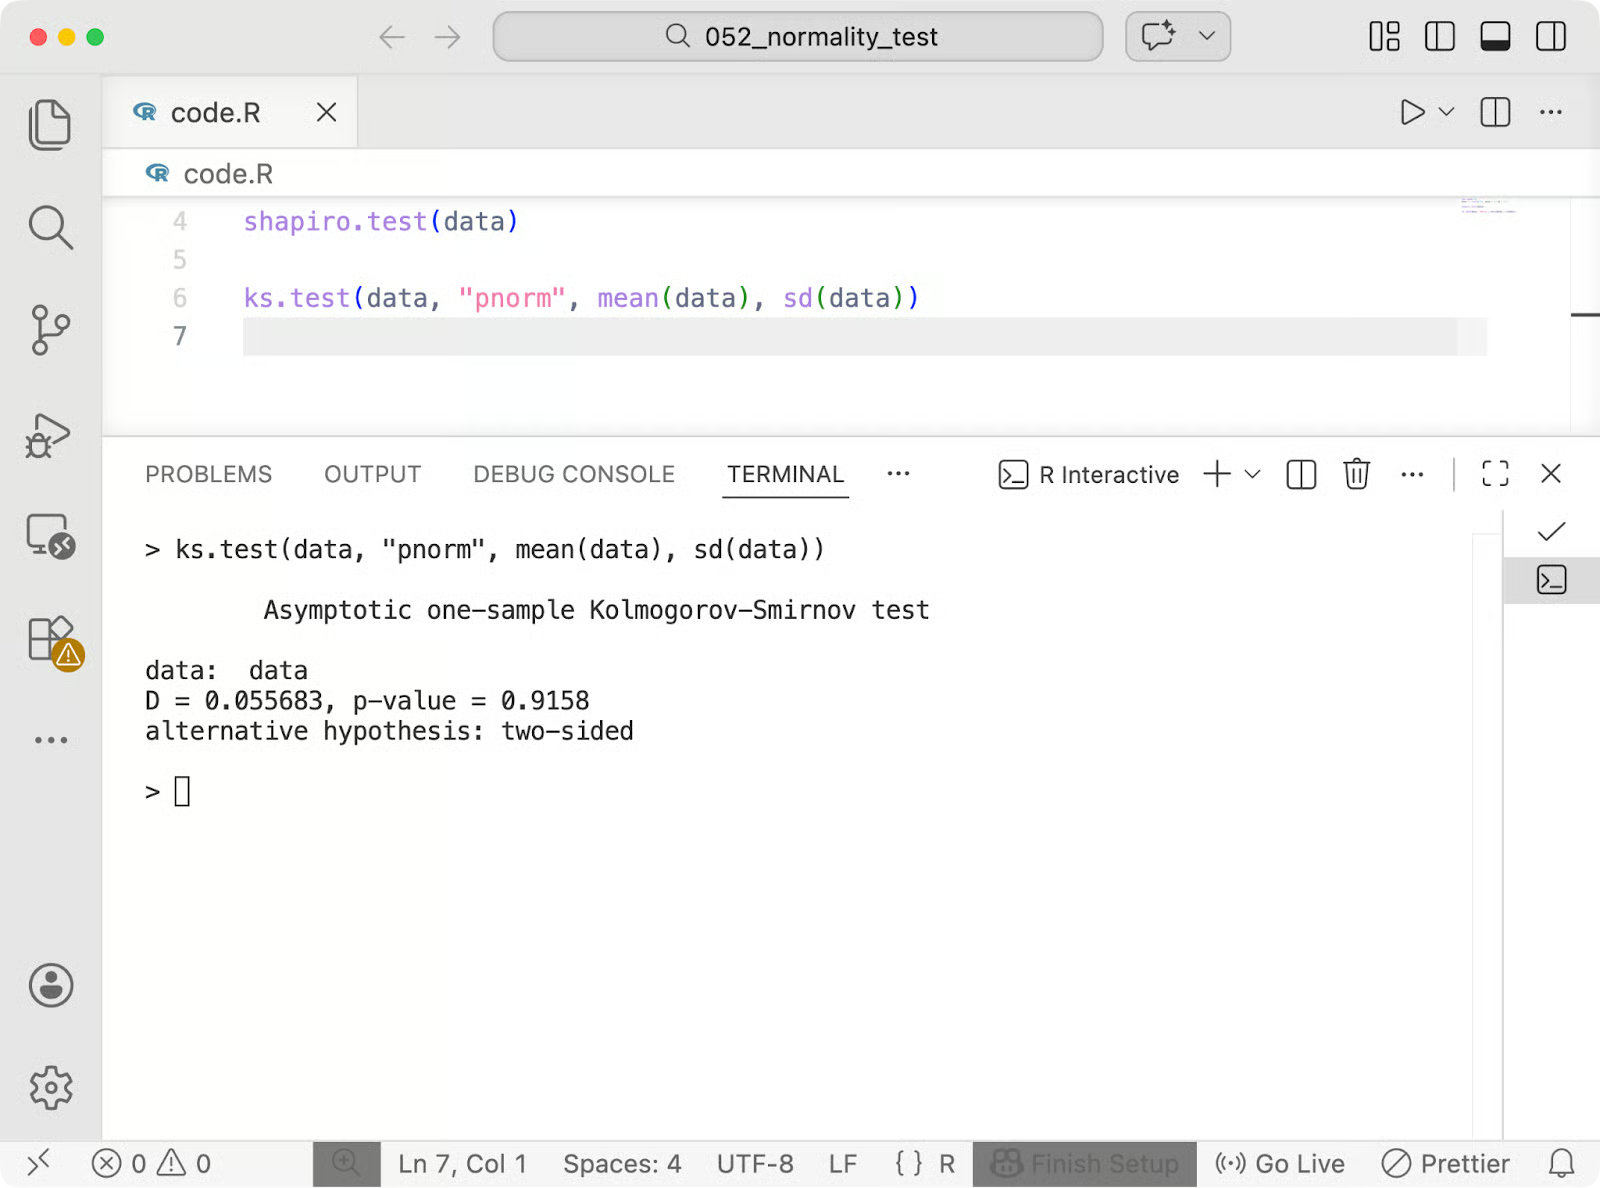
R में Kolmogorov-Smirnov परीक्षण का आउटपुट
फिर से p > 0.05। R में यह परीक्षण Python जैसा ही सावधानी-संदेश रखता है: हमेशा mean(data) और sd(data) पास करें। इन्हें छोड़ने पर मानक सामान्य को डिफ़ॉल्ट माना जाएगा, जो परिणाम को तिरछा कर देगा जब तक कि आपका डेटा पहले से मानकीकृत न हो।
R के बिल्ट-इन qqnorm() और qqline() से आप दो पंक्तियों के कोड में Q-Q प्लॉट बना सकते हैं।
qqnorm(data, main = "Q-Q Plot")
qqline(data, col = "steelblue", lwd = 2)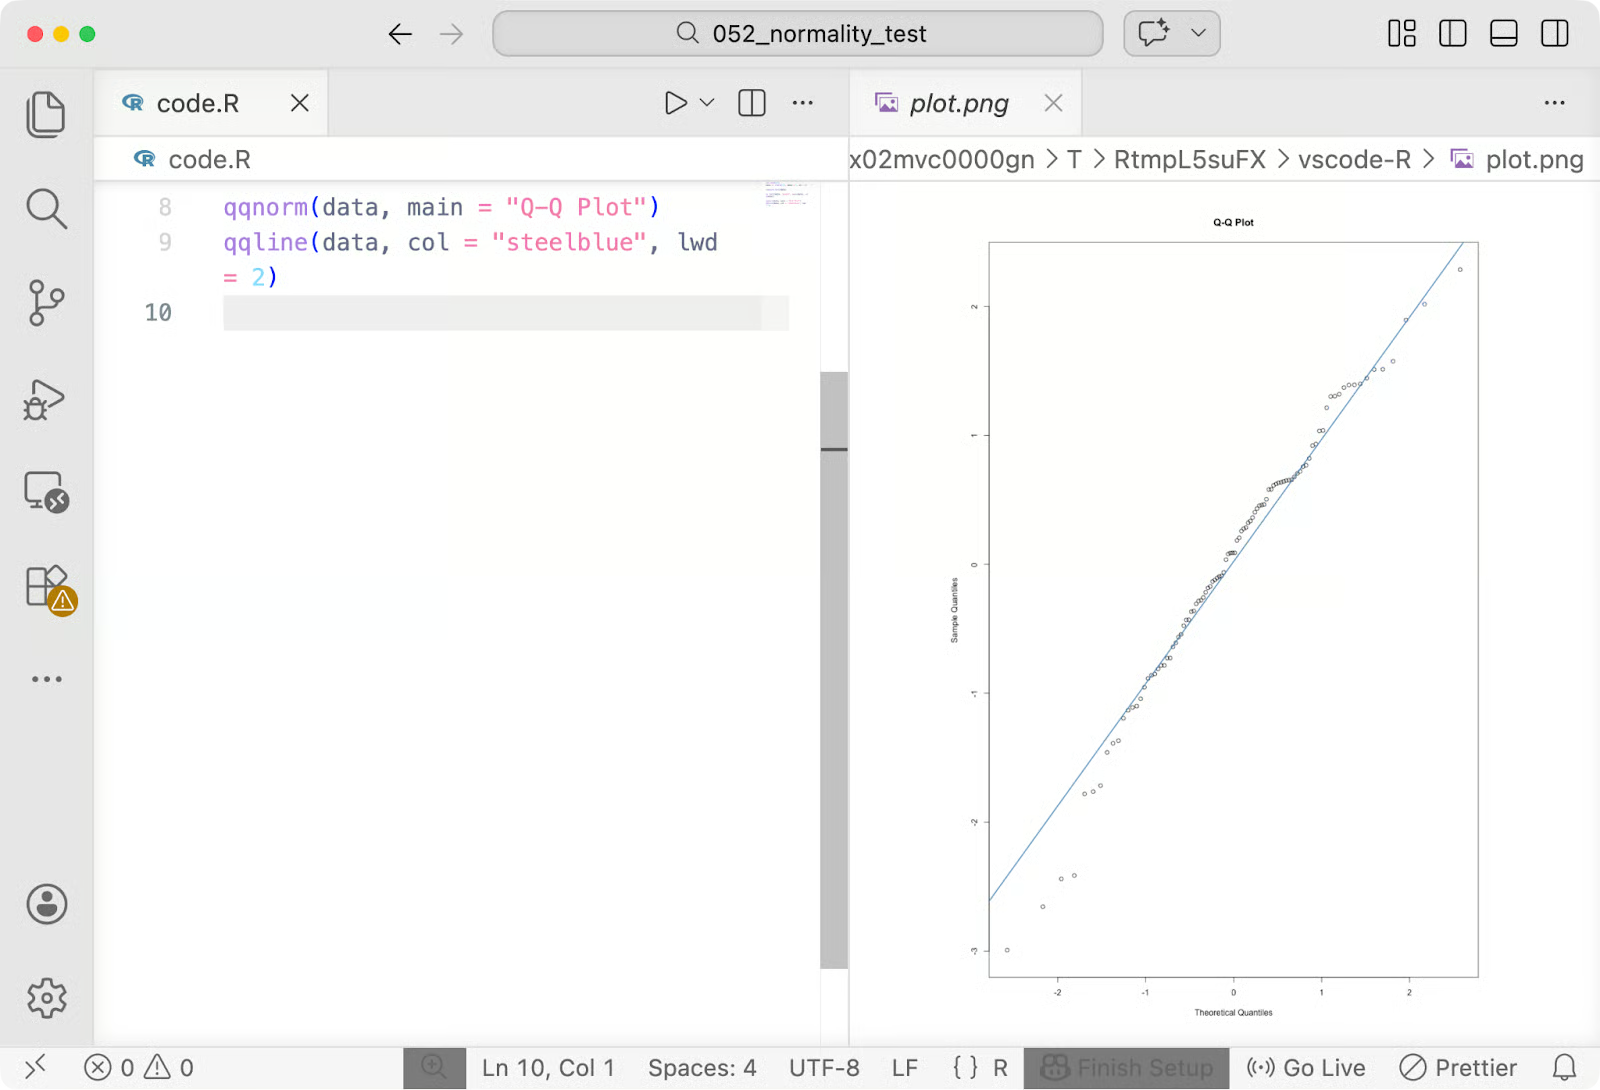
R में Q-Q प्लॉट
qqnorm() आपके नमूने के क्वांटाइल्स को सैद्धांतिक सामान्य क्वांटाइल्स के विरुद्ध प्लॉट करता है। qqline() संदर्भ रेखा खींचता है। बिंदु यदि रेखा का नज़दीकी अनुसरण करते हैं, तो आपका डेटा सामान्य जैसा व्यवहार कर रहा है। सिरों पर विचलन पूंछ-संबंधी मुद्दों का संकेत देते हैं, जिनकी जाँच करना उचित है।
यदि आपका डेटा सामान्यता परीक्षण में असफल रहता है, तो आपके पास कुछ ठोस विकल्प हैं।
कभी-कभी समाधान यह होता है कि डेटा को ऐसा रूप दें कि वह सामान्य जैसा व्यवहार करे, और फिर रूपांतरित मानों पर अपने मूल परीक्षण चलाएँ।
लॉग रूपांतरण सबसे सामान्य विकल्प है। यह दाएँ-पक्षधर (राइट-स्क्यूड) डेटा पर अच्छा काम करता है — जैसे आय, प्रतिक्रिया समय, या जैविक माप जहाँ दाहिनी ओर लंबी पूंछ होती है। Python में फ़ंक्शन है np.log(data), और R में इसका समकक्ष है log(data)।
वर्गमूल रूपांतरण मध्यम पक्षपात के लिए एक हल्का विकल्प है, और तब उपयोगी है जब आपके डेटा में शून्य शामिल हों (क्योंकि शून्य का लॉग नहीं लिया जा सकता)। Python में np.sqrt(data) या R में sqrt(data) का उपयोग करें।
रूपांतरण के बाद, सामान्यता परीक्षण दोबारा चलाएँ। यदि रूपांतरित डेटा पास हो जाता है, तो अपने पैरामीट्रिक परीक्षण जारी रखें — बस यह याद रखें कि व्याख्या रूपांतरित स्केल में ही करें।
यदि रूपांतरण काम नहीं करता या आपके डेटा के लिए अर्थपूर्ण नहीं है, तो गैर-पैरामीट्रिक परीक्षण अपनाएँ। ये सामान्यता मानकर नहीं चलते — ये कच्चे मानों के बजाय रैंक पर काम करते हैं।
दोनों scipy.stats में उपलब्ध हैं (mannwhitneyu() और kruskal()) और R के बेस पैकेज में (wilcox.test() और kruskal.test())।
पर्याप्त बड़े नमूनों के साथ, आप अक्सर सामान्यता की चिंता छोड़ सकते हैं।
केन्द्रीय सीमा प्रमेय कहता है कि जैसे-जैसे आपका नमूना आकार बढ़ता है, माध्य का सैंपलिंग वितरण सामान्य के निकट पहुँचता है — चाहे मूल डेटा का वितरण जैसा भी हो। व्यावहारिक रूप से, इसका मतलब है कि बड़े नमूनों के साथ पैरामीट्रिक परीक्षण सामान्यता के पूर्ण न होने पर भी सामान्यतः भरोसेमंद रहते हैं।
सामान्यता की जाँच आसान है — आपने देखा कि इसमें केवल एक पंक्ति का कोड लगता है। फिर भी, इसे गलत करने के कुछ तरीके हैं।
यहाँ कुछ आम गलतियाँ हैं जो डेटा साइंस के नए लोग अक्सर करते हैं:
तो निष्कर्षतः, सामान्यता परीक्षण आपके डेटा की बस एक जाँच है। इसे कई इनपुट्स में से एक के रूप में उपयोग करें, अंतिम निर्णय के रूप में नहीं।
सामान्यता परीक्षण हमेशा आवश्यक नहीं है। यदि आप समय-सीमा में हैं, तो यह जानना कि कब इसे छोड़ना है, बिना परिणामों को प्रभावित किए आपका समय बचा सकता है।
जब आपका नमूना बड़ा हो, तो केन्द्रीय सीमा प्रमेय यह सुनिश्चित करता है कि माध्य का सैंपलिंग वितरण आपके कच्चे डेटा के आकार की परवाह किए बिना लगभग सामान्य होगा। ऐसी स्थिति में पैरामीट्रिक परीक्षण सामान्यतः भरोसेमंद होते हैं, इसलिए औपचारिक सामान्यता परीक्षण चलाने से बहुत कम अतिरिक्त मूल्य मिलता है।
कुछ सांख्यिकीय विधियाँ सामान्यता-उल्लंघन के प्रति भी सुदृढ़ (robust) होती हैं। जैसे कि रैखिक प्रतिगमन, जब नमूना आकार उचित हों और उल्लंघन अत्यधिक न हों, तो सामान्यतः अच्छा प्रदर्शन करता है। (रैखिक प्रतिगमन फिर भी अवशेषों में सामान्यता मानता है।)
जब आप पैटर्न ढूँढ़ रहे हों, अंतर्दृष्टि बना रहे हों, या यह तय कर रहे हों कि किन चर पर आगे जाँच करनी है, तो एक त्वरित हिस्टोग्राम या Q-Q प्लॉट पर्याप्त है। औपचारिक परीक्षण पुष्टिकारी (confirmatory) विश्लेषण के लिए हैं — जब आपके निष्कर्षों को टिकाऊ होना चाहिए।
याद रखें कि सामान्यता परीक्षण आपको गलत निष्कर्षों से बचाने के लिए है। यदि आप ऐसे संदर्भ में हैं जहाँ गलत निष्कर्ष के वास्तविक परिणाम नहीं हैं, या जहाँ आपकी विधि सामान्यता पर निर्भर नहीं करती, तो परीक्षण वैकल्पिक है।
सामान्यता परीक्षण का उद्देश्य यह जाँचना है कि आपकी मान्यताएँ आपके परिणामों पर भरोसा करने के लिए पर्याप्त रूप से सही हैं या नहीं।
कोई भी डेटासेट पूर्णतः सामान्य नहीं होता। लक्ष्य यह समझना है कि आपका डेटा कैसे व्यवहार करता है, और उसी के अनुसार विधियाँ चुनना। Q-Q प्लॉट आपको बताता है कि विचलन कहाँ हैं। औपचारिक परीक्षण यह बताता है कि क्या वे सांख्यिकीय रूप से पता लगाए जा सकते हैं। साथ मिलकर, वे अकेले-अकेले से अधिक स्पष्ट तस्वीर देते हैं।
उचित परीक्षण आपके संदर्भ पर निर्भर करता है। छोटे नमूनों के लिए Shapiro-Wilk का उपयोग करें, पूंछ अहम हों तो Anderson-Darling, और जब सामान्यता मान नहीं सकते तो गैर-पैरामीट्रिक विकल्प। और कभी-कभी — बड़े नमूनों या सुदृढ़ विधियों के साथ — कोई परीक्षण नहीं भी चलेगा।
क्या आपको p-मूल्यों की पूरी अवधारणा उलझाऊ लगती है? हमारा Hypothesis Testing Made Easy लेख पढ़ें ताकि आप इन्हें सही तरीके से समझ सकें।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स