Phân phối Chuẩn Tắc: Khái niệm và Lý do Quan trọng
Tìm hiểu các nền tảng của phân phối chuẩn tắc và tầm quan trọng của nó trong thống kê, khoa học dữ liệu và máy học. Học cách áp dụng khái niệm này vào phân tích dữ liệu thực tế.
Bạn có thể dễ dàng bắt gặp đường cong hình chuông—có nhiều tên gọi như phân phối chuẩn hay phân phối Gaussian—ở khắp nơi, đặc biệt nếu bạn quan tâm đến thống kê hoặc khoa học dữ liệu. Điều này không phải là “ngẫu nhiên của tự nhiên”: Hóa ra rất nhiều thứ chúng ta đo lường là kết quả của nhiều yếu tố nhỏ cộng dồn, gợi ý sự hiện diện của một mô hình cộng ngầm phía sau.
Bằng cách biến đổi bất kỳ phân phối chuẩn nào thành một dạng đặc biệt gọi là phân phối chuẩn tắc, chúng ta có được một phân phối đặc biệt hữu ích trong một số bối cảnh, như tính xác suất, suy luận thống kê và áp dụng các kiểm định thống kê. Đến cuối bài viết này, bạn sẽ hiểu phân phối chuẩn tắc là gì, vì sao chúng ta thực hiện bước chuẩn hóa này và mối liên hệ của tất cả điều đó với biến thiên, xác suất và kiểm định giả thuyết. Cuối bài, tôi cũng hy vọng bạn sẽ đăng ký khóa Nhập môn Thống kê với R hoặc lộ trình kỹ năng Suy luận Thống kê trong R để tiếp tục xây dựng trên các ý tưởng trong bài viết này.
Phân phối Chuẩn Tắc là gì?
Phân phối chuẩn tắc là một trường hợp cụ thể của phân phối chuẩn, trong đó kỳ vọng bằng không và độ lệch chuẩn bằng một. Ta cũng cần nói rằng phân phối này đối xứng và xác suất của các giá trị nhất định giảm đối xứng khi bạn rời xa tâm.
"Phân phối Chuẩn Tắc" Hình ảnh bởi Dall-E
Hiểu các phương trình của Phân phối Chuẩn Tắc
Hãy xem xét kỹ hơn một chút các khía cạnh toán học của phân phối chuẩn tắc.
Hàm mật độ xác suất (PDF) của phân phối chuẩn tắc
Nếu bạn chưa quen với khái niệm hàm mật độ xác suất (PDF), hãy biết rằng nó mô tả cách xác suất được phân bố trên các giá trị có thể có của một biến ngẫu nhiên liên tục. Mọi phân phối xác suất liên tục, như phân phối mũ, phân phối t hay phân phối Cauchy, đều có hàm mật độ xác suất riêng xác định đường cong của nó. PDF của phân phối chuẩn tắc được định nghĩa như sau:
Hàm này đảm bảo diện tích dưới đường cong bằng 1. Nếu bạn nhìn vào phương trình và thay các giá trị khác nhau của x, bạn sẽ nhận được độ cao của đường cong tại những điểm đó. Trong phương trình:
x biểu diễn bất kỳ số thực nào và là biến đầu vào của hàm. Nó xuất hiện ở số mũ của hàm, là −x2/2. Điều này điều khiển hình dạng đường cong.
Vì x2 luôn không âm, và có dấu trừ phía trước, nên số mũ luôn âm hoặc bằng 0.
Trong trường hợp cụ thể x=0, số mũ là lớn nhất, khiến f(x) đạt đỉnh.
Khi x rời xa 0 theo cả hướng dương hoặc âm, x2 tăng, làm số mũ âm hơn. Một số mũ âm hơn dẫn tới giá trị hàm nhỏ hơn, nghĩa là, cùng với các điều ta đã nói, f(x) giảm đối xứng ở hai phía của x=0.
Cơ số của số mũ, là số Euler, đảm bảo hàm suy giảm nhanh khi x đi xa khỏi 0 theo cả hai phía.
Hằng số 1/√(2π) đảm bảo tổng diện tích dưới đường cong bằng 1.
Hàm phân phối tích lũy (CDF) của phân phối chuẩn tắc
Khác với PDF, vốn cho ta độ cao tương đối của các giá trị khác nhau, CDF cho bạn biết xác suất biến nhỏ hơn hoặc bằng một giá trị cho trước. Tương tự PDF, mỗi phân phối xác suất liên tục đều có CDF riêng.
Phương trình này phức tạp hơn một chút, nhưng ta có thể phân tích như sau:
Ký hiệu tích phân nghĩa là thay vì cho biết độ cao đường cong tại x, CDF cho ta tổng xác suất từ −∞ đến x.
Khi x→−∞, CDF tiến dần về 0.
Khi x=0 thì CDF bằng 0,5, vì phân phối đối xứng và một nửa xác suất nằm bên trái 0.
Khi x→∞, CDF tiến dần về 1.
Vì sao chúng ta quan tâm đến Phân phối Chuẩn Tắc
Bài hướng dẫn về phân phối Gaussian của chúng tôi có nhiều ý hay về thời điểm bạn có thể muốn làm cho dữ liệu tuân theo phân phối chuẩn. Nhưng đôi khi, bạn lại muốn chuyển dữ liệu thành đúng phân phối chuẩn tắc. Dưới đây là vài lý do phổ biến:
Chuẩn tắc được dùng trong kiểm định giả thuyết
Phân phối chuẩn tắc giúp dữ liệu so sánh được và phù hợp với một số phương pháp thống kê. Bằng cách chuyển dữ liệu thành điểm Z, ta có thể so sánh các quan sát giữa các phân phối chuẩn khác nhau. Đặc biệt, đây là cơ sở của kiểm định Z, dùng khi ta muốn xác định xem trung bình mẫu có khác biệt có ý nghĩa so với trung bình tổng thể hay không.
Trong khi đó, kiểm định t sử dụng độ lệch chuẩn mẫu như một ước lượng cho độ lệch chuẩn tổng thể, vì vậy nó dựa trên phân phối t, có đuôi dày hơn phân phối chuẩn tắc. Đọc hướng dẫn T-test vs. Z-test: Khi nào dùng cái nào, nơi bàn về các khái niệm như phương sai tổng thể và phương sai mẫu.
Chuẩn tắc giúp so sánh dữ liệu trên cùng một thang
Vì các tập dữ liệu và biến khác nhau có thể có đơn vị và thang đo khác nhau, việc so sánh trực tiếp có thể khó. Nhưng khi bạn chuyển chúng sang điểm Z bằng cách trừ đi trung bình và chia cho độ lệch chuẩn, bạn có thể dễ dàng so sánh giữa các phân phối khác nhau. Khi áp dụng cho một tập dữ liệu có phân phối chuẩn, điều này tạo ra mộtphân phối chuẩn tắc. Ví dụ, chuyển cả điểm SAT và GRE—mà tôi kỳ vọng đều phân phối gần chuẩn—sang điểm Z cho phép ta so sánh hiệu suất của sinh viên tương đối với quần thể dự thi tương ứng.
Chuẩn tắc dùng trong kiểm soát chất lượng
Phân phối chuẩn tắc được biết là quan trọng trong việc giám sát chất lượng sản phẩm trong sản xuất. Bằng cách xem xét kỹ xác suất, nhà sản xuất có thể xác định liệu biến động chất lượng là do ngẫu nhiên hay do vấn đề tiềm ẩn khác. Điều này liên quan đến kiểm định giả thuyết mà chúng ta đã đề cập, và cả bảng điểm Z mà chúng ta sẽ nói bên dưới.
Chuẩn tắc dùng trong mô hình thống kê
Phân phối chuẩn tắc đóng vai trò trong đánh giá sai số của các mô hình như hồi quy tuyến tính và dự báo chuỗi thời gian. Trong các mô hình này, ta giả định phần dư—chênh lệch giữa giá trị quan sát và dự đoán—không chỉ tuân theo phân phối chuẩn mà còn có thể được chuẩn hóa để theo phân phối chuẩn tắc.
Trong hồi quy tuyến tính, phần dư chuẩn hóa là phần dư đã được chuyển thành giá trị chuẩn hóa, cho phép ta đo độ “cực đoan” của sai số theo đơn vị độ lệch chuẩn, giúp dễ phát hiện ngoại lệ. Điều này hữu ích vì phương sai không đồng nhất ở phần dư—vốn có thể không hiển hiện qua các biến dự báo—có thể làm sai lệch cách diễn giải phần dư.
Trong phân tích chuỗi thời gian, sai số dự báo thường được giả định tuân theo phân phối chuẩn tắc khi đã chuẩn hóa đúng cách. Điều này quan trọng để xây dựng khoảng dự báo. Nhiều mô hình chuỗi thời gian, như ARIMA, dựa vào các phân vị của chuẩn tắc để xác định biên độ tin cậy quanh dự báo. Ngoài ra, trong phân rã chuỗi thời gian, thành phần phần dư—bắt các dao động bất thường—thường được thấy là phân phối chuẩn. Nếu bạn chuẩn hóa thành phần này, bạn có thể tìm xác suất của các giá trị cực đoan trong chuỗi mà bạn biết không do xu hướng–chu kỳ hay mùa vụ gây ra. Khóa Dự báo trong R của chúng tôi sẽ dạy bạn những kỹ thuật như vậy.
Tôi cũng nghĩ đến phân tích thành phần chính, vốn thường được dùng như một kỹ thuật tiền xử lý. Trong PCA, ta muốn các đặc trưng đầu vào có trung bình bằng 0 và phương sai bằng 1 để tránh việc các đặc trưng có giá trị lớn chi phối. Một bước tiền xử lý thường gặp là chuẩn hóa dữ liệu bằng cách trừ đi trung bình và chia cho độ lệch chuẩn. Điều này đảm bảo mỗi đặc trưng có trung bình 0 và phương sai 1, nhưng cần rõ rằng nó không áp đặt tính chuẩn. Tuy nhiên, trong một số trường hợp, tôi kỳ vọng dữ liệu biến đổi sẽ xấp xỉ chuẩn nếu phân phối ban đầu đã gần chuẩn.
Chuẩn tắc dùng để tính xác suất
Hàm phân phối tích lũy của phân phối chuẩn tắc—mà ta đã bàn—được lập bảng tốt, tức là đã được tính sẵn và sắp xếp thành các bảng phổ biến rộng rãi, giúp việc tính xác suất dễ dàng hơn vì bạn chỉ cần tra cứu giá trị phù hợp.
Ví dụ, để tìm xác suất một chiều cao chọn ngẫu nhiên nhỏ hơn 6 feet, ta chuẩn hóa chiều cao đó theo phân phối chuẩn của quần thể và tra điểm Z trong bảng chuẩn tắc. Tôi đã đặt một phiên bản bảng chuẩn tắc ở cuối bài viết phòng khi bạn cần dùng.
Các biến đổi để đưa dữ liệu về Phân phối Chuẩn Tắc
Các phép biến đổi có thể giúp tái định dạng dữ liệu về phân phối chuẩn tắc. Nói đại khái, đây là quy trình hai bước. Trước tiên, ta định dạng lại dữ liệu để trở nên chuẩn, rồi thực hiện chuẩn hóa điểm Z.
Lưu ý, bạn thường không áp dụng chuẩn hóa điểm Z ngay từ đầu vì các giá trị cực đoan có thể làm méo độ lệch chuẩn—do trung bình và độ lệch chuẩn nhạy với ngoại lệ. Ngoài ra, một số phép biến đổi yêu cầu dữ liệu dương. Nếu bạn chuẩn hóa điểm Z trước, các giá trị đã trừ trung bình có thể bao gồm số âm, gây vấn đề cho các phép biến đổi chỉ áp dụng với giá trị dương. Tôi đang nói riêng về logarit. Vì vậy, tốt nhất là đi theo thứ tự: bước 1 rồi bước 2.
Bước 1: Biến đổi dữ liệu để trở nên chuẩn
Một số ý tưởng biến đổi bạn có thể dùng gồm:
Biến đổi log cho dữ liệu lệch phải
Khi dữ liệu lệch phải, biến đổi log có thể giúp “chuẩn hóa” hơn. Ví dụ, áp dụng log lên giá trị thô sẽ nén các giá trị lớn, giảm độ lệch và tạo phân phối đối xứng hơn.
Biến đổi căn bậc hai cho dữ liệu đếm
Với dữ liệu đếm hoặc tập dữ liệu lệch vừa phải, ta có thể thử biến đổi căn bậc hai. Cách này giảm biến thiên trong khi vẫn duy trì cấu trúc đối xứng hơn, đưa dữ liệu gần hơn với dạng hình chuông.
Biến đổi Box-Cox để điều chỉnh linh hoạt
Biến đổi Box-Cox tiến thêm một bước bằng cách điều chỉnh phù hợp với dữ liệu. Tham số λ xác định công thức áp dụng chính xác, khiến phương pháp này rất linh hoạt để đưa dữ liệu phù hợp với các đặc tính của phân phối chuẩn tắc. Khóa Xây dựng Đặc trưng trong R sẽ giới thiệu Box-Cox cùng nhiều phương pháp quan trọng, hữu ích khác.
Bước 2: Thực hiện chuẩn hóa điểm Z
Sau khi đã áp dụng biến đổi, dữ liệu có thể được chuẩn hóa để khớp phân phối chuẩn tắc. Điều này điều chỉnh dữ liệu sao cho có trung bình bằng 0 và độ lệch chuẩn bằng 1. Công thức điểm Z là:
trong đó X là dữ liệu đã biến đổi, μ là trung bình, và σ là độ lệch chuẩn.
Giờ, nếu bạn quen với phân biệt điểm Z của tổng thể và của mẫu—như chúng tôi đề cập trong lộ trình Suy luận Thống kê trong R—bạn có thể nhận ra phương trình trên là công thức điểm Z cho tổng thể. Nếu bạn làm việc với mẫu thay vì toàn bộ tổng thể, ta sẽ ước lượng trung bình và độ lệch chuẩn thay thế:
Ở đây, X gạch ngang là trung bình mẫu, và s là độ lệch chuẩn mẫu.
Kết quả sẽ tương tự nếu bạn dùng trung bình và độ lệch chuẩn từ tập dữ liệu đã chuẩn hóa mới. Nhưng đôi khi, nhà nghiên cứu quan tâm so sánh dữ liệu tương đối với một quần thể tham chiếu lớn hơn bằng cách dùng một loại trung bình và độ lệch chuẩn chuẩn mực.
Hãy hình dung bạn xem xét một tập dữ liệu thu nhập—vốn lệch phải—và thực hiện biến đổi log để làm gần chuẩn. Sau đó, giả sử ta muốn so sánh thu nhập tương đối với các chuẩn mực quốc gia, khi đó ta sẽ dùng trung bình và độ lệch chuẩn quốc gia thay vì từ mẫu của ta để tính điểm Z. Mục đích là cho phép so sánh có ý nghĩa giữa các tập dữ liệu hoặc nghiên cứu.
Tóm lại, nếu bạn dùng mẫu, về mặt kỹ thuật, bạn thu được một xấp xỉ chuẩn tắc đã chuẩn hóa chứ không phải phân phối chuẩn tắc lý thuyết chính xác. Tôi nghĩ đây là phân biệt đáng nêu, dù khác biệt sẽ nhỏ với các tập dữ liệu lớn.
Trực quan hóa Phân phối Chuẩn Tắc
Dưới đây là một cách tạo phân phối chuẩn tắc lý thuyết trong ngôn ngữ R. Trong đoạn mã này, tôi cũng thêm các đường thẳng đứng cho các điểm chuẩn, hay còn gọi là điểm Z, là cách cho ta biết, với một giá trị bất kỳ, nó cách trung bình tổng thể bao nhiêu độ lệch chuẩn.
install.packages("ggplot2")
library(ggplot2)
ggplot(data.frame(x = c(-4,4)), aes(x))+
stat_function(fun = dnorm, geom ="area", fill ='#ffe6b7', color ='black', alpha =0.5, args = list( mean =0, sd =1))+
labs(title ="Standard Normal Distribution", subtitle ="Standard Deviations and Z-Scores")+
theme(plot.title = element_text(hjust =0.5, face ="bold"))+
theme(plot.subtitle = element_text(hjust =0.5))+
geom_vline(xintercept =1, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-1, linetype ='dotdash', color ="black")+
geom_vline(xintercept =2, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-2, linetype ='dotdash', color ="black")+
geom_vline(xintercept =3, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-3, linetype ='dotdash', color ="black")+
geom_text(aes(x=1, label="\n 1 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=2, label="\n 2 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=3, label="\n 3 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-1, label="\n-1 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-2, label="\n-2 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-3, label="\n-3 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))Được hỗ trợ bởi
Bạn nên biết có một số phân phối tương tự trông giống chuẩn tắc nhưng không phải:
Quay lại điều tôi đã đề cập: bảng chuẩn tắc, còn gọi là bảng điểm Z hay Z-table, dùng để tìm xác suất tích lũy cho một điểm Z—đại diện số độ lệch chuẩn mà một giá trị cách trung bình trong phân phối chuẩn tắc. Bảng này thường dùng trong thống kê cho kiểm định giả thuyết, khoảng tin cậy và tính xác suất. Ý tưởng là thay vì tính xác suất thủ công, bạn có thể tra bảng để nhanh chóng xác định tỷ lệ giá trị nằm dưới một điểm Z cho trước.
Bảng cần một chút luyện tập để đọc, và các bảng đôi khi có bố cục khác nhau. Ở đây, bạn thấy cấu trúc hai chiều. Mục đích là giúp tra xác suất cho điểm Z khi làm việc với phần thập phân. Trong trường hợp này, cột ngoài cùng bên trái chứa phần nguyên và chữ số thập phân đầu tiên của điểm Z. Hàng trên cùng biểu diễn chữ số thập phân thứ hai. Để tìm xác suất tương ứng với một điểm Z cụ thể, hãy xác định hàng tương ứng với phần đầu của điểm Z, rồi tìm cột khớp chữ số thập phân thứ hai. Giá trị tại giao điểm của hàng và cột này là xác suất tích lũy, tức tỷ lệ điểm dữ liệu nằm dưới điểm Z đó.
Tốt nhất là minh họa bằng ví dụ: Giả sử bạn tính được điểm Z là 0,32 cho điểm bài kiểm tra của một học sinh. Điều này nghĩa là điểm số nằm trên trung bình 0,32 độ lệch chuẩn. Giờ, hãy dùng Z-table để tìm xác suất một giá trị chọn ngẫu nhiên nhỏ hơn điểm Z này.
Bước 1: Tìm hàng 0,3.
Bước 2: Tìm cột 0,02.
Bước 3: Xem tạigiao điểm của hàng 0,3 và cột 0,02. Giá trị tại vị trí này là 0,6915.
Xác suất tích lũy cho Z = 0,32 là 0,6554, nghĩa là 65,54% giá trị trong phân phối chuẩn tắc nhỏ hơn 0,32 độ lệch chuẩn phía trên trung bình. Nếu bạn cần xác định xác suất một giá trị lớn hơn một điểm Z cho trước, hãy lấy 1 trừ đi giá trị trong bảng trước khi tìm hàng và cột.
Tôi là một cây bút và biên tập viên về khoa học dữ liệu, đã có bài đóng góp cho các nghiên cứu đăng trên tạp chí khoa học. Tôi đặc biệt quan tâm đến đại số tuyến tính, thống kê, R và các chủ đề tương tự. Tôi cũng chơi cờ vua khá thường xuyên!
Câu hỏi thường gặp về Phân phối Chuẩn Tắc
Phân phối chuẩn tắc khác gì so với phân phối chuẩn?⌄
Phân phối chuẩn tắc là một trường hợp cụ thể của phân phối chuẩn, trong đó trung bình bằng 0 và độ lệch chuẩn bằng 1. Việc chuẩn tắc hóa này giúp tính toán xác suất và so sánh giữa các tập dữ liệu dễ dàng hơn.
Việc trừ trung bình và chia cho độ lệch chuẩn có tạo ra phân phối chuẩn tắc không ⌄
Việc trừ đi trung bình và chia cho độ lệch chuẩn biến đổi một tập dữ liệu thành dạng chuẩn hóa, nhưng không nhất thiết tạo ra phân phối chuẩn tắc trừ khi dữ liệu gốc vốn đã phân phối chuẩn.
Mối quan hệ giữa phân phối chuẩn tắc và định lý giới hạn trung tâm là gì?⌄
Định lý giới hạn trung tâm cho biết tổng của nhiều biến ngẫu nhiên độc lập, phân phối như nhau sẽ có xu hướng tuân theo phân phối chuẩn, và khi đó có thể được chuẩn hóa về dạng chuẩn tắc.
Điểm Z biểu diễn điều gì trong phân phối chuẩn tắc?⌄
Điểm Z cho ta biết một giá trị cách trung bình bao nhiêu độ lệch chuẩn. Điểm Z dương nghĩa là giá trị nằm trên trung bình, còn điểm Z âm nghĩa là nằm dưới trung bình.
Phân phối chuẩn tắc liên quan thế nào đến khoảng tin cậy?⌄
Các khoảng tin cậy sử dụng điểm Z để xác định dải xác suất khi ước lượng tham số tổng thể. Ví dụ, khoảng tin cậy 95% tương ứng với điểm Z xấp xỉ ±1,96.


Bạn có thể dễ dàng bắt gặp đường cong hình chuông—có nhiều tên gọi như phân phối chuẩn hay phân phối Gaussian—ở khắp nơi, đặc biệt nếu bạn quan tâm đến thống kê hoặc khoa học dữ liệu. Điều này không phải là “ngẫu nhiên của tự nhiên”: Hóa ra rất nhiều thứ chúng ta đo lường là kết quả của nhiều yếu tố nhỏ cộng dồn, gợi ý sự hiện diện của một mô hình cộng ngầm phía sau.
Bằng cách biến đổi bất kỳ phân phối chuẩn nào thành một dạng đặc biệt gọi là phân phối chuẩn tắc, chúng ta có được một phân phối đặc biệt hữu ích trong một số bối cảnh, như tính xác suất, suy luận thống kê và áp dụng các kiểm định thống kê. Đến cuối bài viết này, bạn sẽ hiểu phân phối chuẩn tắc là gì, vì sao chúng ta thực hiện bước chuẩn hóa này và mối liên hệ của tất cả điều đó với biến thiên, xác suất và kiểm định giả thuyết. Cuối bài, tôi cũng hy vọng bạn sẽ đăng ký khóa Nhập môn Thống kê với R hoặc lộ trình kỹ năng Suy luận Thống kê trong R để tiếp tục xây dựng trên các ý tưởng trong bài viết này.
Phân phối Chuẩn Tắc là gì?
Phân phối chuẩn tắc là một trường hợp cụ thể của phân phối chuẩn, trong đó kỳ vọng bằng không và độ lệch chuẩn bằng một. Ta cũng cần nói rằng phân phối này đối xứng và xác suất của các giá trị nhất định giảm đối xứng khi bạn rời xa tâm.
"Phân phối Chuẩn Tắc" Hình ảnh bởi Dall-E
Hiểu các phương trình của Phân phối Chuẩn Tắc
Hãy xem xét kỹ hơn một chút các khía cạnh toán học của phân phối chuẩn tắc.
Hàm mật độ xác suất (PDF) của phân phối chuẩn tắc
Nếu bạn chưa quen với khái niệm hàm mật độ xác suất (PDF), hãy biết rằng nó mô tả cách xác suất được phân bố trên các giá trị có thể có của một biến ngẫu nhiên liên tục. Mọi phân phối xác suất liên tục, như phân phối mũ, phân phối t hay phân phối Cauchy, đều có hàm mật độ xác suất riêng xác định đường cong của nó. PDF của phân phối chuẩn tắc được định nghĩa như sau: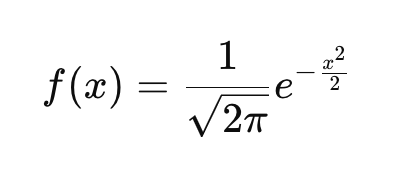
Hàm này đảm bảo diện tích dưới đường cong bằng 1. Nếu bạn nhìn vào phương trình và thay các giá trị khác nhau của x, bạn sẽ nhận được độ cao của đường cong tại những điểm đó. Trong phương trình:
Hàm phân phối tích lũy (CDF) của phân phối chuẩn tắc
Khác với PDF, vốn cho ta độ cao tương đối của các giá trị khác nhau, CDF cho bạn biết xác suất biến nhỏ hơn hoặc bằng một giá trị cho trước. Tương tự PDF, mỗi phân phối xác suất liên tục đều có CDF riêng.
Phương trình này phức tạp hơn một chút, nhưng ta có thể phân tích như sau:
Vì sao chúng ta quan tâm đến Phân phối Chuẩn Tắc
Bài hướng dẫn về phân phối Gaussian của chúng tôi có nhiều ý hay về thời điểm bạn có thể muốn làm cho dữ liệu tuân theo phân phối chuẩn. Nhưng đôi khi, bạn lại muốn chuyển dữ liệu thành đúng phân phối chuẩn tắc. Dưới đây là vài lý do phổ biến:
Chuẩn tắc được dùng trong kiểm định giả thuyết
Phân phối chuẩn tắc giúp dữ liệu so sánh được và phù hợp với một số phương pháp thống kê. Bằng cách chuyển dữ liệu thành điểm Z, ta có thể so sánh các quan sát giữa các phân phối chuẩn khác nhau. Đặc biệt, đây là cơ sở của kiểm định Z, dùng khi ta muốn xác định xem trung bình mẫu có khác biệt có ý nghĩa so với trung bình tổng thể hay không.
Trong khi đó, kiểm định t sử dụng độ lệch chuẩn mẫu như một ước lượng cho độ lệch chuẩn tổng thể, vì vậy nó dựa trên phân phối t, có đuôi dày hơn phân phối chuẩn tắc. Đọc hướng dẫn T-test vs. Z-test: Khi nào dùng cái nào, nơi bàn về các khái niệm như phương sai tổng thể và phương sai mẫu.
Chuẩn tắc giúp so sánh dữ liệu trên cùng một thang
Vì các tập dữ liệu và biến khác nhau có thể có đơn vị và thang đo khác nhau, việc so sánh trực tiếp có thể khó. Nhưng khi bạn chuyển chúng sang điểm Z bằng cách trừ đi trung bình và chia cho độ lệch chuẩn, bạn có thể dễ dàng so sánh giữa các phân phối khác nhau. Khi áp dụng cho một tập dữ liệu có phân phối chuẩn, điều này tạo ra một phân phối chuẩn tắc. Ví dụ, chuyển cả điểm SAT và GRE—mà tôi kỳ vọng đều phân phối gần chuẩn—sang điểm Z cho phép ta so sánh hiệu suất của sinh viên tương đối với quần thể dự thi tương ứng.
Chuẩn tắc dùng trong kiểm soát chất lượng
Phân phối chuẩn tắc được biết là quan trọng trong việc giám sát chất lượng sản phẩm trong sản xuất. Bằng cách xem xét kỹ xác suất, nhà sản xuất có thể xác định liệu biến động chất lượng là do ngẫu nhiên hay do vấn đề tiềm ẩn khác. Điều này liên quan đến kiểm định giả thuyết mà chúng ta đã đề cập, và cả bảng điểm Z mà chúng ta sẽ nói bên dưới.
Chuẩn tắc dùng trong mô hình thống kê
Phân phối chuẩn tắc đóng vai trò trong đánh giá sai số của các mô hình như hồi quy tuyến tính và dự báo chuỗi thời gian. Trong các mô hình này, ta giả định phần dư—chênh lệch giữa giá trị quan sát và dự đoán—không chỉ tuân theo phân phối chuẩn mà còn có thể được chuẩn hóa để theo phân phối chuẩn tắc.
Trong hồi quy tuyến tính, phần dư chuẩn hóa là phần dư đã được chuyển thành giá trị chuẩn hóa, cho phép ta đo độ “cực đoan” của sai số theo đơn vị độ lệch chuẩn, giúp dễ phát hiện ngoại lệ. Điều này hữu ích vì phương sai không đồng nhất ở phần dư—vốn có thể không hiển hiện qua các biến dự báo—có thể làm sai lệch cách diễn giải phần dư.
Trong phân tích chuỗi thời gian, sai số dự báo thường được giả định tuân theo phân phối chuẩn tắc khi đã chuẩn hóa đúng cách. Điều này quan trọng để xây dựng khoảng dự báo. Nhiều mô hình chuỗi thời gian, như ARIMA, dựa vào các phân vị của chuẩn tắc để xác định biên độ tin cậy quanh dự báo. Ngoài ra, trong phân rã chuỗi thời gian, thành phần phần dư—bắt các dao động bất thường—thường được thấy là phân phối chuẩn. Nếu bạn chuẩn hóa thành phần này, bạn có thể tìm xác suất của các giá trị cực đoan trong chuỗi mà bạn biết không do xu hướng–chu kỳ hay mùa vụ gây ra. Khóa Dự báo trong R của chúng tôi sẽ dạy bạn những kỹ thuật như vậy.
Chuẩn tắc dùng trong máy học
Nhiều thuật toán máy học hoạt động tốt nhất khi dữ liệu ở trên một thang chuẩn. Tôi đang nghĩ đến hồi quy logistic, phân cụm k-means và mạng nơ-ron.
Tôi cũng nghĩ đến phân tích thành phần chính, vốn thường được dùng như một kỹ thuật tiền xử lý. Trong PCA, ta muốn các đặc trưng đầu vào có trung bình bằng 0 và phương sai bằng 1 để tránh việc các đặc trưng có giá trị lớn chi phối. Một bước tiền xử lý thường gặp là chuẩn hóa dữ liệu bằng cách trừ đi trung bình và chia cho độ lệch chuẩn. Điều này đảm bảo mỗi đặc trưng có trung bình 0 và phương sai 1, nhưng cần rõ rằng nó không áp đặt tính chuẩn. Tuy nhiên, trong một số trường hợp, tôi kỳ vọng dữ liệu biến đổi sẽ xấp xỉ chuẩn nếu phân phối ban đầu đã gần chuẩn.
Chuẩn tắc dùng để tính xác suất
Hàm phân phối tích lũy của phân phối chuẩn tắc—mà ta đã bàn—được lập bảng tốt, tức là đã được tính sẵn và sắp xếp thành các bảng phổ biến rộng rãi, giúp việc tính xác suất dễ dàng hơn vì bạn chỉ cần tra cứu giá trị phù hợp.
Ví dụ, để tìm xác suất một chiều cao chọn ngẫu nhiên nhỏ hơn 6 feet, ta chuẩn hóa chiều cao đó theo phân phối chuẩn của quần thể và tra điểm Z trong bảng chuẩn tắc. Tôi đã đặt một phiên bản bảng chuẩn tắc ở cuối bài viết phòng khi bạn cần dùng.
Các biến đổi để đưa dữ liệu về Phân phối Chuẩn Tắc
Các phép biến đổi có thể giúp tái định dạng dữ liệu về phân phối chuẩn tắc. Nói đại khái, đây là quy trình hai bước. Trước tiên, ta định dạng lại dữ liệu để trở nên chuẩn, rồi thực hiện chuẩn hóa điểm Z.
Lưu ý, bạn thường không áp dụng chuẩn hóa điểm Z ngay từ đầu vì các giá trị cực đoan có thể làm méo độ lệch chuẩn—do trung bình và độ lệch chuẩn nhạy với ngoại lệ. Ngoài ra, một số phép biến đổi yêu cầu dữ liệu dương. Nếu bạn chuẩn hóa điểm Z trước, các giá trị đã trừ trung bình có thể bao gồm số âm, gây vấn đề cho các phép biến đổi chỉ áp dụng với giá trị dương. Tôi đang nói riêng về logarit. Vì vậy, tốt nhất là đi theo thứ tự: bước 1 rồi bước 2.
Bước 1: Biến đổi dữ liệu để trở nên chuẩn
Một số ý tưởng biến đổi bạn có thể dùng gồm:
Biến đổi log cho dữ liệu lệch phải
Khi dữ liệu lệch phải, biến đổi log có thể giúp “chuẩn hóa” hơn. Ví dụ, áp dụng log lên giá trị thô sẽ nén các giá trị lớn, giảm độ lệch và tạo phân phối đối xứng hơn.
Biến đổi căn bậc hai cho dữ liệu đếm
Với dữ liệu đếm hoặc tập dữ liệu lệch vừa phải, ta có thể thử biến đổi căn bậc hai. Cách này giảm biến thiên trong khi vẫn duy trì cấu trúc đối xứng hơn, đưa dữ liệu gần hơn với dạng hình chuông.
Biến đổi Box-Cox để điều chỉnh linh hoạt
Biến đổi Box-Cox tiến thêm một bước bằng cách điều chỉnh phù hợp với dữ liệu. Tham số λ xác định công thức áp dụng chính xác, khiến phương pháp này rất linh hoạt để đưa dữ liệu phù hợp với các đặc tính của phân phối chuẩn tắc. Khóa Xây dựng Đặc trưng trong R sẽ giới thiệu Box-Cox cùng nhiều phương pháp quan trọng, hữu ích khác.
Bước 2: Thực hiện chuẩn hóa điểm Z
Sau khi đã áp dụng biến đổi, dữ liệu có thể được chuẩn hóa để khớp phân phối chuẩn tắc. Điều này điều chỉnh dữ liệu sao cho có trung bình bằng 0 và độ lệch chuẩn bằng 1. Công thức điểm Z là:
trong đó X là dữ liệu đã biến đổi, μ là trung bình, và σ là độ lệch chuẩn.
Giờ, nếu bạn quen với phân biệt điểm Z của tổng thể và của mẫu—như chúng tôi đề cập trong lộ trình Suy luận Thống kê trong R—bạn có thể nhận ra phương trình trên là công thức điểm Z cho tổng thể. Nếu bạn làm việc với mẫu thay vì toàn bộ tổng thể, ta sẽ ước lượng trung bình và độ lệch chuẩn thay thế:
Ở đây, X gạch ngang là trung bình mẫu, và s là độ lệch chuẩn mẫu.
Kết quả sẽ tương tự nếu bạn dùng trung bình và độ lệch chuẩn từ tập dữ liệu đã chuẩn hóa mới. Nhưng đôi khi, nhà nghiên cứu quan tâm so sánh dữ liệu tương đối với một quần thể tham chiếu lớn hơn bằng cách dùng một loại trung bình và độ lệch chuẩn chuẩn mực.
Hãy hình dung bạn xem xét một tập dữ liệu thu nhập—vốn lệch phải—và thực hiện biến đổi log để làm gần chuẩn. Sau đó, giả sử ta muốn so sánh thu nhập tương đối với các chuẩn mực quốc gia, khi đó ta sẽ dùng trung bình và độ lệch chuẩn quốc gia thay vì từ mẫu của ta để tính điểm Z. Mục đích là cho phép so sánh có ý nghĩa giữa các tập dữ liệu hoặc nghiên cứu.
Tóm lại, nếu bạn dùng mẫu, về mặt kỹ thuật, bạn thu được một xấp xỉ chuẩn tắc đã chuẩn hóa chứ không phải phân phối chuẩn tắc lý thuyết chính xác. Tôi nghĩ đây là phân biệt đáng nêu, dù khác biệt sẽ nhỏ với các tập dữ liệu lớn.
Trực quan hóa Phân phối Chuẩn Tắc
Dưới đây là một cách tạo phân phối chuẩn tắc lý thuyết trong ngôn ngữ R. Trong đoạn mã này, tôi cũng thêm các đường thẳng đứng cho các điểm chuẩn, hay còn gọi là điểm Z, là cách cho ta biết, với một giá trị bất kỳ, nó cách trung bình tổng thể bao nhiêu độ lệch chuẩn.
Bạn nên biết có một số phân phối tương tự trông giống chuẩn tắc nhưng không phải:
Phân phối Chuẩn Tắc và Bảng Chuẩn Tắc
Quay lại điều tôi đã đề cập: bảng chuẩn tắc, còn gọi là bảng điểm Z hay Z-table, dùng để tìm xác suất tích lũy cho một điểm Z—đại diện số độ lệch chuẩn mà một giá trị cách trung bình trong phân phối chuẩn tắc. Bảng này thường dùng trong thống kê cho kiểm định giả thuyết, khoảng tin cậy và tính xác suất. Ý tưởng là thay vì tính xác suất thủ công, bạn có thể tra bảng để nhanh chóng xác định tỷ lệ giá trị nằm dưới một điểm Z cho trước.
Bảng cần một chút luyện tập để đọc, và các bảng đôi khi có bố cục khác nhau. Ở đây, bạn thấy cấu trúc hai chiều. Mục đích là giúp tra xác suất cho điểm Z khi làm việc với phần thập phân. Trong trường hợp này, cột ngoài cùng bên trái chứa phần nguyên và chữ số thập phân đầu tiên của điểm Z. Hàng trên cùng biểu diễn chữ số thập phân thứ hai. Để tìm xác suất tương ứng với một điểm Z cụ thể, hãy xác định hàng tương ứng với phần đầu của điểm Z, rồi tìm cột khớp chữ số thập phân thứ hai. Giá trị tại giao điểm của hàng và cột này là xác suất tích lũy, tức tỷ lệ điểm dữ liệu nằm dưới điểm Z đó.
Tốt nhất là minh họa bằng ví dụ: Giả sử bạn tính được điểm Z là 0,32 cho điểm bài kiểm tra của một học sinh. Điều này nghĩa là điểm số nằm trên trung bình 0,32 độ lệch chuẩn. Giờ, hãy dùng Z-table để tìm xác suất một giá trị chọn ngẫu nhiên nhỏ hơn điểm Z này.
Xác suất tích lũy cho Z = 0,32 là 0,6554, nghĩa là 65,54% giá trị trong phân phối chuẩn tắc nhỏ hơn 0,32 độ lệch chuẩn phía trên trung bình. Nếu bạn cần xác định xác suất một giá trị lớn hơn một điểm Z cho trước, hãy lấy 1 trừ đi giá trị trong bảng trước khi tìm hàng và cột.
Kết luận
Hy vọng bạn thích phần khám phá về phân phối chuẩn tắc này. Tiếp tục học cùng chúng tôi tại DataCamp. Tôi đã nhắc đến khóa Nhập môn Thống kê với R và lộ trình kỹ năng Suy luận Thống kê trong R. Còn nếu bạn thích Python, khóa Tư duy Thống kê với Python và khóa Thiết kế Thực nghiệm trong Python đều là lựa chọn tuyệt vời.