
Corso
Test di ipotesi in Python
4 ore
61.5K
Ti è mai capitato di eseguire un t-test, ottenere un p-value pulito e poi renderti conto di non aver mai controllato se i dati erano distribuiti normalmente?
I test statistici non ti dicono quando le loro assunzioni vengono violate. Si limitano a restituire un valore. Il problema è che test come t-test e ANOVA assumono che i tuoi dati seguano una distribuzione normale. Se non è così, stai costruendo conclusioni su fondamenta fragili.
I test di normalità ti permettono di verificare questa assunzione. Esistono metodi sia visivi sia statistici per farlo, e sapere quali usare - e come leggere i risultati - è ciò che ti permette di sostenere con sicurezza le tue conclusioni.
In questo articolo ti guiderò attraverso i metodi visivi e statistici più comuni per verificare la normalità, ti mostrerò come eseguirli in Python e R e spiegherò cosa fare quando i tuoi dati non superano il test.
Probabilmente hai già visto la curva a campana, ma ecco cosa significa davvero per i tuoi dati.
Una distribuzione normale è uno schema in cui la maggior parte dei valori si concentra attorno al centro, e man mano che ci si allontana in entrambe le direzioni i valori diventano meno frequenti. Se la rappresenti graficamente, ottieni una curva simmetrica a forma di campana. Il lato sinistro rispecchia il destro.
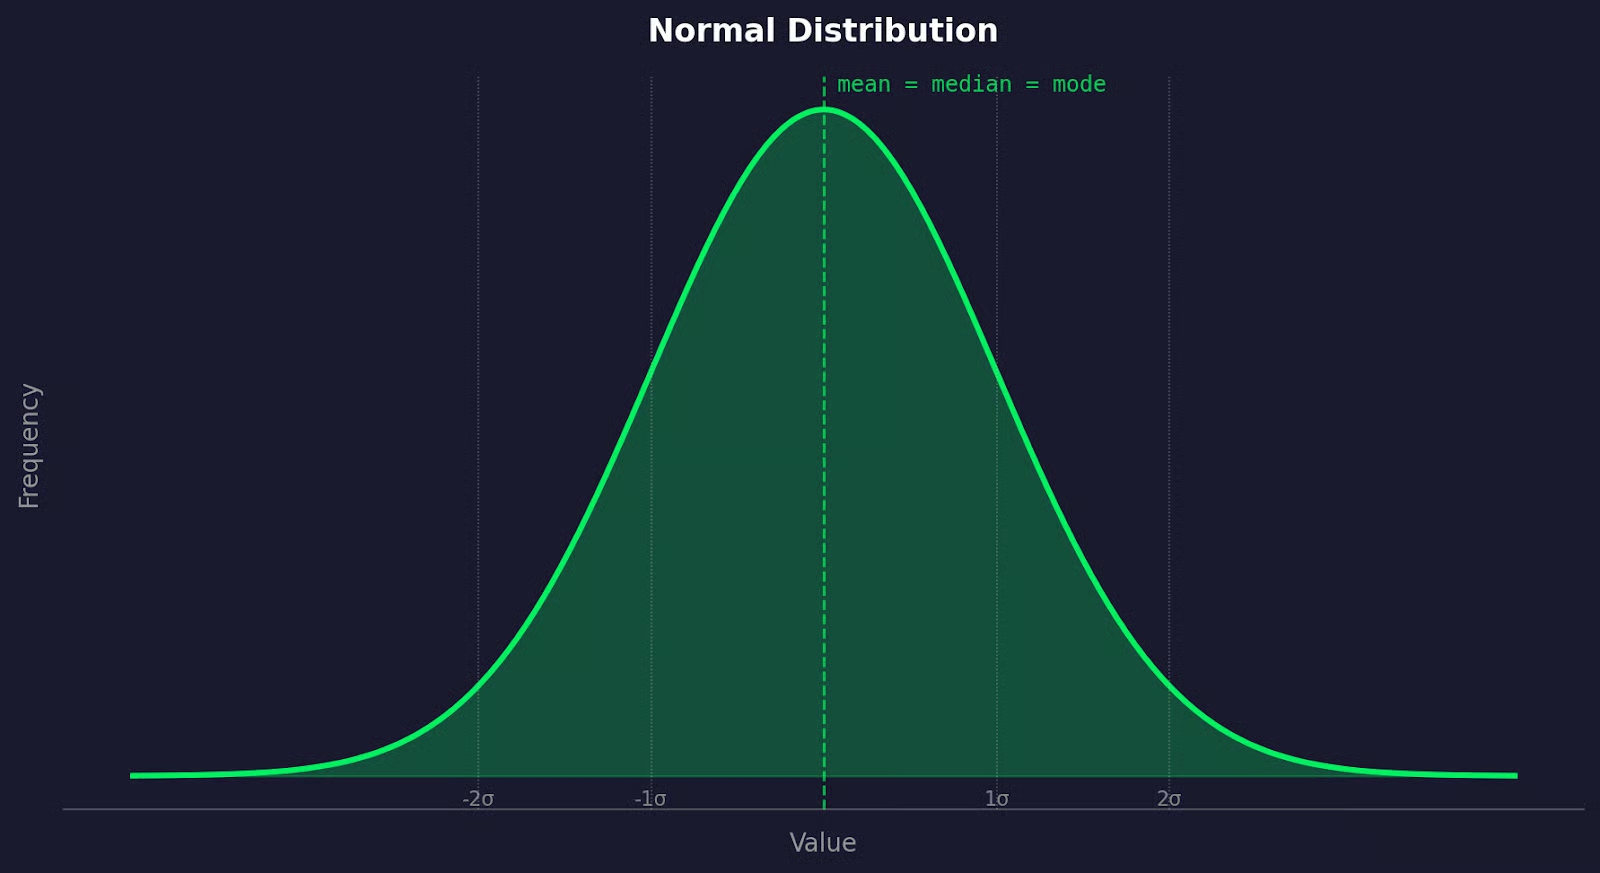
Grafico di distribuzione normale
Ciò che rende unica la distribuzione normale è che media, mediana e moda coincidono nello stesso punto: il centro della campana. Non c’è asimmetria verso sinistra o destra. In altre parole, i dati sono bilanciati.
Questo schema ricorre continuamente nei dati di misura del mondo reale. Altezza umana, pressione sanguigna, tolleranze di produzione, punteggi dei test: tendono tutti a seguire una distribuzione normale quando raccogli abbastanza osservazioni. La variazione naturale nei sistemi biologici e fisici tende a produrre questa forma.
Detto ciò, non tutti i dati si comportano così. I redditi sono asimmetrici a destra. I tempi di risposta dei siti web hanno code lunghe.
Nel mondo reale, le cose possono andare molto male se dai per scontata la normalità senza controllare.
Il problema di non verificare la normalità è che la maggior parte dei test statistici comuni - t-test, ANOVA - sono test parametrici.
Ciò significa che si basano su assunzioni sulla distribuzione dei tuoi dati. La normalità è una di queste. Quando quell’assunzione salta, salta anche la matematica del test. Otterrai comunque un risultato, ma potrebbe portarti a conclusioni sbagliate.
I test parametrici funzionano assumendo proprietà matematiche della popolazione da cui proviene il campione. Quando tali assunzioni valgono, questi test sono utili e accurati. Quando non valgono, i p-value diventano inaffidabili e non puoi trarre conclusioni accurate.
È qui che entrano in gioco i test non parametrici.
Test come Mann-Whitney U o Kruskal-Wallis non assumono la normalità: lavorano con i ranghi invece che con i valori grezzi. Sono più flessibili, ma tendono a essere meno utili quando i dati sono normali. Quindi passare a questi test senza necessità non è la soluzione.
Il vero errore che tanti neofiti della data science commettono è saltare del tutto il controllo.
Testare la normalità richiede poche righe di codice. Non testare significa che stai affidandoti ai tuoi dati - o che non ci stai proprio pensando.
Prima di eseguire qualsiasi test formale, rappresenta i dati. I grafici ti diranno molto su cosa hai tra le mani.
Un istogramma ti mostra la forma della distribuzione.
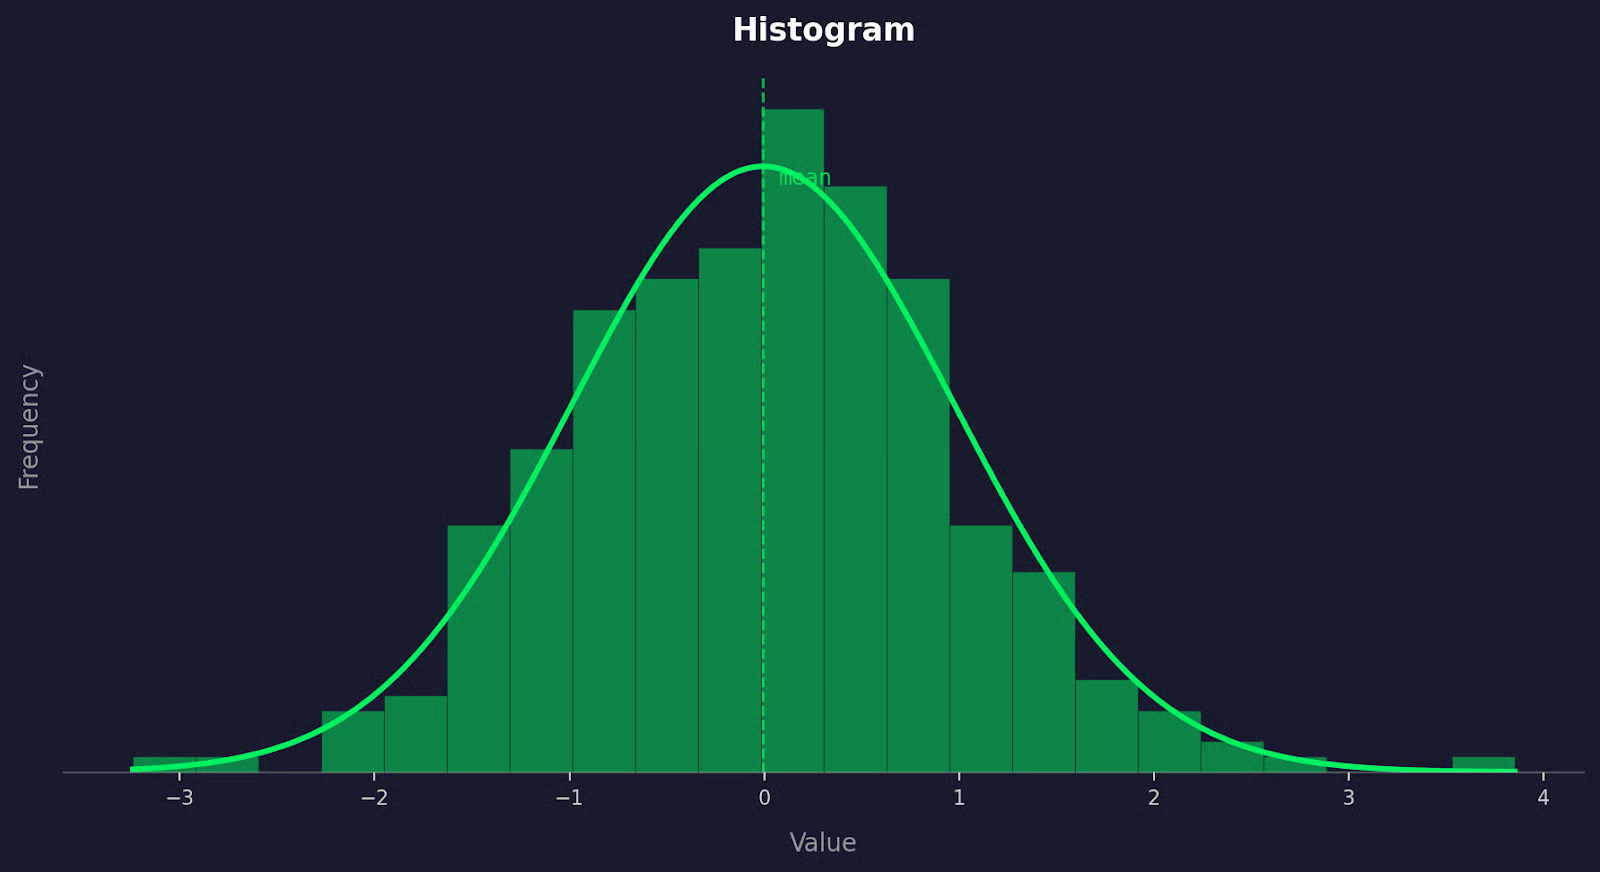
Esempio di istogramma
Se i tuoi dati sono distribuiti normalmente, l’istogramma dovrebbe assomigliare a una curva a campana: alto al centro e che si assottiglia simmetricamente su entrambi i lati. Quello che devi osservare è la asimmetria (skewness): una coda lunga verso destra indica asimmetria positiva, una coda verso sinistra indica asimmetria negativa. In entrambi i casi, è un segnale che i dati potrebbero non essere normali.
Il problema degli istogrammi è che la loro forma dipende dalla dimensione dei bin:
Prova sempre un paio di dimensioni dei bin prima di trarre conclusioni.
Un Q-Q plot (quantile-quantile plot) confronta i quantili dei tuoi dati con i quantili di una distribuzione normale teorica.
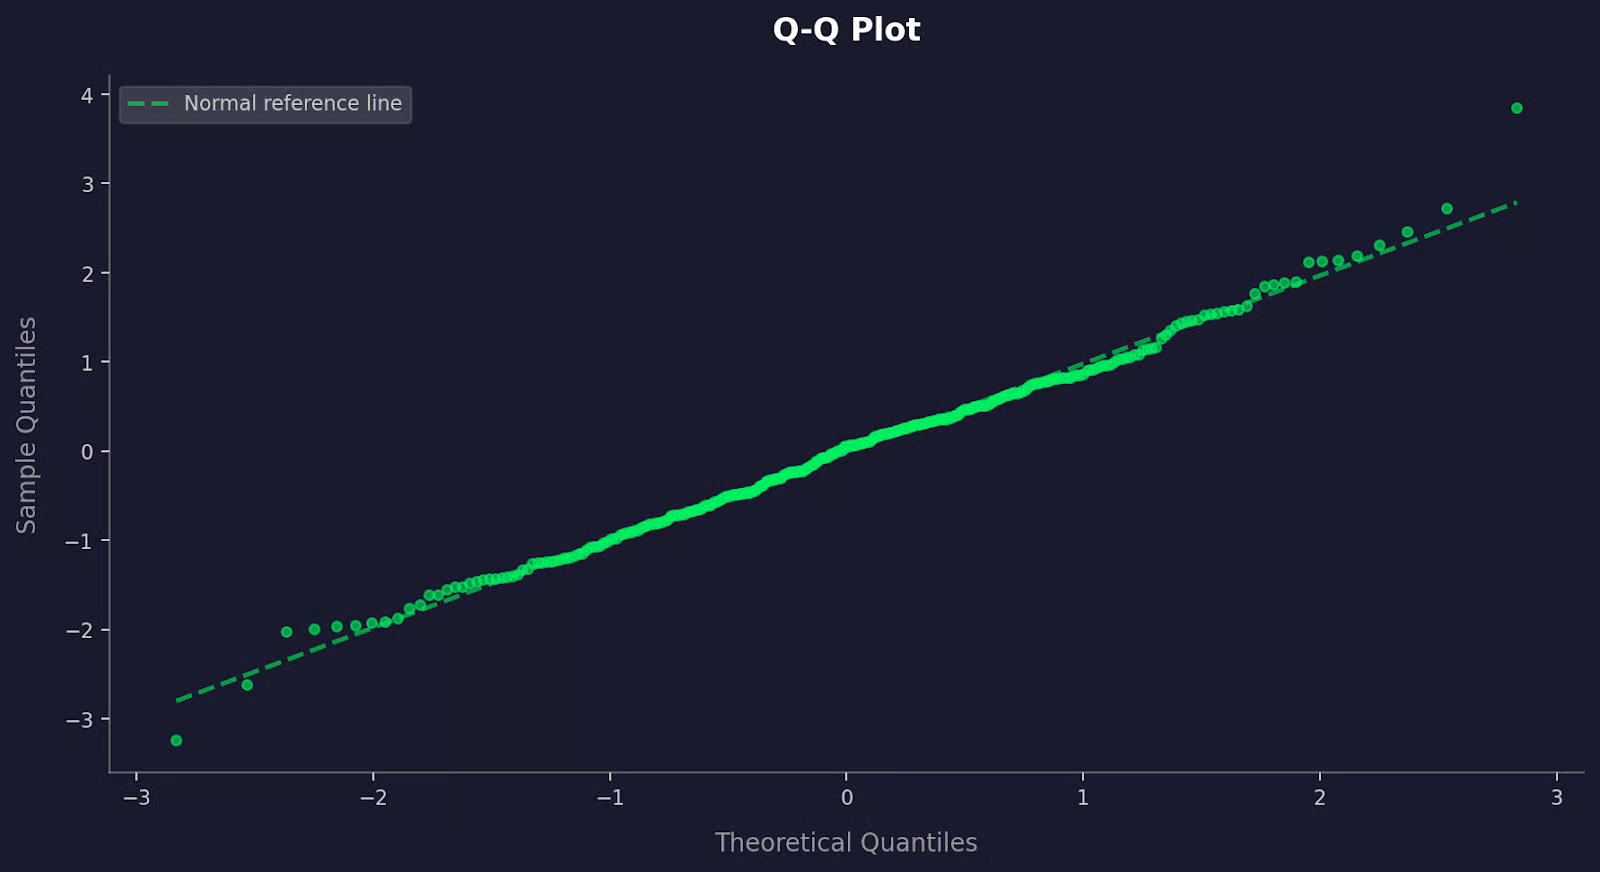
Esempio di Q-Q plot
Se i dati sono normali, i punti si dispongono lungo una linea diagonale retta. Le deviazioni da quella linea ti dicono dove la normalità si rompe. Punti che curvano verso l’alto alle estremità suggeriscono code pesanti. Una curva a S indica asimmetria.
I Q-Q plot sono più precisi degli istogrammi nell’individuare scostamenti sottili dalla normalità, soprattutto nelle code, dove gli istogrammi tendono a perdere dettagli.
Un box plot ti mostra mediana, dispersione e outlier in un’unica vista.
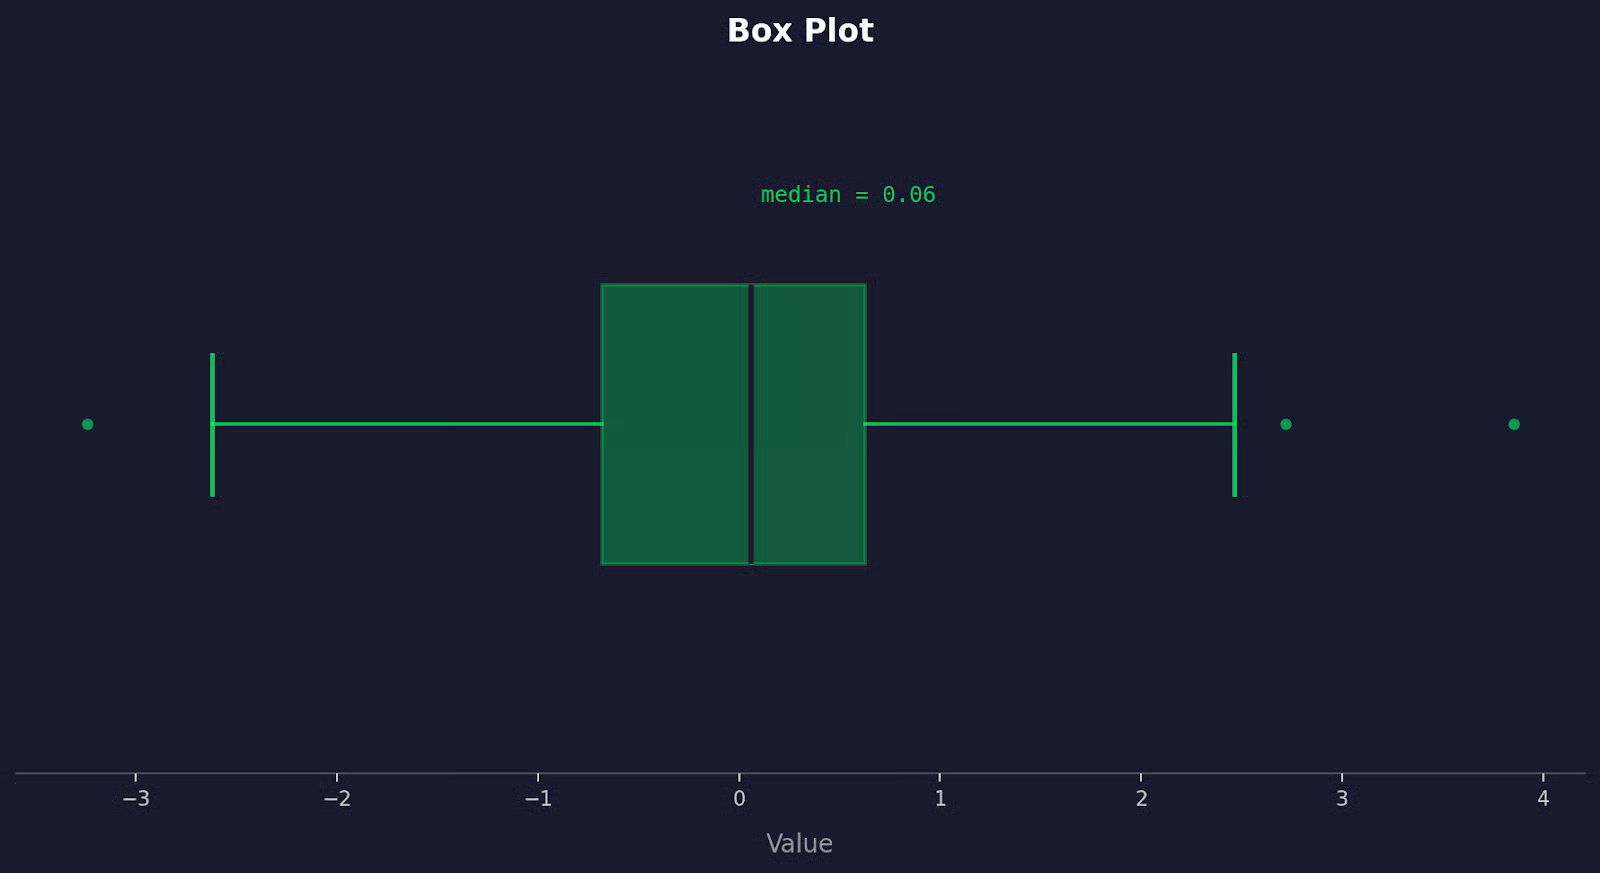
Esempio di box plot
Un dataset normalmente distribuito produce un box plot in cui la mediana si trova più o meno al centro della scatola e i baffi si estendono per lunghezze simili su entrambi i lati. Se la mediana è decentrata o un baffo è molto più lungo dell’altro, c’è asimmetria. I punti fuori dai baffi sono outlier.
Il problema generale dei grafici è che sono soggettivi. Due persone possono guardare lo stesso istogramma e non essere d’accordo. Usali per farti un’idea iniziale dei dati, poi conferma con un test formale.
Non esiste un test di normalità unico che funzioni al meglio in ogni situazione. Quello giusto dipende dalla dimensione del campione e da ciò che vuoi rilevare.
Il test di Shapiro-Wilk è la scelta predefinita per campioni piccoli o medi, generalmente fino a qualche centinaio di osservazioni.
Misura quanto i tuoi dati si avvicinano a una distribuzione normale confrontando i valori osservati con quelli attesi se i dati fossero normali. È ampiamente usato, ben compreso e disponibile in tutte le principali librerie statistiche. Per la maggior parte degli analisti, è il primo test da provare.
Il suo limite principale è che diventa ipersensibile con campioni grandi. Tende a segnalare come significative deviazioni minime, praticamente irrilevanti.
Il test di Kolmogorov-Smirnov (KS) confronta la distribuzione cumulativa del tuo campione con una distribuzione teorica - in questo caso, la normale.
È più generale di Shapiro-Wilk e può testare contro qualsiasi distribuzione, non solo la normale. Il KS è meno potente di Shapiro-Wilk per la normalità, cioè è meno propenso a cogliere scostamenti sottili. Inoltre richiede di specificare a priori i parametri della distribuzione, il che introduce bias se li stimi dagli stessi dati.
Usalo quando ti serve un controllo rapido e generico, non come test principale di normalità.
Il test di Anderson-Darling è una variante del KS, con una differenza chiave: attribuisce più peso alle code della distribuzione.
Questo lo rende migliore nell’individuare deviazioni che emergono agli estremi: code pesanti, outlier o comportamenti non normali che il KS potrebbe non cogliere. Se il tuo caso d’uso è sensibile al comportamento in coda, Anderson-Darling è una buona scelta.
Il test di D'Agostino-Pearson adotta un approccio diverso.
Invece di confrontare direttamente le distribuzioni, misura due proprietà dei tuoi dati: asimmetria (skewness) e curtosi (quanto sono pesanti o leggere le code).
Le combina in un’unica statistica di test. Questo lo rende efficace per capire perché i dati potrebbero non essere normali - non solo se lo sono o meno. Funziona meglio con campioni più grandi, dove le stime di asimmetria e curtosi sono affidabili.
Il test di Jarque-Bera utilizza anch’esso asimmetria e curtosi, in modo simile a D'Agostino-Pearson.
È comune in econometria e analisi di serie temporali. Come D'Agostino-Pearson, richiede un campione abbastanza grande per produrre risultati affidabili. Con campioni piccoli, il test non è molto affidabile. Se lavori in ambito finanza o economia, lo incontrerai spesso.
In conclusione, inizia con Shapiro-Wilk per campioni piccoli e abbinalo a un Q-Q plot. Usa Anderson-Darling quando contano le code e D'Agostino-Pearson quando vuoi capire la natura della deviazione.
Ogni test di normalità è un test d’ipotesi.
L’ipotesi nulla in qualsiasi test di normalità è che i tuoi dati siano distribuiti normalmente. Il test chiede: dato ciò che vediamo nei dati, quanto è probabile che questa ipotesi nulla sia vera?
La risposta arriva come un p-value:
Sembra semplice, ma qui molti sbagliano.
Un p-value basso non ti dice quanto i dati sono non normali - solo che è stata rilevata una differenza. Con campioni grandi, i test di normalità diventano estremamente sensibili. Segnaleranno deviazioni così piccole da non avere alcun impatto reale sulla tua analisi.
Esiste anche il problema opposto. Con campioni piccoli, anche dati visibilmente asimmetrici possono produrre p > 0.05 perché il test non ha abbastanza potenza per rilevare la deviazione.
Significatività statistica e significatività pratica non sono la stessa cosa.
Un p-value ti dice se esiste uno scostamento dalla normalità. Non ti dice se quello scostamento conta per la tua analisi specifica. Abbina sempre il risultato del test a un Q-Q plot: se i punti seguono da vicino la linea, i tuoi dati probabilmente sono sufficientemente normali, a prescindere da cosa dica il p-value.
Il modulo scipy.stats di Python ha tutto il necessario per eseguire test di normalità in poche righe di codice.
Per tutti gli esempi qui sotto userò lo stesso dataset: 100 campioni estratti da una distribuzione normale, così puoi eseguire il codice e seguire passo passo.
import numpy as np
from scipy import stats

np.random.seed(42)
data = np.random.normal(loc=0, scale=1, size=100)Usa shapiro() come primo controllo, soprattutto con dataset piccoli.
stat, p_value = stats.shapiro(data)
print(f"Statistic: {stat:.4f}, p-value: {p_value:.4f}")
Ecco cosa ottieni:
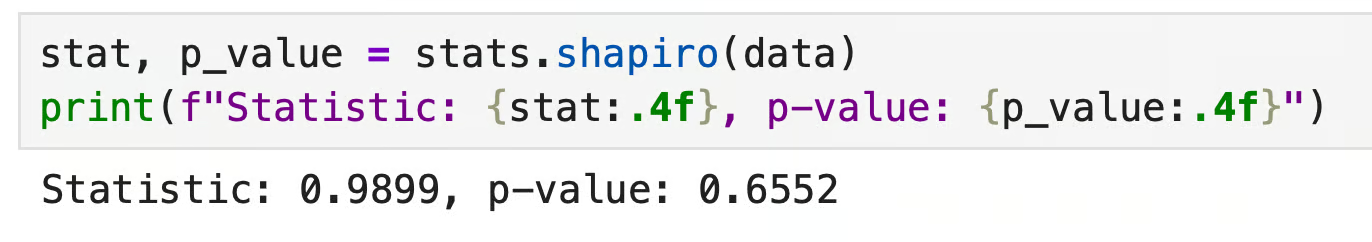
Output di un test di Shapiro-Wilk in Python
Il p-value è ben al di sopra di 0.05, quindi non rifiutiamo la normalità. I dati sembrano normali - il che ha senso, visto che li abbiamo generati da una distribuzione normale.
kstest() confronta il tuo campione con una distribuzione nominata. Per la normalità, passa "norm" insieme alla media e alla deviazione standard del campione.
stat, p_value = stats.kstest(data, 'norm', args=(data.mean(), data.std()))
print(f"Statistic: {stat:.4f}, p-value: {p_value:.4f}")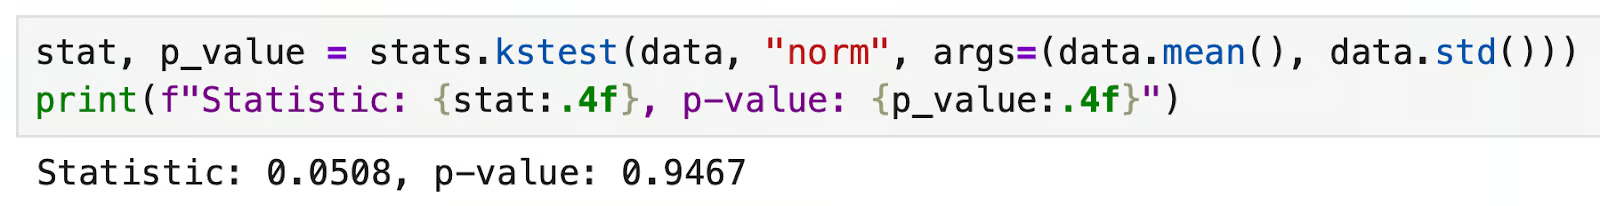
Output di un test di Kolmogorov-Smirnov in Python
Di nuovo, p > 0.05: nessuna evidenza contro la normalità.
Con questo test in Python, passa sempre media e deviazione standard esplicitamente tramite args. Se lo salti, kstest() usa di default una normale standard (media=0, dev.std=1), che darà risultati inaffidabili a meno che i tuoi dati non siano già standardizzati.
normaltest() verifica la normalità controllando asimmetria e curtosi combinate. Funziona meglio con campioni grandi.
stat, p_value = stats.normaltest(data)
print(f"Statistic: {stat:.4f}, p-value: {p_value:.4f}")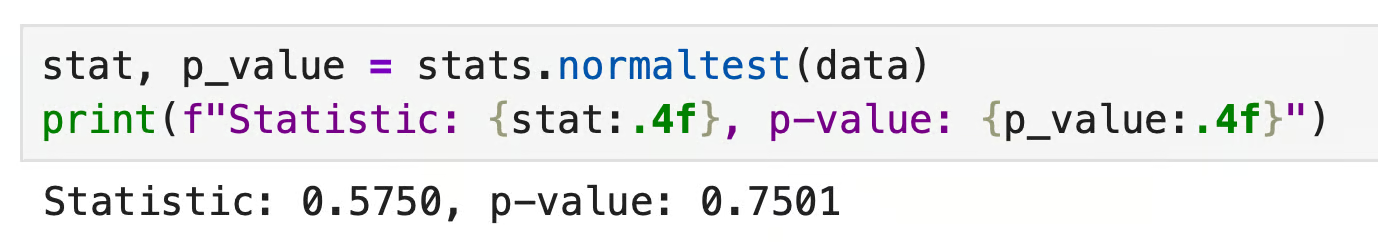
Output di un test di D'Agostino-Pearson in Python
Ancora p > 0.05. I dati superano tutti e tre i test, ma è atteso: li ho generati per essere normali. In pratica, spesso vedrai questi test non concordare, soprattutto vicino alla soglia 0.05. Quando succede, fai affidamento sul Q-Q plot per decidere.
R ha funzioni integrate per i test di normalità. Non servono pacchetti aggiuntivi per le basi.
Come negli esempi Python, userò lo stesso dataset: 100 campioni da una distribuzione normale.
set.seed(42)
data <- rnorm(100, mean = 0, sd = 1)shapiro.test() è il riferimento per campioni piccoli o medi. Passagli semplicemente il tuo vettore di dati:
shapiro.test(data)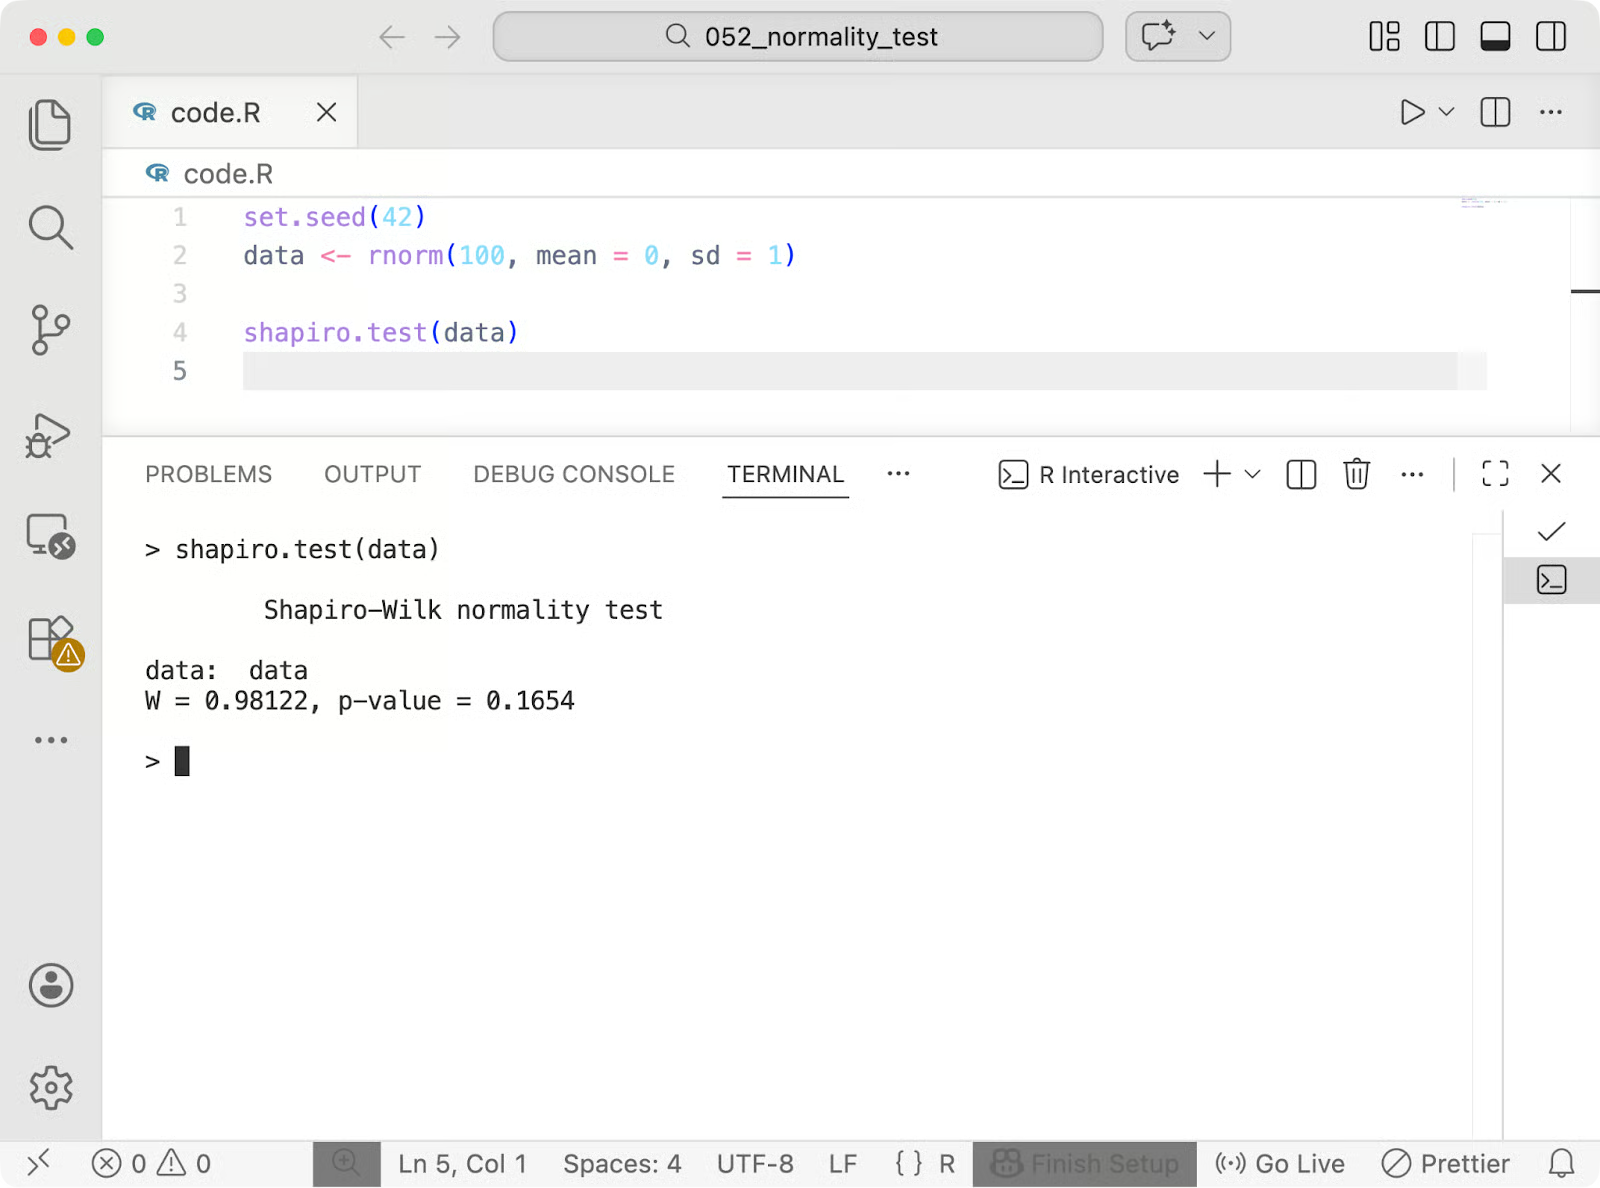
Output di un test di Shapiro-Wilk in R
p > 0.05: nessuna evidenza contro la normalità. La statistica W varia da 0 a 1, dove valori vicini a 1 indicano che i dati seguono da vicino una distribuzione normale.
ks.test() confronta il tuo campione con una distribuzione teorica. Per la normalità, specifica "pnorm" e passa media e deviazione standard del campione.
ks.test(data, "pnorm", mean(data), sd(data))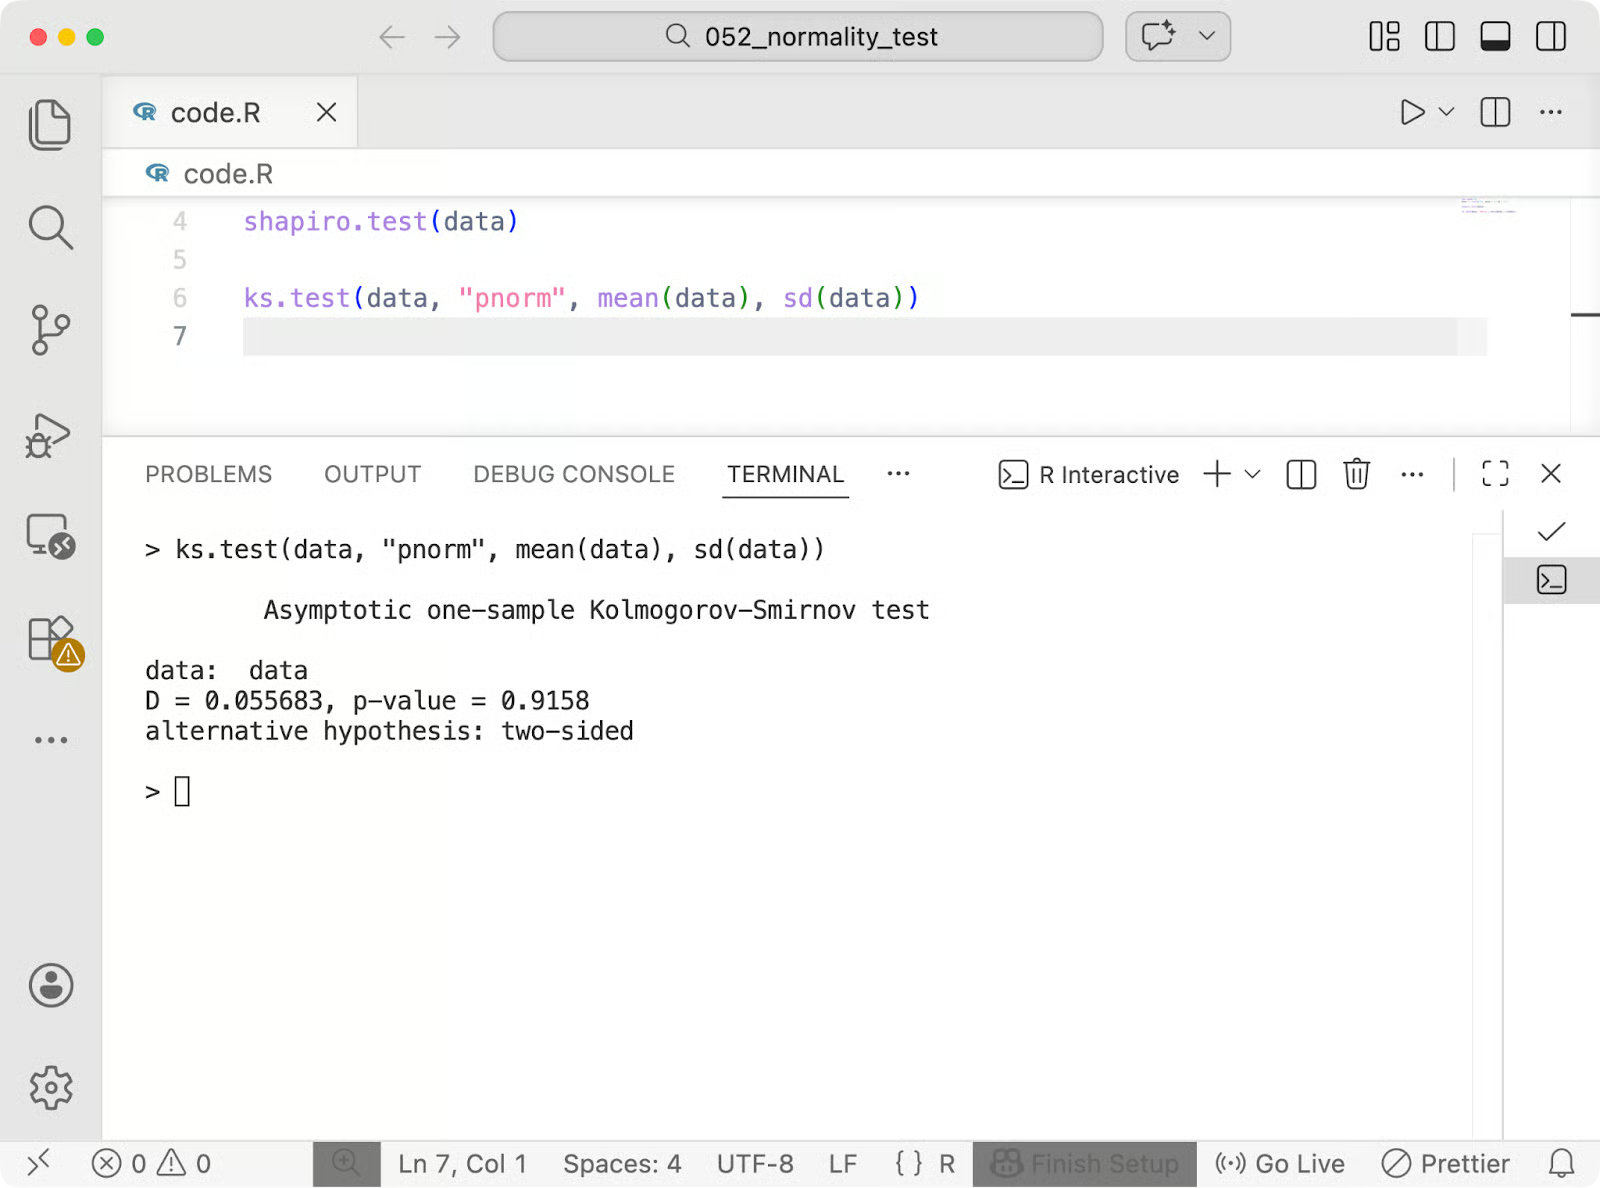
Output di un test di Kolmogorov-Smirnov in R
Di nuovo p > 0.05. Questo test in R ha lo stesso caveat che in Python: passa sempre mean(data) e sd(data). Saltandoli, il default è la normale standard, che altera il risultato a meno che i dati non siano già standardizzati.
Le funzioni integrate di R qqnorm() e qqline() ti danno un Q-Q plot in due righe di codice.
qqnorm(data, main = "Q-Q Plot")
qqline(data, col = "steelblue", lwd = 2)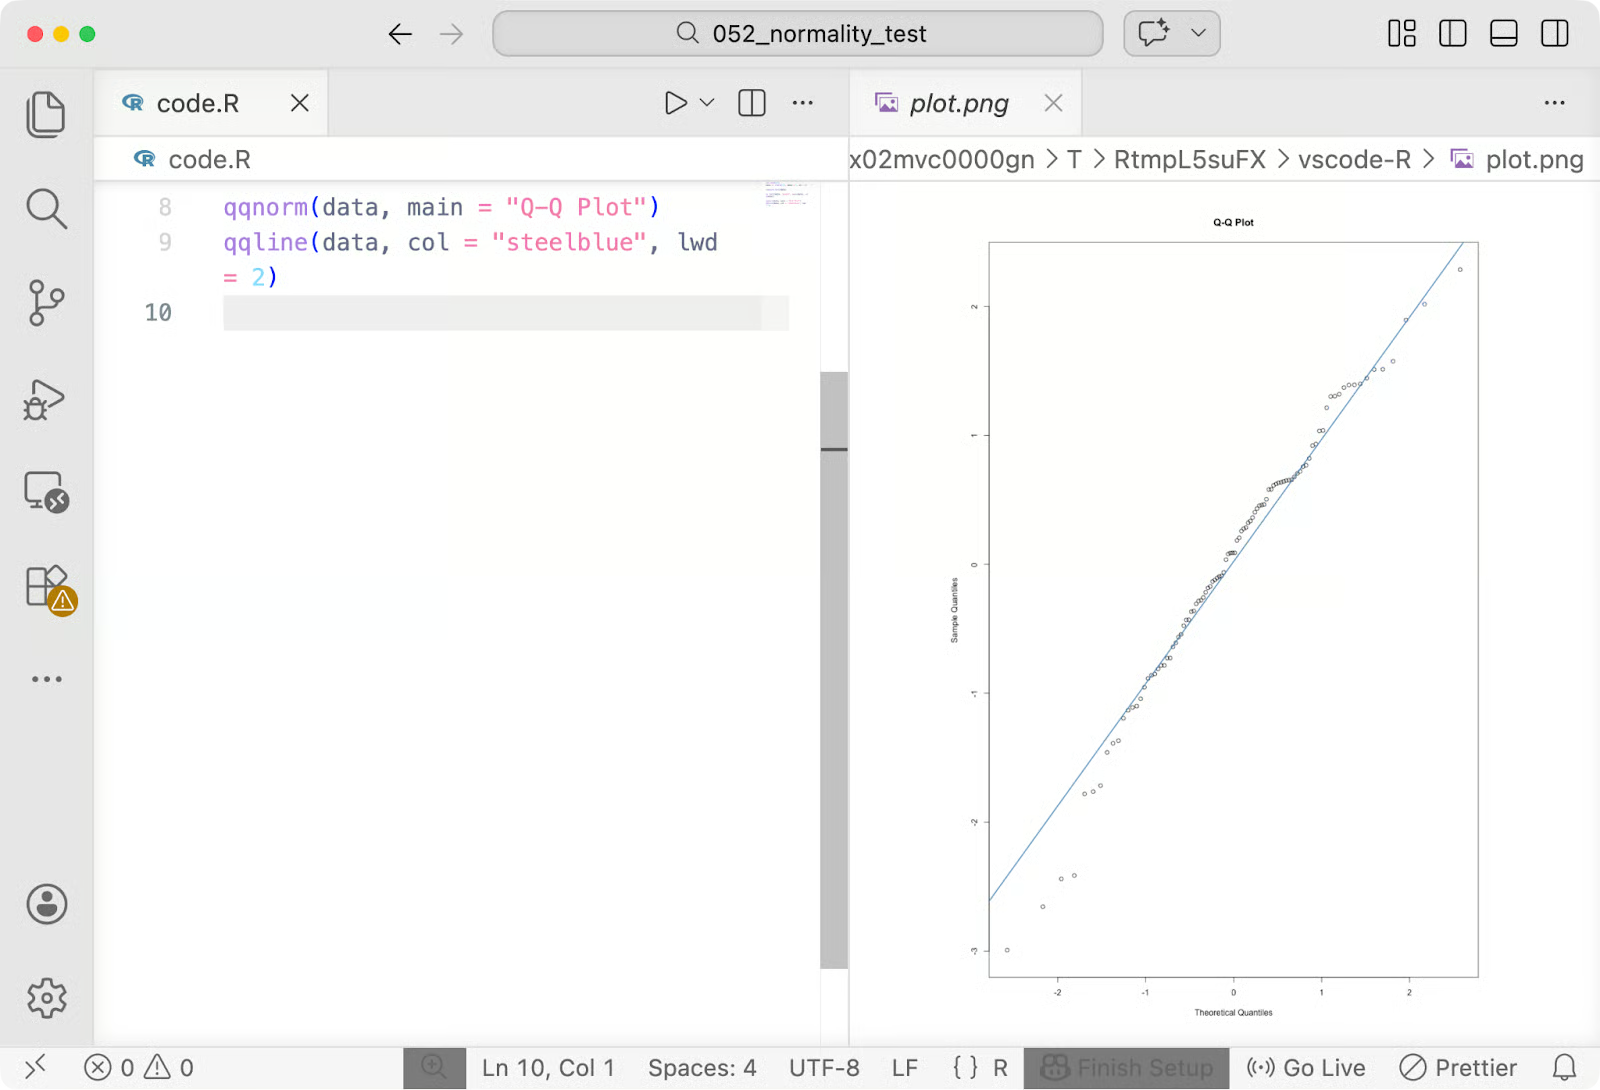
Q-Q plot in R
qqnorm() traccia i quantili del campione contro i quantili normali teorici. qqline() disegna la linea di riferimento. Punti che seguono da vicino quella linea significano che i dati si comportano in modo normale. Deviazioni alle estremità segnalano problemi nelle code da approfondire.
Se i tuoi dati non superano un test di normalità, hai un paio di valide opzioni.
A volte la soluzione è trasformare i dati in modo che si comportino normalmente, quindi eseguire i test originali sui valori trasformati.
Trasformazione logaritmica è la scelta più comune. Funziona bene su dati asimmetrici a destra - pensa a redditi, tempi di risposta o misure biologiche con una lunga coda a destra. La funzione in Python è np.log(data) e l’equivalente in R è log(data).
Trasformazione a radice quadrata è un’opzione più blanda per un’asimmetria moderata, ed è utile quando i dati contengono zeri (non puoi fare il logaritmo di zero). Usa np.sqrt(data) in Python o sqrt(data) in R.
Dopo la trasformazione, riesegui il test di normalità. Se i dati trasformati lo superano, procedi con i test parametrici: ricorda solo di interpretare i risultati nella scala trasformata.
Se la trasformazione non funziona o non ha senso per i tuoi dati, passa ai test non parametrici. Questi non assumono la normalità: classificano i dati invece di lavorare con i valori grezzi.
Entrambi sono disponibili in scipy.stats (mannwhitneyu() e kruskal()) e nel pacchetto base di R (wilcox.test() e kruskal.test()).
Con campioni sufficientemente grandi, spesso puoi ignorare il problema della normalità.
Il teorema del limite centrale dice che all’aumentare della dimensione del campione, la distribuzione campionaria della media tende alla normale - indipendentemente da come sono distribuiti i dati originali. In pratica, questo significa che i test parametrici tendono a essere affidabili con grandi campioni anche quando i dati sottostanti non sono perfettamente normali.
Testare la normalità è semplice - hai visto che richiede una sola riga di codice. Eppure, ci sono alcuni modi per sbagliare.
Ecco alcuni errori comuni che chi è alle prime armi con la data science commette spesso:
Quindi, in conclusione, il test di normalità è solo un controllo tra i tanti sui tuoi dati. Usalo come un input tra molti, non come parola definitiva.
Il test di normalità non è sempre necessario. Se sei sotto scadenza, sapere quando saltarlo può farti risparmiare tempo senza influire sui risultati.
Quando hai un campione ampio, il teorema del limite centrale garantisce che la distribuzione campionaria della media sia approssimativamente normale, indipendentemente dalla forma dei dati grezzi. In questa situazione i test parametrici sono in genere affidabili, quindi eseguire un test formale di normalità aggiunge poco valore.
Alcuni metodi statistici sono anche robusti alla non normalità. Tecniche come la regressione lineare tendono a reggere bene quando la dimensione del campione è ragionevole e le violazioni non sono estreme. (La regressione lineare assume comunque normalità nei residui.)
Quando stai cercando pattern, costruendo intuizioni o decidendo quali variabili approfondire, un rapido istogramma o Q-Q plot è sufficiente. I test formali servono per l’analisi confermativa - quando le tue conclusioni devono reggere.
Ricorda che i test di normalità esistono per proteggerti dal trarre conclusioni sbagliate. Se sei in un contesto in cui una conclusione errata non ha conseguenze reali, o in cui il tuo metodo non dipende dalla normalità, il test è opzionale.
Testare la normalità serve a verificare se le tue assunzioni tengono abbastanza da poterti fidare dei risultati.
Nessun dataset è perfettamente normale. L’obiettivo è capire come si comportano i tuoi dati e scegliere di conseguenza i metodi. Un Q-Q plot ti dice dove sono le deviazioni. Un test formale ti informa se sono statisticamente rilevabili. Insieme, danno un quadro più chiaro di ciascuno singolarmente.
Il test giusto dipende dal contesto. Usa Shapiro-Wilk per campioni piccoli, Anderson-Darling quando contano le code, alternative non parametriche quando la normalità non è assumibile. E a volte - con campioni grandi o metodi robusti - nessun test del tutto.
Trovi confuso l’intero concetto di p-value? Leggi il nostro articolo Hypothesis Testing Made Easy per assicurarti di interpretarli correttamente.
Impara con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



