Standart normal dağılımın temellerini ve istatistik, veri bilimi ve makine öğrenimindeki önemini keşfedin. Bu kavramı gerçek dünya veri analizine nasıl uygulayacağınızı öğrenin.
Normal dağılım ya da Gauss dağılımı gibi pek çok adla anılan çan eğrisini, özellikle istatistik ya da veri bilimine ilgi duyuyorsanız, neredeyse her yerde görebilirsiniz. Sanki doğanın bir kazasıymış gibi görünür ama öyle değildir: Ölçtüklerimizin çoğu, birçoğu küçük olan etkenlerin toplamının sonucudur; bu da altta yatan bir toplamsal modelin varlığına işaret eder.
Herhangi bir normal dağılımı standart normal dağılım denen özel bir forma dönüştürerek, belirli bağlamlarda —olasılık hesaplama, istatistiksel çıkarım yapma ve istatistiksel testler uygulama gibi— özellikle kullanışlı bir dağılım elde ederiz. Bu yazının sonunda standart normal dağılımın ne olduğunu, neden ekstra bir adım olarak onu standardize ettiğimizi ve tüm bunların değişkenlik, olasılık ve hipotez testleri ile nasıl ilişkili olduğunu netleştirmiş olacaksınız. Yazının sonunda ayrıca, bu yazıdaki fikirleri geliştirmeye devam etmek için R ile İstatistiğe Giriş kursumuza ya da R ile İstatistiksel Çıkarım yetkinlik yolumuza kaydolmanızı umuyorum.
Standart Normal Dağılım Nedir?
Standart normal dağılım, ortalamanın sıfır ve standart sapmanın bir olduğu özel bir normal dağılım biçimidir. Ayrıca dağılımın simetrik olduğunu ve belirli değerlere ilişkin olasılıkların, merkezden uzaklaştıkça simetrik biçimde azaldığını da söylemeliyiz.
"Standart Normal Dağılım" Görseli: Dall-E
Standart Normal Dağılım Denklemlerini Anlamak
Şimdi standart normal dağılımın matematiksel yönlerine biraz daha yakından bakalım.
Standart normal dağılımın PDF’i
Olasılık yoğunluk fonksiyonu (PDF) fikrine aşina değilseniz, bunun, sürekli bir rassal değişkenin olası değerleri üzerindeki olasılıkların nasıl dağıldığını tanımladığını bilin. Üstel dağılım, t-dağılımı veya Cauchy dağılımı gibi her sürekli olasılık dağılımının eğriyi tanımlayan kendine özgü bir olasılık yoğunluk fonksiyonu vardır. Standart normal dağılımın PDF’i burada tanımlanır:
Bu fonksiyon, eğrinin altındaki alanın 1 olacak şekilde integre edilmesini sağlar. Denkleme bakıp x’in farklı değerlerini yerine koyarsanız, o noktalardaki eğri yüksekliğini elde edersiniz. Denklemde:
x herhangi bir gerçek sayıyı temsil eder ve fonksiyonun giriş değişkenidir. Fonksiyonun üstel kısmında, yani −x2/2 ifadesinde yer alır. Bu, eğrinin şeklini kontrol eder.
x2 her zaman negatif olmayan bir değerdir ve önünde eksi işareti bulunduğundan üs her zaman negatif ya da sıfırdır.
x=0 özel durumunda, üs en büyük değerine ulaşır ve f(x) tepe noktasına erişir.
x, 0’dan pozitif ya da negatif yönde uzaklaştıkça x2 artar ve üst daha da negatife gider. Daha negatif bir üs, daha küçük bir fonksiyon değeri verir; bu da, söylediklerimizle birlikte, f(x)’in x=0’ın iki yanında simetrik biçimde azaldığı anlamına gelir.
Üssün tabanı olan Euler sayısı, x her iki yönde de sıfırdan uzaklaştıkça fonksiyonun hızlı şekilde sönümlenmesini sağlar.
Sabit 1/√(2π), eğri altındaki toplam alanın 1 olmasını sağlar.
Standart normal dağılımın CDF’i
PDF, farklı değerlerin göreli olasılıklarını verirken, CDF bir değişkenin belirli bir değerden küçük ya da ona eşit olma olasılığını verir. PDF gibi, her sürekli olasılık dağılımının kendine özgü bir CDF’i vardır.
Bu denklem biraz daha karmaşık, ancak adım adım ilerleyebiliriz:
İntegral, CDF’in x noktasındaki eğri yüksekliğini vermek yerine, −∞ ile x arasındaki toplam olasılığı verdiği anlamına gelir.
x→−∞ iken CDF, 0’a yaklaşır.
x=0 olduğunda CDF 0,5’tir; çünkü dağılım simetriktir ve olasılığın yarısı sıfırın solunda yer alır.
x→∞ iken CDF, 1’e yaklaşır.
Standart Normal Dağılımla Neden İlgileniriz?
Gauss dağılımı rehberimiz, verilerinizi ne zaman normal bir dağılıma uydurmak isteyebileceğinize dair iyi fikirler sunar. Ancak bazen verilerinizi özel olarak standart normale dönüştürmek isteyebilirsiniz. Bunun yaygın nedenlerinden bazıları şunlardır:
Standart normal, hipotez testlerinde kullanılır
Standart normal dağılım, verilerimizi belirli istatistiksel yöntemlerle daha karşılaştırılabilir ve kullanılabilir kılar. Verileri Z-puanlarına dönüştürerek farklı normal dağılımlar arasındaki gözlemleri karşılaştırabiliriz. Özellikle, bir örneklem ortalamasının ana kütle ortalamasından anlamlı biçimde farklı olup olmadığını belirlemek istediğimizde kullandığımız Z-testlerinin temelini oluşturur.
Öte yandan t-testi, ana kütle standart sapmasının bir tahmini olarak örneklem standart sapmasını kullanır; bu nedenle standart normal dağılıma kıyasla daha ağır kuyruklara sahip t-dağılımına dayanır. Ana kütle ve örneklem varyansı gibi konuları ele alan T-testi vs. Z-testi: Hangisi Ne Zaman Kullanılır adlı eğitimimizi okuyun.
Standart normal, verileri ortak bir ölçekte karşılaştırır
Farklı veri kümeleri ve değişkenler farklı birimlere ve ölçeklere sahip olabilir; bu da doğrudan karşılaştırmayı zorlaştırır. Ancak, ortalamayı çıkarıp standart sapmaya böldüğünüzde, farklı dağılımlar arasında kolay karşılaştırma sağlayan Z-puanlarına dönüştürmüş olursunuz. Normal dağılmış bir veri kümesine uygulandığında bu, standart normal dağılım ile sonuçlanır. Örneğin, her ikisinin de normal dağıldığını beklediğim SAT ve GRE puanlarını Z-puanlarına dönüştürmek, öğrencilerin kendi test popülasyonlarına göre performanslarını karşılaştırmamıza olanak tanır.
Standart normal, kalite kontrolde kullanılır
Standart normalin, üretimde ürün kalitesinin izlenmesinde önemli olduğu bilinir. Olasılıklara yakından bakarak, üreticiler kalite dalgalanmalarının rastgele değişimden mi yoksa başka bir altta yatan sorundan mı kaynaklandığını belirleyebilir. Bu, daha önce bahsettiğimiz hipotez testleriyle ve aşağıda ele alacağımız Z-puanı tablosuyla ilişkilidir.
Standart normal, istatistiksel modellemede kullanılır
Standart normal dağılım, doğrusal regresyon ve zaman serisi tahmini gibi modellerde hataların değerlendirilmesinde rol oynar. Bu modellerde, gözlenen ve tahmin edilen değerler arasındaki farklar olan artıkların, yalnızca normal dağılıma uyduğu değil, aynı zamanda standart normal dağılıma uyması için standardize edilebildiği varsayılır.
Doğrusal regresyonda standartlaştırılmış artıklar, standartlaştırılmış değerlere dönüştürülmüş artıklardır; bu da bir hatanın kaç standart sapma birimi kadar uç olduğunu ölçmemizi sağlar ve aykırı değerleri tespit etmeyi kolaylaştırabilir. Bu yararlıdır; çünkü modelin yordayıcılarında bariz olmayan artık değişen varyans, artık yorumlarını bozabilir.
Zaman serisi analizinde, uygun şekilde standardize edildiğinde, tahmin hatalarının standart normal dağılıma uyduğu sıklıkla varsayılır. Bu, tahmin aralıklarının oluşturulması için önemlidir. ARIMA gibi birçok zaman serisi modeli, öngörüler etrafındaki güven sınırlarını tanımlamak için standart normal çeyrekliklerine dayanır. Ayrıca, zaman serisi ayrıştırmasında düzensiz dalgalanmaları yakalayan artık bileşenin sıklıkla normal dağıldığı görülür. Bu artık bileşeni standardize ederseniz, trend-döngü ya da mevsimsellikten kaynaklanmadığını bildiğiniz zaman serinizdeki aşırı değerlerin olasılığını bulabilirsiniz. Bu tür teknikleri R ile Zaman Serisi Tahmini kursumuzda öğreneceksiniz.
Aklıma ayrıca sıklıkla bir ön işleme tekniği olarak kullanılan temel bileşen analizi (PCA) geliyor. PCA’da, giriş özelliklerimizin ortalamasının sıfır ve varyansının bir olmasını isteriz; bu, büyük değerlere sahip özelliklerin baskın olmasını önlemeye yardımcı olur. Yaygın bir ön işleme adımı, verileri ortalamayı çıkarıp standart sapmaya bölerek standardize etmektir. Bu, her özelliğin sıfır ortalama ve birim varyansa sahip olmasını sağlar; ancak bunun normalliği zorunlu kılmadığını açıkça belirtmeliyiz. Yine de bazı durumlarda, orijinal dağılım zaten normale yakınsa, dönüştürülen verilerin normalliğe yaklaştığını beklerim.
Standart normal, olasılık hesaplarında kullanılır
Standart normal dağılımın, yukarıda bahsettiğimiz kümülatif dağılım fonksiyonu iyi tablolaştırılmıştır; yani önceden hesaplanıp yaygın olarak bulunan tablolarda düzenlenmiştir. Bu da olasılık hesaplarını kolaylaştırır; çünkü tek yapmanız gereken doğru değeri tablodan bulmaktır.
Örneğin, rastgele seçilen bir boy uzunluğunun 6 feet’in altında olma olasılığını bulmak için, nüfusun normal dağılımını kullanarak boyu standardize eder ve Z-puanını standart normal tabloda ararız. Bu tabloyu kullanmanız gerekirse diye yazının sonunda standart normal tablonun bir versiyonunu ekledim.
Verileri Standart Normal Dağılımla Uyumlu Hale Getirmek İçin Dönüşümler
Dönüşümler, verileri standart normal dağılıma daha uygun bir şekle sokmaya yardımcı olabilir. Kabaca konuşursak bu, iki aşamalı bir süreçtir. Önce verilerimizi normal hale gelecek şekilde dönüştürürüz, ardından Z-puanı standardizasyonu uygularız.
Not olarak, genellikle ilk adım olarak Z-puanı standardizasyonu uygulamazsınız; çünkü uç değerler standart sapmayı bozabilir; zira ortalama ve standart sapma aykırı değerlere duyarlıdır. Ayrıca bazı dönüşümler pozitif veriye ihtiyaç duyar. Z-puanı standardizasyonunu önce uygularsanız, ortalama etrafında merkezlenmiş değerler negatif sayıları içerebilir; bu da sadece pozitif değerlerle çalışan dönüşümler (özellikle logaritma) için sorun yaratabilir. Bu yüzden sırayla gitmek en iyisidir: önce adım 1, sonra adım 2.
Adım 1: Verileri normal hale getirin
Kullanabileceğiniz bazı dönüşüm fikirleri şunlardır:
Sağa çarpık veriler için log dönüşümü
Veriler pozitif yönde çarpıksa, log dönüşümü onları normale yaklaştırmaya yardımcı olabilir. Örneğin ham değerlere logaritma uygulamak, büyük değerleri sıkıştırır; çarpıklığı azaltarak daha simetrik bir dağılım oluşturur.
Sayım verileri için karekök dönüşümü
Sayım verileri veya orta düzeyde çarpık veri kümeleri için karekök dönüşümünü deneyebiliriz. Bu yöntem, daha simetrik bir yapı korurken değişkenliği azaltır ve verileri çan eğrisi biçimine yaklaştırır.
Esnek ayarlamalar için Box-Cox dönüşümü
Box-Cox dönüşümü, dönüşümü veriye göre uyarlayarak bir adım daha ileri gider. Lambda (λ) parametresi uygulanan kesin formülü belirler ve verileri standart normal dağılımın özellikleriyle hizalamada son derece esnek hale getirir. R ile Özellik Mühendisliği kursu, Box-Cox’u ve diğer pek çok önemli ve kullanışlı yöntemi gösterecektir.
Adım 2: Z-puanı standardizasyonunu uygulayın
Bir dönüşüm uygulandıktan sonra, veriler standart normal dağılıma uyacak şekilde standardize edilebilir. Bu, verilerin ortalamasını sıfır ve standart sapmasını bir olacak şekilde ayarlar. Z-puanı formülü:
burada X dönüştürülmüş veridir, μ ortalama ve σ standart sapmadır.
Şimdi, R ile İstatistiksel Çıkarım yolumuzda ele aldığımız ana kütle Z-puanı ile örneklem Z-puanı ayrımına aşinaysanız, yukarıdaki denklemi ana kütle Z-puanı için olan denklem olarak tanıyabilirsiniz. Tüm ana kütle yerine bir örneklem ile çalışıyorsanız, ortalama ve standart sapmayı tahmin ederiz:
Burada X üzeri çizgi (X-bar) örneklem ortalamasıdır ve s örneklem standart sapmasıdır.
Yeni, normalleştirilmiş veri kümesinin ortalama ve standart sapmasını kullanmanız durumunda da sonuç aynı olurdu. Ancak bazen araştırmacılar, Z-puanlarını hesaplamak için örneklemimizinkiler yerine bir tür ulusal ortalama ve standart sapma gibi daha geniş bir referans ana kütleye göre verileri karşılaştırmakla ilgilenebilir.
Sağa çarpık olan bir gelir veri setini ele aldığınızı ve onu normale yaklaştırmak için log dönüşümü yaptığınızı hayal edin. Ardından, gelirleri ulusal kıyaslara göre karşılaştırmak istediğimizi düşünün; bu durumda Z-puanlarını hesaplarken örneklemimizinkiler yerine ulusal ortalama ve standart sapmayı kullanırdık. Amaç, veri kümeleri veya çalışmalar arasında anlamlı bir karşılaştırmaya olanak tanımaktır.
Özetle, bir örneklem kullanıyorsanız teknik olarak tam kuramsal standart normal dağılım yerine standardize edilmiş bir normal yaklaşımı elde edersiniz. Büyük veri kümelerinde farkın küçük olması gerekse de bunun açıklamaya değer bir ayrım olduğunu düşünüyorum.
Standart Normal Dağılımın Görselleştirilmesi
R programlama dilinde kuramsal bir standart normal dağılım oluşturmanın bir yolu şöyledir. Bu kodda, standart puanlar yani Z-puanları için dikey çizgiler de ekledim; bu, herhangi bir değer için, bu değerin ana kütle ortalamasının kaç standart sapma üzerinde ya da altında olduğunu söylemenin bir yoludur.
Standart normale benzeyebilen ama aslında standart normal olmayan bazı benzer dağılımlar olduğunu bilmelisiniz:
Dağılım
Neden Standart Normal Değil
t-Dağılımı
Biraz daha ağır kuyruklar; serbestlik derecelerine bağlıdır
Lojistik Dağılım
Normalden biraz daha ağır kuyruklar, farklı şekil
Laplace Dağılımı
Daha sivri tepe, daha ağır kuyruklar, üstel sönüm
Standart Normal Dağılım ve Standart Normal Tablo
Şimdi daha önce değindiğim bir konuya dönelim: Standart normal tablo, diğer adıyla Z-puanı tablosu ya da Z-tablosu fikri. Bu tablo, standart normal dağılımda bir değerin ortalamadan kaç standart sapma uzakta olduğunu gösteren Z-puanı için kümülatif olasılıkları bulmakta kullanılır. Bu tablo, istatistikte hipotez testleri, güven aralıkları ve olasılık hesapları için yaygın olarak kullanılır. Buradaki fikir, olasılıkları elle hesaplamak yerine, belirli bir Z-puanının altında kalan değerlerin oranını hızlıca belirlemek için tabloya başvurabilmenizdir.
Tabloyu okumak biraz pratik gerektirir ve tablolar bazen birbirinden farklı görünebilir. Burada iki boyutlu bir biçimde yapılandırıldığını görüyorsunuz. Amaç, ondalık basamaklarla çalışırken Z-puanları için olasılıkları aramayı kolaylaştırmaktır. Bu durumda, en soldaki sütun Z-puanının tam kısmını ve birinci ondalık basamağını içerir. Üst satır ise ikinci ondalık basamağı temsil eder. Belirli bir Z-puanıyla ilişkili olasılığı bulmak için, önce Z-puanının ilk kısmına karşılık gelen satırı bulun; ardından ikinci ondalık basamağa uyan sütunu bulun. Bu satır ve sütunun kesişimindeki değer kümülatif olasılıktır; yani bu Z-puanının altında kalan veri noktalarının oranıdır.
En iyisi bir örnekle göstermek: Örneğin, bir öğrencinin sınav puanı için 0,32’lik bir Z-puanı hesapladığınızı varsayalım. Bu, puanın ortalamanın 0,32 standart sapma üzerinde olduğu anlamına gelir. Şimdi, bu Z-puanından daha küçük bir değere rastlama olasılığını bulmak için Z-tablosunu kullanalım.
Adım 1: 0,3 satırını bulun.
Adım 2: 0,02 sütununu bulun.
Adım 3: 0,3 satırı ile 0,02 sütununun kesişimindeki değere bakın. Bu pozisyondaki değer 0,6915’tir.
Z = 0,32 için kümülatif olasılık 0,6554’tür; bu, standart normal dağılımdaki değerlerin %65,54’ününortalamanın 0,32 standart sapma üzerinde olduğunu ifade eder. Belirli bir Z-puanından daha büyük olma olasılığını bulmanız gerekiyorsa, satır ve sütunu bulmadan önce tablo değerini 1’den çıkarın.
Bilimsel dergilerde yayımlanan araştırma makalelerine katkıları olan bir veri bilimi yazarı ve editörüyüm. Özellikle lineer cebir, istatistik, R ve benzeri konularla ilgileniyorum. Aynı zamanda epey satranç da oynarım!
Standart Normal Dağılım Hakkında SSS
Standart normal dağılım, normal dağılımdan nasıl farklıdır?⌄
Standart normal dağılım, ortalamanın 0 ve standart sapmanın 1 olduğu özel bir normal dağılım durumudur. Bu standardizasyon, olasılık hesaplarını ve veri kümeleri arasında karşılaştırmaları kolaylaştırır.
Ortalamayı çıkarıp standart sapmaya bölmek standart normal dağılım oluşturur mu ⌄
Ortalamanın çıkarılması ve standart sapmaya bölünmesi bir veri kümesini standartlaştırılmış bir forma dönüştürür; ancak orijinal veriler normal dağılıma sahip değilse bu işlem tek başına standart normal dağılım oluşturmaz.
Standart normal dağılım ile merkezi limit teoremi arasındaki ilişki nedir?⌄
Merkezi limit teoremi, birbirinden bağımsız ve özdeş dağılıma sahip çok sayıda rassal değişkenin toplamının normal dağılıma eğilimli olduğunu ve bunun standart normal forma standardize edilebileceğini belirtir.
Standart normal dağılımda Z-puanı neyi ifade eder?⌄
Z-puanı, bir değerin ortalamadan kaç standart sapma uzakta olduğunu söyler. Pozitif bir Z-puanı değerinin ortalamanın üzerinde, negatif bir Z-puanı ise altında olduğunu ifade eder.
Standart normal dağılım güven aralıklarıyla nasıl ilişkilidir?⌄
Güven aralıkları, ana kütle parametrelerini tahmin etmek için olasılık aralıklarını belirlemede Z-puanlarını kullanır. Örneğin, %95 güven aralığı yaklaşık ±1,96’lık Z-puanlarına karşılık gelir.
Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!





Normal dağılım ya da Gauss dağılımı gibi pek çok adla anılan çan eğrisini, özellikle istatistik ya da veri bilimine ilgi duyuyorsanız, neredeyse her yerde görebilirsiniz. Sanki doğanın bir kazasıymış gibi görünür ama öyle değildir: Ölçtüklerimizin çoğu, birçoğu küçük olan etkenlerin toplamının sonucudur; bu da altta yatan bir toplamsal modelin varlığına işaret eder.
Herhangi bir normal dağılımı standart normal dağılım denen özel bir forma dönüştürerek, belirli bağlamlarda —olasılık hesaplama, istatistiksel çıkarım yapma ve istatistiksel testler uygulama gibi— özellikle kullanışlı bir dağılım elde ederiz. Bu yazının sonunda standart normal dağılımın ne olduğunu, neden ekstra bir adım olarak onu standardize ettiğimizi ve tüm bunların değişkenlik, olasılık ve hipotez testleri ile nasıl ilişkili olduğunu netleştirmiş olacaksınız. Yazının sonunda ayrıca, bu yazıdaki fikirleri geliştirmeye devam etmek için R ile İstatistiğe Giriş kursumuza ya da R ile İstatistiksel Çıkarım yetkinlik yolumuza kaydolmanızı umuyorum.
Standart Normal Dağılım Nedir?
Standart normal dağılım, ortalamanın sıfır ve standart sapmanın bir olduğu özel bir normal dağılım biçimidir. Ayrıca dağılımın simetrik olduğunu ve belirli değerlere ilişkin olasılıkların, merkezden uzaklaştıkça simetrik biçimde azaldığını da söylemeliyiz.
"Standart Normal Dağılım" Görseli: Dall-E
Standart Normal Dağılım Denklemlerini Anlamak
Şimdi standart normal dağılımın matematiksel yönlerine biraz daha yakından bakalım.
Standart normal dağılımın PDF’i
Olasılık yoğunluk fonksiyonu (PDF) fikrine aşina değilseniz, bunun, sürekli bir rassal değişkenin olası değerleri üzerindeki olasılıkların nasıl dağıldığını tanımladığını bilin. Üstel dağılım, t-dağılımı veya Cauchy dağılımı gibi her sürekli olasılık dağılımının eğriyi tanımlayan kendine özgü bir olasılık yoğunluk fonksiyonu vardır. Standart normal dağılımın PDF’i burada tanımlanır: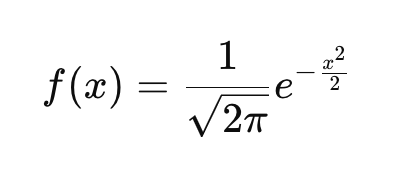
Bu fonksiyon, eğrinin altındaki alanın 1 olacak şekilde integre edilmesini sağlar. Denkleme bakıp x’in farklı değerlerini yerine koyarsanız, o noktalardaki eğri yüksekliğini elde edersiniz. Denklemde:
Standart normal dağılımın CDF’i
PDF, farklı değerlerin göreli olasılıklarını verirken, CDF bir değişkenin belirli bir değerden küçük ya da ona eşit olma olasılığını verir. PDF gibi, her sürekli olasılık dağılımının kendine özgü bir CDF’i vardır.
Bu denklem biraz daha karmaşık, ancak adım adım ilerleyebiliriz:
Standart Normal Dağılımla Neden İlgileniriz?
Gauss dağılımı rehberimiz, verilerinizi ne zaman normal bir dağılıma uydurmak isteyebileceğinize dair iyi fikirler sunar. Ancak bazen verilerinizi özel olarak standart normale dönüştürmek isteyebilirsiniz. Bunun yaygın nedenlerinden bazıları şunlardır:
Standart normal, hipotez testlerinde kullanılır
Standart normal dağılım, verilerimizi belirli istatistiksel yöntemlerle daha karşılaştırılabilir ve kullanılabilir kılar. Verileri Z-puanlarına dönüştürerek farklı normal dağılımlar arasındaki gözlemleri karşılaştırabiliriz. Özellikle, bir örneklem ortalamasının ana kütle ortalamasından anlamlı biçimde farklı olup olmadığını belirlemek istediğimizde kullandığımız Z-testlerinin temelini oluşturur.
Öte yandan t-testi, ana kütle standart sapmasının bir tahmini olarak örneklem standart sapmasını kullanır; bu nedenle standart normal dağılıma kıyasla daha ağır kuyruklara sahip t-dağılımına dayanır. Ana kütle ve örneklem varyansı gibi konuları ele alan T-testi vs. Z-testi: Hangisi Ne Zaman Kullanılır adlı eğitimimizi okuyun.
Standart normal, verileri ortak bir ölçekte karşılaştırır
Farklı veri kümeleri ve değişkenler farklı birimlere ve ölçeklere sahip olabilir; bu da doğrudan karşılaştırmayı zorlaştırır. Ancak, ortalamayı çıkarıp standart sapmaya böldüğünüzde, farklı dağılımlar arasında kolay karşılaştırma sağlayan Z-puanlarına dönüştürmüş olursunuz. Normal dağılmış bir veri kümesine uygulandığında bu, standart normal dağılım ile sonuçlanır. Örneğin, her ikisinin de normal dağıldığını beklediğim SAT ve GRE puanlarını Z-puanlarına dönüştürmek, öğrencilerin kendi test popülasyonlarına göre performanslarını karşılaştırmamıza olanak tanır.
Standart normal, kalite kontrolde kullanılır
Standart normalin, üretimde ürün kalitesinin izlenmesinde önemli olduğu bilinir. Olasılıklara yakından bakarak, üreticiler kalite dalgalanmalarının rastgele değişimden mi yoksa başka bir altta yatan sorundan mı kaynaklandığını belirleyebilir. Bu, daha önce bahsettiğimiz hipotez testleriyle ve aşağıda ele alacağımız Z-puanı tablosuyla ilişkilidir.
Standart normal, istatistiksel modellemede kullanılır
Standart normal dağılım, doğrusal regresyon ve zaman serisi tahmini gibi modellerde hataların değerlendirilmesinde rol oynar. Bu modellerde, gözlenen ve tahmin edilen değerler arasındaki farklar olan artıkların, yalnızca normal dağılıma uyduğu değil, aynı zamanda standart normal dağılıma uyması için standardize edilebildiği varsayılır.
Doğrusal regresyonda standartlaştırılmış artıklar, standartlaştırılmış değerlere dönüştürülmüş artıklardır; bu da bir hatanın kaç standart sapma birimi kadar uç olduğunu ölçmemizi sağlar ve aykırı değerleri tespit etmeyi kolaylaştırabilir. Bu yararlıdır; çünkü modelin yordayıcılarında bariz olmayan artık değişen varyans, artık yorumlarını bozabilir.
Zaman serisi analizinde, uygun şekilde standardize edildiğinde, tahmin hatalarının standart normal dağılıma uyduğu sıklıkla varsayılır. Bu, tahmin aralıklarının oluşturulması için önemlidir. ARIMA gibi birçok zaman serisi modeli, öngörüler etrafındaki güven sınırlarını tanımlamak için standart normal çeyrekliklerine dayanır. Ayrıca, zaman serisi ayrıştırmasında düzensiz dalgalanmaları yakalayan artık bileşenin sıklıkla normal dağıldığı görülür. Bu artık bileşeni standardize ederseniz, trend-döngü ya da mevsimsellikten kaynaklanmadığını bildiğiniz zaman serinizdeki aşırı değerlerin olasılığını bulabilirsiniz. Bu tür teknikleri R ile Zaman Serisi Tahmini kursumuzda öğreneceksiniz.
Standart normal, makine öğreniminde kullanılır
Birçok makine öğrenimi algoritması, veriler standart bir ölçekte olduğunda en iyi performansı gösterir. Aklıma lojistik regresyon, k-ortalamalar kümeleme ve sinir ağları geliyor.
Aklıma ayrıca sıklıkla bir ön işleme tekniği olarak kullanılan temel bileşen analizi (PCA) geliyor. PCA’da, giriş özelliklerimizin ortalamasının sıfır ve varyansının bir olmasını isteriz; bu, büyük değerlere sahip özelliklerin baskın olmasını önlemeye yardımcı olur. Yaygın bir ön işleme adımı, verileri ortalamayı çıkarıp standart sapmaya bölerek standardize etmektir. Bu, her özelliğin sıfır ortalama ve birim varyansa sahip olmasını sağlar; ancak bunun normalliği zorunlu kılmadığını açıkça belirtmeliyiz. Yine de bazı durumlarda, orijinal dağılım zaten normale yakınsa, dönüştürülen verilerin normalliğe yaklaştığını beklerim.
Standart normal, olasılık hesaplarında kullanılır
Standart normal dağılımın, yukarıda bahsettiğimiz kümülatif dağılım fonksiyonu iyi tablolaştırılmıştır; yani önceden hesaplanıp yaygın olarak bulunan tablolarda düzenlenmiştir. Bu da olasılık hesaplarını kolaylaştırır; çünkü tek yapmanız gereken doğru değeri tablodan bulmaktır.
Örneğin, rastgele seçilen bir boy uzunluğunun 6 feet’in altında olma olasılığını bulmak için, nüfusun normal dağılımını kullanarak boyu standardize eder ve Z-puanını standart normal tabloda ararız. Bu tabloyu kullanmanız gerekirse diye yazının sonunda standart normal tablonun bir versiyonunu ekledim.
Verileri Standart Normal Dağılımla Uyumlu Hale Getirmek İçin Dönüşümler
Dönüşümler, verileri standart normal dağılıma daha uygun bir şekle sokmaya yardımcı olabilir. Kabaca konuşursak bu, iki aşamalı bir süreçtir. Önce verilerimizi normal hale gelecek şekilde dönüştürürüz, ardından Z-puanı standardizasyonu uygularız.
Not olarak, genellikle ilk adım olarak Z-puanı standardizasyonu uygulamazsınız; çünkü uç değerler standart sapmayı bozabilir; zira ortalama ve standart sapma aykırı değerlere duyarlıdır. Ayrıca bazı dönüşümler pozitif veriye ihtiyaç duyar. Z-puanı standardizasyonunu önce uygularsanız, ortalama etrafında merkezlenmiş değerler negatif sayıları içerebilir; bu da sadece pozitif değerlerle çalışan dönüşümler (özellikle logaritma) için sorun yaratabilir. Bu yüzden sırayla gitmek en iyisidir: önce adım 1, sonra adım 2.
Adım 1: Verileri normal hale getirin
Kullanabileceğiniz bazı dönüşüm fikirleri şunlardır:
Sağa çarpık veriler için log dönüşümü
Veriler pozitif yönde çarpıksa, log dönüşümü onları normale yaklaştırmaya yardımcı olabilir. Örneğin ham değerlere logaritma uygulamak, büyük değerleri sıkıştırır; çarpıklığı azaltarak daha simetrik bir dağılım oluşturur.
Sayım verileri için karekök dönüşümü
Sayım verileri veya orta düzeyde çarpık veri kümeleri için karekök dönüşümünü deneyebiliriz. Bu yöntem, daha simetrik bir yapı korurken değişkenliği azaltır ve verileri çan eğrisi biçimine yaklaştırır.
Esnek ayarlamalar için Box-Cox dönüşümü
Box-Cox dönüşümü, dönüşümü veriye göre uyarlayarak bir adım daha ileri gider. Lambda (λ) parametresi uygulanan kesin formülü belirler ve verileri standart normal dağılımın özellikleriyle hizalamada son derece esnek hale getirir. R ile Özellik Mühendisliği kursu, Box-Cox’u ve diğer pek çok önemli ve kullanışlı yöntemi gösterecektir.
Adım 2: Z-puanı standardizasyonunu uygulayın
Bir dönüşüm uygulandıktan sonra, veriler standart normal dağılıma uyacak şekilde standardize edilebilir. Bu, verilerin ortalamasını sıfır ve standart sapmasını bir olacak şekilde ayarlar. Z-puanı formülü:
burada X dönüştürülmüş veridir, μ ortalama ve σ standart sapmadır.
Şimdi, R ile İstatistiksel Çıkarım yolumuzda ele aldığımız ana kütle Z-puanı ile örneklem Z-puanı ayrımına aşinaysanız, yukarıdaki denklemi ana kütle Z-puanı için olan denklem olarak tanıyabilirsiniz. Tüm ana kütle yerine bir örneklem ile çalışıyorsanız, ortalama ve standart sapmayı tahmin ederiz:
Burada X üzeri çizgi (X-bar) örneklem ortalamasıdır ve s örneklem standart sapmasıdır.
Yeni, normalleştirilmiş veri kümesinin ortalama ve standart sapmasını kullanmanız durumunda da sonuç aynı olurdu. Ancak bazen araştırmacılar, Z-puanlarını hesaplamak için örneklemimizinkiler yerine bir tür ulusal ortalama ve standart sapma gibi daha geniş bir referans ana kütleye göre verileri karşılaştırmakla ilgilenebilir.
Sağa çarpık olan bir gelir veri setini ele aldığınızı ve onu normale yaklaştırmak için log dönüşümü yaptığınızı hayal edin. Ardından, gelirleri ulusal kıyaslara göre karşılaştırmak istediğimizi düşünün; bu durumda Z-puanlarını hesaplarken örneklemimizinkiler yerine ulusal ortalama ve standart sapmayı kullanırdık. Amaç, veri kümeleri veya çalışmalar arasında anlamlı bir karşılaştırmaya olanak tanımaktır.
Özetle, bir örneklem kullanıyorsanız teknik olarak tam kuramsal standart normal dağılım yerine standardize edilmiş bir normal yaklaşımı elde edersiniz. Büyük veri kümelerinde farkın küçük olması gerekse de bunun açıklamaya değer bir ayrım olduğunu düşünüyorum.
Standart Normal Dağılımın Görselleştirilmesi
R programlama dilinde kuramsal bir standart normal dağılım oluşturmanın bir yolu şöyledir. Bu kodda, standart puanlar yani Z-puanları için dikey çizgiler de ekledim; bu, herhangi bir değer için, bu değerin ana kütle ortalamasının kaç standart sapma üzerinde ya da altında olduğunu söylemenin bir yoludur.
Standart normale benzeyebilen ama aslında standart normal olmayan bazı benzer dağılımlar olduğunu bilmelisiniz:
Standart Normal Dağılım ve Standart Normal Tablo
Şimdi daha önce değindiğim bir konuya dönelim: Standart normal tablo, diğer adıyla Z-puanı tablosu ya da Z-tablosu fikri. Bu tablo, standart normal dağılımda bir değerin ortalamadan kaç standart sapma uzakta olduğunu gösteren Z-puanı için kümülatif olasılıkları bulmakta kullanılır. Bu tablo, istatistikte hipotez testleri, güven aralıkları ve olasılık hesapları için yaygın olarak kullanılır. Buradaki fikir, olasılıkları elle hesaplamak yerine, belirli bir Z-puanının altında kalan değerlerin oranını hızlıca belirlemek için tabloya başvurabilmenizdir.
Tabloyu okumak biraz pratik gerektirir ve tablolar bazen birbirinden farklı görünebilir. Burada iki boyutlu bir biçimde yapılandırıldığını görüyorsunuz. Amaç, ondalık basamaklarla çalışırken Z-puanları için olasılıkları aramayı kolaylaştırmaktır. Bu durumda, en soldaki sütun Z-puanının tam kısmını ve birinci ondalık basamağını içerir. Üst satır ise ikinci ondalık basamağı temsil eder. Belirli bir Z-puanıyla ilişkili olasılığı bulmak için, önce Z-puanının ilk kısmına karşılık gelen satırı bulun; ardından ikinci ondalık basamağa uyan sütunu bulun. Bu satır ve sütunun kesişimindeki değer kümülatif olasılıktır; yani bu Z-puanının altında kalan veri noktalarının oranıdır.
En iyisi bir örnekle göstermek: Örneğin, bir öğrencinin sınav puanı için 0,32’lik bir Z-puanı hesapladığınızı varsayalım. Bu, puanın ortalamanın 0,32 standart sapma üzerinde olduğu anlamına gelir. Şimdi, bu Z-puanından daha küçük bir değere rastlama olasılığını bulmak için Z-tablosunu kullanalım.
Z = 0,32 için kümülatif olasılık 0,6554’tür; bu, standart normal dağılımdaki değerlerin %65,54’ünün ortalamanın 0,32 standart sapma üzerinde olduğunu ifade eder. Belirli bir Z-puanından daha büyük olma olasılığını bulmanız gerekiyorsa, satır ve sütunu bulmadan önce tablo değerini 1’den çıkarın.
Sonuç
Standart normal dağılıma yaptığımız bu yolculuktan keyif aldığınızı umarım. DataCamp ile öğrenmeye devam edin. R ile İstatistiğe Giriş kursumuzdan ve R ile İstatistiksel Çıkarım yetkinlik yolumuzdan bahsettim. Ancak Python tercih ediyorsanız, Python’da İstatistiksel Düşünme kursumuz ve Python’da Deney Tasarımı kursumuz da harika seçeneklerdir.