La distribuzione normale standard: cos’è e perché è importante
Scopri i fondamenti della distribuzione normale standard e la sua importanza in statistica, data science e machine learning. Impara ad applicare questo concetto all’analisi di dati reali.
Potresti notare la curva a campana, che ha molti nomi, come distribuzione normale o distribuzione gaussiana, praticamente ovunque, soprattutto se hai un occhio per la statistica o la data science. Sembra, ma non è, un accidente della natura: risulta che molto di ciò che misuriamo è il risultato della somma di molti piccoli fattori, il che suggerisce la presenza di un modello additivo sottostante.
Trasformando qualsiasi distribuzione normale in una forma speciale chiamata distribuzione normale standard, possiamo ottenere una distribuzione particolarmente utile in contesti specifici, come il calcolo delle probabilità, le inferenze statistiche e l’applicazione di test statistici. Alla fine di questo articolo, ti sarà chiaro cos’è la distribuzione normale standard, perché facciamo il passo in più di standardizzarla e come tutto questo si collega a variabilità, probabilità e test d’ipotesi. Spero anche che alla fine ti iscriverai al nostro corso Introduction to Statistics in R o al percorso Statistical Inference in R per continuare a sviluppare le idee presentate in questo articolo.
Che cos’è la distribuzione normale standard?
La distribuzione normale standard è una forma specifica della distribuzione normale in cui la media è zero e la deviazione standard è uno. Dovremmo anche dire che la distribuzione è simmetrica e che le probabilità di certi valori diminuiscono simmetricamente man mano che ci si allontana dal centro.
Immagine "Standard Normal Distribution" di Dall-E
Capire le equazioni della distribuzione normale standard
Diamo uno sguardo più da vicino agli aspetti matematici della distribuzione normale standard.
La PDF della distribuzione normale standard
Se non hai familiarità con l’idea di funzione di densità di probabilità (PDF), sappi che descrive come le probabilità sono distribuite sui possibili valori di una variabile casuale continua. Ogni distribuzione di probabilità continua, come la distribuzione esponenziale, la distribuzione t o la distribuzione di Cauchy, ha la propria funzione di densità che definisce la curva. La PDF della distribuzione normale standard è definita qui:
Questa funzione garantisce che l’area sotto la curva si integri a 1. Se guardi l’equazione e inserisci diversi valori di x, ottieni l’altezza della curva in quei punti. Nell’equazione:
x rappresenta un qualsiasi numero reale ed è la variabile di input della funzione. Compare nell’esponente della funzione, che è −x2/2. Questo controlla la forma della curva.
Poiché x2 è sempre non negativo e c’è un segno meno davanti, l’esponente è sempre negativo o nullo.
Nel caso specifico in cui x=0, l’esponente è massimo, facendo raggiungere a f(x) il suo picco.
Se x si allontana da 0 sia in direzione positiva che negativa, x2 aumenta, rendendo l’esponente più negativo. Un esponente più negativo produce un valore della funzione più piccolo, il che, insieme ad altro detto, significa che f(x) diminuisce simmetricamente su entrambi i lati di x=0.
La base dell’esponente, cioè il numero di Eulero, assicura il rapido decadimento della funzione man mano che x si allontana da zero in entrambe le direzioni.
La costante 1/√(2π) garantisce che l’area totale sotto la curva sia pari a 1.
La CDF della distribuzione normale standard
A differenza della PDF, che fornisce la probabilità relativa di valori diversi, la CDF ti dice la probabilità che una variabile sia minore o uguale a un dato valore. Proprio come la PDF, ogni distribuzione continua ha la sua CDF.
Questa equazione è un po’ più complicata, ma possiamo analizzarla:
L’integrale significa che, invece di dare l’altezza della curva in x, la CDF ci dice la probabilità totale da −∞ a x.
Quando x→−∞, la CDF tende a 0.
Quando x=0 la CDF è 0,5, poiché la distribuzione è simmetrica e metà della probabilità si trova a sinistra dello zero.
Quando x→∞, la CDF tende a 1.
Perché ci interessa la distribuzione normale standard
La nostra guida sulla distribuzione gaussiana offre buone idee su quando potresti voler conformare i tuoi dati a una distribuzione normale. Ma a volte potresti voler trasformare i tuoi dati specificamente in una normale standard. Ecco alcuni motivi comuni:
La normale standard è usata nei test d’ipotesi
Una distribuzione normale standard rende i nostri dati più confrontabili e utilizzabili con certi metodi statistici. Convertendo i dati in Z-score, possiamo confrontare osservazioni tra diverse distribuzioni normali. In particolare, è alla base degli Z-test, che usiamo quando vogliamo determinare se la media di un campione differisce in modo significativo dalla media della popolazione.
Il t-test, invece, usa la deviazione standard del campione come stima della deviazione standard della popolazione, motivo per cui si basa sulla distribuzione t, che ha code più pesanti rispetto alla normale standard. Leggi il nostro tutorial T-test vs. Z-test: When to Use Each, che parla di cose come varianza della popolazione e del campione.
La normale standard confronta i dati su una scala comune
Poiché dataset e variabili diverse possono avere unità e scale diverse, i confronti diretti possono essere difficili. Ma quando le converti in Z-score sottraendo la media e dividendo per la deviazione standard, ottieni un confronto semplice tra distribuzioni diverse. Applicato a un dataset normalmente distribuito, questo porta a unadistribuzione normale standard. Per esempio, convertire sia i punteggi SAT che GRE, che mi aspetto siano distribuiti normalmente, in Z-score ci consente di confrontare le prestazioni degli studenti rispetto alle rispettive popolazioni di test.
La normale standard è usata nel controllo qualità
La normale standard è nota per essere importante nel monitoraggio della qualità dei prodotti in ambito manifatturiero. Osservando da vicino le probabilità, i produttori possono determinare se le fluttuazioni della qualità siano dovute a variazioni casuali o a qualche altro problema sottostante. Questo è collegato ai test d’ipotesi, che abbiamo menzionato prima, e anche a una tabella degli Z-score, di cui parleremo sotto.
La normale standard è usata nella modellazione statistica
La distribuzione normale standard ha un ruolo nella valutazione degli errori in modelli come la regressione lineare e la previsione di serie temporali. In questi modelli, assumiamo che i residui, cioè le differenze tra valori osservati e predetti, non solo seguano una distribuzione normale ma possano anche essere standardizzati per seguire una normale standard.
Nella regressione lineare, i residui standardizzati sono residui convertiti in valori standardizzati, che permettono di misurare quanto è estremo un errore in unità di deviazione standard, rendendo più facile individuare gli outlier. Questo è utile perché l’eteroschedasticità nei residui, che può essere non evidente nei predittori del modello, può distorcere l’interpretazione dei residui.
Nell’analisi delle serie temporali, si assume spesso che gli errori di previsione seguano una distribuzione normale standard quando adeguatamente standardizzati. Questo è importante per costruire intervalli di previsione. Molti modelli di serie temporali, come ARIMA, si basano sui quantili della normale standard per definire i limiti di confidenza attorno alle previsioni. Inoltre, nella decomposizione delle serie temporali, la componente resto, che cattura le fluttuazioni irregolari, è spesso risultata normalmente distribuita. Se standardizzi questa componente di resto, potresti trovare la probabilità di valori estremi nella tua serie temporale che sai non essere il risultato del ciclo-trend o della stagionalità. Il nostro corso Forecasting in R ti insegnerà queste tecniche.
Penso anche all’analisi delle componenti principali, spesso usata come tecnica di preprocessing. Nella PCA, vogliamo che le feature in input abbiano media zero e varianza unitaria per aiutare a evitare che le feature con valori grandi dominino. Un passaggio di preprocessing comune è standardizzare i dati sottraendo la media e dividendoli per la deviazione standard. Questo assicura che ogni feature abbia media zero e varianza unitaria, ma va chiarito che non impone la normalità. Tuttavia, in alcuni casi mi aspetto che i dati trasformati approssimino la normalità se la distribuzione originale era già vicina alla normale.
La normale standard è usata per i calcoli di probabilità
La funzione di ripartizione cumulativa della distribuzione normale standard, di cui abbiamo parlato prima, è ben tabulata, cioè precomputata e organizzata in tabelle ampiamente disponibili, il che rende più facili i calcoli di probabilità perché basta usare la tabella per cercare il valore corretto.
Per esempio, per trovare la probabilità che un’altezza scelta a caso sia inferiore a 6 piedi, standardizziamo l’altezza usando la distribuzione normale della popolazione e cerchiamo lo Z-score in una tabella della normale standard. Ho inserito una versione della tabella della normale standard in fondo a questo articolo nel caso ti servisse.
Trasformazioni per allineare i dati alla distribuzione normale standard
Le trasformazioni possono aiutare a rimodellare i dati in una distribuzione normale standard. A grandi linee, sarebbe un processo in due parti. Prima, rimodelliamo i dati per renderli normali, poi eseguiamo la standardizzazione tramite Z-score.
Nota: in genere non applicheresti la standardizzazione tramite Z-score come primo passo perché i valori estremi possono distorcere la deviazione standard, dato che media e deviazione standard sono sensibili agli outlier. Inoltre, alcune trasformazioni richiedono dati positivi. Se applichi prima la standardizzazione Z-score, i valori centrati sulla media possono includere numeri negativi, il che può creare problemi per trasformazioni che funzionano solo con valori positivi. Penso in particolare ai logaritmi. Quindi è meglio seguire l’ordine: passo 1, poi passo 2.
Passo 1: Trasformare i dati per renderli normali
Alcune idee di trasformazione che potresti usare includono:
Trasformazione logaritmica per dati asimmetrici positivamente
Quando i dati sono asimmetrici positivamente, una trasformazione logaritmica può aiutare a normalizzarli. Ad esempio, applicare il logaritmo ai valori grezzi comprime i valori grandi, riducendo l’asimmetria e creando una distribuzione più simmetrica.
Trasformazione radice quadrata per dati di conteggio
Per dati di conteggio o dataset moderatamente asimmetrici, possiamo provare una trasformazione a radice quadrata. Questo metodo riduce la variabilità mantenendo una struttura più simmetrica, avvicinando i dati alla forma a campana.
Trasformazione di Box-Cox per aggiustamenti flessibili
La trasformazione di Box-Cox fa un passo oltre, adattando la trasformazione ai dati. Il suo parametro λ determina la formula esatta applicata, rendendola altamente versatile per allineare i dati alle proprietà della distribuzione normale standard. Feature Engineering in R ti mostrerà la Box-Cox, insieme a molti altri metodi importanti e utili.
Passo 2: Eseguire la standardizzazione tramite Z-score
Una volta applicata una trasformazione, i dati possono essere standardizzati per adattarsi alla distribuzione normale standard. Questo regola i dati affinché abbiano media zero e deviazione standard uno. La formula dello Z-score è:
dove X è il dato trasformato, μ è la media e σ è la deviazione standard.
Ora, se conosci la distinzione tra Z-score di popolazione e Z-score di campione, come trattiamo nel nostro percorso Statistical Inference in R, potresti riconoscere l’equazione sopra come quella per uno Z-score di popolazione. Se stai lavorando con un campione invece che con l’intera popolazione, stimeremmo media e deviazione standard al loro posto:
Qui, X-bar è la media campionaria e s è la deviazione standard campionaria.
Il risultato sarebbe lo stesso se usassi la media e la deviazione standard del nuovo dataset normalizzato. Ma a volte i ricercatori potrebbero essere interessati a confrontare i dati rispetto a una popolazione di riferimento più ampia usando una sorta di media e deviazione standard di benchmark.
Immagina di osservare un dataset di redditi, che sarebbe asimmetrico a destra, e di applicare una trasformazione log per normalizzarlo. Poi, immagina anche di voler confrontare i redditi rispetto a benchmark nazionali, nel qual caso useremmo la media e la deviazione standard nazionali invece di quelle del nostro campione per calcolare gli Z-score. Lo scopo qui sarebbe permettere confronti significativi tra dataset o studi.
Quindi, in sostanza, se stai usando un campione, tecnicamente ottieni un’approssimazione normalizzata standard piuttosto che l’esatta distribuzione normale standard teorica. Credo sia una distinzione che vale la pena chiarire, anche se la differenza dev’essere piccola per dataset grandi.
Visualizzare la distribuzione normale standard
Ecco un modo per creare una distribuzione normale standard teorica nel linguaggio R. In questo codice ho anche aggiunto linee verticali per i punteggi standard, alias Z-score, che è un modo per dirci, per un dato valore, di quante deviazioni standard sopra o sotto la media della popolazione si trova il nostro valore.
install.packages("ggplot2")
library(ggplot2)
ggplot(data.frame(x = c(-4,4)), aes(x))+
stat_function(fun = dnorm, geom ="area", fill ='#ffe6b7', color ='black', alpha =0.5, args = list( mean =0, sd =1))+
labs(title ="Standard Normal Distribution", subtitle ="Standard Deviations and Z-Scores")+
theme(plot.title = element_text(hjust =0.5, face ="bold"))+
theme(plot.subtitle = element_text(hjust =0.5))+
geom_vline(xintercept =1, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-1, linetype ='dotdash', color ="black")+
geom_vline(xintercept =2, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-2, linetype ='dotdash', color ="black")+
geom_vline(xintercept =3, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-3, linetype ='dotdash', color ="black")+
geom_text(aes(x=1, label="\n 1 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=2, label="\n 2 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=3, label="\n 3 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-1, label="\n-1 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-2, label="\n-2 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-3, label="\n-3 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))Offerto da
Dovresti sapere che esistono alcune distribuzioni simili che possono sembrare normali standard ma non lo sono:
Distribuzione
Perché non è normale standard
Distribuzione t
Code leggermente più pesanti, dipende dai gradi di libertà
Distribuzione logistica
Code leggermente più pesanti della normale, forma diversa
Distribuzione di Laplace
Picco più acuto, code più pesanti, decadimento esponenziale
La distribuzione normale standard e la tabella della normale standard
Torno ora a qualcosa che ho menzionato prima: l’idea di una tabella della normale standard, chiamata anche tabella degli Z-score o Z-table, che si usa per trovare le probabilità cumulative per uno Z-score, che rappresenta il numero di deviazioni standard di cui un valore si discosta dalla media in una normale standard. Questa tabella è comunemente usata in statistica per test d’ipotesi, intervalli di confidenza e calcoli di probabilità. L’idea è che, invece di calcolare le probabilità manualmente, puoi consultare la tabella per determinare rapidamente la proporzione di valori che stanno al di sotto di un dato Z-score.
La tabella richiede un po’ di pratica per essere letta, e le tabelle a volte possono apparire diverse. Qui la vedi strutturata in un formato bidimensionale. Lo scopo è facilitare la consultazione delle probabilità per gli Z-score quando si lavora con le cifre decimali. In questo caso, la colonna più a sinistra contiene la parte intera e la prima cifra decimale dello Z-score. La riga superiore rappresenta la seconda cifra decimale. Per trovare la probabilità associata a uno Z-score specifico, individua la riga corrispondente alla prima parte dello Z-score, quindi trova la colonna che corrisponde alla seconda cifra decimale. Il valore all’intersezione di questa riga e colonna è la probabilità cumulativa, cioè la proporzione di punti che si collocano al di sotto di quello Z-score.
È meglio mostrare un esempio: Per esempio, supponi di calcolare uno Z-score di 0,32 per il punteggio di uno studente. Questo significa che il punteggio è 0,32 deviazioni standard sopra la media. Ora, usiamo la Z-table per trovare la probabilità che un valore selezionato a caso sia inferiore a questo Z-score.
Passo 1: Individua la riga per 0,3.
Passo 2: Individua la colonna per 0,02.
Passo 3: Guarda l’intersezione della riga per 0,3 e della colonna per 0,02. Il valore in questa posizione è 0,6915.
La probabilità cumulativa per Z = 0,32 è 0,6554, il che significa che il 65,54% dei valori in una distribuzione normale standard è inferiore a 0,32 deviazioni standard sopra la media. Se devi determinare la probabilità che un valore sia maggiore di un dato Z-score, sottrai il valore della tabella da 1 prima di trovare riga e colonna.
Sono uno scrittore e editor di data science, con contributi a articoli di ricerca su riviste scientifiche. Sono particolarmente interessato ad algebra lineare, statistica, R e affini. Inoltre, gioco anche parecchio a scacchi!
Domande frequenti sulla distribuzione normale standard
In cosa la distribuzione normale standard è diversa da una distribuzione normale?⌄
La distribuzione normale standard è un caso specifico della distribuzione normale in cui la media è 0 e la deviazione standard è 1. Questa standardizzazione consente calcoli di probabilità e confronti tra dataset più semplici.
Sottrarre la media e dividere per la deviazione standard crea una distribuzione normale standard⌄
Sottrarre la media e dividere per la deviazione standard trasforma un dataset in una forma standardizzata, ma non crea necessariamente una distribuzione normale standard a meno che i dati originali non fossero distribuiti normalmente.
Qual è la relazione tra la distribuzione normale standard e il teorema del limite centrale?⌄
Il teorema del limite centrale afferma che la somma di molte variabili casuali indipendenti e identicamente distribuite tende a seguire una distribuzione normale, che può essere standardizzata nella forma normale standard.
Cosa rappresenta uno Z-score nella distribuzione normale standard?⌄
Uno Z-score ci dice di quante deviazioni standard un valore si discosta dalla media. Uno Z-score positivo significa che il valore è sopra la media, mentre uno Z-score negativo significa che è sotto.
Come si collega la distribuzione normale standard agli intervalli di confidenza?⌄
Gli intervalli di confidenza usano gli Z-score per determinare intervalli di probabilità per stimare parametri di popolazione. Per esempio, un intervallo di confidenza al 95% corrisponde a Z-score di circa ±1,96.
Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.





Potresti notare la curva a campana, che ha molti nomi, come distribuzione normale o distribuzione gaussiana, praticamente ovunque, soprattutto se hai un occhio per la statistica o la data science. Sembra, ma non è, un accidente della natura: risulta che molto di ciò che misuriamo è il risultato della somma di molti piccoli fattori, il che suggerisce la presenza di un modello additivo sottostante.
Trasformando qualsiasi distribuzione normale in una forma speciale chiamata distribuzione normale standard, possiamo ottenere una distribuzione particolarmente utile in contesti specifici, come il calcolo delle probabilità, le inferenze statistiche e l’applicazione di test statistici. Alla fine di questo articolo, ti sarà chiaro cos’è la distribuzione normale standard, perché facciamo il passo in più di standardizzarla e come tutto questo si collega a variabilità, probabilità e test d’ipotesi. Spero anche che alla fine ti iscriverai al nostro corso Introduction to Statistics in R o al percorso Statistical Inference in R per continuare a sviluppare le idee presentate in questo articolo.
Che cos’è la distribuzione normale standard?
La distribuzione normale standard è una forma specifica della distribuzione normale in cui la media è zero e la deviazione standard è uno. Dovremmo anche dire che la distribuzione è simmetrica e che le probabilità di certi valori diminuiscono simmetricamente man mano che ci si allontana dal centro.
Immagine "Standard Normal Distribution" di Dall-E
Capire le equazioni della distribuzione normale standard
Diamo uno sguardo più da vicino agli aspetti matematici della distribuzione normale standard.
La PDF della distribuzione normale standard
Se non hai familiarità con l’idea di funzione di densità di probabilità (PDF), sappi che descrive come le probabilità sono distribuite sui possibili valori di una variabile casuale continua. Ogni distribuzione di probabilità continua, come la distribuzione esponenziale, la distribuzione t o la distribuzione di Cauchy, ha la propria funzione di densità che definisce la curva. La PDF della distribuzione normale standard è definita qui: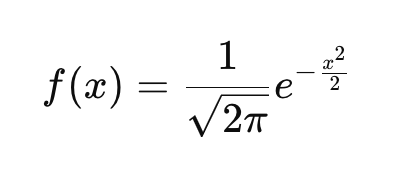
Questa funzione garantisce che l’area sotto la curva si integri a 1. Se guardi l’equazione e inserisci diversi valori di x, ottieni l’altezza della curva in quei punti. Nell’equazione:
La CDF della distribuzione normale standard
A differenza della PDF, che fornisce la probabilità relativa di valori diversi, la CDF ti dice la probabilità che una variabile sia minore o uguale a un dato valore. Proprio come la PDF, ogni distribuzione continua ha la sua CDF.
Questa equazione è un po’ più complicata, ma possiamo analizzarla:
Perché ci interessa la distribuzione normale standard
La nostra guida sulla distribuzione gaussiana offre buone idee su quando potresti voler conformare i tuoi dati a una distribuzione normale. Ma a volte potresti voler trasformare i tuoi dati specificamente in una normale standard. Ecco alcuni motivi comuni:
La normale standard è usata nei test d’ipotesi
Una distribuzione normale standard rende i nostri dati più confrontabili e utilizzabili con certi metodi statistici. Convertendo i dati in Z-score, possiamo confrontare osservazioni tra diverse distribuzioni normali. In particolare, è alla base degli Z-test, che usiamo quando vogliamo determinare se la media di un campione differisce in modo significativo dalla media della popolazione.
Il t-test, invece, usa la deviazione standard del campione come stima della deviazione standard della popolazione, motivo per cui si basa sulla distribuzione t, che ha code più pesanti rispetto alla normale standard. Leggi il nostro tutorial T-test vs. Z-test: When to Use Each, che parla di cose come varianza della popolazione e del campione.
La normale standard confronta i dati su una scala comune
Poiché dataset e variabili diverse possono avere unità e scale diverse, i confronti diretti possono essere difficili. Ma quando le converti in Z-score sottraendo la media e dividendo per la deviazione standard, ottieni un confronto semplice tra distribuzioni diverse. Applicato a un dataset normalmente distribuito, questo porta a una distribuzione normale standard. Per esempio, convertire sia i punteggi SAT che GRE, che mi aspetto siano distribuiti normalmente, in Z-score ci consente di confrontare le prestazioni degli studenti rispetto alle rispettive popolazioni di test.
La normale standard è usata nel controllo qualità
La normale standard è nota per essere importante nel monitoraggio della qualità dei prodotti in ambito manifatturiero. Osservando da vicino le probabilità, i produttori possono determinare se le fluttuazioni della qualità siano dovute a variazioni casuali o a qualche altro problema sottostante. Questo è collegato ai test d’ipotesi, che abbiamo menzionato prima, e anche a una tabella degli Z-score, di cui parleremo sotto.
La normale standard è usata nella modellazione statistica
La distribuzione normale standard ha un ruolo nella valutazione degli errori in modelli come la regressione lineare e la previsione di serie temporali. In questi modelli, assumiamo che i residui, cioè le differenze tra valori osservati e predetti, non solo seguano una distribuzione normale ma possano anche essere standardizzati per seguire una normale standard.
Nella regressione lineare, i residui standardizzati sono residui convertiti in valori standardizzati, che permettono di misurare quanto è estremo un errore in unità di deviazione standard, rendendo più facile individuare gli outlier. Questo è utile perché l’eteroschedasticità nei residui, che può essere non evidente nei predittori del modello, può distorcere l’interpretazione dei residui.
Nell’analisi delle serie temporali, si assume spesso che gli errori di previsione seguano una distribuzione normale standard quando adeguatamente standardizzati. Questo è importante per costruire intervalli di previsione. Molti modelli di serie temporali, come ARIMA, si basano sui quantili della normale standard per definire i limiti di confidenza attorno alle previsioni. Inoltre, nella decomposizione delle serie temporali, la componente resto, che cattura le fluttuazioni irregolari, è spesso risultata normalmente distribuita. Se standardizzi questa componente di resto, potresti trovare la probabilità di valori estremi nella tua serie temporale che sai non essere il risultato del ciclo-trend o della stagionalità. Il nostro corso Forecasting in R ti insegnerà queste tecniche.
La normale standard è usata nel machine learning
Molti algoritmi di machine learning funzionano al meglio quando i dati sono su una scala standard. Penso alla regressione logistica, al k-means clustering e alle reti neurali.
Penso anche all’analisi delle componenti principali, spesso usata come tecnica di preprocessing. Nella PCA, vogliamo che le feature in input abbiano media zero e varianza unitaria per aiutare a evitare che le feature con valori grandi dominino. Un passaggio di preprocessing comune è standardizzare i dati sottraendo la media e dividendoli per la deviazione standard. Questo assicura che ogni feature abbia media zero e varianza unitaria, ma va chiarito che non impone la normalità. Tuttavia, in alcuni casi mi aspetto che i dati trasformati approssimino la normalità se la distribuzione originale era già vicina alla normale.
La normale standard è usata per i calcoli di probabilità
La funzione di ripartizione cumulativa della distribuzione normale standard, di cui abbiamo parlato prima, è ben tabulata, cioè precomputata e organizzata in tabelle ampiamente disponibili, il che rende più facili i calcoli di probabilità perché basta usare la tabella per cercare il valore corretto.
Per esempio, per trovare la probabilità che un’altezza scelta a caso sia inferiore a 6 piedi, standardizziamo l’altezza usando la distribuzione normale della popolazione e cerchiamo lo Z-score in una tabella della normale standard. Ho inserito una versione della tabella della normale standard in fondo a questo articolo nel caso ti servisse.
Trasformazioni per allineare i dati alla distribuzione normale standard
Le trasformazioni possono aiutare a rimodellare i dati in una distribuzione normale standard. A grandi linee, sarebbe un processo in due parti. Prima, rimodelliamo i dati per renderli normali, poi eseguiamo la standardizzazione tramite Z-score.
Nota: in genere non applicheresti la standardizzazione tramite Z-score come primo passo perché i valori estremi possono distorcere la deviazione standard, dato che media e deviazione standard sono sensibili agli outlier. Inoltre, alcune trasformazioni richiedono dati positivi. Se applichi prima la standardizzazione Z-score, i valori centrati sulla media possono includere numeri negativi, il che può creare problemi per trasformazioni che funzionano solo con valori positivi. Penso in particolare ai logaritmi. Quindi è meglio seguire l’ordine: passo 1, poi passo 2.
Passo 1: Trasformare i dati per renderli normali
Alcune idee di trasformazione che potresti usare includono:
Trasformazione logaritmica per dati asimmetrici positivamente
Quando i dati sono asimmetrici positivamente, una trasformazione logaritmica può aiutare a normalizzarli. Ad esempio, applicare il logaritmo ai valori grezzi comprime i valori grandi, riducendo l’asimmetria e creando una distribuzione più simmetrica.
Trasformazione radice quadrata per dati di conteggio
Per dati di conteggio o dataset moderatamente asimmetrici, possiamo provare una trasformazione a radice quadrata. Questo metodo riduce la variabilità mantenendo una struttura più simmetrica, avvicinando i dati alla forma a campana.
Trasformazione di Box-Cox per aggiustamenti flessibili
La trasformazione di Box-Cox fa un passo oltre, adattando la trasformazione ai dati. Il suo parametro λ determina la formula esatta applicata, rendendola altamente versatile per allineare i dati alle proprietà della distribuzione normale standard. Feature Engineering in R ti mostrerà la Box-Cox, insieme a molti altri metodi importanti e utili.
Passo 2: Eseguire la standardizzazione tramite Z-score
Una volta applicata una trasformazione, i dati possono essere standardizzati per adattarsi alla distribuzione normale standard. Questo regola i dati affinché abbiano media zero e deviazione standard uno. La formula dello Z-score è:
dove X è il dato trasformato, μ è la media e σ è la deviazione standard.
Ora, se conosci la distinzione tra Z-score di popolazione e Z-score di campione, come trattiamo nel nostro percorso Statistical Inference in R, potresti riconoscere l’equazione sopra come quella per uno Z-score di popolazione. Se stai lavorando con un campione invece che con l’intera popolazione, stimeremmo media e deviazione standard al loro posto:
Qui, X-bar è la media campionaria e s è la deviazione standard campionaria.
Il risultato sarebbe lo stesso se usassi la media e la deviazione standard del nuovo dataset normalizzato. Ma a volte i ricercatori potrebbero essere interessati a confrontare i dati rispetto a una popolazione di riferimento più ampia usando una sorta di media e deviazione standard di benchmark.
Immagina di osservare un dataset di redditi, che sarebbe asimmetrico a destra, e di applicare una trasformazione log per normalizzarlo. Poi, immagina anche di voler confrontare i redditi rispetto a benchmark nazionali, nel qual caso useremmo la media e la deviazione standard nazionali invece di quelle del nostro campione per calcolare gli Z-score. Lo scopo qui sarebbe permettere confronti significativi tra dataset o studi.
Quindi, in sostanza, se stai usando un campione, tecnicamente ottieni un’approssimazione normalizzata standard piuttosto che l’esatta distribuzione normale standard teorica. Credo sia una distinzione che vale la pena chiarire, anche se la differenza dev’essere piccola per dataset grandi.
Visualizzare la distribuzione normale standard
Ecco un modo per creare una distribuzione normale standard teorica nel linguaggio R. In questo codice ho anche aggiunto linee verticali per i punteggi standard, alias Z-score, che è un modo per dirci, per un dato valore, di quante deviazioni standard sopra o sotto la media della popolazione si trova il nostro valore.
Dovresti sapere che esistono alcune distribuzioni simili che possono sembrare normali standard ma non lo sono:
La distribuzione normale standard e la tabella della normale standard
Torno ora a qualcosa che ho menzionato prima: l’idea di una tabella della normale standard, chiamata anche tabella degli Z-score o Z-table, che si usa per trovare le probabilità cumulative per uno Z-score, che rappresenta il numero di deviazioni standard di cui un valore si discosta dalla media in una normale standard. Questa tabella è comunemente usata in statistica per test d’ipotesi, intervalli di confidenza e calcoli di probabilità. L’idea è che, invece di calcolare le probabilità manualmente, puoi consultare la tabella per determinare rapidamente la proporzione di valori che stanno al di sotto di un dato Z-score.
La tabella richiede un po’ di pratica per essere letta, e le tabelle a volte possono apparire diverse. Qui la vedi strutturata in un formato bidimensionale. Lo scopo è facilitare la consultazione delle probabilità per gli Z-score quando si lavora con le cifre decimali. In questo caso, la colonna più a sinistra contiene la parte intera e la prima cifra decimale dello Z-score. La riga superiore rappresenta la seconda cifra decimale. Per trovare la probabilità associata a uno Z-score specifico, individua la riga corrispondente alla prima parte dello Z-score, quindi trova la colonna che corrisponde alla seconda cifra decimale. Il valore all’intersezione di questa riga e colonna è la probabilità cumulativa, cioè la proporzione di punti che si collocano al di sotto di quello Z-score.
È meglio mostrare un esempio: Per esempio, supponi di calcolare uno Z-score di 0,32 per il punteggio di uno studente. Questo significa che il punteggio è 0,32 deviazioni standard sopra la media. Ora, usiamo la Z-table per trovare la probabilità che un valore selezionato a caso sia inferiore a questo Z-score.
La probabilità cumulativa per Z = 0,32 è 0,6554, il che significa che il 65,54% dei valori in una distribuzione normale standard è inferiore a 0,32 deviazioni standard sopra la media. Se devi determinare la probabilità che un valore sia maggiore di un dato Z-score, sottrai il valore della tabella da 1 prima di trovare riga e colonna.
Conclusione
Spero che questa esplorazione della distribuzione normale standard ti sia piaciuta. Continua a imparare con noi su DataCamp. Ho menzionato il nostro corso Introduction to Statistics in R e il percorso Statistical Inference in R. Ma se preferisci Python, i nostri corsi Statistical Thinking in Python e Experimental Design in Python sono entrambi ottime opzioni.