De standaardnormale verdeling: wat het is en waarom het ertoe doet
Ontdek de basis van de standaardnormale verdeling en het belang ervan in statistiek, data science en machine learning. Leer hoe je dit concept toepast op data-analyse in de praktijk.
Je ziet de klokvormige curve, die veel namen heeft zoals de normale verdeling of de Gauss-verdeling, overal opduiken, zeker als je oog hebt voor statistiek of data science. Het voelt als, maar is geen, toeval van de natuur: veel van wat we meten is het resultaat van talloze kleine factoren die bij elkaar worden opgeteld, wat wijst op een onderliggend additief model.
Door elke normale verdeling te transformeren naar een speciale vorm, de standaardnormale verdeling, krijgen we een verdeling die in specifieke contexten extra handig is, zoals het berekenen van kansen, het maken van statistische gevolgtrekkingen en het toepassen van statistische toetsen. Aan het eind van dit artikel weet je wat de standaardnormale verdeling is, waarom we de extra stap van standaardiseren zetten en hoe dit allemaal samenhangt met variabiliteit, kans en toetsen van hypothesen. Hopelijk schrijf je je daarna ook in voor onze cursus Introduction to Statistics in R of onze skill track Statistical Inference in R om verder te bouwen op de ideeën uit dit artikel.
Wat is de standaardnormale verdeling?
De standaardnormale verdeling is een specifieke vorm van de normale verdeling waarbij het gemiddelde nul is en de standaardafwijking één. We moeten er ook bij zeggen dat de verdeling symmetrisch is en dat de kansen op bepaalde waarden symmetrisch afnemen naarmate je verder van het midden beweegt.
"Standaardnormale verdeling" Afbeelding door Dall-E
De vergelijkingen van de standaardnormale verdeling begrijpen
Laten we wat nauwkeuriger kijken naar de wiskundige aspecten van de standaardnormale verdeling.
De PDF van de standaardnormale verdeling
Als je niet bekend bent met het idee van een kansdichtheidsfunctie (PDF), weet dan dat die beschrijft hoe kansen zijn verdeeld over de mogelijke waarden van een continue toevalsvariabele. Elke continue kansverdeling, zoals de exponentiële verdeling, de t-verdeling of de Cauchy-verdeling, heeft zijn eigen kansdichtheidsfunctie die de curve definieert. De PDF van de standaardnormale verdeling is hier gedefinieerd:
Deze functie zorgt ervoor dat de oppervlakte onder de curve tot 1 integreert. Als je naar de vergelijking kijkt en verschillende waarden van x invult, krijg je de hoogte van de curve op die punten. In de vergelijking:
x staat voor elk reëel getal en is de invoervariabele voor de functie. Het verschijnt in de exponent van de functie, namelijk −x2/2. Dit bepaalt de vorm van de curve.
Omdat x2 altijd niet-negatief is en er een minteken voor staat, is de exponent altijd negatief of nul.
In het specifieke geval waarin x=0 is de exponent het grootst, waardoor f(x) zijn piek bereikt.
Als x zich van 0 verwijdert, in positieve of negatieve richting, neemt x2 toe en wordt de exponent negatiever. Een negatievere exponent resulteert in een kleinere functiewaarde, wat, samen met de andere punten, betekent dat f(x) symmetrisch afneemt aan beide zijden van x=0.
De grondslag van de exponent, Eulers getal, zorgt voor het snelle verval van de functie naarmate x verder van nul beweegt in beide richtingen.
De constante 1/√(2π) zorgt ervoor dat de totale oppervlakte onder de curve gelijk is aan 1.
De CDF van de standaardnormale verdeling
In tegenstelling tot de PDF, die de relatieve waarschijnlijkheid van verschillende waarden geeft, vertelt de CDF je de kans dat een variabele kleiner is dan of gelijk is aan een gegeven waarde. Net als de PDF heeft elke continue kansverdeling zijn eigen CDF.
Deze vergelijking is wat ingewikkelder, maar we kunnen haar doorlopen:
De integraal betekent dat de CDF ons, in plaats van de hoogte van de curve bij x, de totale kans van −∞ tot x geeft.
Als x→−∞, nadert de CDF 0.
Als x=0 is de CDF 0,5, omdat de verdeling symmetrisch is en de helft van de kans links van nul ligt.
Als x→∞, nadert de CDF 1.
Waarom we geven om de standaardnormale verdeling
Onze gids over de Gauss-verdeling bevat goede ideeën over wanneer je je data zou willen laten voldoen aan een normale verdeling. Maar soms wil je je data specifiek omzetten naar een standaardnormale verdeling. Hier zijn enkele veelvoorkomende redenen:
De standaardnormaal wordt gebruikt bij hypothesetoetsing
Een standaardnormale verdeling maakt onze data beter vergelijkbaar en bruikbaar met bepaalde statistische methoden. Door data om te zetten in Z-scores kunnen we observaties vergelijken over verschillende normale verdelingen heen. In het bijzonder vormt ze de basis van Z-toetsen, die we gebruiken wanneer we willen bepalen of een steekproefgemiddelde significant afwijkt van een populatiegemiddelde.
De t-toets daarentegen gebruikt de steekproefstandaardafwijking als schatting van de populatiestandaardafwijking, waardoor ze berust op de t-verdeling, die zwaardere staarten heeft dan de standaardnormale verdeling. Lees onze tutorial T-test vs. Z-test: wanneer gebruik je welke, die ingaat op zaken als populatie- en steekproefvariantie.
De standaardnormaal vergelijkt data op een gemeenschappelijke schaal
Omdat verschillende datasets en variabelen verschillende eenheden en schalen kunnen hebben, kunnen directe vergelijkingen lastig zijn. Maar wanneer je ze omzet naar Z-scores door het gemiddelde af te trekken en te delen door de standaardafwijking, kun je eenvoudig vergelijken over verschillende verdelingen heen. Toegepast op een normaal verdeelde dataset resulteert dit in eenstandaardnormale verdeling. Zo maakt het omzetten van zowel SAT- als GRE-scores, waarvan ik verwacht dat ze normaal verdeeld zijn, naar Z-scores het mogelijk om de prestaties van studenten relatief aan hun respectieve testpopulaties te vergelijken.
De standaardnormaal wordt gebruikt in kwaliteitscontrole
De standaardnormaal is belangrijk bij het monitoren van productkwaliteit in de productie. Door nauwkeurig naar kansen te kijken, kunnen producenten bepalen of fluctuaties in kwaliteit te wijten zijn aan willekeurige variatie of aan een ander onderliggend probleem. Dit hangt samen met hypothesetoetsing, die we eerder noemden, en ook met een Z-tabel, waar we hieronder op terugkomen.
De standaardnormaal wordt gebruikt in statistische modellering
De standaardnormale verdeling speelt een rol bij het beoordelen van fouten in modellen zoals lineaire regressie en tijdreeksvoorspelling. In deze modellen gaan we ervan uit dat de residuen, de verschillen tussen geobserveerde en voorspelde waarden, niet alleen normaal verdeeld zijn, maar ook gestandaardiseerd kunnen worden om een standaardnormale verdeling te volgen.
In lineaire regressie zijn gestandaardiseerde residuen residuen die zijn omgezet naar gestandaardiseerde waarden, waarmee we kunnen meten hoe extreem een fout is in eenheden van standaardafwijkingen, wat het opsporen van uitschieters vergemakkelijkt. Dit is nuttig omdat heteroscedasticiteit in de residuen, die niet altijd duidelijk is in de voorspellers van het model, de interpretatie van residuen kan vertekenen.
In tijdreeksanalyse gaan we er vaak van uit dat voorspellingsfouten, mits correct gestandaardiseerd, een standaardnormale verdeling volgen. Dit is belangrijk voor het construeren van voorspellingsintervallen. Veel tijdreeksmodellen, zoals ARIMA, vertrouwen op standaardnormale kwantielen om betrouwbaarheidsgrenzen rond voorspellingen te definiëren. Ook wordt in tijdreeksdecompositie de restcomponent, die onregelmatige schommelingen vastlegt, vaak normaal verdeeld aangetroffen. Als je deze restcomponent standaardiseert, kun je de kans vinden op extreme waarden in je tijdreeks waarvan je weet dat ze niet het gevolg zijn van trend-cyclus of seizoensinvloeden. Onze cursus Forecasting in R leert je dit soort technieken.
De standaardnormaal wordt gebruikt in machine learning
Ik denk ook aan principalecomponentenanalyse, die vaak wordt gebruikt als voorbewerkingstechniek. Bij PCA willen we dat onze invoerkenmerken een gemiddeld van nul en een variantie van één hebben om te helpen voorkomen dat kenmerken met grote waarden domineren. Een veelgebruikte voorbewerkingsstap is het standaardiseren van de data door het gemiddelde af te trekken en te delen door de standaardafwijking. Dit zorgt ervoor dat elk kenmerk een gemiddeld van nul en een variantie van één heeft, maar we moeten duidelijk zijn dat dit geen normaliteit afdwingt. In sommige gevallen verwacht ik echter dat de getransformeerde data de normaliteit benadert als de oorspronkelijke verdeling al dicht bij normaal lag.
De standaardnormaal wordt gebruikt voor kansberekeningen
De cumulatieve verdelingsfunctie van de standaardnormale verdeling, waar we het eerder over hadden, is goed getabelleerd, waarmee ik bedoel: vooraf berekend en in tabellen georganiseerd die algemeen beschikbaar zijn. Dit maakt kansberekeningen makkelijker omdat je alleen de juiste waarde in de tabel hoeft op te zoeken.
Om bijvoorbeeld de kans te vinden dat een willekeurig gekozen lengte onder de 6 voet ligt, standaardiseren we de lengte met behulp van de normale verdeling van de populatie en zoeken we de Z-score op in een standaardnormale tabel. Onderaan dit artikel vind je een versie van de standaardnormale tabel voor het geval je die nodig hebt.
Transformaties om data in lijn te brengen met de standaardnormale verdeling
Transformaties kunnen helpen om data om te vormen naar een standaardnormale verdeling. Grofweg is dit een proces in twee stappen. Eerst vormen we onze data om naar normaal, en vervolgens voeren we Z-score-standaardisatie uit.
Let op: je past Z-score-standaardisatie doorgaans niet als eerste stap toe, omdat extreme waarden de standaardafwijking kunnen vertekenen; het gemiddelde en de standaardafwijking zijn namelijk gevoelig voor uitschieters. Ook vereisen sommige transformaties positieve data. Als je eerst Z-score-standaardisatie toepast, kunnen de rond het gemiddelde gecentreerde waarden negatief zijn, wat problemen kan geven bij transformaties die alleen met positieve waarden werken. Ik denk hierbij specifiek aan logaritmen. Het is dus het beste om de volgorde aan te houden: stap 1, dan stap 2.
Stap 1: Transformeer data naar normaal
Enkele transformatie-ideeën die je kunt gebruiken, zijn:
Logtransformatie voor scheve data
Wanneer data positief scheef is, kan een logtransformatie helpen normaliseren. Het toepassen van de logaritme op ruwe waarden comprimeert bijvoorbeeld grote waarden, vermindert de scheefheid en creëert een meer symmetrische verdeling.
Vierkantsworteltransformatie voor teldata
Voor teldata of matig scheve datasets kunnen we een vierkantsworteltransformatie proberen. Deze methode vermindert de variabiliteit terwijl de structuur symmetrischer wordt, waardoor de data dichter bij de klokvorm komt.
Box-Cox-transformatie voor flexibele aanpassingen
De Box-Cox-transformatie gaat een stap verder door de transformatie aan te passen aan de data. De parameter λ bepaalt de exacte formule die wordt toegepast, wat haar zeer veelzijdig maakt om data af te stemmen op de eigenschappen van de standaardnormale verdeling. Feature Engineering in R laat je de Box-Cox zien, naast veel andere belangrijke en nuttige methoden.
Stap 2: Voer Z-score-standaardisatie uit
Zodra een transformatie is toegepast, kan de data worden gestandaardiseerd om te passen bij de standaardnormale verdeling. Dit past de data aan zodat het gemiddelde nul is en de standaardafwijking één. De formule voor de Z-score is:
waar X de getransformeerde data is, μ het gemiddelde en σ de standaardafwijking.
Als je bekend bent met het onderscheid tussen Z-score voor een populatie en voor een steekproef, zoals we behandelen in onze track Statistical Inference in R, herken je de bovenstaande vergelijking als die voor een populatie-Z-score. Werk je met een steekproef in plaats van met de volledige populatie, dan schatten we het gemiddelde en de standaardafwijking in plaats daarvan:
Hier is X-streep het steekproefgemiddelde en s de steekproefstandaardafwijking.
Het resultaat zou hetzelfde zijn als je het gemiddelde en de standaardafwijking uit de nieuwe, genormaliseerde dataset zou gebruiken. Soms willen onderzoekers de data echter vergelijken ten opzichte van een grotere referentiepopulatie door in plaats daarvan een soort benchmarkgemiddelde en -standaardafwijking te gebruiken.
Stel je voor dat je naar een inkomensdataset kijkt, die rechts-scheef is, en dat je een logtransformatie uitvoert om deze te normaliseren. Stel je dan ook voor dat we de inkomens willen vergelijken met nationale benchmarks; in dat geval zouden we het nationale gemiddelde en de nationale standaardafwijking gebruiken in plaats van die uit onze steekproef om Z-scores te berekenen. Het doel is hier om zinvolle vergelijkingen mogelijk te maken tussen datasets of studies.
Kortom, als je een steekproef gebruikt, krijg je technisch gezien een gestandaardiseerde normale benadering in plaats van de exacte theoretische standaardnormale verdeling. Het is een onderscheid dat het waard is om te verduidelijken, ook al zal het verschil bij grote datasets klein zijn.
De standaardnormale verdeling visualiseren
Hier is één manier om een theoretische standaardnormale verdeling te maken in de R-programmeertaal. In deze code heb ik ook verticale lijnen toegevoegd voor standaardscores, oftewel Z-scores, wat een manier is om ons, voor een gegeven waarde, te vertellen hoeveel standaardafwijkingen boven of onder het populatiegemiddelde onze waarde ligt.
install.packages("ggplot2")
library(ggplot2)
ggplot(data.frame(x = c(-4,4)), aes(x))+
stat_function(fun = dnorm, geom ="area", fill ='#ffe6b7', color ='black', alpha =0.5, args = list( mean =0, sd =1))+
labs(title ="Standard Normal Distribution", subtitle ="Standard Deviations and Z-Scores")+
theme(plot.title = element_text(hjust =0.5, face ="bold"))+
theme(plot.subtitle = element_text(hjust =0.5))+
geom_vline(xintercept =1, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-1, linetype ='dotdash', color ="black")+
geom_vline(xintercept =2, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-2, linetype ='dotdash', color ="black")+
geom_vline(xintercept =3, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-3, linetype ='dotdash', color ="black")+
geom_text(aes(x=1, label="\n 1 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=2, label="\n 2 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=3, label="\n 3 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-1, label="\n-1 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-2, label="\n-2 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-3, label="\n-3 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))Mogelijk gemaakt door
Je moet weten dat er enkele soortgelijke verdelingen zijn die op een standaardnormale lijken maar het niet zijn:
Verdeling
Waarom het geen standaardnormaal is
t-verdeling
Iets zwaardere staarten, hangt af van vrijheidsgraden
De standaardnormale verdeling en de standaardnormale tabel
Laat me terugkomen op iets wat ik eerder noemde: het idee van een standaardnormale tabel, ook wel Z-scoretabel of Z-tabel genoemd, die wordt gebruikt om cumulatieve kansen te vinden voor een Z-score, die het aantal standaardafwijkingen weergeeft dat een waarde van het gemiddelde afligt in een standaardnormale verdeling. Deze tabel wordt veel gebruikt in de statistiek voor hypothesetoetsing, betrouwbaarheidsintervallen en kansberekeningen. Het idee is dat je, in plaats van kansen handmatig te berekenen, in de tabel snel het aandeel waarden kunt opzoeken dat onder een gegeven Z-score valt.
De tabel vergt wat oefening om te lezen, en tabellen zien er soms verschillend uit. Hier zie je hem in een tweedimensionale structuur. Het doel is om het opzoeken van kansen voor Z-scores met decimalen te vergemakkelijken. In dit geval bevat de meest linkse kolom het gehele getal en de eerste decimaal van de Z-score. De bovenste rij geeft de tweede decimaal weer. Om de kans bij een specifieke Z-score te vinden, zoek je de rij op die overeenkomt met het eerste deel van de Z-score en vervolgens de kolom die overeenkomt met de tweede decimaal. De waarde op het snijpunt van deze rij en kolom is de cumulatieve kans, oftewel het aandeel dat onder die Z-score valt.
Het is het beste om een voorbeeld te geven: Stel dat je een Z-score van 0,32 berekent voor iemands toetsresultaat. Dit betekent dat de score 0,32 standaardafwijkingen boven het gemiddelde ligt. Laten we nu de Z-tabel gebruiken om de kans te vinden dat een willekeurig geselecteerde waarde kleiner is dan deze Z-score.
Stap 1: Zoek de rij voor 0,3 op.
Stap 2: Zoek de kolom voor 0,02 op.
Stap 3: Kijk naar hetsnijpunt van de rij voor 0,3 en de kolom voor 0,02. De waarde op deze positie is 0,6915.
De cumulatieve kans voor Z = 0,32 is 0,6554, wat betekent dat 65,54% van de waarden in een standaardnormale verdeling minder dan 0,32 standaardafwijkingen boven het gemiddelde ligt. Moet je de kans bepalen dat een waarde groter is dan een gegeven Z-score, trek de tabelwaarde dan af van 1 voordat je de rij en kolom opzoekt.
Ik ben een schrijver en editor op het gebied van data science en heb bijgedragen aan onderzoeksartikelen in wetenschappelijke tijdschriften. Ik ben vooral geïnteresseerd in lineaire algebra, statistiek, R en dergelijke. Ik speel ook best wat schaak!
Veelgestelde vragen over de standaardnormale verdeling
Hoe verschilt de standaardnormale verdeling van een normale verdeling?⌄
De standaardnormale verdeling is een specifiek geval van de normale verdeling waarbij het gemiddelde 0 is en de standaardafwijking 1. Deze standaardisatie maakt kansberekeningen en vergelijkingen tussen datasets makkelijker.
Creëert het aftrekken van het gemiddelde en delen door de standaardafwijking een standaardnormale verdeling ⌄
Het aftrekken van het gemiddelde en delen door de standaardafwijking zet een dataset om in een gestandaardiseerde vorm, maar creëert niet per se een standaardnormale verdeling, tenzij de oorspronkelijke data normaal verdeeld was.
Wat is de relatie tussen de standaardnormale verdeling en de centrale limietstelling?⌄
De centrale limietstelling stelt dat de som van veel onafhankelijke, identiek verdeelde toevalsvariabelen de neiging heeft een normale verdeling te volgen, die kan worden gestandaardiseerd tot de standaardnormale vorm.
Wat stelt een Z-score voor in de standaardnormale verdeling?⌄
Een Z-score vertelt ons hoeveel standaardafwijkingen een waarde van het gemiddelde afligt. Een positieve Z-score betekent dat de waarde boven het gemiddelde ligt, terwijl een negatieve Z-score betekent dat hij eronder ligt.
Hoe hangt de standaardnormale verdeling samen met betrouwbaarheidsintervallen?⌄
Betrouwbaarheidsintervallen gebruiken Z-scores om kansbereiken te bepalen voor het schatten van populatieparameters. Een 95%-betrouwbaarheidsinterval komt bijvoorbeeld overeen met Z-scores van ongeveer ±1,96.




Je ziet de klokvormige curve, die veel namen heeft zoals de normale verdeling of de Gauss-verdeling, overal opduiken, zeker als je oog hebt voor statistiek of data science. Het voelt als, maar is geen, toeval van de natuur: veel van wat we meten is het resultaat van talloze kleine factoren die bij elkaar worden opgeteld, wat wijst op een onderliggend additief model.
Door elke normale verdeling te transformeren naar een speciale vorm, de standaardnormale verdeling, krijgen we een verdeling die in specifieke contexten extra handig is, zoals het berekenen van kansen, het maken van statistische gevolgtrekkingen en het toepassen van statistische toetsen. Aan het eind van dit artikel weet je wat de standaardnormale verdeling is, waarom we de extra stap van standaardiseren zetten en hoe dit allemaal samenhangt met variabiliteit, kans en toetsen van hypothesen. Hopelijk schrijf je je daarna ook in voor onze cursus Introduction to Statistics in R of onze skill track Statistical Inference in R om verder te bouwen op de ideeën uit dit artikel.
Wat is de standaardnormale verdeling?
De standaardnormale verdeling is een specifieke vorm van de normale verdeling waarbij het gemiddelde nul is en de standaardafwijking één. We moeten er ook bij zeggen dat de verdeling symmetrisch is en dat de kansen op bepaalde waarden symmetrisch afnemen naarmate je verder van het midden beweegt.
"Standaardnormale verdeling" Afbeelding door Dall-E
De vergelijkingen van de standaardnormale verdeling begrijpen
Laten we wat nauwkeuriger kijken naar de wiskundige aspecten van de standaardnormale verdeling.
De PDF van de standaardnormale verdeling
Als je niet bekend bent met het idee van een kansdichtheidsfunctie (PDF), weet dan dat die beschrijft hoe kansen zijn verdeeld over de mogelijke waarden van een continue toevalsvariabele. Elke continue kansverdeling, zoals de exponentiële verdeling, de t-verdeling of de Cauchy-verdeling, heeft zijn eigen kansdichtheidsfunctie die de curve definieert. De PDF van de standaardnormale verdeling is hier gedefinieerd: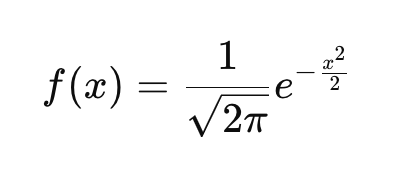
Deze functie zorgt ervoor dat de oppervlakte onder de curve tot 1 integreert. Als je naar de vergelijking kijkt en verschillende waarden van x invult, krijg je de hoogte van de curve op die punten. In de vergelijking:
De CDF van de standaardnormale verdeling
In tegenstelling tot de PDF, die de relatieve waarschijnlijkheid van verschillende waarden geeft, vertelt de CDF je de kans dat een variabele kleiner is dan of gelijk is aan een gegeven waarde. Net als de PDF heeft elke continue kansverdeling zijn eigen CDF.
Deze vergelijking is wat ingewikkelder, maar we kunnen haar doorlopen:
Waarom we geven om de standaardnormale verdeling
Onze gids over de Gauss-verdeling bevat goede ideeën over wanneer je je data zou willen laten voldoen aan een normale verdeling. Maar soms wil je je data specifiek omzetten naar een standaardnormale verdeling. Hier zijn enkele veelvoorkomende redenen:
De standaardnormaal wordt gebruikt bij hypothesetoetsing
Een standaardnormale verdeling maakt onze data beter vergelijkbaar en bruikbaar met bepaalde statistische methoden. Door data om te zetten in Z-scores kunnen we observaties vergelijken over verschillende normale verdelingen heen. In het bijzonder vormt ze de basis van Z-toetsen, die we gebruiken wanneer we willen bepalen of een steekproefgemiddelde significant afwijkt van een populatiegemiddelde.
De t-toets daarentegen gebruikt de steekproefstandaardafwijking als schatting van de populatiestandaardafwijking, waardoor ze berust op de t-verdeling, die zwaardere staarten heeft dan de standaardnormale verdeling. Lees onze tutorial T-test vs. Z-test: wanneer gebruik je welke, die ingaat op zaken als populatie- en steekproefvariantie.
De standaardnormaal vergelijkt data op een gemeenschappelijke schaal
Omdat verschillende datasets en variabelen verschillende eenheden en schalen kunnen hebben, kunnen directe vergelijkingen lastig zijn. Maar wanneer je ze omzet naar Z-scores door het gemiddelde af te trekken en te delen door de standaardafwijking, kun je eenvoudig vergelijken over verschillende verdelingen heen. Toegepast op een normaal verdeelde dataset resulteert dit in een standaardnormale verdeling. Zo maakt het omzetten van zowel SAT- als GRE-scores, waarvan ik verwacht dat ze normaal verdeeld zijn, naar Z-scores het mogelijk om de prestaties van studenten relatief aan hun respectieve testpopulaties te vergelijken.
De standaardnormaal wordt gebruikt in kwaliteitscontrole
De standaardnormaal is belangrijk bij het monitoren van productkwaliteit in de productie. Door nauwkeurig naar kansen te kijken, kunnen producenten bepalen of fluctuaties in kwaliteit te wijten zijn aan willekeurige variatie of aan een ander onderliggend probleem. Dit hangt samen met hypothesetoetsing, die we eerder noemden, en ook met een Z-tabel, waar we hieronder op terugkomen.
De standaardnormaal wordt gebruikt in statistische modellering
De standaardnormale verdeling speelt een rol bij het beoordelen van fouten in modellen zoals lineaire regressie en tijdreeksvoorspelling. In deze modellen gaan we ervan uit dat de residuen, de verschillen tussen geobserveerde en voorspelde waarden, niet alleen normaal verdeeld zijn, maar ook gestandaardiseerd kunnen worden om een standaardnormale verdeling te volgen.
In lineaire regressie zijn gestandaardiseerde residuen residuen die zijn omgezet naar gestandaardiseerde waarden, waarmee we kunnen meten hoe extreem een fout is in eenheden van standaardafwijkingen, wat het opsporen van uitschieters vergemakkelijkt. Dit is nuttig omdat heteroscedasticiteit in de residuen, die niet altijd duidelijk is in de voorspellers van het model, de interpretatie van residuen kan vertekenen.
In tijdreeksanalyse gaan we er vaak van uit dat voorspellingsfouten, mits correct gestandaardiseerd, een standaardnormale verdeling volgen. Dit is belangrijk voor het construeren van voorspellingsintervallen. Veel tijdreeksmodellen, zoals ARIMA, vertrouwen op standaardnormale kwantielen om betrouwbaarheidsgrenzen rond voorspellingen te definiëren. Ook wordt in tijdreeksdecompositie de restcomponent, die onregelmatige schommelingen vastlegt, vaak normaal verdeeld aangetroffen. Als je deze restcomponent standaardiseert, kun je de kans vinden op extreme waarden in je tijdreeks waarvan je weet dat ze niet het gevolg zijn van trend-cyclus of seizoensinvloeden. Onze cursus Forecasting in R leert je dit soort technieken.
De standaardnormaal wordt gebruikt in machine learning
Veel machinelearning-algoritmen werken het best wanneer data op een standaardschaal staat. Ik denk aan logistische regressie, k-means-clustering en neurale netwerken.
Ik denk ook aan principalecomponentenanalyse, die vaak wordt gebruikt als voorbewerkingstechniek. Bij PCA willen we dat onze invoerkenmerken een gemiddeld van nul en een variantie van één hebben om te helpen voorkomen dat kenmerken met grote waarden domineren. Een veelgebruikte voorbewerkingsstap is het standaardiseren van de data door het gemiddelde af te trekken en te delen door de standaardafwijking. Dit zorgt ervoor dat elk kenmerk een gemiddeld van nul en een variantie van één heeft, maar we moeten duidelijk zijn dat dit geen normaliteit afdwingt. In sommige gevallen verwacht ik echter dat de getransformeerde data de normaliteit benadert als de oorspronkelijke verdeling al dicht bij normaal lag.
De standaardnormaal wordt gebruikt voor kansberekeningen
De cumulatieve verdelingsfunctie van de standaardnormale verdeling, waar we het eerder over hadden, is goed getabelleerd, waarmee ik bedoel: vooraf berekend en in tabellen georganiseerd die algemeen beschikbaar zijn. Dit maakt kansberekeningen makkelijker omdat je alleen de juiste waarde in de tabel hoeft op te zoeken.
Om bijvoorbeeld de kans te vinden dat een willekeurig gekozen lengte onder de 6 voet ligt, standaardiseren we de lengte met behulp van de normale verdeling van de populatie en zoeken we de Z-score op in een standaardnormale tabel. Onderaan dit artikel vind je een versie van de standaardnormale tabel voor het geval je die nodig hebt.
Transformaties om data in lijn te brengen met de standaardnormale verdeling
Transformaties kunnen helpen om data om te vormen naar een standaardnormale verdeling. Grofweg is dit een proces in twee stappen. Eerst vormen we onze data om naar normaal, en vervolgens voeren we Z-score-standaardisatie uit.
Let op: je past Z-score-standaardisatie doorgaans niet als eerste stap toe, omdat extreme waarden de standaardafwijking kunnen vertekenen; het gemiddelde en de standaardafwijking zijn namelijk gevoelig voor uitschieters. Ook vereisen sommige transformaties positieve data. Als je eerst Z-score-standaardisatie toepast, kunnen de rond het gemiddelde gecentreerde waarden negatief zijn, wat problemen kan geven bij transformaties die alleen met positieve waarden werken. Ik denk hierbij specifiek aan logaritmen. Het is dus het beste om de volgorde aan te houden: stap 1, dan stap 2.
Stap 1: Transformeer data naar normaal
Enkele transformatie-ideeën die je kunt gebruiken, zijn:
Logtransformatie voor scheve data
Wanneer data positief scheef is, kan een logtransformatie helpen normaliseren. Het toepassen van de logaritme op ruwe waarden comprimeert bijvoorbeeld grote waarden, vermindert de scheefheid en creëert een meer symmetrische verdeling.
Vierkantsworteltransformatie voor teldata
Voor teldata of matig scheve datasets kunnen we een vierkantsworteltransformatie proberen. Deze methode vermindert de variabiliteit terwijl de structuur symmetrischer wordt, waardoor de data dichter bij de klokvorm komt.
Box-Cox-transformatie voor flexibele aanpassingen
De Box-Cox-transformatie gaat een stap verder door de transformatie aan te passen aan de data. De parameter λ bepaalt de exacte formule die wordt toegepast, wat haar zeer veelzijdig maakt om data af te stemmen op de eigenschappen van de standaardnormale verdeling. Feature Engineering in R laat je de Box-Cox zien, naast veel andere belangrijke en nuttige methoden.
Stap 2: Voer Z-score-standaardisatie uit
Zodra een transformatie is toegepast, kan de data worden gestandaardiseerd om te passen bij de standaardnormale verdeling. Dit past de data aan zodat het gemiddelde nul is en de standaardafwijking één. De formule voor de Z-score is:
waar X de getransformeerde data is, μ het gemiddelde en σ de standaardafwijking.
Als je bekend bent met het onderscheid tussen Z-score voor een populatie en voor een steekproef, zoals we behandelen in onze track Statistical Inference in R, herken je de bovenstaande vergelijking als die voor een populatie-Z-score. Werk je met een steekproef in plaats van met de volledige populatie, dan schatten we het gemiddelde en de standaardafwijking in plaats daarvan:
Hier is X-streep het steekproefgemiddelde en s de steekproefstandaardafwijking.
Het resultaat zou hetzelfde zijn als je het gemiddelde en de standaardafwijking uit de nieuwe, genormaliseerde dataset zou gebruiken. Soms willen onderzoekers de data echter vergelijken ten opzichte van een grotere referentiepopulatie door in plaats daarvan een soort benchmarkgemiddelde en -standaardafwijking te gebruiken.
Stel je voor dat je naar een inkomensdataset kijkt, die rechts-scheef is, en dat je een logtransformatie uitvoert om deze te normaliseren. Stel je dan ook voor dat we de inkomens willen vergelijken met nationale benchmarks; in dat geval zouden we het nationale gemiddelde en de nationale standaardafwijking gebruiken in plaats van die uit onze steekproef om Z-scores te berekenen. Het doel is hier om zinvolle vergelijkingen mogelijk te maken tussen datasets of studies.
Kortom, als je een steekproef gebruikt, krijg je technisch gezien een gestandaardiseerde normale benadering in plaats van de exacte theoretische standaardnormale verdeling. Het is een onderscheid dat het waard is om te verduidelijken, ook al zal het verschil bij grote datasets klein zijn.
De standaardnormale verdeling visualiseren
Hier is één manier om een theoretische standaardnormale verdeling te maken in de R-programmeertaal. In deze code heb ik ook verticale lijnen toegevoegd voor standaardscores, oftewel Z-scores, wat een manier is om ons, voor een gegeven waarde, te vertellen hoeveel standaardafwijkingen boven of onder het populatiegemiddelde onze waarde ligt.
Je moet weten dat er enkele soortgelijke verdelingen zijn die op een standaardnormale lijken maar het niet zijn:
De standaardnormale verdeling en de standaardnormale tabel
Laat me terugkomen op iets wat ik eerder noemde: het idee van een standaardnormale tabel, ook wel Z-scoretabel of Z-tabel genoemd, die wordt gebruikt om cumulatieve kansen te vinden voor een Z-score, die het aantal standaardafwijkingen weergeeft dat een waarde van het gemiddelde afligt in een standaardnormale verdeling. Deze tabel wordt veel gebruikt in de statistiek voor hypothesetoetsing, betrouwbaarheidsintervallen en kansberekeningen. Het idee is dat je, in plaats van kansen handmatig te berekenen, in de tabel snel het aandeel waarden kunt opzoeken dat onder een gegeven Z-score valt.
De tabel vergt wat oefening om te lezen, en tabellen zien er soms verschillend uit. Hier zie je hem in een tweedimensionale structuur. Het doel is om het opzoeken van kansen voor Z-scores met decimalen te vergemakkelijken. In dit geval bevat de meest linkse kolom het gehele getal en de eerste decimaal van de Z-score. De bovenste rij geeft de tweede decimaal weer. Om de kans bij een specifieke Z-score te vinden, zoek je de rij op die overeenkomt met het eerste deel van de Z-score en vervolgens de kolom die overeenkomt met de tweede decimaal. De waarde op het snijpunt van deze rij en kolom is de cumulatieve kans, oftewel het aandeel dat onder die Z-score valt.
Het is het beste om een voorbeeld te geven: Stel dat je een Z-score van 0,32 berekent voor iemands toetsresultaat. Dit betekent dat de score 0,32 standaardafwijkingen boven het gemiddelde ligt. Laten we nu de Z-tabel gebruiken om de kans te vinden dat een willekeurig geselecteerde waarde kleiner is dan deze Z-score.
De cumulatieve kans voor Z = 0,32 is 0,6554, wat betekent dat 65,54% van de waarden in een standaardnormale verdeling minder dan 0,32 standaardafwijkingen boven het gemiddelde ligt. Moet je de kans bepalen dat een waarde groter is dan een gegeven Z-score, trek de tabelwaarde dan af van 1 voordat je de rij en kolom opzoekt.
Conclusie
Ik hoop dat je deze verkenning van de standaardnormale verdeling interessant vond. Blijf leren met ons hier bij DataCamp. Ik noemde onze cursus Introduction to Statistics in R en onze skill track Statistical Inference in R. Maar als je liever Python gebruikt, zijn onze cursussen Statistical Thinking in Python en Experimental Design in Python allebei goede opties.