
कोर्स
Introduction to Regression in R
4 घंटा
78.7K
मूल रूप से, R-स्क्वेयर्ड आश्रित चर में कुल विचरण का वह अनुपात बताता है जिसे स्वतंत्र चर (या चर) के कारण माना जा सकता है। आप इसे इस रूप में देख सकते हैं कि हमारा मॉडल डेटा की कहानी को कितनी अच्छी तरह पकड़ता है, और कितना हिस्सा अस्पष्टीकृत शोर के रूप में बचता है। इसकी सादगी और सीधी व्याख्या के कारण यह रैखिक प्रतिगमन निदान में व्यापक है, खासकर सरल और बहु-रैखिक प्रतिगमन में।
इस लेख में, हम R-स्क्वेयर्ड का अर्थ, गणना, व्याख्या, और इससे जुड़ी आम गलतफहमियों पर चर्चा करेंगे, ताकि हम इसे आत्मविश्वास और सावधानी—दोनों के साथ—इस्तेमाल कर सकें। साथ ही, हम R और Python में R-स्क्वेयर्ड निकालने के कुछ कोड उदाहरण भी देखेंगे।
R-स्क्वेयर्ड, जिसे R² से दर्शाया जाता है, प्रतिगमन मॉडलों में गुडनेस-ऑफ-फिट का एक सांख्यिकीय माप है। यह बताता है कि आश्रित चर में कितनी भिन्नता को मॉडल द्वारा समझाया जा सकता है।
R-स्क्वेयर्ड का मान 0 और 1 के बीच होता है:
यद्यपि अवधारणा सरल है, इसकी व्याख्या अर्थपूर्ण ढंग से करना सूक्ष्मता मांगता है—खासकर जब सिद्धांत से व्यवहार में जाते हैं।
R-स्क्वेयर्ड की गणना के कई गणितीय रूप से समतुल्य तरीके हैं, जो संदर्भ—सरल प्रतिगमन, बहु-प्रतिगमन, मैट्रिक्स बीजगणित, या बेयज़ियन मॉडलिंग—के अनुसार “फिट” का अलग-अलग दृष्टिकोण देते हैं। आइए सबसे अधिक इस्तेमाल होने वाले तरीकों को देखें।
यह सबसे मानक और व्यापक रूप से प्रयुक्त सूत्र है:
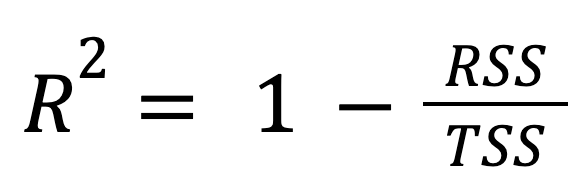
जहाँ:
दूसरे शब्दों में, R-स्क्वेयर्ड कुल भिन्नता का वह अंश दर्शाता है जिसे मॉडल समझाता है।
यह तरीका इस बात पर प्रकाश डालता है कि औसत के आधार पर भविष्यवाणी करने की तुलना में प्रतिगमन मॉडल कितना बेहतर प्रदर्शन करता है।
R-स्क्वेयर्ड को सीधे समझाई गई भिन्नता के रूप में भी लिखा जा सकता है:
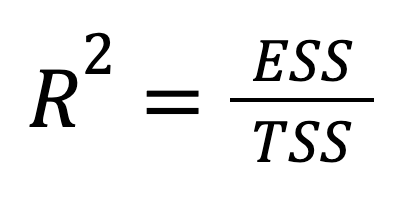
जहाँ:
यह संस्करण दर्शाता है कि परिणाम में कुल भिन्नता का कितना हिस्सा मॉडल की भविष्यवाणियों द्वारा पकड़ा गया है। यानी, यहाँ फोकस इस बात से हटकर कि हमने क्या नहीं समझाया (RSS) से इस पर आता है कि हमने क्या समझाया (ESS)—जो अधिक सकारात्मक ढांचा देता है।
वर्गों के योग के तीन घटकों पर गहराई से पढ़ने के लिए देखें Understanding Sum of Squares: A Guide to SST, SSR, and SSE.
ANOVA तालिका के संदर्भ में, R-स्क्वेयर्ड कुल भिन्नता के विघटन से स्वाभाविक रूप से निकलता है:

जहाँ:
यह रूप दिखाता है कि कुल भिन्नता का कितना हिस्सा मॉडल ने पकड़ा और कितना हिस्सा अनव्याख्यित रह गया।
यह दृष्टिकोण थोड़ा अनोखा है क्योंकि यह R-स्क्वेयर्ड को परिकल्पना परीक्षण से जोड़ता है। इसका कारण यह है कि ESS और RSS के अनुपात से ही F-सांख्यक निकाला जाता है, जिससे ANOVA शैली की रिपोर्टिंग में R-स्क्वेयर्ड महत्व-परीक्षण का अहम हिस्सा बनता है।
पिछले तीन तरीके प्रतिगमन विघटन से प्राप्त बीजगणितीय रूप से समतुल्य सूत्र थे। अब एक नया दृष्टिकोण देखें:
एक ही पूर्वानुमानक वाले सरल रैखिक प्रतिगमन में R-स्क्वेयर्ड का एक शॉर्टकट होता है:
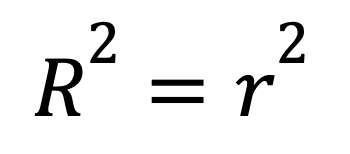
जहाँ
यह सूत्र दिखाता है कि दो चरों के बीच मजबूत रैखिक संबंध सीधे उच्च R-स्क्वेयर्ड में बदल जाता है।
सरल रैखिक प्रतिगमन के पीछे के सिद्धांत को समझने के लिए यह पढ़ें: Simple Linear Regression: Everything You Need to Know।
R-स्क्वेयर्ड को मॉडल त्रुटि के एक सामान्यीकृत माप के रूप में भी निकाला जा सकता है:
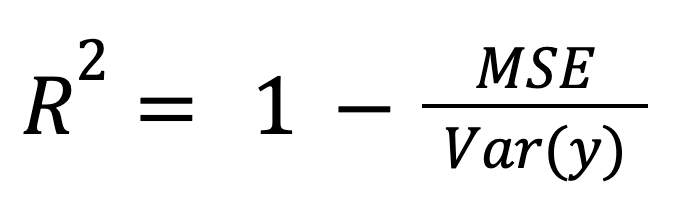
जहाँ:
यह ढांचा विशेष रूप से तब प्रासंगिक है जब अलग-अलग पैमानों या इकाइयों में मॉडलों की तुलना करनी हो, क्योंकि यह मॉडल त्रुटि को संपूर्ण डेटा फैलाव से सामान्यीकृत करता है।
यदि अवशेष पूर्वानुमानों से असंबद्ध हों, तो R-स्क्वेयर्ड को मॉडल द्वारा पकड़ी गई भिन्नता के अंश के रूप में भी समझा जा सकता है:
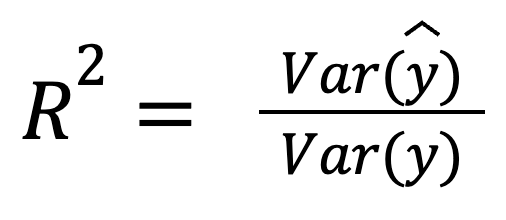
जहाँ:
यह संस्करण इस बात पर प्रकाश डालता है कि भविष्यवाणियाँ वास्तविक डेटा के फैलाव को कितनी अच्छी तरह दर्शाती हैं।
जैसा कि हमने पहले कहा, R-स्क्वेयर्ड निकालना आसान है, पर अर्थपूर्ण व्याख्या करना थोड़ा मुश्किल।
यह याद रखना महत्वपूर्ण है कि R-स्क्वेयर्ड सहसंबंध को मापता है, कारणता को नहीं। इस बात से कि हमारे पूर्वानुमानक परिणाम को समझाते हैं, यह सिद्ध नहीं होता कि वे उसे कारण हैं—क्योंकि सहसंबंध कारण नहीं होता। साथ ही, R-स्क्वेयर्ड यह भी नहीं बताता कि भविष्यवाणियाँ सटीक हैं या नहीं।
रैखिक प्रतिगमन से जुड़े उन्नत विषयों पर ये दो साधन उपयोगी हैं:
उचित परिस्थितियों में R-स्क्वेयर्ड बहुत सहायक है। यह इन स्थितियों में उपयुक्त है:
दूसरी ओर, इन परिस्थितियों में R-स्क्वेयर्ड भ्रामक हो सकता है:
अब Kaggle के Fish Market डेटासेट से R और Python में R-स्क्वेयर्ड को प्रदर्शित करते हैं। दोनों भाषाओं में, हम दो मॉडल बनाएंगे:
आइए R से शुरू करें।
# Load data
fish <- read.csv("Fish.csv")

# Model 1
model1 <- lm(Weight ~ Length1 + Length2 + Height + Width, data=fish)
summary(model1)$r.squared
आउटपुट:
[1] 0.8673# Model 2 with an irrelevant predictor
fish$random_noise <- rnorm(nrow(fish))
model2 <- lm(Weight ~ Length1 + Length2 + Height + Width + random_noise, data=fish)
summary(model2)$r.squaredआउटपुट:
[1] 0.8679जैसा कि हम देखते हैं, अप्रासंगिक पूर्वानुमानक (मॉडल 2) जोड़ने के बाद R-स्क्वेयर्ड थोड़ा बढ़ा। पर इसका मतलब यह नहीं कि मॉडल बेहतर हो गया—आखिरकार, हमने सिर्फ यादृच्छिक शोर जोड़ा है।
इस विषय पर और पढ़ने के लिए ये ट्यूटोरियल देखें:
और हमारे निर्दिष्ट कोर्स में नामांकन करना याद रखें:
अब, Python में कोशिश करें।
import pandas as pd
import statsmodels.api as sm
import numpy as np

# Load data
fish = pd.read_csv('Fish.csv')
X1 = fish[['Length1', 'Length2', 'Height', 'Width']]
y = fish['Weight']

# Model 1
X1 = sm.add_constant(X1)
model1 = sm.OLS(y, X1).fit()
print(model1.rsquared)
आउटपुट:
0.8673# Model 2 with an irrelevant predictor
fish['random_noise'] = np.random.randn(len(fish))
X2 = fish[['Length1', 'Length2', 'Height', 'Width', 'random_noise']]
X2 = sm.add_constant(X2)
model2 = sm.OLS(y, X2).fit()
print(model2.rsquared)आउटपुट:
0.8679फिर से, R-स्क्वेयर्ड में हल्की वृद्धि दिखती है, लेकिन यह केवल यादृच्छिक शोर को पकड़ रहा है।
सीखना जारी रखने के लिए, हमारे कोर्स में नामांकन करें:
अब हम संक्षेप में R-स्क्वेयर्ड की तुलना दो संबंधित मेट्रिक्स से करेंगे: समायोजित R-स्क्वेयर्ड और भविष्यवाणी R-स्क्वेयर्ड।
R-स्क्वेयर्ड के विपरीत, समायोजित R-स्क्वेयर्ड पूर्वानुमानकों की संख्या का लेखा रखता है। विशेष रूप से, यह अनावश्यक पूर्वानुमानकों को शामिल करने पर मॉडल को दंडित करता है:
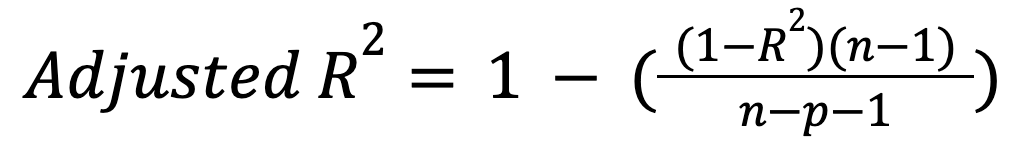
जहाँ:
यह मेट्रिक तभी बढ़ता है जब नया पूर्वानुमानक वास्तव में मॉडल को सार्थक रूप से सुधारता है, और उल्टे हाल में घट सकता है। इस महत्वपूर्ण विस्तार पर अधिक जानने के लिए हमारा ट्यूटोरियल पढ़ें: Adjusted R-Squared: A Clear Explanation with Examples।
जहाँ सामान्य R-स्क्वेयर्ड बताता है कि मॉडल प्रशिक्षण डेटा पर कितना अच्छा करता है, वहीं भविष्यवाणी R-स्क्वेयर्ड बताता है कि नया, अनदेखा डेटा पर यह कैसा करता है। इसलिए, यह मॉडल की सामान्यीकरण क्षमता का आकलन करता है।
भविष्यवाणी R-स्क्वेयर्ड को क्रॉस-वैलिडेशन या प्रशिक्षण डेटा के एक हिस्से को अलग रखकर निकाला जाता है। यदि मॉडल ओवरफिटेड है, तो यह सामान्य R-स्क्वेयर्ड से काफी कम हो सकता है। अतः यदि सामान्य R-स्क्वेयर्ड उच्च और भविष्यवाणी R-स्क्वेयर्ड निम्न है, तो यह अधिकांशतः ओवरफिटिंग का संकेत है।
आइए R-स्क्वेयर्ड से जुड़े कुछ लोकप्रिय मिथकों और वास्तविकताओं पर नज़र डालें:
संक्षेप में, हमने सीखा कि R-स्क्वेयर्ड क्या है, इसे कैसे निकाला जाता है (गणितीय रूप से और R व Python में), कब इसका उपयोग करना चाहिए और कब नहीं, और परिणामों की व्याख्या कैसे करें। साथ ही, हमने दो संबंधित मेट्रिक्स और R-स्क्वेयर्ड से जुड़ी कुछ प्रचलित गलतफहमियों को भी छुआ।
संक्षेप में, R-स्क्वेयर्ड प्रतिगमन मॉडल फिट का एक उपयोगी, सहज और सीधा माप है। यह मॉडल मूल्यांकन का एक अच्छा शुरुआती बिंदु है, पर इसे समझदारी से इस्तेमाल करना चाहिए, अन्य मेट्रिक्स के साथ मिलाकर देखना चाहिए, और इसे पूरी तस्वीर न मानें—खासकर बहु-प्रतिगमन और मॉडल चयन के सन्दर्भ में।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स