Curso
Introducción a R
4 h
3.1M
Cuando hablamos de anomalías, nos referimos a los puntos de datos que son atípicos o a eventos excepcionales. Identificarlos es sencillo en conjuntos de datos pequeños y puede hacerse con gráficos simples como los boxplots. Pero la cosa se complica al trabajar con conjuntos grandes, especialmente en series temporales. Una serie temporal es un conjunto de datos capturados a intervalos fijos durante un periodo; al analizarlos muestran tendencia o estacionalidad. Detectar anomalías en estos casos es bastante más delicado.
Aquí entra en juego el paquete anomalize para la detección de anomalías en análisis de series temporales: es un algoritmo ordenado (tidy), basado en el tiempo y escalable de una a muchas series.
Existen paquetes y métodos que han contribuido a su desarrollo; en otras palabras, combina recursos disponibles con un enfoque escalable.
El trabajo open source que lo ha ayudado incluye:
Todos estos paquetes y funciones se integran en un flujo de trabajo escalable.
El flujo de trabajo de anomalize se divide en tres partes:
time_decompose().anomalize().time_recompose().El primer paso es la descomposición con time_decompose(). El valor medido o numérico sobre el que se quiere detectar anomalías para un grupo concreto se descompone en cuatro columnas: observed, season, trend y remainder. El método por defecto de descomposición es stl, una descomposición estacional que utiliza un suavizado Loess.
La regresión Loess es el método más común para suavizar series temporales volátiles: ajusta múltiples regresiones en vecindarios locales; es decir, divide los datos y aplica regresión a cada parte. Es útil en series temporales porque conocemos el rango temporal, que en este caso es la variable X. Este método funciona bien cuando la tendencia domina la estacionalidad.
Aquí, la tendencia es el crecimiento a largo plazo que ocurre a lo largo de muchas observaciones, y la estacionalidad es el patrón cíclico que se repite a diario, por minuto, por hora o semanalmente.
Existe una segunda técnica para la descomposición estacional basada en la mediana: el método de Twitter, también usado en el paquete AnomalyDetection. Es idéntico a STL a la hora de eliminar el componente estacional. La diferencia al eliminar la tendencia es que utiliza medianas por tramos de los datos (una o varias medianas segmentadas en intervalos concretos) en lugar de ajustar un suavizador. Este método funciona bien cuando la estacionalidad domina la tendencia.
Veamos la salida de la función time_decompose(). Como hemos dicho, produce 4 columnas:
La función time_decompose() incluye el argumento merge; si lo pones a TRUE puedes conservar los datos originales junto con las columnas generadas.
# Using data package provided in the anomalize package and taking single time series of package purrr

purrr_package = tidyverse_cran_downloads%>%
  filter(package == "purrr")%>%
  ungroup()

purrr_anomaly  = purrr_package %>%
  time_decompose(count)

purrr_anomaly%>% glimpse()
 ## Observations: 425
## Variables: 5
## $ date      <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, 201...
## $ observed  <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008, 2...
## $ season    <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9377...
## $ trend     <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901, 15...
## $ remainder <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -797.8...Tras completar el análisis de la serie temporal, y una vez que el residuo tiene las características adecuadas, se realiza la detección de anomalías, que crea tres columnas nuevas.
Las anomalías son puntos de alto apalancamiento que distorsionan la distribución. anomalize implementa dos métodos resistentes a estos puntos de alto apalancamiento:
Es similar al método usado en la función tsoutliers() del paquete forecast. En IQR se toma la distribución y los cuartiles 25% y 75% para establecer la distribución del residuo. Los límites se fijan por defecto a un factor de 3 veces por encima y por debajo del rango intercuartílico; cualquier residuo fuera de esos límites se considera anomalía.
En GESD las anomalías se evalúan de forma progresiva eliminando los peores casos y recalculando las estadísticas de prueba y los valores críticos; dicho de forma sencilla, el rango se recalcula tras identificar anomalías de manera iterativa.
Ambos métodos, IQR y GESD, tienen pros y contras. IQR es más rápido, ya que no usa bucles, pero es menos preciso que GESD porque las anomalías sesgan la mediana, efecto que GESD mitiga.
purrr_anomaly = purrr_anomaly%>%
  anomalize(remainder)

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 8
## $ date         <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, ...
## $ observed     <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008...
## $ season       <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9...
## $ trend        <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901,...
## $ remainder    <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -79...
## $ remainder_l1 <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -4330...
## $ remainder_l2 <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459,...
## $ anomaly <chr> "No", "No", "No", "No", "No", "No", "No", "No", "...El último paso del flujo de trabajo es crear bandas inferior y superior alrededor de los valores observados con time_recompose. Recomponen season, trend, remainder_l1 y remainder_l2 en nuevos límites:
purrr_anomaly = purrr_anomaly%>%
  time_recompose()

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 10
## $ date          <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04,...
## $ observed      <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 200...
## $ season        <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939....
## $ trend         <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901...
## $ remainder     <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -7...
## $ remainder_l1  <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -433...
## $ remainder_l2  <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459...
## $ anomaly       <chr> "No", "No", "No", "No", "No", "No", "No", "No", ...
## $ recomposed_l1 <dbl> -4992.689, -2126.845, -1717.634, -1738.578, -183...
## $ recomposed_l2 <dbl> 3738.281, 6604.125, 7013.336, 6992.392, 6894.298...
Representación de anomalías
purrr_anomaly%>%
  plot_anomaly_decomposition()+
  ggtitle("Plotting Anomalies")
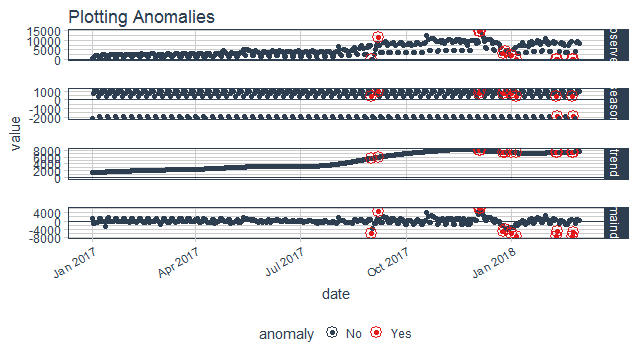
Modelar un detector de anomalías sin ajustar los parámetros, que dependen totalmente de los datos, es dejar el trabajo a medias.
Vamos a ello: los parámetros de cada nivel del flujo de trabajo son distintos, porque cada nivel realiza su propia tarea.
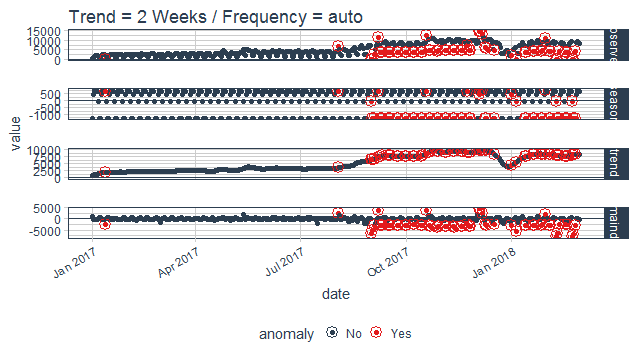
Como hemos comentado, la tendencia y la estacionalidad son fundamentales para descomponer una serie temporal, así que el ajuste debe hacerse también en la frecuencia y la tendencia de la función time_decompose. Por defecto, los valores se asignan automáticamente: 7 días de frecuencia en ambos métodos (STL y Twitter) y, para la tendencia, 91 días en STL y 85 días en Twitter.
Puedes ajustar uno o ambos argumentos según te convenga, pero hazlo con cuidado: cambiar sin observar puede llevar a sobreajustar o infraajustar la descomposición.
purrr_package %>%
  time_decompose(count, frequency = "auto", trend = "2 weeks")%>%
  anomalize(remainder)%>%
  plot_anomaly_decomposition()+
  ggtitle("Trend = 2 Weeks / Frequency = auto ")
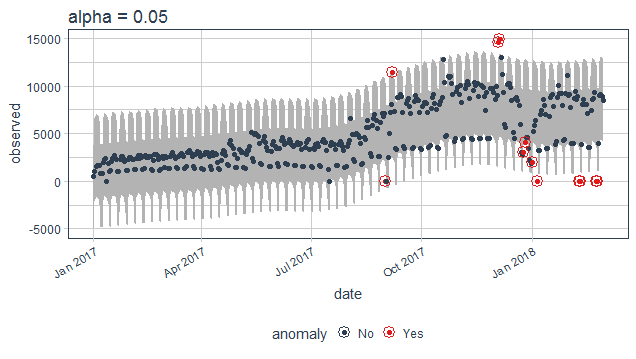
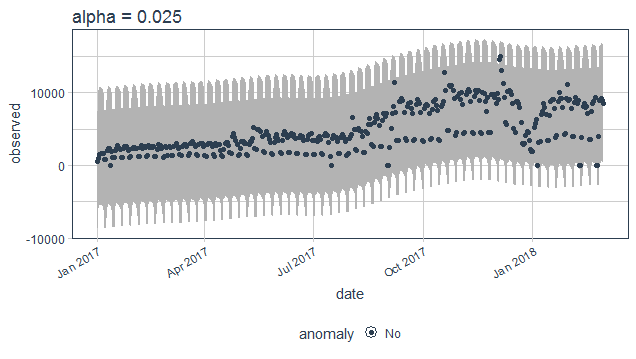
Como hemos visto, aquí las anomalías se determinan a partir de los valores del residuo, calculando límites para clasificar los atípicos. Dos parámetros controlan la función anomalize(): alpha y max_anoms. En pocas palabras, alpha controla la anchura de la banda; por defecto es 0.05. Si reduces su valor, aumentas el tamaño de la banda y será más difícil que un punto sea una anomalía.
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.05")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.025)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.025")
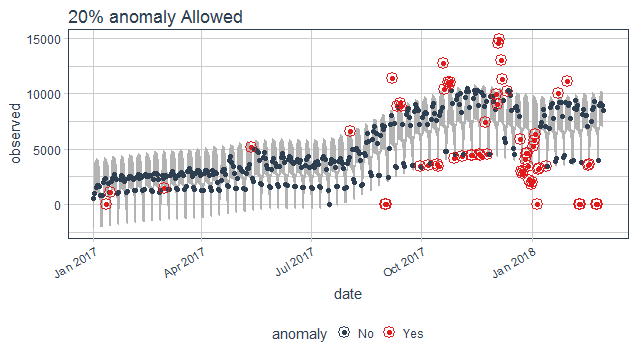
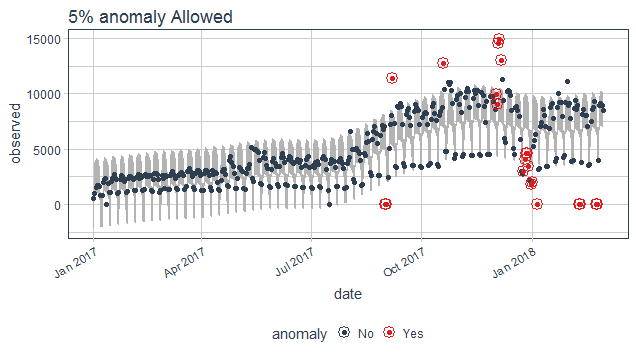
El parámetro max_anoms controla el porcentaje de datos que pueden ser anomalías. Es útil cuando alpha es difícil de afinar y quieres centrarte en las anomalías más agresivas.
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.2)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("20% anomaly Allowed")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("5% anomaly Allowed")
Si quieres aprender más sobre R, haz el curso Introduction to Time Series Analysis de DataCamp.
Echa un vistazo a nuestro Time Series Analysis using R: Tutorial.
Cursos de R
Curso
Curso
Curso
blog
Elena Kosourova
14 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Łukasz Deryło
10 min
Tutorial
Zoumana Keita
15 min
Tutorial
Zoumana Keita
12 min



