Curso
Introdução ao R
4 h
3.1M
Quando falamos de anomalias, pensamos nos pontos de dados que são outliers ou eventos excepcionais. Identificar esses eventos é fácil em conjuntos pequenos e pode ser feito com gráficos simples, como boxplots. Mas as coisas ficam bem mais complicadas quando passamos para conjuntos grandes, especialmente no caso de séries temporais. Séries temporais são dados capturados em intervalos fixos ao longo de um período e, quando analisados, mostram tendência ou sazonalidade. Identificar anomalias nesses cenários é um desafio.
É aí que entra o pacote anomalize para detecção de anomalias em séries temporais: um algoritmo "tidy" de detecção de anomalias baseado em tempo e escalável de uma até muitas séries temporais.
Existem pacotes e métodos disponíveis que ajudam na sua construção — dá para dizer que é uma combinação de recursos existentes com uma abordagem escalável.
Os trabalhos open source que ajudaram foram:
Todos esses pacotes e funções são usados para integrar um fluxo de trabalho escalável.
Falando do fluxo de trabalho do anomalize, ele é dividido em três partes:
time_decompose().anomalize().time_recompose().O primeiro passo é a decomposição da série temporal usando time_decompose(). O valor medido ou numérico sobre o qual a detecção precisa ser feita para um determinado grupo é decomposto em quatro colunas: observed, season, trend e remainder. O método padrão de decomposição é o stl, uma decomposição sazonal que utiliza um suavizador Loess.
A regressão Loess é o método mais comum para suavizar séries temporais voláteis. Ela ajusta várias regressões em vizinhanças locais — ou seja, os dados são segmentados e a regressão é aplicada a cada parte. Isso é útil em séries temporais porque conhecemos o limite de tempo, que é a variável X nesse caso. Esse método funciona bem quando a tendência domina a sazonalidade da série.
Aqui, tendência é o crescimento de longo prazo ao longo de muitas observações, e sazonalidade é o padrão cíclico que ocorre em um ciclo diário, por minuto ou por hora, ou semanal.
Há uma segunda técnica para decomposição sazonal em séries temporais baseada na mediana: o método do Twitter, também usado no pacote AnomalyDetection. Ele é idêntico ao STL na remoção do componente sazonal. A diferença está na remoção da tendência: usa-se a mediana por partes dos dados (uma ou várias medianas divididas em intervalos especificados) em vez de ajustar um suavizador. Esse método funciona bem quando a sazonalidade domina a tendência na série temporal.
Falando da saída da função time_decompose(), como dito acima, ela produz 4 colunas:
A função time_decompose() contém o argumento merge; definindo-o como TRUE, mantemos os dados originais junto com as colunas geradas.
# Using data package provided in the anomalize package and taking single time series of package purrr

purrr_package = tidyverse_cran_downloads%>%
  filter(package == "purrr")%>%
  ungroup()

purrr_anomaly  = purrr_package %>%
  time_decompose(count)

purrr_anomaly%>% glimpse()
 ## Observations: 425
## Variables: 5
## $ date      <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, 201...
## $ observed  <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008, 2...
## $ season    <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9377...
## $ trend     <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901, 15...
## $ remainder <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -797.8...Depois que a série temporal é analisada e o remainder tem as características desejadas para realizar a detecção, o processo cria mais três colunas.
Anomalias são pontos de alta alavancagem que distorcem a distribuição. O anomalize implementa dois métodos resistentes a esses pontos:
Método semelhante ao usado na função tsoutliers() do pacote forecast. No IQR, toma-se a distribuição e os quartis de 25% e 75% para estabelecer a distribuição do remainder. Os limites são definidos, por padrão, como um fator de 3 vezes acima e abaixo do intervalo interquartil; qualquer remainder além desses limites é considerado anomalia.
No GESD, as anomalias são avaliadas progressivamente, removendo-se os piores casos e recalculando as estatísticas de teste e os valores críticos. Em outras palavras, o intervalo é recalculado de forma iterativa após identificar as anomalias.
Ambos IQR e GESD têm prós e contras. O IQR é mais rápido, pois não envolve loops, mas não é tão preciso quanto o GESD, já que as anomalias enviesam a mediana — efeito mitigado no GESD.
purrr_anomaly = purrr_anomaly%>%
  anomalize(remainder)

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 8
## $ date         <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, ...
## $ observed     <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008...
## $ season       <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9...
## $ trend        <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901,...
## $ remainder    <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -79...
## $ remainder_l1 <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -4330...
## $ remainder_l2 <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459,...
## $ anomaly <chr> "No", "No", "No", "No", "No", "No", "No", "No", "...O último passo do fluxo é criar limites inferior e superior ao redor dos valores observados com time_recompose. Ele recompõe season, trend, remainder_l1 e remainder_l2 em novos limites, que são:
purrr_anomaly = purrr_anomaly%>%
  time_recompose()

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 10
## $ date          <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04,...
## $ observed      <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 200...
## $ season        <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939....
## $ trend         <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901...
## $ remainder     <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -7...
## $ remainder_l1  <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -433...
## $ remainder_l2  <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459...
## $ anomaly       <chr> "No", "No", "No", "No", "No", "No", "No", "No", ...
## $ recomposed_l1 <dbl> -4992.689, -2126.845, -1717.634, -1738.578, -183...
## $ recomposed_l2 <dbl> 3738.281, 6604.125, 7013.336, 6992.392, 6894.298...
Plotando anomalias
purrr_anomaly%>%
  plot_anomaly_decomposition()+
  ggtitle("Plotting Anomalies")
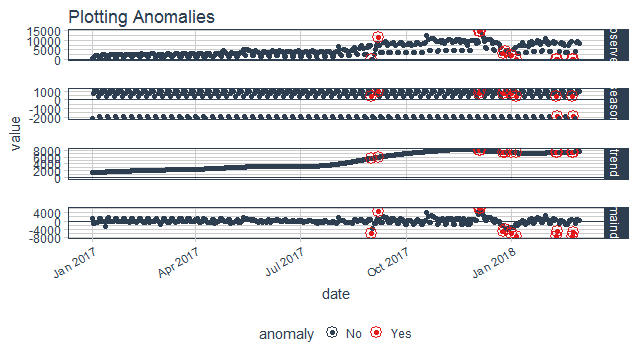
Modelar um detector de anomalias fica incompleto sem ajustar os parâmetros — algo totalmente dependente dos dados.
Vamos ao ajuste: os parâmetros de cada etapa do fluxo são diferentes, já que cada uma executa sua própria função.
Como vimos, tendência e sazonalidade são fundamentais para decompor uma série temporal, então o ajuste também deve ser feito na frequência e na tendência da função time_decompose. Por padrão, os valores são atribuídos automaticamente: 7 dias para a frequência em ambos os métodos (STL, Twitter) e, para tendência, 91 dias no STL e 85 dias no Twitter.
Você pode ajustar um ou ambos os argumentos conforme necessário, mas observe com cuidado: mudar sem avaliar pode levar a overfitting ou underfitting no processo de decomposição.
purrr_package %>%
  time_decompose(count, frequency = "auto", trend = "2 weeks")%>%
  anomalize(remainder)%>%
  plot_anomaly_decomposition()+
  ggtitle("Trend = 2 Weeks / Frequency = auto ")
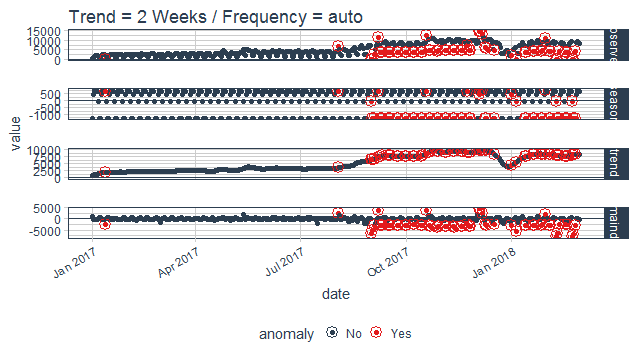
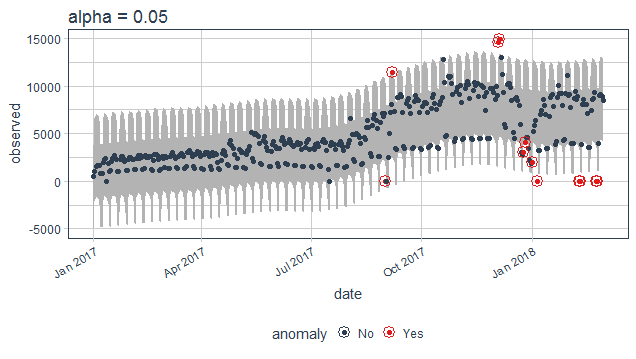
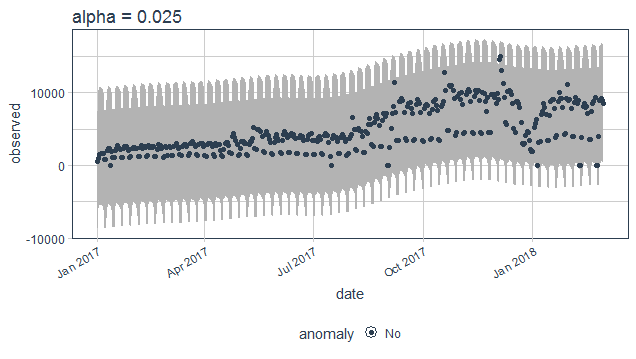
Como dito acima, aqui a anomalia é definida a partir dos valores do remainder, calculando limites para categorizar os outliers. Os parâmetros alpha e max_anoms controlam a função anomalize(). Em resumo, o alpha controla a faixa do limite: por padrão é 0.05; diminuir seu valor aumenta a largura da faixa, dificultando que um ponto seja considerado anomalia.
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.05")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.025)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.025")
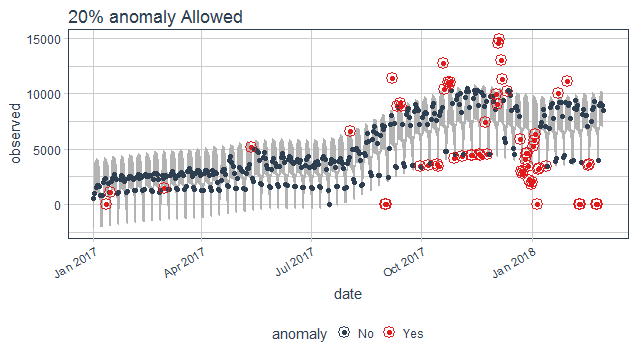
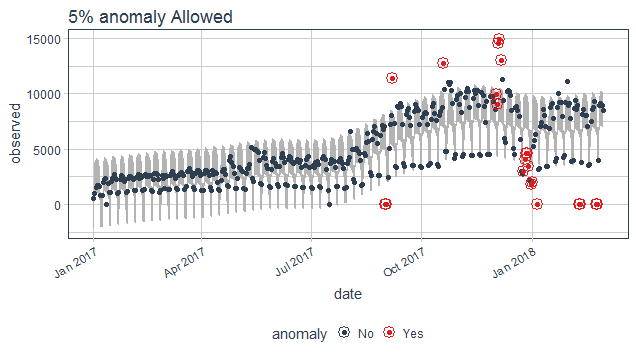
O parâmetro max_anom controla a porcentagem de dados que pode ser considerada anomalia. Ele é útil quando o alpha é difícil de calibrar e você quer focar nas anomalias mais agressivas.
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.2)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("20% anomaly Allowed")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("5% anomaly Allowed")
Se você quiser aprender mais sobre R, faça o curso Introduction to Time Series Analysis da DataCamp.
Confira nosso Time Series Analysis using R: Tutorial.
Cursos de R
Curso
Curso
Curso
Tutorial
Somil Asthana
11 min
Tutorial
Amberle McKee
15 min
Tutorial
Kevin Babitz
15 min
Tutorial
Zoumana Keita
15 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Abid Ali Awan
10 min