Kurs
Einführung in R
4 Std.
3.1M
Wenn wir von Anomalien sprechen, meinen wir Ausreißer oder außergewöhnliche Ereignisse in den Daten. In kleinen Datensätzen lassen sie sich leicht mit einfachen Visualisierungen wie Boxplots identifizieren. In großen Datensätzen, vor allem bei Zeitreihen, wird es jedoch schnell komplex. Eine Zeitreihe erfasst Daten in festen Intervallen über einen Zeitraum und zeigt bei der Analyse oft Trend- und Saisoneffekte. Anomalien in solchen Fällen zu erkennen, ist knifflig.
Hier setzt das Paket anomalize zur Anomalieerkennung in Zeitreihen an: ein tidy, zeitbasiertes Verfahren, das von einer bis zu vielen Zeitreihen skalierbar ist.
Es nutzt bestehende Pakete und Methoden und kombiniert diese zu einem skalierbaren Ansatz.
Diese Open-Source-Arbeiten haben dazu beigetragen:
Alle diese Pakete und Funktionen fließen in einen skalierbaren Workflow ein.
Der Workflow von anomalize gliedert sich in drei Schritte:
time_decompose().anomalize().time_recompose().Der erste Schritt ist die Zerlegung der Zeitreihe mit time_decompose(). Der Messwert, auf dem die Erkennung für eine bestimmte Gruppe erfolgen soll, wird in vier Spalten zerlegt: observed, season, trend und remainder. Standardmäßig wird stl verwendet, eine saisonale Zerlegung mit Loess-Glättung.
Loess-Regression ist die gängigste Methode, um volatile Zeitreihen zu glätten. Sie passt in lokalen Nachbarschaften mehrere Regressionen an, sprich, die Daten werden in Abschnitte geteilt und jeweils regressiert. Das ist in Zeitreihen hilfreich, da die Zeit als X-Variable begrenzt ist. Diese Methode funktioniert gut, wenn der Trend die Saisonalität überwiegt.
Trend steht hier für langfristige Entwicklung über viele Beobachtungen, Saisonalität für wiederkehrende Muster, z. B. minütlich, stündlich oder wöchentlich.
Als zweite Technik zur saisonalen Zerlegung gibt es die auf Mediane basierende Twitter-Methode, die auch das Paket AnomalyDetection nutzt. Sie entfernt die saisonale Komponente wie STL. Der Unterschied liegt im Trend: Statt einer Glättung wird ein stückweiser Median der Daten (ein oder mehrere Mediansplits in festen Intervallen) verwendet. Diese Methode ist vorteilhaft, wenn die Saisonalität den Trend dominiert.
Zum Output von time_decompose(): Wie beschrieben entstehen vier Spalten:
Die Funktion time_decompose() hat ein Argument merge. Mit TRUE bleibt der Originaldatensatz zusammen mit den erzeugten Spalten erhalten.
# Using data package provided in the anomalize package and taking single time series of package purrr

purrr_package = tidyverse_cran_downloads%>%
  filter(package == "purrr")%>%
  ungroup()

purrr_anomaly  = purrr_package %>%
  time_decompose(count)

purrr_anomaly%>% glimpse()
 ## Observations: 425
## Variables: 5
## $ date      <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, 201...
## $ observed  <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008, 2...
## $ season    <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9377...
## $ trend     <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901, 15...
## $ remainder <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -797.8...Nach der Zerlegung und sobald der remainder die gewünschten Eigenschaften hat, wird die Anomalieerkennung durchgeführt. Dabei entstehen drei neue Spalten.
Anomalien sind Hebelpunkte mit starkem Einfluss, die die Verteilung verzerren. anomalize implementiert zwei robuste Methoden gegenüber solchen Punkten:
Dieses Verfahren ähnelt der Methode in tsoutliers() aus dem forecast-Paket. Beim IQR wird die Verteilung anhand des 25%- und 75%-Quartils beschrieben. Standardmäßig werden die Grenzen mit dem Faktor 3 ober- und unterhalb des Interquartilsabstands gesetzt. Jeder remainder außerhalb dieser Grenzen gilt als Anomalie.
Bei GESD werden Anomalien schrittweise bewertet: Die stärksten Ausreißer werden entfernt und Teststatistik sowie kritische Werte neu berechnet. Vereinfacht: Nach jeder Identifikation wird der Bereich iterativ neu bestimmt.
Beide, IQR und GESD, haben Vor- und Nachteile. IQR ist schneller, da keine Schleifen nötig sind, aber weniger präzise als GESD, weil Ausreißer die Medianlage verzerren, was GESD gezielt adressiert.
purrr_anomaly = purrr_anomaly%>%
  anomalize(remainder)

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 8
## $ date         <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, ...
## $ observed     <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008...
## $ season       <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9...
## $ trend        <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901,...
## $ remainder    <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -79...
## $ remainder_l1 <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -4330...
## $ remainder_l2 <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459,...
## $ anomaly <chr> "No", "No", "No", "No", "No", "No", "No", "No", "...Im letzten Schritt werden mit time_recompose untere und obere Grenzen um die beobachteten Werte gelegt. Saison, Trend, remainder_l1 und remainder_l2 werden zu neuen Schranken rekombiniert:
purrr_anomaly = purrr_anomaly%>%
  time_recompose()

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 10
## $ date          <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04,...
## $ observed      <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 200...
## $ season        <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939....
## $ trend         <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901...
## $ remainder     <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -7...
## $ remainder_l1  <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -433...
## $ remainder_l2  <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459...
## $ anomaly       <chr> "No", "No", "No", "No", "No", "No", "No", "No", ...
## $ recomposed_l1 <dbl> -4992.689, -2126.845, -1717.634, -1738.578, -183...
## $ recomposed_l2 <dbl> 3738.281, 6604.125, 7013.336, 6992.392, 6894.298...
Anomalien visualisieren
purrr_anomaly%>%
  plot_anomaly_decomposition()+
  ggtitle("Plotting Anomalies")
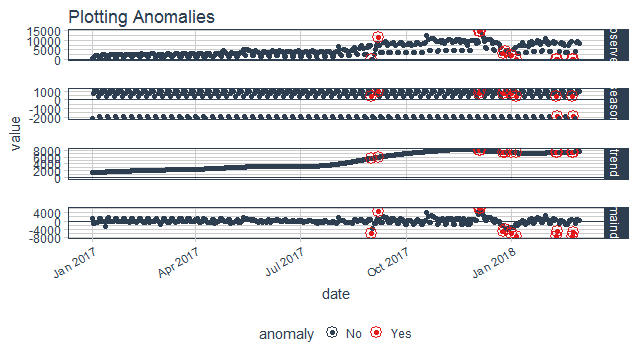
Ein Anomaliedetektor ist ohne Parametertuning unvollständig — und die passenden Werte hängen immer von den Daten ab.
Schauen wir uns die Parameter der drei Workflow-Ebenen an. Jede Ebene erfüllt eine eigene Aufgabe und hat entsprechend eigene Stellschrauben.
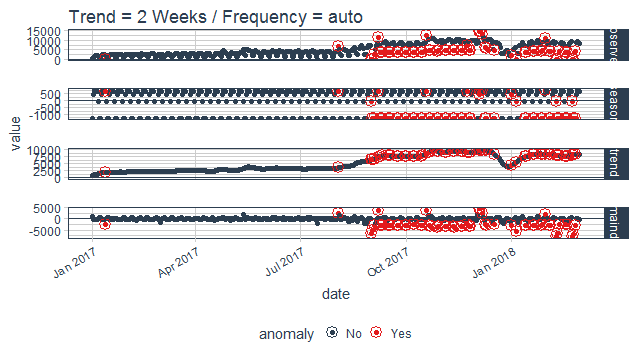
Trend und Saisonalität sind die Grundlagen der Zeitreihenzerlegung. Entsprechend solltest du in time_decompose Frequenz und Trend anpassen. Standardmäßig werden Werte automatisch gesetzt: 7 Tage Frequenz (für STL und Twitter), für den Trend 91 Tage bei STL und 85 Tage bei Twitter.
Du kannst beide oder einzelne Argumente anpassen. Beobachte die Effekte genau, sonst riskierst du Overfitting oder Underfitting der Zerlegung.
purrr_package %>%
  time_decompose(count, frequency = "auto", trend = "2 weeks")%>%
  anomalize(remainder)%>%
  plot_anomaly_decomposition()+
  ggtitle("Trend = 2 Weeks / Frequency = auto ")
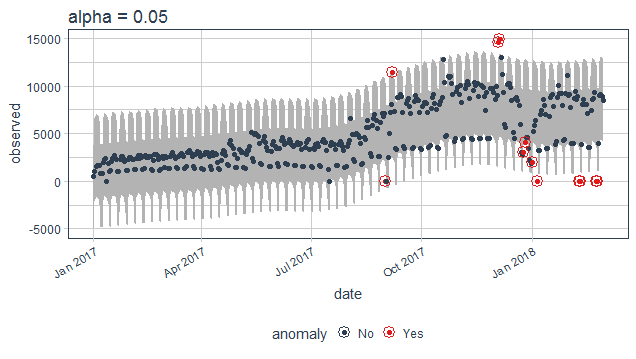
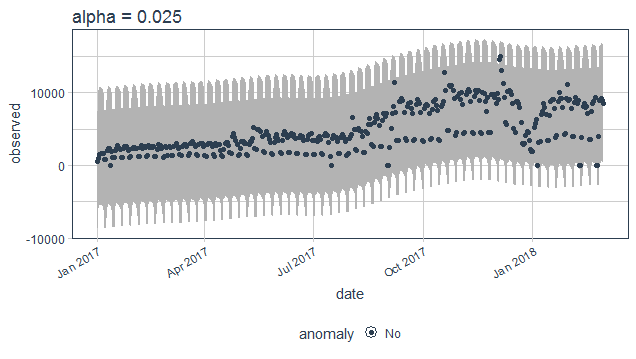
Wie oben beschrieben werden Anomalien anhand der remainder-Werte und daraus berechneter Grenzen bestimmt. Die Parameter alpha und max_anoms steuern die Funktion anomalize(). Vereinfacht gesagt bestimmt alpha die Breite des Intervalls. Standard ist 0,05. Ein kleineres alpha verbreitert das Band und macht es für Punkte schwieriger, als Anomalie zu gelten.
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.05")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.025)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.025")
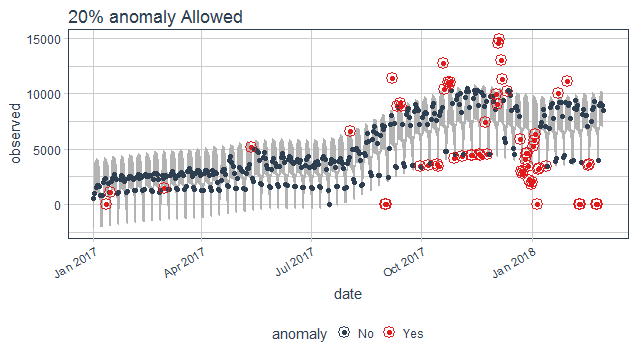
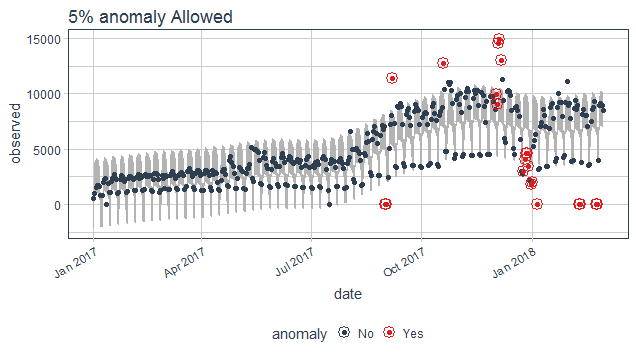
Der Parameter max_anoms steuert, welcher prozentuale Anteil der Daten als Anomalie markiert werden darf. Das ist hilfreich, wenn sich alpha schwer abstimmen lässt und du die auffälligsten Anomalien priorisieren willst.
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.2)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("20% anomaly Allowed")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("5% anomaly Allowed")
Wenn du mehr über R lernen möchtest, schau dir den DataCamp-Kurs Introduction to Time Series Analysis an.
Sieh dir auch unser Time Series Analysis using R: Tutorial an.
R-Kurse
Kurs
Kurs
Kurs
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Adel Nehme
5 Min.




