Cours
Introduction à R
4 h
3.1M
Quand on parle d'anomalies, on vise des points de données atypiques ou des événements exceptionnels. Les repérer est simple sur de petits jeux de données, par exemple avec des graphiques de base comme les boîtes à moustaches. En revanche, l'exercice se complique sur de grands volumes, en particulier pour les séries temporelles. Une série temporelle regroupe des mesures recueillies à intervalles réguliers sur une période ; son analyse révèle tendances et saisonnalités. Détecter les anomalies dans ce contexte est délicat.
Le package anomalize répond à ce besoin : un algorithme tidy de détection d'anomalies, fondé sur le temps et dimensionnable d'une à de multiples séries temporelles.
Il s'appuie sur différents packages et méthodes existants : c'est en quelque sorte une combinaison de ressources disponibles, organisée pour l'échelle.
Les travaux open source qui ont contribué sont :
Ces packages et fonctions s'intègrent dans un flux de travail conçu pour passer à l'échelle.
Côté flux de travail, anomalize se décompose en trois étapes :
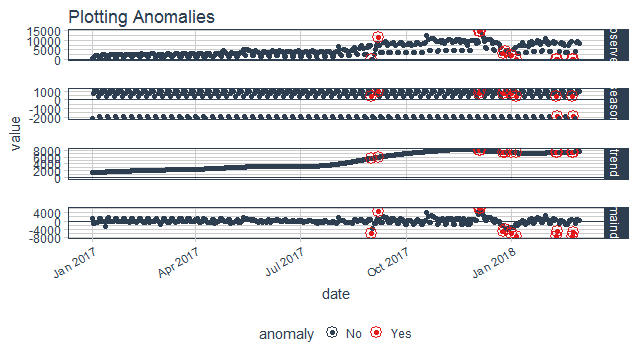
time_decompose().anomalize().time_recompose().Première étape : la décomposition via time_decompose(). La valeur mesurée, c'est-à-dire le numérique sur lequel effectuer la détection pour un groupe donné, est décomposée en quatre colonnes : observed, season, trend et remainder. La méthode par défaut est stl, une décomposition saisonnière s'appuyant sur un lissage Loess.
La régression Loess est couramment utilisée pour lisser une série temporelle volatile : elle ajuste des régressions locales par voisinage, autrement dit on segmente les données et on ajuste une régression sur chaque portion ; c'est utile en série temporelle car l'axe du temps (variable X) est borné. Cette approche fonctionne bien lorsque la tendance domine la saisonnalité.
Ici, la tendance correspond à l'évolution de long terme sur de nombreuses observations, tandis que la saisonnalité désigne les motifs cycliques quotidiens, hebdomadaires, horaires, etc.
Deuxième technique possible pour la décomposition saisonnière : la méthode Twitter (utilisée aussi dans le package AnomalyDetection), de nature médiane. Elle retire la composante saisonnière comme STL. La différence tient au traitement de la tendance : elle utilise des médianes par morceaux (une ou plusieurs médianes sur des intervalles fixés) plutôt qu'un lissage. Cette méthode est efficace quand la saisonnalité domine la tendance.
Sortie de time_decompose() : comme indiqué, 4 colonnes :
La fonction time_decompose() propose l'argument merge : en le passant à TRUE, on conserve les données d'origine en plus des colonnes produites.
# Using data package provided in the anomalize package and taking single time series of package purrr

purrr_package = tidyverse_cran_downloads%>%
  filter(package == "purrr")%>%
  ungroup()

purrr_anomaly  = purrr_package %>%
  time_decompose(count)

purrr_anomaly%>% glimpse()
 ## Observations: 425
## Variables: 5
## $ date      <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, 201...
## $ observed  <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008, 2...
## $ season    <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9377...
## $ trend     <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901, 15...
## $ remainder <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -797.8...Une fois la décomposition réalisée et le remainder prêt pour la détection, anomalize() crée trois nouvelles colonnes :
Les anomalies sont des points à fort levier qui déforment la distribution. anomalize implémente deux méthodes robustes à ces points influents :
Méthode proche de celle utilisée par tsoutliers() dans forecast. On prend la distribution et l'on utilise les 1er et 3e quartiles (25 % et 75 %) pour caractériser le remainder. Les limites sont par défaut fixées à 3 fois l'écart interquartile au-dessus et en dessous ; tout remainder au-delà est considéré comme anomalie.
Avec GESD, on évalue les anomalies de façon itérative : on retire progressivement les pires cas puis on recalcule les statistiques de test et les valeurs critiques ; en bref, on recalcule l'intervalle à chaque itération après identification d'anomalies.
IQR et GESD ont chacun leurs atouts et limites. IQR est plus rapide (pas de boucles), mais moins précis que GESD, car les anomalies biaisent la médiane ; GESD en corrige l'effet.
purrr_anomaly = purrr_anomaly%>%
  anomalize(remainder)

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 8
## $ date         <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, ...
## $ observed     <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008...
## $ season       <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9...
## $ trend        <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901,...
## $ remainder    <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -79...
## $ remainder_l1 <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -4330...
## $ remainder_l2 <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459,...
## $ anomaly <chr> "No", "No", "No", "No", "No", "No", "No", "No", "...Derniere étape : créer des bornes inférieure et supérieure autour des valeurs observées avec time_recompose. On recompose season, trend, remainder_l1 et remainder_l2 en nouvelles limites :
purrr_anomaly = purrr_anomaly%>%
  time_recompose()

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 10
## $ date          <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04,...
## $ observed      <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 200...
## $ season        <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939....
## $ trend         <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901...
## $ remainder     <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -7...
## $ remainder_l1  <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -433...
## $ remainder_l2  <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459...
## $ anomaly       <chr> "No", "No", "No", "No", "No", "No", "No", "No", ...
## $ recomposed_l1 <dbl> -4992.689, -2126.845, -1717.634, -1738.578, -183...
## $ recomposed_l2 <dbl> 3738.281, 6604.125, 7013.336, 6992.392, 6894.298...
Visualiser les anomalies
purrr_anomaly%>%
  plot_anomaly_decomposition()+
  ggtitle("Plotting Anomalies")
Modéliser un détecteur d'anomalies suppose d'ajuster des paramètres dépendants des données.
Chaque étape du flux dispose de ses propres paramètres : à ajuster en fonction de la tâche réalisée.
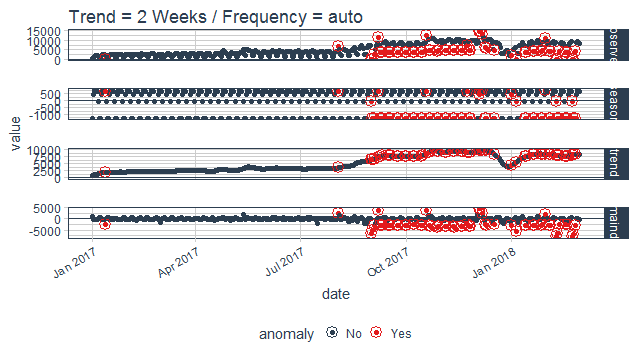
La tendance et la saisonnalité étant au cœur de la décomposition, on ajuste la fréquence et la tendance dans time_decompose. Par défaut, les valeurs sont détectées automatiquement : 7 jours pour la fréquence (STL et Twitter), et pour la tendance 91 jours (STL) et 85 jours (Twitter).
Vous pouvez modifier l'un ou l'autre argument selon vos besoins ; observez toutefois l'impact : un réglage inadéquat peut sur- ou sous-ajuster la décomposition.
purrr_package %>%
  time_decompose(count, frequency = "auto", trend = "2 weeks")%>%
  anomalize(remainder)%>%
  plot_anomaly_decomposition()+
  ggtitle("Trend = 2 Weeks / Frequency = auto ")
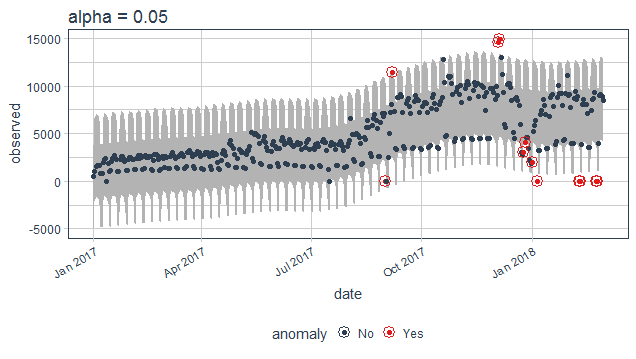
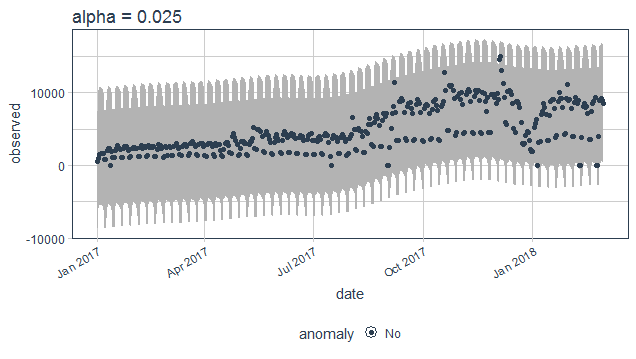
Ici, l'anomalie est décidée en fonction du remainder et des limites calculées pour classer les valeurs aberrantes. Deux paramètres pilotent anomalize() : alpha et max_anoms. En bref, alpha contrôle la largeur de la bande ; par défaut à 0,05 : diminuer alpha élargit la bande, ce qui rend plus difficile la détection d'un point comme anomalie.
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.05")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.025)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.025")
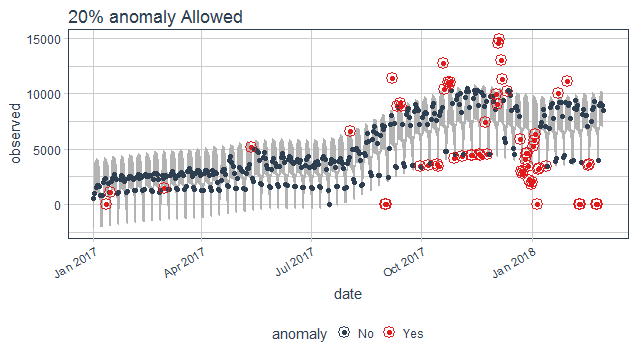
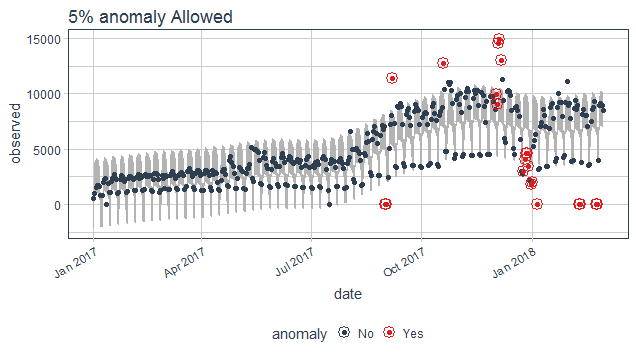
Le paramètre max_anoms contrôle la part maximale des données pouvant être marquées comme anomalies. Utile quand alpha est difficile à régler et que vous souhaitez cibler les anomalies les plus marquées.
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.2)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("20% anomaly Allowed")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("5% anomaly Allowed")
Pour aller plus loin avec R, suivez le cours Introduction to Time Series Analysis de DataCamp.
Consultez notre tutoriel : analyse de séries temporelles avec R.
Cours R
Cours
Cours
Cours