कोर्स
R परिचय
4 घंटा
3.1M
जब हम विसंगतियों की बात करते हैं, तो हम उन डेटा बिंदुओं पर विचार करते हैं जो आउटलायर हों या असाधारण घटनाएँ हों। छोटे डेटा सेट में ऐसी घटनाओं की पहचान करना आसान है और इसे बॉक्सप्लॉट जैसे सरल विश्लेषणात्मक ग्राफ़ से किया जा सकता है। लेकिन जैसे ही बड़े डेटा सेट, खासकर टाइम सीरीज़, पर आते हैं, मामले जटिल होने लगते हैं। टाइम सीरीज़ वह डेटा है जो समयावधि में एक नियत अंतराल पर एकत्र किया गया होता है, जिसका विश्लेषण करने पर ट्रेंड या मौसमी पैटर्न दिखाई देता है। इन मामलों में विसंगतियों की पहचान करना कुछ पेचीदा होता है।
इसी जगह टाइम सीरीज़ विश्लेषण में विसंगति पहचान के लिए anomalize पैकेज आता है। यह एक सुव्यवस्थित, समय-आधारित और एक से कई टाइम सीरीज़ तक स्केलेबल अनोमली डिटेक्शन एल्गोरिदम है।
इसके विकास में कुछ उपलब्ध पैकेज और विधियाँ मदद करती हैं, या यूँ कहें कि यह उपलब्ध संसाधनों का एक स्केलेबल संयोजन है।
वे ओपन सोर्स कार्य जिनसे मदद मिली, इस प्रकार हैं:
इन सभी पैकेजों और फ़ंक्शनों को एक स्केलेबल वर्कफ़्लो में एकीकृत करने के लिए इस्तेमाल किया जाता है।
anomalize के वर्कफ़्लो की बात करें तो इसे तीन हिस्सों में बाँटा गया है:
time_decompose() के साथ टाइम सीरीज़ डीकंपोज़िशन।anomalize() के साथ रिमेंडर में विसंगतियों का पता लगाना।time_recompose() के साथ विसंगतियों की निचली और ऊपरी सीमा का पुनरूपांतरण।पहला चरण है time_decompose() का उपयोग करके टाइम सीरीज़ का डीकंपोज़ करना। वह मापित या संख्यात्मक मान जिस पर किसी विशेष समूह के लिए डिटेक्शन करना है, उसे चार कॉलम में विभाजित किया जाता है: observed, season, trend, और remainder। डिफ़ॉल्ट डीकंपोज़िशन विधि stl है, जो Loess स्मूथर का उपयोग करते हुए मौसमी डीकंपोज़िशन करती है।
Loess रिग्रेशन अस्थिर टाइम सीरीज़ को स्मूथ करने की सबसे आम विधि है। यह स्थानीय पड़ोस में अनेक रिग्रेशन फिट करता है; यूँ भी कह सकते हैं कि डेटा को हिस्सों में बाँटकर हर हिस्से पर रिग्रेशन लगाया जाता है। टाइम सीरीज़ में यह उपयोगी है क्योंकि यहाँ समय (इस मामले में X वेरिएबल) की सीमा हमें पता होती है। यह विधि तब अच्छी तरह काम करती है जब टाइम सीरीज़ में ट्रेंड, सीज़नैलिटी पर हावी हो।
यहाँ ट्रेंड का अर्थ है कई ऑब्ज़र्वेशनों में दिखने वाली दीर्घकालिक वृद्धि, और सीज़नैलिटी का अर्थ है मिनट, घंटे या साप्ताहिक स्तर पर होने वाला आवर्ती चक्रीय पैटर्न।
एक दूसरी तकनीक भी है जिसे आप मीडियन-आधारित मौसमी डीकंपोज़िशन के लिए उपयोग कर सकते हैं, यानी Twitter विधि, जो AnomalyDetection पैकेज में भी प्रयुक्त होती है। मौसमी घटक हटाने में यह STL के समान है। अंतर ट्रेंड हटाने में है: यह स्मूथर फिट करने के बजाय डेटा के पीस-वाइज़ मीडियन (निर्दिष्ट अंतरालों पर एक या कई मीडियन स्प्लिट) का उपयोग करती है। यह विधि तब अच्छी तरह काम करती है जब टाइम सीरीज़ में सीज़नैलिटी, ट्रेंड पर हावी हो।
अब time_decompose() फ़ंक्शन के आउटपुट पर बात करें। जैसा ऊपर कहा, यह 4 कॉलम बनाता है:
time_decompose() फ़ंक्शन में merge नाम का आर्गुमेंट होता है; इसे TRUE करने पर मूल डेटा, बने हुए कॉलमों के साथ रखा जा सकता है।
# Using data package provided in the anomalize package and taking single time series of package purrr

purrr_package = tidyverse_cran_downloads%>%
  filter(package == "purrr")%>%
  ungroup()

purrr_anomaly  = purrr_package %>%
  time_decompose(count)

purrr_anomaly%>% glimpse()
 ## Observations: 425
## Variables: 5
## $ date      <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, 201...
## $ observed  <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008, 2...
## $ season    <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9377...
## $ trend     <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901, 15...
## $ remainder <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -797.8...टाइम सीरीज़ विश्लेषण के बाद जब रिमेंडर में अनोमली डिटेक्शन के लिए अपेक्षित विशेषताएँ होती हैं, तब फिर तीन नए कॉलम बनाए जाते हैं।
विसंगतियाँ ऐसे उच्च-प्रभाव बिंदु हैं जो वितरण को विकृत करते हैं। anomalize दो ऐसी विधियाँ लागू करता है जो उच्च-प्रभाव बिंदुओं के प्रति सक्षम हैं:
यह forecast पैकेज के tsoutliers() फ़ंक्शन में प्रयुक्त विधि के समान है। IQR में वितरण लिया जाता है और 25% तथा 75% की इंटर क्वारटाइल रेंज के आधार पर रिमेंडर का वितरण स्थापित किया जाता है। सीमाएँ डिफ़ॉल्ट रूप से इंटर क्वारटाइल रेंज से ऊपर और नीचे 3 गुना फैक्टर पर तय होती हैं; इस सीमा से परे कोई भी रिमेंडर विसंगति माना जाता है।
GESD में विसंगतियों का प्रगतिशील रूप से मूल्यांकन किया जाता है—सबसे खराब अपवादों को हटाकर परीक्षण सांख्यिकी और क्रिटिकल वैल्यू फिर से गणना की जाती हैं; सरल शब्दों में, आप कह सकते हैं कि पहचानी गई विसंगतियों के बाद एक रेंज का पुनरावर्ती तरीके से पुनर्गणन किया जाता है।
IQR और GESD दोनों के अपने-अपने फायदे और सीमाएँ हैं। IQR तुलनात्मक रूप से तेज़ है क्योंकि इसमें लूप शामिल नहीं होते, पर यह GESD जितना सटीक नहीं होता क्योंकि विसंगतियाँ मीडियन को तिरछा कर देती हैं, जिसे GESD में हटाया जाता है।
purrr_anomaly = purrr_anomaly%>%
  anomalize(remainder)

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 8
## $ date         <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04, ...
## $ observed     <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 2008...
## $ season       <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939.9...
## $ trend        <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901,...
## $ remainder    <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -79...
## $ remainder_l1 <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -4330...
## $ remainder_l2 <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459,...
## $ anomaly <chr> "No", "No", "No", "No", "No", "No", "No", "No", "...वर्कफ़्लो का अंतिम चरण time_recompose के साथ observed मानों के चारों ओर निचली और ऊपरी सीमाएँ बनाना है। यह season, trend, remainder_l1 और remainder_l2 को फिर से संयोजित कर नई सीमाएँ बनाता है, जो हैं:
purrr_anomaly = purrr_anomaly%>%
  time_recompose()

purrr_anomaly%>% glimpse()
## Observations: 425
## Variables: 10
## $ date          <date> 2017-01-01, 2017-01-02, 2017-01-03, 2017-01-04,...
## $ observed      <dbl> 550, 1012, 1515, 1702, 1696, 1613, 860, 796, 200...
## $ season        <dbl> -2158.8893, 692.6571, 1087.5708, 1052.3294, 939....
## $ trend         <dbl> 1496.712, 1511.009, 1525.307, 1539.604, 1553.901...
## $ remainder     <dbl> 1212.1777, -1191.6661, -1097.8773, -889.9334, -7...
## $ remainder_l1  <dbl> -4330.511, -4330.511, -4330.511, -4330.511, -433...
## $ remainder_l2  <dbl> 4400.459, 4400.459, 4400.459, 4400.459, 4400.459...
## $ anomaly       <chr> "No", "No", "No", "No", "No", "No", "No", "No", ...
## $ recomposed_l1 <dbl> -4992.689, -2126.845, -1717.634, -1738.578, -183...
## $ recomposed_l2 <dbl> 3738.281, 6604.125, 7013.336, 6992.392, 6894.298...
विसंगतियों का प्लॉट बनाना
purrr_anomaly%>%
  plot_anomaly_decomposition()+
  ggtitle("Plotting Anomalies")
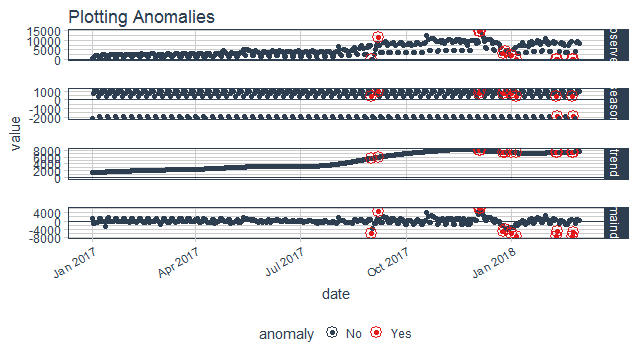
किसी अनोमली डिटेक्टर का मॉडलिंग, पैरामीटर समायोजन के बिना पूर्ण नहीं होता, और यह पूरी तरह डेटा पर निर्भर है।
आइए पैरामीटर समायोजन पर आएँ। वर्कफ़्लो के प्रत्येक स्तर के पैरामीटर अलग हैं क्योंकि हर स्तर अपना अलग कार्य करता है।
जैसा पहले चर्चा की, टाइम सीरीज़ को डीकंपोज़ करने में ट्रेंड और सीज़नैलिटी बुनियादी तत्व हैं, इसलिए time_decompose फ़ंक्शन की frequency और trend का समायोजन भी होना चाहिए। डिफ़ॉल्ट रूप से मान स्वतः निर्धारित होते हैं: दोनों विधियों (STL, Twitter) में frequency 7 दिन, और trend के लिए STL में 91 दिन तथा Twitter में 85 दिन।
आप अपनी सुविधा अनुसार एक या दोनों आर्गुमेंट बदल सकते हैं, लेकिन समायोजन से पहले ध्यान से जाँचें; बिना अवलोकन के बदलाव डीकंपोज़िशन प्रक्रिया को ओवरफिट या अंडरफिट कर सकते हैं।
purrr_package %>%
  time_decompose(count, frequency = "auto", trend = "2 weeks")%>%
  anomalize(remainder)%>%
  plot_anomaly_decomposition()+
  ggtitle("Trend = 2 Weeks / Frequency = auto ")
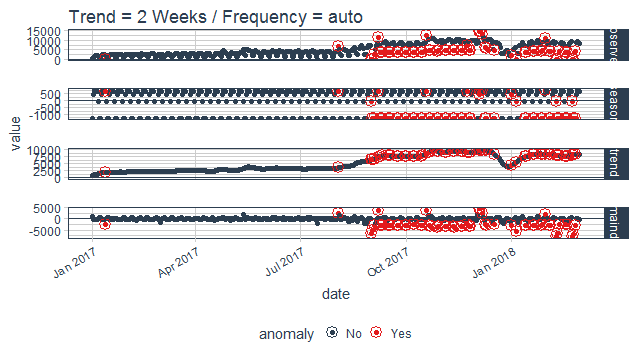
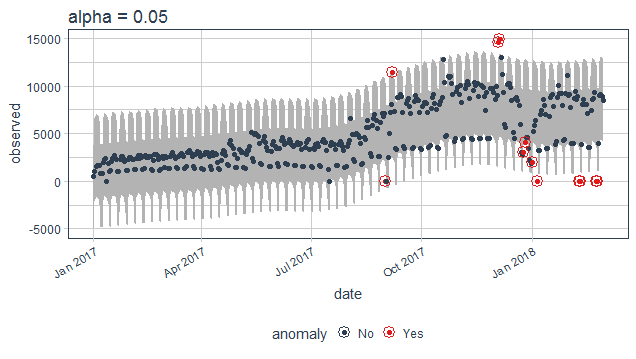
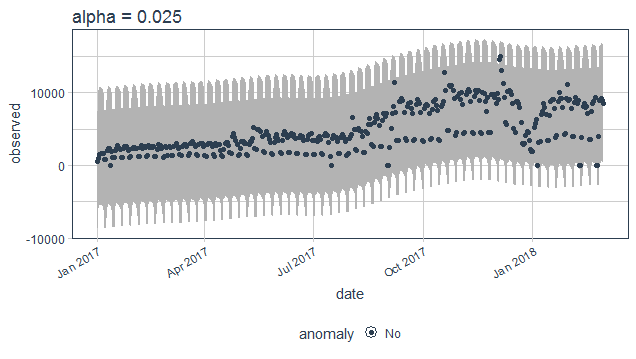
ऊपर चर्चा के अनुसार यहाँ विसंगति, रिमेंडर के मानों के आधार पर आउटलायर की श्रेणी करने के लिए सीमाएँ गणना कर तय होती है। anomalize() फ़ंक्शन को नियंत्रित करने वाले दो पैरामीटर हैं alpha और max_anoms। सरल शब्दों में, alpha सीमा के बैंड को नियंत्रित करता है; डिफ़ॉल्ट 0.05 है। इसका मान घटाने से बैंड का आकार बढ़ेगा, जिससे किसी बिंदु के विसंगति होने की संभावना कम हो जाएगी।
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.05")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.025)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("alpha = 0.025")
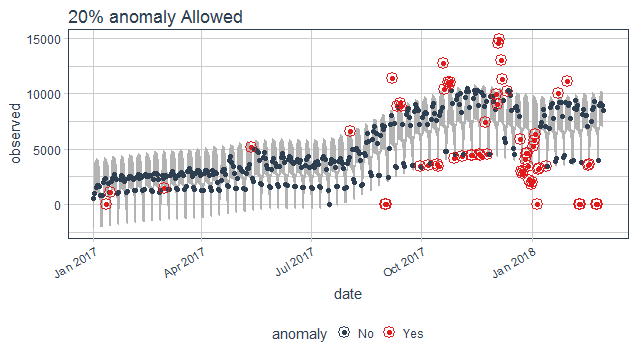
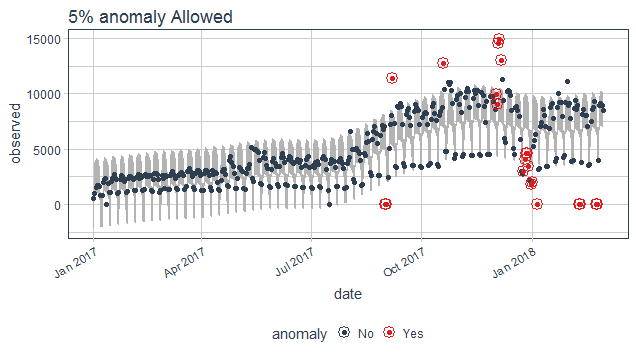
max_anoms पैरामीटर नियंत्रित करता है कि डेटा का कितना प्रतिशत विसंगति हो सकता है। यह पैरामीटर तब उपयोगी है जब alpha को ट्यून करना कठिन हो और आप सबसे आक्रामक विसंगतियों पर ध्यान केंद्रित करना चाहें।
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.2)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("20% anomaly Allowed")
purrr_package%>%
  time_decompose(count)%>%
  anomalize(remainder, alpha = 0.2, max_anoms = 0.05)%>%
  time_recompose()%>%
  plot_anomalies(time_recompose = T)+
  ggtitle("5% anomaly Allowed")
यदि आप R के बारे में और सीखना चाहें, तो DataCamp का Introduction to Time Series Analysis कोर्स करें।
हमारा Time Series Analysis using R: Tutorial देखें।
R कोर्स
कोर्स
कोर्स
कोर्स