Cours
Analyse des séries temporelles en Python
4 h
70.6K
Lors de la session Facebook Live du 4 janvier, nous avons exploré les données Google Trends des mots-clés "diet", "gym" et "finance" pour voir comment ils évoluent dans le temps. Nous nous sommes demandé s'il y avait davantage de recherches sur ces termes en janvier, quand chacun essaie de repartir sur de bonnes bases.
Dans ce tutoriel, vous allez reprendre pas à pas le code développé pendant la session. Pas besoin de faire beaucoup de mathématiques : l'accent est mis sur l'exploration visuelle du jeu de données.
Pour aller plus loin avec pandas, découvrez le parcours Data Manipulation with Python de DataCamp. Pour en savoir plus sur les séries temporelles avec pandas, consultez le cours Manipulating Time Series Data in Python.
La question demeure : observe-t-on plus de recherches sur ces termes en janvier, quand on veut tous repartir du bon pied ?
Vérifions-le en allant ici pour consulter les données. Remarque : ce tutoriel s’inspire de cet article de FiveThirtyEight.
Vous pouvez aussi télécharger les données au format .csv, les enregistrer puis les importer dans votre environnement Python pour mener votre propre analyse. C’est ce que vous allez faire maintenant. C’est parti !
Pour commencer, importez quelques packages : ici, vous allez utiliser numpy, pandas, matplotlib et seaborn.
De plus, si vous souhaitez afficher les graphiques directement dans Jupyter Notebook, utilisez la commande magique IPython %matplotlib inline. Vous pouvez aussi appliquer les thèmes par défaut de Seaborn avec sns.set() :
# Import packages
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()
Importez les données téléchargées avec .read_csv() et affichez les premières lignes avec .head().
Remarque : ajoutez l’argument skiprows pour ignorer la première ligne du fichier.
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()| Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Utilisez aussi la méthode .info() pour examiner les types de données, le nombre de lignes, etc. :
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
Vous avez importé les données Google Trends et jeté un premier coup d’œil. Il est temps de préparer et transformer les données pour l’analyse.
Commencez par renommer les colonnes du DataFrame df pour supprimer les espaces. Plusieurs approches sont possibles ; ici, vous allez simplement réassigner à df.columns la liste des nouveaux noms.
Vérifiez le résultat avec df.head() :
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
| month | diet | gym | finance | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Ensuite, convertissez la colonne 'month' en type DateTime et utilisez-la comme index du DataFrame.
Remarque : la méthode .info() a montré que 'Month' était de type object, un type générique (chaînes, entiers, etc.), peu pratique pour travailler avec des séries temporelles. Utilisez .to_datetime() pour convertir la colonne 'month' en DateTime.
Attention ! Lors du paramétrage de l’index, pensez à l’argument inplace pour modifier l’index d’origine et le définir sur 'month'.
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
df.head()
| diet | gym | finance | |
|---|---|---|---|
| month | |||
| 2004-01-01 | 100 | 31 | 48 |
| 2004-02-01 | 75 | 26 | 49 |
| 2004-03-01 | 67 | 24 | 47 |
| 2004-04-01 | 70 | 22 | 48 |
| 2004-05-01 | 72 | 22 | 43 |
Passons maintenant à l’exploration visuelle du DataFrame.
Utilisez la méthode de visualisation intégrée de pandas, .plot(), pour tracer 3 courbes sur une même figure (une par colonne : 'diet', 'gym' et 'finance').
Remarque : vous pouvez préciser des arguments comme figsize, linewidth et fontsize pour la taille de la figure, l’épaisseur des lignes et la taille des polices.
Vous verrez que l’axe des x affiche les années (et non les mois, malgré le libellé par défaut). Pour être plus précis, définissez le libellé de l’axe des x à 'Year' et la taille de police à 20.
Astuce : pour supprimer la sortie Matplotlib, ajoutez simplement un point-virgule ; à la fin de votre dernière ligne de code.
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
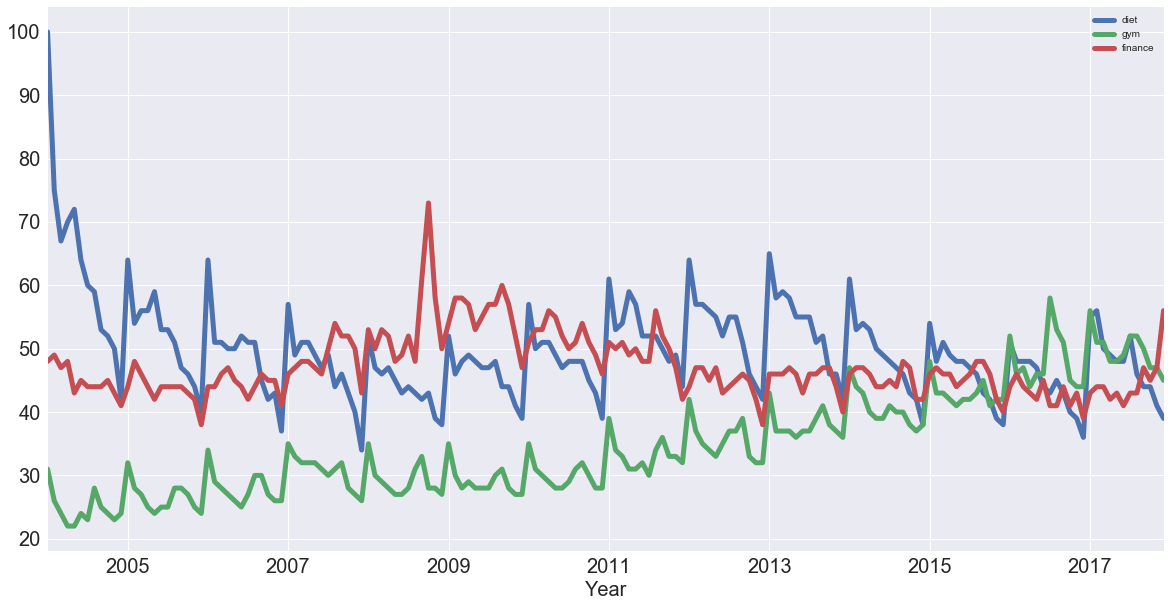
Remarque : ces données sont relatives. Comme l’indique Google Trends :
Les valeurs représentent l’intérêt de recherche relativement au point le plus élevé du graphique pour la zone et la période données. Une valeur de 100 correspond au pic de popularité du terme. Une valeur de 50 signifie que le terme est deux fois moins populaire. Inversement, un score de 0 signifie que le terme était inférieur à 1 % du pic de popularité.
Vous pouvez aussi tracer la colonne 'diet' seule en série temporelle :
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
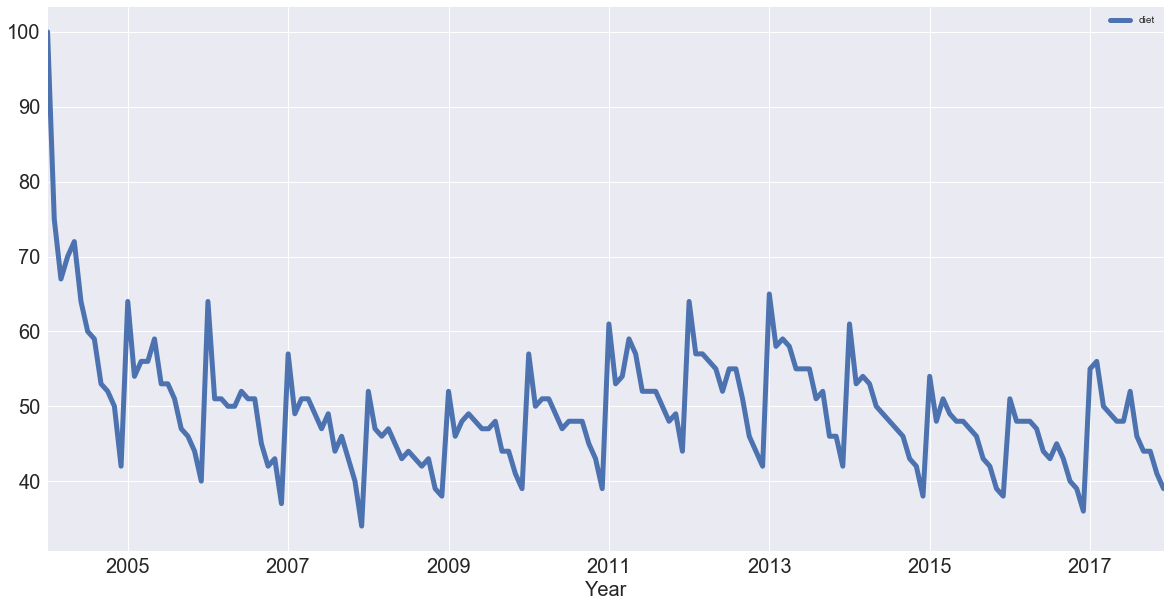
Remarque : premier constat, il y a de la saisonnalité : chaque mois de janvier, on observe un fort pic. Il semble aussi y avoir une tendance : légère hausse, puis baisse, puis à nouveau hausse et baisse. Autrement dit, ces séries présentent à la fois des tendances et des composantes saisonnières.
Gardez cela en tête : vous allez apprendre à identifier les tendances dans vos séries temporelles.
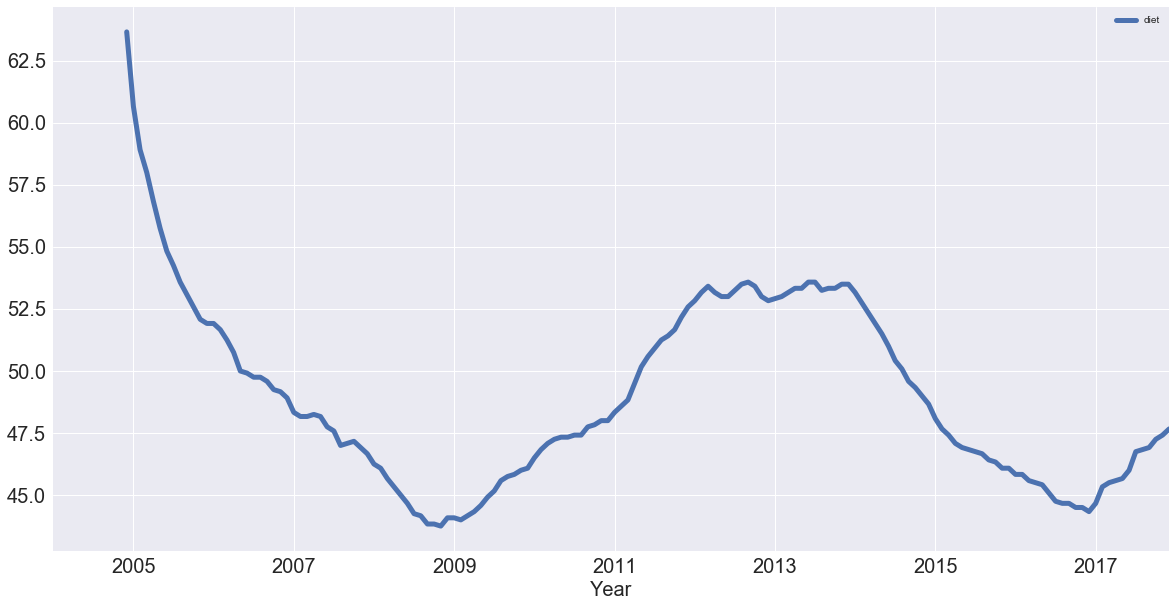
Plusieurs approches existent pour identifier une tendance. Une méthode courante est la moyenne glissante : pour chaque point temporel, on calcule la moyenne des points autour. Le nombre de points utilisés est défini par la taille de fenêtre, à choisir selon le cas.
La moyenne atténue le bruit et la saisonnalité. Voyons un exemple avec la moyenne glissante de 'diet' via les méthodes intégrées de pandas.
Pour choisir la taille de fenêtre, commencez par 12 mois, puisque la saisonnalité semble annuelle.
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Remarque : ci-dessus, deux crochets sont utilisés pour extraire 'diet' sous forme de DataFrame ; avec un seul crochet (df['diet']), vous obtiendriez une Series pandas.
Vous avez aussi enchaîné les méthodes (method chaining) : vous appelez plusieurs méthodes successivement sur un même objet. pandas se prête particulièrement bien à ce style.
Vous tenez maintenant la tendance recherchée ! La saisonnalité est en grande partie retirée par rapport au graphique précédent.
Tracez aussi la moyenne glissante de 'gym' avec la même fenêtre :
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
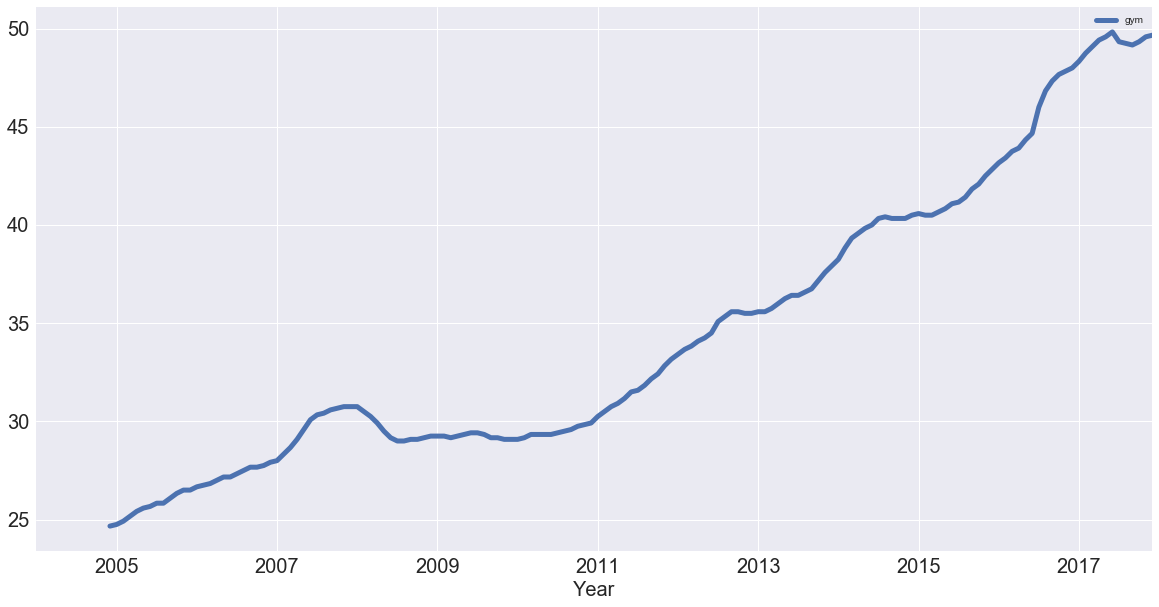
Vous avez efficacement gommé la saisonnalité et vous observez une tendance à la hausse pour "gym". Mais comment ces deux termes se comparent-ils ?
Superposez les tendances de 'gym' et 'diet' sur une même figure :
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
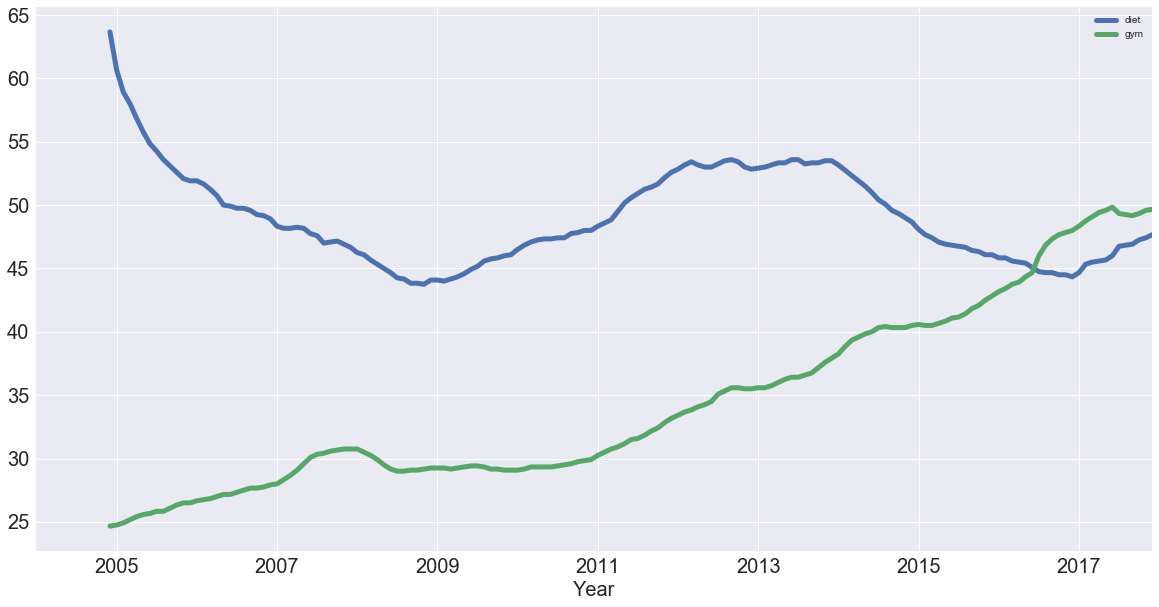
Vous avez créé un nouveau DataFrame df_rm contenant deux colonnes : les moyennes glissantes de 'diet' et 'gym'. La fonction pd.concat() prend la liste de colonnes en premier argument et, comme vous voulez concaténer par colonnes, vous définissez axis à 1.
Ensuite, vous tracez le DataFrame avec plot() comme précédemment. En supprimant la saisonnalité, on voit que diet conserve possiblement une composante cyclique, tandis que gym progresse réellement.
Après avoir identifié les tendances, intéressons-nous à la saisonnalité, c’est-à-dire au caractère répétitif de la série. Comme observé au début, les séries semblent mêler tendances et composantes saisonnières.
Une façon d’étudier la saisonnalité consiste à retirer la tendance pour mieux l’isoler. Vous pouvez soustraire la tendance (moyenne glissante) du signal d’origine. Le résultat dépendra toutefois de la taille de fenêtre choisie.
Une autre méthode est la "différenciation" (differencing) : on calcule la différence entre deux points successifs ("différenciation d’ordre 1").
Utilisez pandas avec diff() et plot() pour calculer et tracer la différence d’ordre 1 de la Series 'diet' :
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
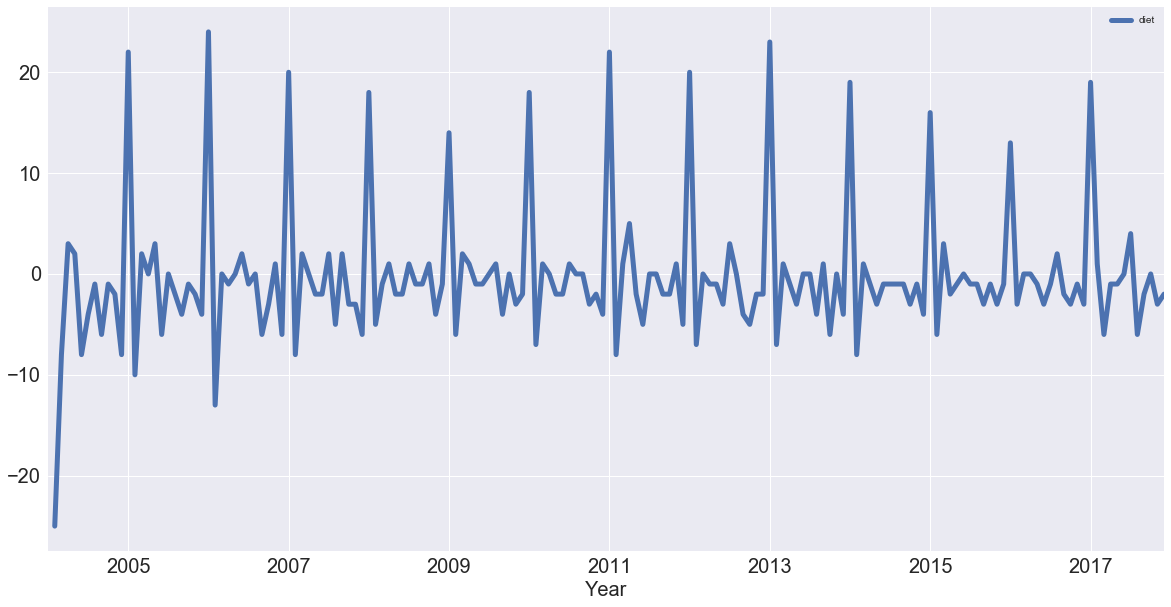
Vous avez supprimé une grande partie de la tendance et les pics de janvier apparaissent clairement chaque année. Chaque mois de janvier, on observe un bond de 20 % ou plus sur l’élément de recherche le plus élevé.
Remarque : vous pouvez aussi effectuer une différenciation d’ordre 2 (différence entre un point et les deux qui le précèdent) si la tendance n’est pas totalement supprimée. Plus d’infos ici.
La différenciation est très utile pour rendre une série temporelle stationnaire. Sans entrer dans les détails, une série stationnaire a des propriétés statistiques (moyenne, variance, etc.) stables dans le temps. C’est important car de nombreuses méthodes de prévision reposent sur cette hypothèse.
Avec tout cela en tête, vous allez maintenant analyser la périodicité via la fonction d’autocorrélation. Mais avant cela, petit détour par la corrélation.
Une série temporelle est périodique si elle se répète à intervalles réguliers, par exemple tous les 12 mois.
Autrement dit, si la série présente un pic à un moment donné, on en attend un autre 12 mois plus tard ; de même pour un creux.
Encore une autre manière de le formuler : la série est corrélée avec elle-même décalée de 12 mois. Si vous décalez la série de 12 mois vers l’avant ou l’arrière, elle se superpose en partie à elle-même.
Considérer la corrélation d’une série avec sa version décalée relève de l’autocorrélation.
Nous y venons dans un instant.
D’abord, rafraîchissons la notion de corrélation avec une approche intuitive.
Le coefficient de corrélation entre deux variables mesure leur relation linéaire. Pour l’illustrer, utilisons le jeu de données iris, qui contient des mesures de fleurs.
Importez le jeu de données iris depuis scikit-learn, transformez-le en DataFrame et affichez les premières lignes avec .head() :
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
Pour rappel, toutes les fleurs ont un sépale et un pétale. Le sépale entoure les pétales et est généralement vert et foliacé, tandis que les pétales sont colorés. La colonne 'target' (variable cible) correspond à l’espèce d’iris : Versicolor, Virginica ou Setosa, encodées ici en 0, 1 et 2.
Pour étudier la corrélation, regardons comment la longueur du sépale est corrélée à sa largeur. Créez un nuage de points de 'sepal length' en fonction de 'sepal width' avec pandas ou seaborn :
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
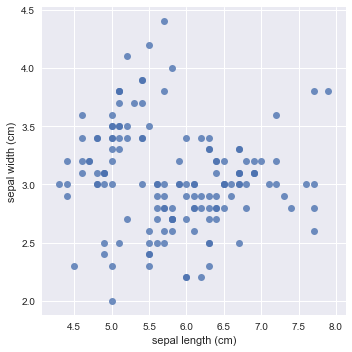
Remarque : vous avez désactivé la régression linéaire avec fit_reg=False.
La longueur et la largeur du sépale sont-elles corrélées positivement ou négativement sur l’ensemble des fleurs ? Et au sein de chaque espèce ? Distinction essentielle.
La corrélation positive signifie que lorsque la longueur augmente, la largeur augmente aussi linéairement. Négative : si la longueur augmente, la largeur diminue linéairement.
À première vue, le graphique ci-dessus suggère une légère corrélation négative : plus la longueur augmente, plus la largeur diminue un peu.
Traçons maintenant le nuage de points 'sepal length' vs 'sepal width', coloré par la cible (species) :
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
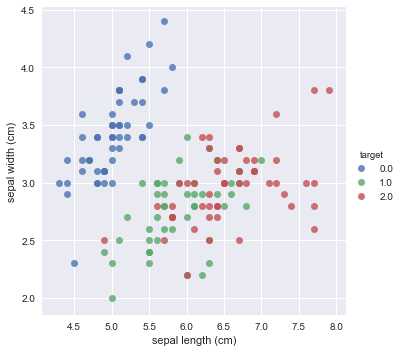
Cette fois, on observe plutôt une corrélation positive : pour chaque espèce, lorsque la longueur augmente, la largeur augmente également.
Les visualisations donnent une intuition, mais on peut aller plus loin en calculant un coefficient de corrélation.
Calculez les coefficients de corrélation pour chaque paire de mesures avec .corr() :
df_iris.corr()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
Remarque : "sepal length (cm)" et "sepal width (cm)" semblent négativement corrélés sur l’ensemble des fleurs (coefficient : -0,1). Mais au sein de chaque espèce, ils ne le sont pas ; le coefficient avec la cible atteint 0,78.
Pour les curieux, c’est le paradoxe de Simpson, crucial en inférence causale. À lire ici.
Allons plus loin : calculons les corrélations au sein de chaque espèce. Pour cela, enchaînez .groupby() et .corr() pour grouper par cible et afficher les coefficients :
df_iris.groupby(['target']).corr()
| petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) | ||
|---|---|---|---|---|---|
| target | |||||
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 | |
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 | |
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 | |
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 | |
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 | |
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 | |
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 | |
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 | |
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
Dans cette matrice de corrélation, on observe :
Toutes positives (de décroissantes), et bien plus élevées que la corrélation négative observée sur l’ensemble.
C’est très instructif et rappelle l’importance d’analyser finement vos données.
Maintenant que la corrélation est clarifiée, passons à l’analyse de la périodicité via la fonction d’autocorrélation.
Pour commencer, retracez toutes vos séries temporelles pour vous les remémorer :
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
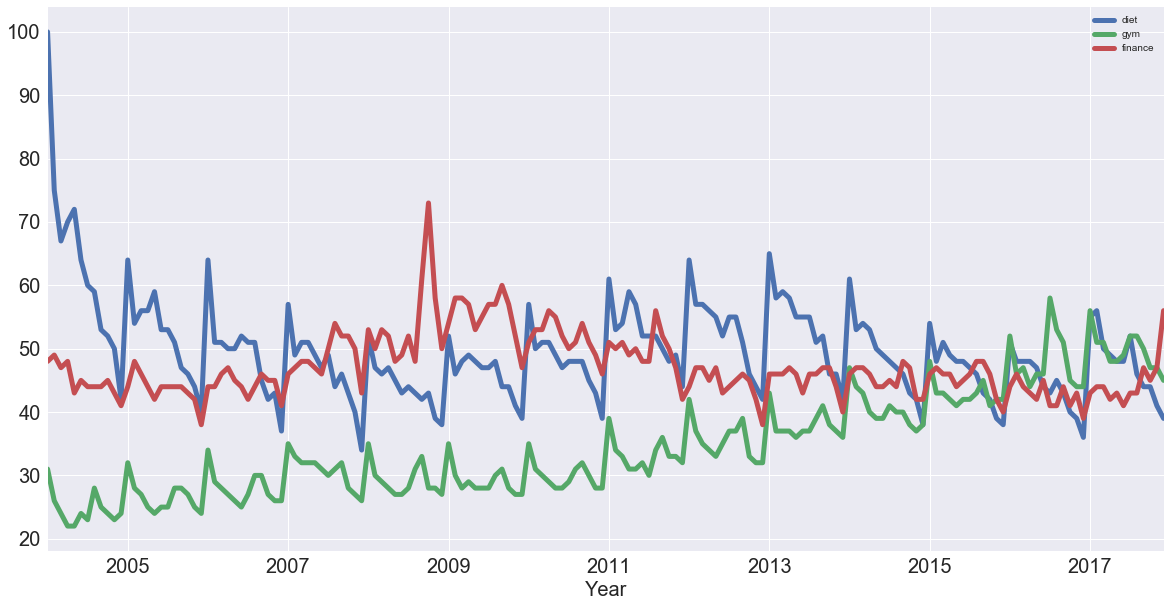
Puis calculez les coefficients de corrélation entre toutes ces séries avec .corr() :
df.corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
| gym | -0.100764 | 1.000000 | -0.284279 |
| finance | -0.034639 | -0.284279 | 1.000000 |
Que nous dit ce tableau ?
Concentrons-nous sur 'diet' et 'gym' : ils sont négativement corrélés. Intéressant ! Rappelez-vous que chaque série combine tendance et saisonnalité. Le coefficient capture les deux : visuellement, les composantes saisonnières semblent positivement corrélées, alors que les tendances paraissent négativement corrélées.
Le coefficient de corrélation agrège ces deux effets.
Tracez maintenant les différences d’ordre 1 de ces séries puis calculez leur corrélation : cela approchera la corrélation des composantes saisonnières. En retirant la tendance, on peut révéler une corrélation saisonnière.
Commencez par tracer les différences avec .diff() et .plot() :
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
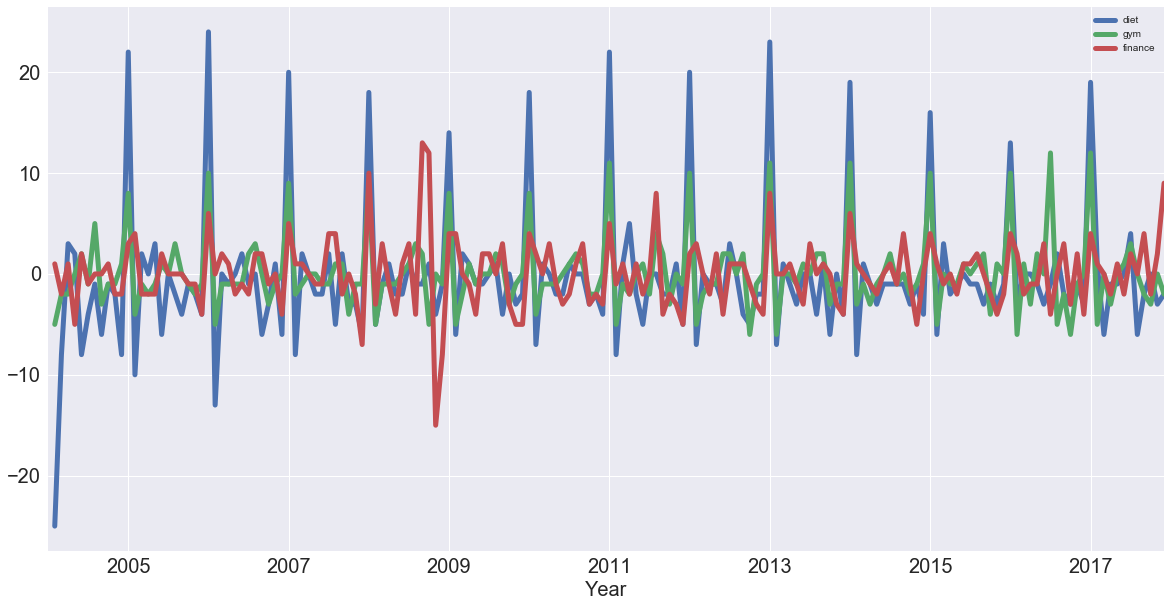
On voit que 'diet' et 'gym' sont fortement corrélés une fois la tendance retirée. Calculez maintenant la corrélation des différences d’ordre 1 :
df.diff().corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
| gym | 0.758707 | 1.000000 | 0.301111 |
| finance | 0.373828 | 0.301111 | 1.000000 |
Remarque : alors qu’il y avait une légère corrélation négative quand tendance et saisonnalité étaient mêlées, on observe ici, sur la composante saisonnière, une très forte corrélation entre 'diet' et 'gym' (0,76).
Après avoir exploré la corrélation entre variables et séries temporelles, tracez l’autocorrélation de la série 'diet' : l’axe des x indique le décalage (lag) et l’axe des y la corrélation de la série avec elle-même à ce décalage.
Si la série se répète tous les deux jours, on attend un pic à un lag de 2 jours.
Ici, vous devriez voir un pic à 12 mois : la série est corrélée avec elle-même décalée d’un an.
Utilisez l’interface plotting de pandas et la fonction autocorrelation_plot() pour tracer la série 'diet' :
pd.plotting.autocorrelation_plot(diet);
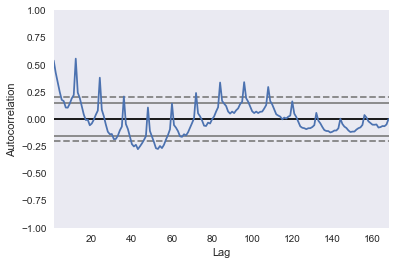
Avec un axe couvrant plus de lags, vous verriez un pic majeur à 12 mois, un autre à 24 mois, puis à 36, etc., l’intensité diminuant au fur et à mesure.
Évidemment, la corrélation à un lag de 0 est maximale (la série avec elle-même).
Les pointillés indiquent la significativité statistique. Ici, on peut dire que la série 'diet' est réellement autocorrélée avec un lag de 12 mois.
Vous avez identifié une saisonnalité annuelle (répétition sur 12 mois) !
Dans ce tutoriel, vous avez parcouru beaucoup de notions ! Vous avez étudié les données Google Trends des mots-clés "diet", "gym" et, plus rapidement, "finance", pour observer leurs variations dans le temps. Vous avez couvert la saisonnalité, les tendances, la corrélation, l’autocorrélation, etc.
Pour les data scientists motivés, deux pistes immédiates :
En savoir plus sur Python
Cours
Cours
Cours