Cours
Sécurité de l’IA et gestion des risques
2 h
11K
IA et ML sont souvent utilisés indifféremment. Mais pour les distinguer rapidement : l’IA désigne la technologie qui conçoit des machines imitant des fonctions cognitives humaines, tandis que le ML est un sous‑ensemble d’algorithmes d’IA qui apprennent et s’améliorent à partir des données.
Dans cet article, je propose d’explorer l’applicabilité des techniques de machine learning en cybersécurité, en présentant des cas d’usage et les défis d’explicabilité, d’interprétabilité et de robustesse à relever pour en tirer tout le potentiel.
La détection et la réponse aux menaces consistent à identifier les cybermenaces visant des réseaux ou des systèmes, puis à déployer rapidement des stratégies d’atténuation efficaces. Cela implique de repérer des comportements anormaux dans les réseaux et systèmes, d’identifier des intrusions non autorisées et d’analyser des échantillons de malwares pour protéger nos environnements.
La détection d’anomalies vise à identifier des motifs dans les données qui ne correspondent pas à une notion bien définie de comportement normal.
Concept fondamental et transversal, elle s’applique pleinement à la cybersécurité. Je l’emploie pour repérer des activités malveillantes variées : exfiltration de données, attaques par déni de service distribué (DDoS), infections par malwares, etc. Divers algorithmes de ML, tels que Local Outlier Factor (LOF), Isolation Forest, One‑Class Support Vector Machine (OC‑SVM), sont utilisés pour détecter des anomalies. Toutefois, choisir la bonne technique exige de prendre en compte plusieurs facteurs, notamment :
Nous verrons comment sélectionner les bonnes techniques de ML et expliquerons comment elles détectent des activités malveillantes. Nous nous concentrerons sur deux applications clés : la détection d’intrusion et l’analyse de malwares.
Les IDS sont les yeux et les oreilles des réseaux et systèmes : ils surveillent et analysent le trafic réseau (IDS réseau) et les appels système (IDS hôte) pour y déceler des activités malveillantes.
Au fil de mes expériences, j’ai constaté l’efficacité des approches par détection d’anomalies pour repérer de nouvelles menaces inconnues échappant aux techniques à base de signatures, qui reposent sur des motifs d’attaque prédéfinis.
Avant d’aborder l’IDS hôte, rappelons ce que sont les appels système : des requêtes faites par un programme au système d’exploitation pour exécuter des tâches données. Par exemple, sous Linux, un éditeur de texte demande l’ouverture d’un fichier via open(), y écrit via write(), puis enregistre en le fermant via close().
Si les appels d’un éditeur sont prévisibles, la séquence d’un acteur malveillant est souvent trompeuse : open(), write() pour déposer un fichier caché, puis execve() pour l’exécuter avec des privilèges élevés, suivi d’appels réseau comme socket() pour potentiellement établir un canal de commande et contrôle.
Pour y faire face, les séquences d’appels système sont souvent transformées en représentations statiques de caractéristiques adaptées aux algorithmes de ML. Mais quelle technique d’apprentissage privilégier pour entraîner les modèles ?
Le choix dépend fortement des étiquettes disponibles. Si l’on dispose d’un jeu équilibré de séquences normales et anormales, je privilégie des modèles supervisés comme les machines à vecteurs de support (SVM).
À l’inverse, en absence de données étiquetées, j’utilise des modèles non supervisés comme Isolation Forest. Lorsque seuls les comportements normaux figurent à l’entraînement, je me tourne vers des techniques semi‑supervisées, comme One‑Class SVM ou DBSCAN.
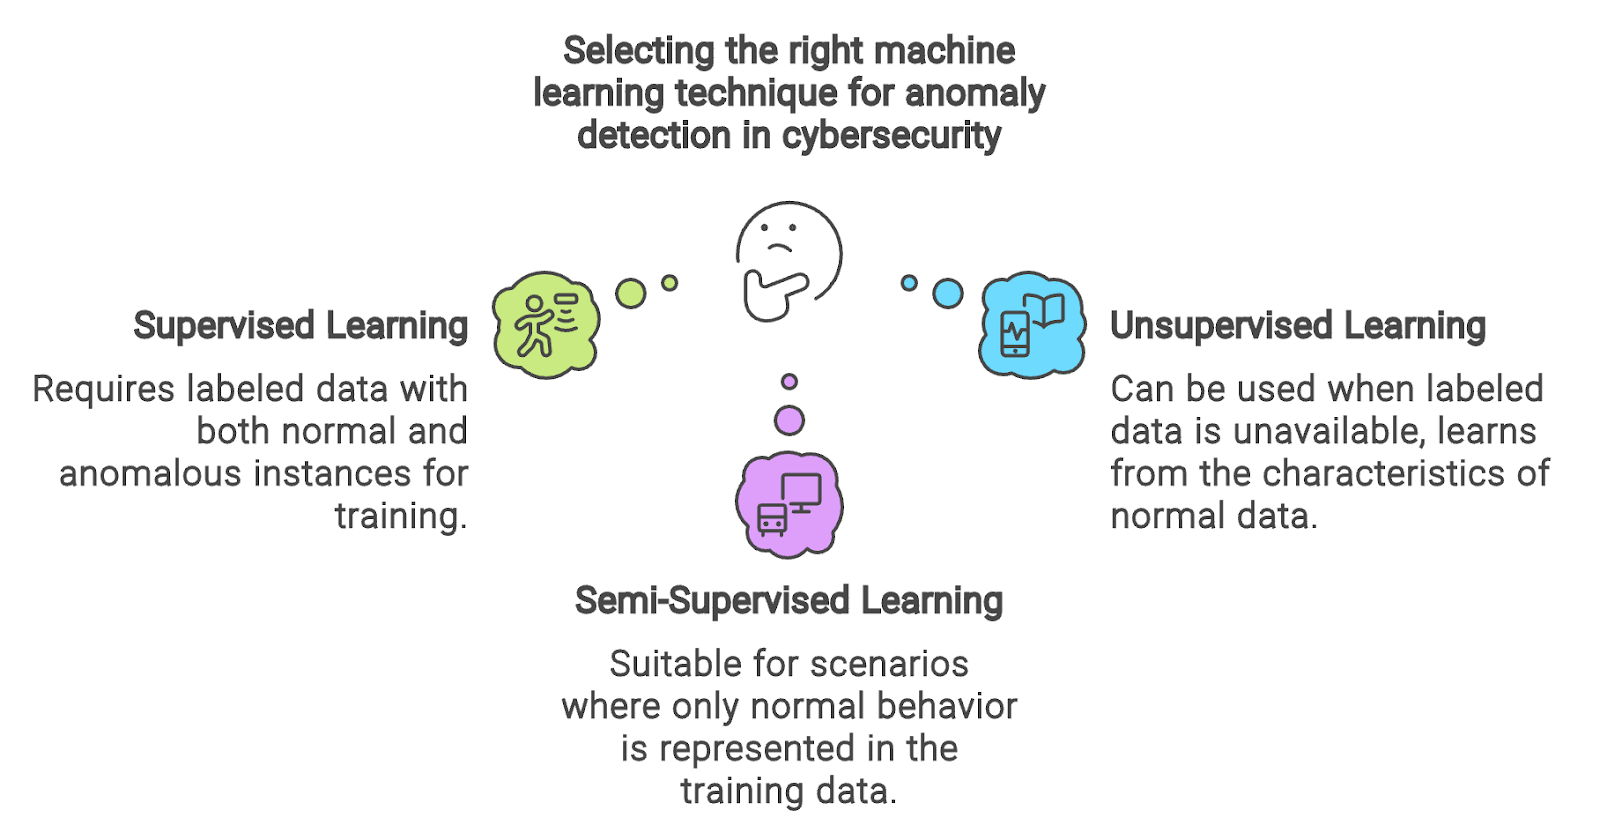
Schéma créé avec Napkin.ai
Après l’IDS hôte, passons au domaine de l’IDS réseau. Les systèmes hôtes se concentrent sur la machine, tandis que les IDS réseau identifient des intrusions dans les données réseau : ils surveillent statistiques de flux, charges utiles et en‑têtes de paquets pour détecter vols d’information et perturbations.
Un rapide coup d’œil au tableau suivant donne une idée d’un jeu de données de flux réseau.
|
Port de destination |
Port source |
Durée du flux (ms) |
Total paquets sortants |
Total paquets entrants |
Étiquette |
|
54865 |
9910 |
6 |
5000 |
600 |
0 |
|
54810 |
9010 |
2 |
2000 |
200 |
1 |
Statistiques synthétiques de flux réseau normaux et anormaux.
Chaque ligne représente une session de communication indépendante entre deux points, sans relation intrinsèque avec les autres flux du jeu de données.
Chaque flux est défini par des attributs comme les ports source et destination, la durée en millisecondes, et le nombre total de paquets échangés dans les deux sens. Une étiquette catégorique indique si le flux est anormal ou attaque, fournissant une vérité terrain essentielle pour les modèles de détection d’intrusion.
À noter : chaque ligne correspond à un flux indépendant, sans dépendances séquentielles ou relationnelles avec d’autres flux du jeu.
Étant donné cette indépendance, après quelques techniques de feature engineering, le jeu de données peut alimenter des algorithmes de ML pour la détection d’anomalies. Comme pour l’IDS hôte, le choix des techniques dépend de la disponibilité des étiquettes.
Avant l’analyse, rappelons ce qu’est un malware et comment il opère.
Un malware est un logiciel malveillant conçu pour exécuter les intentions nocives d’un attaquant. Ce code exploite volontairement des vulnérabilités pour compromettre l’intégrité, voler des données sensibles, supprimer des informations, voire chiffrer des données pour rançon. Il peut prendre la forme de virus, vers, spyware, chevaux de Troie, ransomware, etc.
Pour comprendre la catégorie, les fonctionnalités et l’impact potentiel, on extrait plusieurs caractéristiques d’analyses statique et dynamique et on les injecte dans des algorithmes de ML adaptés.
Pour l’analyse d’exécutables Windows, c’est‑à‑dire les Portable Executables (PE), on peut extraire des caractéristiques issues à la fois d’analyses dynamiques et statiques : séquences d’octets, API/appels système, opcodes, réseau, système de fichiers, registres CPU, attributs de fichiers PE et chaînes, puis entraîner des modèles supervisés, non supervisés ou semi‑supervisés pour détecter les malwares.
Pour réduire le risque d’exposition aux cyberattaques, il faut identifier, évaluer et traiter rapidement les faiblesses de sécurité de nos réseaux, postes et applications. Voyons le rôle de l’IA et du ML dans l’amélioration de la gestion des vulnérabilités : scan des vulnérabilités, gestion des correctifs et évaluation des risques.
En tant que chercheur, je développe souvent des outils sur mesure pour automatiser des tâches : parseurs de journaux réseau, fuzzers, etc.
S’ils renforcent nos opérations de sécurité, il est indispensable de les soumettre à un scan de vulnérabilités rigoureux avant usage et partage avec mes collègues.
Sinon, un attaquant pourrait exploiter une faille non découverte et non corrigée dans mon script pour obtenir un accès non autorisé, compromettre des informations sensibles ou perturber des services.
Les modèles de ML voient la forêt derrière les arbres : ils excellent à extraire des signaux utiles de grands volumes en repérant des motifs subtils. J’ai donc commencé à les explorer pour automatiser la détection de vulnérabilités, accélérer l’analyse et identifier des failles inédites.
Pour bâtir un modèle de détection basé ML, je collecte des exemples vulnérables et non vulnérables issus de différentes sources, dont la NVD (National Vulnerability Database), OWASP, etc.
La collecte est ensuite prétraitée et encodée pour alimenter le modèle. L’entrée peut être représentée sous forme de graphe ou d’arbre montrant les relations entre éléments de code, comme un Code Property Graph (CPG) ou un arbre de syntaxe abstraite (AST).
L’entrée peut aussi être tokenisée, le code source étant transformé en vecteurs de jetons. Diverses techniques d’embedding peuvent ensuite être appliquées : Word2Vec, graph embeddings, one‑hot, n‑grammes, etc.
Comme expliqué plus haut, le choix du modèle et du mode d’apprentissage dépend surtout des étiquettes disponibles. À l’entraînement, le jeu de données est séparé en ensembles d’apprentissage et de validation, et le modèle apprend sur des données étiquetées.
Les paramètres sont mis à jour itérativement selon les erreurs de prédiction via des techniques d’optimisation. Une fois l’apprentissage terminé, la capacité du modèle à détecter des vulnérabilités est évaluée sur des données inédites. Des indicateurs clés comme l’accuracy, la précision, le rappel et le score F1 sont calculés.
Après détection de vulnérabilités dans mon script, une évaluation des risques s’impose. Si des contrôles existants empêchent leur exploitation ou si les conséquences potentielles sont minimes, le risque peut être accepté.
On peut aussi décider de ne pas utiliser le code afin d’éliminer tout risque. Si cela est impraticable, il faut mettre en place des mesures de mitigation.
Voyons ensuite le correctif logiciel comme mesure prioritaire.
Traiter toutes les vulnérabilités ouvertes et critiques serait idéal, mais souvent irréaliste. Une approche plus stratégique s’impose. Grâce au ML, nous pouvons prédire quelles vulnérabilités ont le plus de chances d’être exploitées, et ainsi prioriser les correctifs.
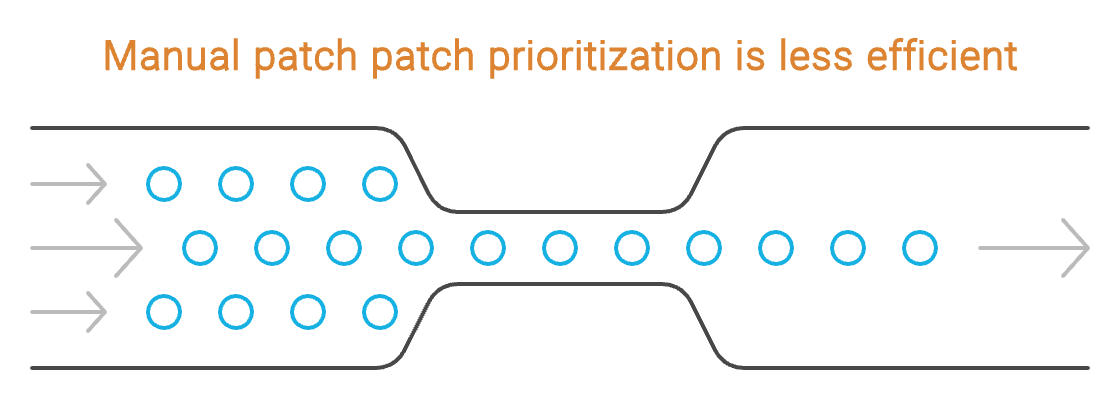
Créé avec Napkin.ai
Pour rationaliser la priorisation, nous utilisons le modèle pré‑entraîné à base d’arbres Exploit Prediction Scoring System (EPSS), qui combine des informations sur les vulnérabilités avec l’activité d’exploitation observée pour prédire la probabilité d’utilisation d’une faille au cours des trente prochains jours.
Le modèle EPSS identifie des motifs et relations entre informations de vulnérabilité, comme le CVSS, et activité d’exploitation pour estimer mathématiquement la probabilité d’usage par des attaquants.
Après priorisation, les correctifs sont acquis, validés et testés de manière rigoureuse pour limiter les risques opérationnels. Le déploiement dépend de plusieurs facteurs, notamment :
À l’échelle et avec la diversité des environnements modernes, le déploiement manuel est lourd et chronophage. L’automatisation par l’IA peut l’optimiser en sélectionnant et déployant intelligemment le correctif adéquat sur chaque système selon ces facteurs.
Des algorithmes de clustering, comme K‑means, peuvent regrouper des systèmes similaires pour un déploiement plus efficace.
L’évaluation du cyber‑risque est essentielle pour identifier, évaluer et atténuer menaces potentielles et vulnérabilités détectées.
Les approches classiques peinent à repérer des indicateurs de risques imprévisibles : les chercheurs se tournent donc vers le ML.
Grâce à des classifications supervisées multi‑classes, ils améliorent l’évaluation des risques via l’analyse de facteurs clés.
Comme indiqué dans le tableau ci‑dessous, ces facteurs incluent les investissements cybersécurité, les caractéristiques des équipes, l’historique des attaques, les vulnérabilités d’infrastructure, l’accompagnement externe et le niveau de risque associé. Leur preuve de concept SecRiskAI montre le potentiel du ML pour prédire la probabilité d’attaques DDoS ou de phishing.
|
Information |
Exemple |
|
Chiffre d’affaires |
2 500 000 |
|
Investissement cybersécurité |
500 000 |
|
Attaques réussies |
5 |
|
Attaques déjouées |
10 |
|
Nombre d’employés |
4 450 |
|
Formation des employés |
Moyenne |
|
Vulnérabilités connues |
9 |
|
Conseiller cybersécurité externe |
Non |
|
Risque |
Faible |
Exemple d’attributs clés pour l’évaluation du cyber‑risque (source)
Voyons maintenant comment l’IA et le ML transforment la réponse aux incidents : automatisation des workflows, réduction des délais de réponse, détection proactive de menaces latentes et amélioration de la forensique pour remonter à l’origine et à l’impact des attaques.
J’ai pu constater que les plateformes SOAR ingèrent des alertes issues des systèmes de gestion des informations et événements de sécurité (SIEM) et déclenchent des playbooks qui automatisent et coordonnent une série de tâches de sécurité.
Ces tâches incluent des actions d’enquête (vérification de réputation d’URL, récupération d’informations sur un utilisateur ou un actif) et des actions de réponse (blocage d’une IP sur un pare‑feu, arrêt d’un processus malveillant sur un endpoint).
Mais ces systèmes ont des limites : les analystes doivent définir, créer et modifier manuellement les playbooks, et le choix entre plusieurs playbooks repose sur des règles fixées par eux.
Pour les dépasser, l’intégration de l’IA et du ML dans les SOC peut révolutionner le processus, en générant automatiquement des playbooks capables de
réagir à des alertes inconnues.
Cela améliore l’efficacité et libère du temps aux analystes. À l’aide d’algorithmes de ML, on peut aussi entraîner le système à calculer le coût pénalité de chaque action selon l’alerte reçue et à sélectionner la réponse au coût minimal.
Imaginez la charge de passer au crible des millions de logs pour identifier des menaces potentielles.
À l’échelle d’une entreprise, chaque log devrait être examiné et classé comme malveillant ou bénin.
En intégrant le ML, on simplifie et on accélère cette tâche. Des algorithmes comme SVM ou Random Forest peuvent être entraînés à analyser et catégoriser efficacement les logs, ce qui accélère l’identification des menaces et soulage les équipes sécurité.
Avec l’essor et la complexité croissante des données numériques, l’intégration de l’IA et du ML en forensique numérique — l’analyse des preuves numériques pour enquêter sur les cybercrimes — est devenue essentielle.
Elle permet d’accroître la rapidité, la précision et l’efficacité de l’identification et de la réponse aux menaces.
L’IA et le ML s’emploient notamment au triage forensique : des algorithmes classent et catégorisent de grands volumes de fichiers numériques selon leur pertinence pour l’enquête.
L’intégration de l’IA en cybersécurité ouvre de grandes opportunités, mais il faut aussi en reconnaître les défis et limites.
De nombreux systèmes d’IA sont vulnérables aux attaques adversariales — empoisonnement, évasion, extraction de modèle, injection de prompts et inférence — qui exploitent leurs faiblesses.
Dans ces attaques, des perturbations imperceptibles pour l’humain sont ajoutées à l’entrée et suffisent à induire des prédictions erronées. Cela pose des problèmes de sûreté dans des environnements critiques, y compris la cybersécurité.
Pour nous défendre, nous recourons à des mécanismes comme l’entraînement adversarial, la distillation défensive et le masquage de gradient.
Même si les algorithmes d’IA obtiennent d’excellents résultats, comprendre leur fonctionnement interne reste difficile.
C’est crucial dans mon domaine : confier des décisions critiques à un système opaque comporte des risques évidents.
L’IA explicable (XAI) offre une voie pour concevoir des systèmes de cybersécurité plus transparents tout en maintenant de hautes performances. En rendant les décisions plus compréhensibles, la XAI m’aide à mener des analyses éclairées et à prendre les mesures les plus appropriées face aux incidents.
Les avancées récentes, comme l’analyse d’importance des variables et la visualisation d’arbres de décision, rendent cette transparence accessible.
À chaque sélection de jeu de données pour entraîner mes solutions IA en cybersécurité, je vérifie qu’il n’est pas biaisé. Sinon, les modèles pourraient produire des résultats injustes ou discriminatoires. J’emploie des techniques de prétraitement pour identifier et corriger les biais présents dans les données d’entraînement, et j’applique des méthodes d’équité pour évaluer les sorties du modèle.
Si vous avez lu jusqu’ici, vous avez vu comment l’IA et le ML transforment la protection de nos ordinateurs, mobiles, réseaux et applications. Vous avez constaté comment ils renforcent les équipes sécurité, détectent plus vite et musclent les outils.
Et le plus enthousiasmant : nous ne faisons que commencer.
L’avenir de la cybersécurité passera par l’essor continu de l’IA et du ML, en particulier des modèles de langage de grande taille (LLM). Grâce à des contextes étendus, à leur compréhension du code et à des analyses détaillées, ces modèles accélèreront et fiabiliseront l’analyse de malwares et la réponse aux menaces.
C’est le cas du modèle Gemini 1.5, déjà utilisé pour détecter des malwares dans des fichiers volumineux. Sans entraînement spécifique cybersécurité, ces modèles résolvent des tâches pertinentes via du prompt engineering, l’apprentissage en contexte et des chaînes de raisonnement.
Nous entrevoyons aussi cet avenir grâce au fine‑tuning de LLM à poids ouverts, dont Llama, pour des tâches liées à la cybersécurité comme Hackmentor.
Dans ce billet, nous avons vu comment des outils de cybersécurité s’appuyant sur l’IA et le ML aident à faire face à la nature dynamique et complexe des menaces actuelles. Ces outils détectent, répondent et réduisent les risques via des applications ciblées en détection de menaces, gestion des vulnérabilités et réponse aux incidents.
Il faut toutefois tenir compte des défis importants et des implications éthiques liés au développement et au déploiement de solutions de cybersécurité basées sur l’IA.
Malgré ces défis, l’évolution constante de l’IA et du ML offre de belles perspectives pour renforcer nos défenses face à des menaces en mutation.
En savoir plus sur la sécurité des données !
Cours
Cours
Cours