Kurs
KI-Sicherheit und Risikomanagement
2 Std.
11K
KI und ML werden oft synonym verwendet. Kurz gefasst: KI bezeichnet Technologien, die Maschinen befähigen, kognitive Funktionen menschlicher Intelligenz nachzuahmen, während ML die Untergruppe von KI-Algorithmen ist, die aus Daten lernen und sich fortlaufend verbessern.
In diesem Artikel erkunde ich die Einsatzmöglichkeiten von Machine-Learning-Verfahren in der Cybersicherheit, zeige Anwendungsfälle und beleuchte Herausforderungen wie Erklärbarkeit, Interpretierbarkeit und Robustheit, die wir adressieren müssen, um das Potenzial zu heben.
Threat Detection and Response umfasst das Erkennen von Cyberbedrohungen gegen Netzwerke oder Systeme, gefolgt von schnellen, wirksamen Gegenmaßnahmen. Dazu gehören die Erkennung anomaler Verhaltensweisen in Netz und Systemen, das Aufspüren unautorisierter Eindringlinge und die Analyse von Malware – um unsere Systeme zu schützen.
Anomalien zu erkennen bedeutet, Muster in Daten zu identifizieren, die nicht der definierten Vorstellung von normalem Verhalten entsprechen.
Dieses Grundkonzept ist in vielen Bereichen relevant – auch in der Cybersicherheit. Ich nutze Anomalieerkennung, um vielfältige bösartige Aktivitäten aufzuspüren, etwa Datenabfluss, Distributed-Denial-of-Service-(DDoS)-Angriffe, Malware-Infektionen und mehr.Verschiedene ML-Algorithmen wie Local Outlier Factor (LOF), Isolation Forest, One-Class Support Vector Machine (OC-SVM) kommen dafür zum Einsatz. Die Wahl der passenden Methode ist jedoch komplex und hängt unter anderem ab von:
Wir schauen uns an, wie wir die richtige ML-Technik auswählen und wie sie bösartige Aktivitäten erkennt. Im Fokus stehen zwei zentrale Anwendungen: Intrusion Detection und Malware-Analyse.
Intrusion-Detection-Systeme sind die Augen und Ohren von Netzwerken und Systemen: Sie überwachen und analysieren Netzwerkverkehr (netzwerkbasiertes IDS) und Systemaufrufe (hostbasiertes IDS) auf bösartige Aktivitäten.
In meinen Experimenten habe ich die Stärke von Anomalieerkennung bei beiden Systemtypen erlebt – speziell beim Aufspüren neuer oder unbekannter Bedrohungen, die signaturbasierte Verfahren, die auf vordefinierten Angriffsmustern beruhen, umgehen.
Bevor wir in hostbasierte IDS einsteigen, lohnt ein Blick auf Systemaufrufe: Das sind Anfragen eines Programms an das Betriebssystem, bestimmte Aufgaben auszuführen. Nutzt du etwa einen Texteditor unter Linux, ruft er im Hintergrund open() zum Öffnen der Datei auf, schreibt Änderungen mit write() und speichert durch close().
Während die Systemaufrufe eines Editors recht vorhersehbar sind, ist die Sequenz bei Angreifern oft trügerisch: Ein bösartiges Programm könnte mit open(), write() eine versteckte Datei ablegen, sie per execve() mit erhöhten Rechten ausführen und anschließend mit socket() eine Command-and-Control-Verbindung aufbauen.
Daher werden Sequenzen von Systemaufrufen oft in statische Merkmalsdarstellungen überführt, die sich für ML-Modelle eignen. Bleibt die Frage: Welche Lernmethode passt hier am besten?
Das hängt stark von verfügbaren Labels ab. Gibt es ein ausgewogenes Datenset aus normalen und anomalen Sequenzen, setze ich auf überwachte Modelle wie Support Vector Machines (SVM).
Fehlen Labels, nutze ich unüberwachte Verfahren wie Isolation Forest. Liegen nur normale Muster im Training vor, greife ich zu semiüberwachten Ansätzen wie One-Class SVM oder DBSCAN.
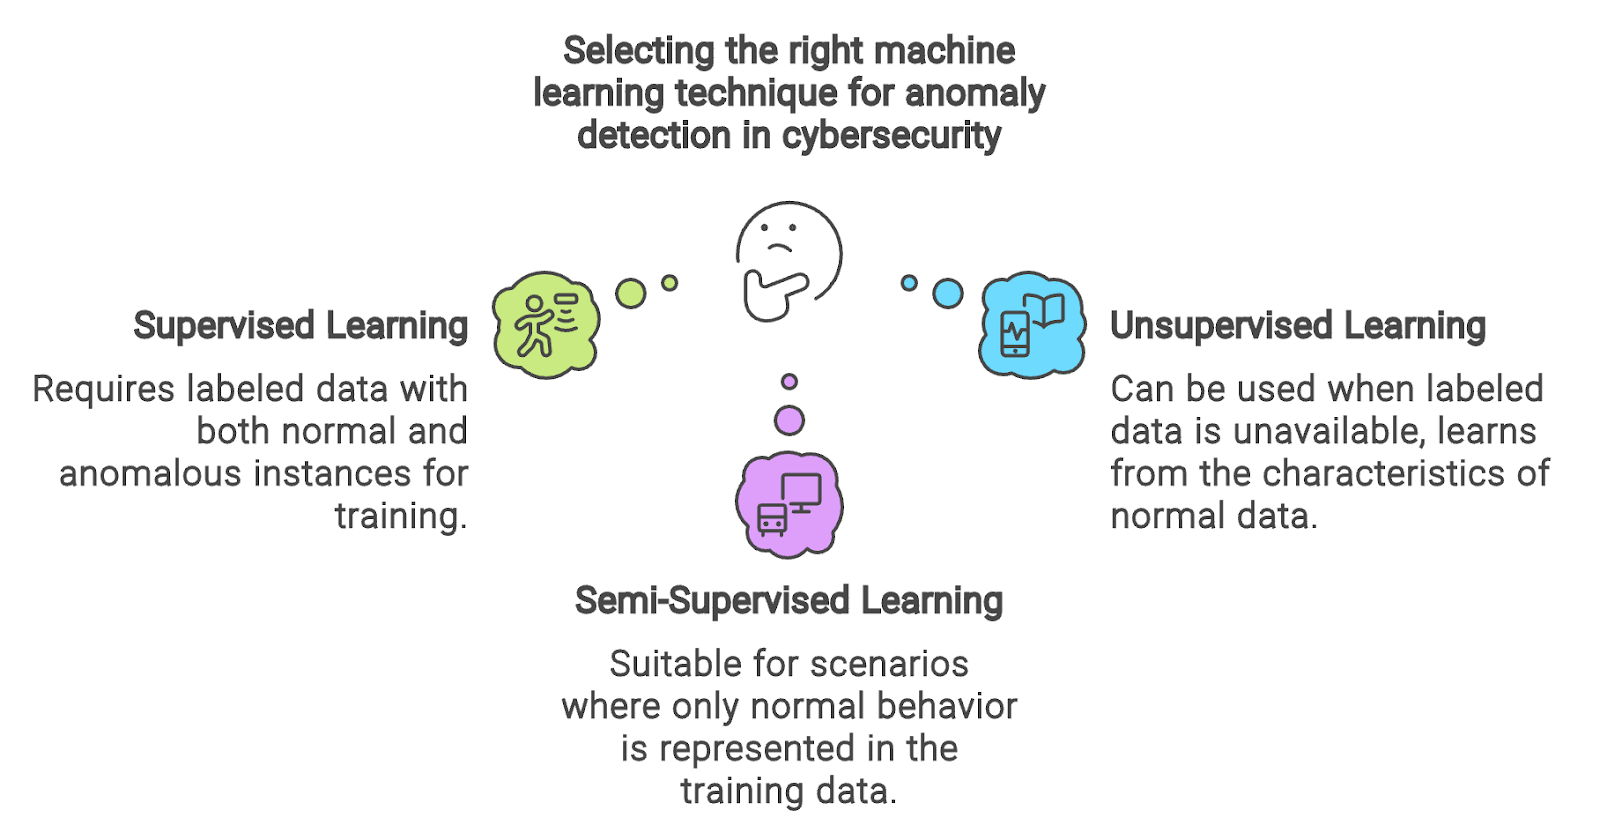
Diagramm erstellt mit Napkin.ai
Nachdem wir den Einsatz von ML bei hostbasierten IDS verstanden haben, wechseln wir zu netzwerkbasierten IDS. Während hostbasierte Systeme einzelne Maschinen betrachten, erkennen netzwerkbasierte IDS Eindringlinge in Netzwerkdaten. Statt Systemaufrufe zu analysieren, überwachen sie Netzwerkfluss-Statistiken, Nutzdaten und Paket-Header, um Datendiebstahl und Störungen aufzuspüren.
Ein kurzer Blick auf die folgende Tabelle zeigt, wie ein Datensatz für Netzwerkflüsse aussehen kann.
|
Zielport |
Quellport |
Flussdauer (ms) |
Pakete gesamt vorwärts |
Pakete gesamt rückwärts |
Label |
|
54865 |
9910 |
6 |
5000 |
600 |
0 |
|
54810 |
9010 |
2 |
2000 |
200 |
1 |
Synthetische Statistiken für normale und abnormale Netzwerkflüsse.
Jede Zeile steht für eine eigenständige Kommunikationssitzung zwischen zwei Endpunkten – ohne inhärente Beziehung zu anderen Flüssen im Datensatz.
Ein Fluss ist über Attribute definiert wie Quell- und Zielport, Flussdauer in Millisekunden und die Gesamtzahl ausgetauschter Pakete in beide Richtungen. Ein kategorisches Label gibt an, ob der Fluss als anomal oder als Angriff eingestuft ist – die nötige Ground Truth für Intrusion-Detection-Modelle.
Auffällig: Jede Zeile repräsentiert einen unabhängigen Netzwerkfluss ohne sequentielle oder relationale Abhängigkeiten zu anderen Flüssen im Datensatz.
Angesichts dieser Unabhängigkeit lässt sich der Datensatz – nach passender Feature-Engineering—direkt in ML-Algorithmen für Anomalieerkennung einspeisen. Wie bei hostbasierten IDS gilt: Die Wahl der Technik hängt vor allem von verfügbaren Labels ab.
Bevor wir in die Analyse einsteigen, klären wir kurz, was Malware ist und wie sie arbeitet.
Malware ist ein Sammelbegriff für bösartige Software oder Binärprogramme, die die Absichten von Angreifern umsetzen. Solcher Code nutzt gezielt Schwachstellen aus, um die Integrität zu kompromittieren, sensible Daten zu stehlen, Daten zu löschen oder für Lösegeld zu verschlüsseln. Kategorien sind u. a. Viren, Würmer, Spyware, Trojaner, Ransomware usw.
Um Typ, Funktionsweise und potenzielle Auswirkungen zu verstehen, extrahieren wir Merkmale aus statischer und dynamischer Analyse und speisen sie in passende ML-Algorithmen ein.
Bei Windows-Executables (Portable Executables, PEs) lassen sich vielfältige Features aus dynamischer und statischer Analyse gewinnen – etwa Bytesequenzen, APIs/Systemaufrufe, Opcodes, Netzwerk- und Dateisystemaktivitäten, CPU-Register, PE-Dateimerkmale und Strings – und anschließend in überwachte, unüberwachte oder semiüberwachte ML-Modelle zur Malware-Erkennung geben.
Um das Risiko von Cyberangriffen zu senken, müssen wir potenzielle Sicherheitslücken in Netzwerken, Rechnern und Anwendungen schnell identifizieren, bewerten und beheben. Schauen wir, wie KI und ML das Schwachstellenmanagement über Scans, Patch-Management und Risikobewertung verbessern.
Als Cybersicherheitsforscherin entwickle ich häufig eigene Tools zur Automatisierung – etwa Parser für Netzwerkprotokolle, Fuzzer und mehr.
So hilfreich diese Tools sind, müssen sie vor dem Einsatz und Teilen im Team gründlichen Schwachstellenscans unterzogen werden.
Andernfalls könnten Angreifer unentdeckte und ungepatchte Lücken in meinem Skript ausnutzen, sich unautorisierten Zugriff verschaffen, sensible Informationen kompromittieren oder Dienste stören.
ML-Modelle sehen sprichwörtlich den Wald vor lauter Bäumen: Sie extrahieren aus großen Datenmengen aussagekräftige Merkmale und entdecken subtile Muster und Korrelationen. Daher prüfe ich, inwieweit sie Schwachstellen automatisch aufspüren, schneller analysieren und bislang unbekannte Lücken identifizieren können.
Für ein ML-basiertes Schwachstellenerkennungsmodell sammle ich Trainingsdaten zu verwundbarem und nicht verwundbarem Code aus Quellen wie der NVD (National Vulnerability Database), OWASP u. a.
Die Sammlung wird vorverarbeitet und eingebettet, um sie dem gewählten Modell zuzuführen. Die Eingaben können als Graph oder Baum die Beziehungen zwischen Codeelementen zeigen, z. B. Code Property Graph (CPG) oder Abstract Syntax Trees (AST).
Alternativ ist eine tokenbasierte Darstellung möglich, bei der Quellcode in Token-Vektoren transformiert wird. Verschiedene Embedding-Techniken wie Word2Vec, Graph Embeddings, One-Hot-Encoding, N-Gramm-Features usw. können angewandt werden.
Wie bereits beschrieben, richtet sich die Modellauswahl primär nach verfügbaren Labels. Im Training wird der Datensatz in Trainings- und Validierungsteile getrennt und das Modell lernt aus gelabelten Daten.
Die Modellparameter werden iterativ anhand der Vorhersagefehler mittels Optimierungsverfahren angepasst. Nach Abschluss des Lernens wird die Erkennungsleistung an unbekannten Daten gemessen. Kennzahlen wie Accuracy, Precision, Recall und F1-Score bewerten die Fähigkeit zur Schwachstellenerkennung.
Werden in meinem Skript Schwachstellen entdeckt, ist eine fundierte Risikobewertung entscheidend. Verhindern vorhandene Sicherheitskontrollen eine Ausnutzung oder sind die Folgen gering, kann das Risiko akzeptiert werden.
Alternativ kann der Code auch ganz verworfen werden, um jede Ausnutzbarkeit auszuschließen. Ist das nicht praktikabel, sind wirksame Gegenmaßnahmen nötig.
Als Nächstes betrachten wir das Patchen verwundbarer Software als zentrale Maßnahme.
Alle offenen und kritischen Lücken zu schließen, wäre ideal – ist aber oft unrealistisch. Ein strategischer Ansatz ist gefragt. Mit ML können wir vorhersagen, welche Schwachstellen mit hoher Wahrscheinlichkeit für Sicherheitsvorfälle ausgenutzt werden. So priorisieren wir Patches gezielt.
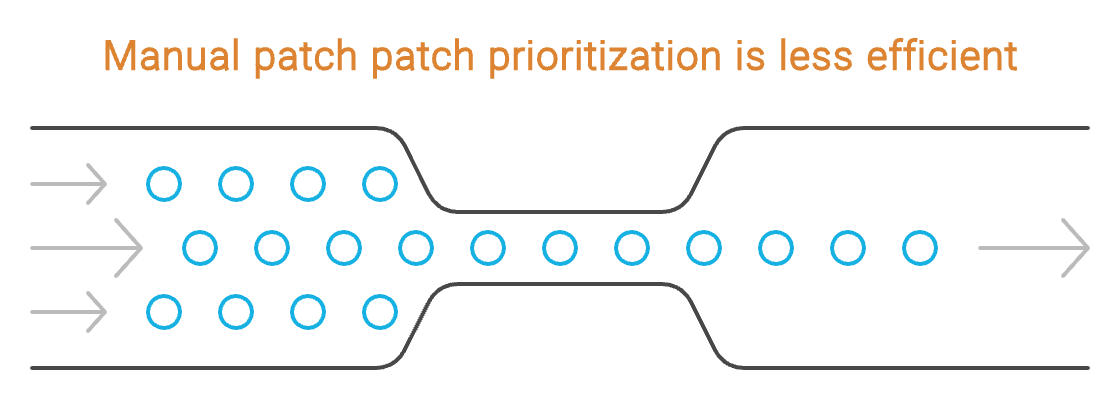
Erstellt mit Napkin.ai
Zur Optimierung der Patch-Priorisierung nutzen wir das baumgestützte, vortrainierte Exploit Prediction Scoring System (EPSS), das Schwachstelleninformationen mit realen Exploit-Aktivitäten kombiniert, um die Wahrscheinlichkeit eines Angriffs in den nächsten 30 Tagen zu prognostizieren.
Das EPSS-ML-Modell erkennt Muster und Beziehungen zwischen Informationen wie CVSS und realer Ausnutzung, um die Wahrscheinlichkeit eines Angriffs mathematisch zu bestimmen.
Nach der Priorisierung werden Patches sorgfältig bezogen, validiert und getestet, um Betriebsrisiken zu minimieren. Die Verteilung hängt von mehreren Faktoren ab, u. a.:
Angesichts der Größe und Vielfalt moderner IT-Landschaften ist manuelles Patchen arbeitsintensiv und langsam. KI-gestützte Automatisierung kann den Prozess verschlanken, indem sie je nach Faktoren intelligent die passenden Patches auswählt und verteilt.
Clustering-Algorithmen wie K-Means eignen sich, um ähnliche Systeme zu gruppieren und Patches effizienter auszurollen.
Die Bewertung von Cyberrisiken ist zentral, um potenzielle Bedrohungen und erkannte Schwachstellen zu identifizieren, zu bewerten und zu mitigieren.
Da traditionelle Ansätze unvorhersehbare Cyberrisiken oft nicht hinreichend erfassen, setzen Forschende zunehmend auf ML.
Mit überwachter, mehrklassiger Klassifikation verbessern sie die Risikobewertung durch eine umfassende Analyse zentraler Faktoren.
Wie in der folgenden Tabelle skizziert, zählen dazu Investitionen in Cybersicherheit, Belegschaftsmerkmale, Angriffshistorie, Infrastruktur-Schwachstellen, externe Beratung und das zugehörige Risiko. Ihr Proof-of-Concept-Framework SecRiskAI zeigt, wie ML die Wahrscheinlichkeit von DDoS- oder Phishing-Angriffen vorhersagen kann.
|
Information |
Beispiel |
|
Umsatz |
2.500.000 |
|
Investition in Cybersicherheit |
500.000 |
|
Erfolgreiche Angriffe |
5 |
|
Abgewehrte Angriffe |
10 |
|
Mitarbeitendenzahl |
4.450 |
|
Mitarbeitendentraining |
Mittel |
|
Bekannte Schwachstellen |
9 |
|
Externe Cybersecurity-Beratung |
Nein |
|
Risiko |
Niedrig |
Beispiel für Schlüsselfaktoren der Cyber-Risikobewertung (Quelle)
Werfen wir nun einen Blick darauf, wie KI und ML die Incident Response verändern: Sie automatisieren Workflows, verkürzen Reaktionszeiten, decken proaktiv versteckte Bedrohungen auf und verbessern die Forensik, um Ursprung und Auswirkungen von Angriffen nachzuvollziehen.
SOAR-Systeme nehmen Alerts aus SIEM-Lösungen entgegen und starten passende Playbooks, die eine Reihe von Sicherheitsaufgaben automatisiert koordinieren – das habe ich vielfach erlebt.
Diese Aufgaben reichen von Untersuchungen wie URL-Reputationsprüfungen oder dem Abruf von Nutzer- und Asset-Details bis zu Reaktionen wie dem Sperren einer IP am Firewall oder dem Beenden eines bösartigen Prozesses auf einem Endpunkt.
Doch es gibt klare Grenzen: Security-Analysten müssen Playbooks manuell definieren, erstellen und ändern, und die Auswahl zwischen Playbooks erfolgt regelbasiert durch die Analysten.
Die Integration von KI und ML in SOC-Plattformen kann das revolutionieren: Playbooks lassen sich automatisch generieren und
auf unbekannte Alerts abstimmen.
Das steigert die Effizienz und schafft Freiräume für wertschöpfende Aufgaben. Mit ML-Algorithmen lässt sich zudem die „Strafkosten“ jeder Reaktion je nach Alert berechnen und die Maßnahme mit den geringsten Kosten wählen.
Stell dir vor, du wühlst dich durch Millionen Logeinträge und suchst potenzielle Bedrohungen.
Skaliert man das auf Unternehmensebene, muss jeder einzelne Log geprüft und als bösartig oder unbedenklich klassifiziert werden – ein enormer Aufwand.
Mit ML wird es einfacher und schneller: KI- und ML-Modelle wie SVM oder Random Forest lassen sich trainieren, Logs effizient zu analysieren und zu kategorisieren – das beschleunigt die Erkennung und entlastet Teams.
Da digitale Daten immer umfangreicher und komplexer werden, ist die Integration von KI und ML in die digitale Forensik – die Analyse digitaler Beweismittel zur Aufklärung von Cyberkriminalität – essenziell.
So steigern wir Tempo, Genauigkeit und Wirksamkeit bei der Identifikation und Reaktion auf Bedrohungen.
Ein Beispiel ist das forensische Triage: ML-Algorithmen klassifizieren und kategorisieren große Mengen digitaler Dateien nach ihrer Relevanz für eine Untersuchung.
Die Integration von KI in die Cybersicherheit eröffnet große Chancen. Gleichzeitig müssen wir die inhärenten Hürden und Grenzen adressieren.
Viele KI-Systeme sind anfällig für Adversarial Attacks – etwa Poisoning, Evasion, Model Extraction, Prompt Injection und Inference – die gezielt Schwachstellen ausnutzen.
Dabei fügen Angreifer dem Input minimale, für Menschen kaum wahrnehmbare Störungen hinzu, die Modelle zu falschen Vorhersagen verleiten. Das ist sicherheitskritisch – auch in der Cybersicherheit.
Zur Abwehr nutzen wir Maßnahmen wie Adversarial Training, defensive Distillation und Gradient Masking.
Auch wenn KI-Algorithmen starke Ergebnisse liefern, bleibt ihr Innenleben oft schwer nachvollziehbar – ein Problem in meinem Fachgebiet, denn kritische Entscheidungen dürfen keine Blackbox sein.
Explainable AI (XAI) weist hier den Weg: mehr Erklärbarkeit bei hoher Performance. Mit Transparenz in der Entscheidungsfindung kann ich fundiert analysieren und passende Maßnahmen bei Sicherheitsvorfällen ergreifen.
Aktuelle XAI-Methoden – z. B. Feature-Importance-Analysen und Entscheidungsbaum-Visualisierungen – machen diese Transparenz zunehmend greifbar.
Wenn ich Datensätze für KI-basierte Sicherheitslösungen auswähle, achte ich darauf, dass sie nicht verzerrt sind. Andernfalls drohen unfaire oder diskriminierende Ergebnisse. Ich setze Datenvorverarbeitung ein, um Bias zu identifizieren und zu entfernen, und nutze Fairness-Metriken, um die Modellausgaben auf mögliche Verzerrungen zu prüfen.
Wenn du bis hierhin gelesen hast, hast du gesehen, wie KI und ML den Schutz von Rechnern, Mobilgeräten, Netzwerken und Anwendungen verändern – wie sie Teams stärken, Bedrohungen schneller erkennen und Security-Tools aufwerten.
Und das Spannende: Wir stehen erst am Anfang.
Die Zukunft der Cybersicherheit liegt in der Weiterentwicklung von KI und ML – insbesondere bei Large Language Models (LLMs). Dank größerer Kontextfenster, Codeverständnis und detaillierter Analysen skalieren diese Modelle die Malware-Analyse – schneller und präziser.
Ein Beispiel ist das Gemini-1.5-Modell, das bereits Malware in sehr großen Dateien erkennt. Auch ohne spezifisches Cybersecurity-Training lösen solche Modelle Aufgaben durch Prompt Engineering, In-Context Learning und Chain-of-Thought.
Ein weiterer Blick in die Zukunft ist das Finetuning offener LLMs wie Llama für Sicherheitsaufgaben – etwa Hackmentor.
Wir haben gesehen, wie KI- und ML-basierte Security-Tools der dynamischen, komplexen Bedrohungslage begegnen. Sie erkennen, reagieren und mitigieren Risiken – gezielt in Threat Detection, Schwachstellenmanagement und Incident Response.
Gleichzeitig müssen wir die Herausforderungen und ethischen Fragen bei Entwicklung und Einsatz KI-basierter Sicherheitslösungen im Blick behalten.
Trotz dieser Hürden verspricht der Fortschritt in KI und ML, unsere Abwehr gegenüber wachsenden Cyberbedrohungen nachhaltig zu stärken.
Erfahre mehr über Datensicherheit!
Kurs
Kurs
Kurs