इस लेख का मुख्य भाग लंबा लेकिन विस्तारपूर्ण है, इसलिए हम प्रस्तावना को यथासंभव छोटा रखेंगे और सीधे इस प्रश्न से शुरू करेंगे, “ग्रेडिएंट बूस्टिंग की परवाह क्यों करें?”
इसके कई ठोस कारण हैं:
- ग्रेडिएंट बूस्टिंग सर्वश्रेष्ठ है: सारणीबद्ध सुपरवाइज़्ड लर्निंग कार्यों के लिए इसकी शुद्धता और प्रदर्शन बेजोड़ हैं।
- ग्रेडिएंट बूस्टिंग अत्यंत बहुमुखी है: इसे रिग्रेशन, क्लासिफिकेशन, रैंकिंग और सर्वाइवल एनालिसिस जैसे कई महत्त्वपूर्ण कार्यों में उपयोग किया जा सकता है।
- ग्रेडिएंट बूस्टिंग व्याख्येय है: न्यूरल नेटवर्क जैसे ब्लैक-बॉक्स एल्गोरिद्म के विपरीत, ग्रेडिएंट बूस्टिंग प्रदर्शन के लिए व्याख्येयता का बलिदान नहीं करता। यह स्विस घड़ी की तरह काम करता है और फिर भी, धैर्य के साथ, आप एक स्कूली बच्चे को भी इसका तरीका सिखा सकते हैं।
- ग्रेडिएंट बूस्टिंग का श्रेष्ठ इम्प्लीमेंटेशन है: यह उन एल्गोरिद्म में से नहीं है जिनका व्यावहारिक मूल्य कम हो। Python में XGBoost और LightGBM जैसी अनेक ग्रेडिएंट बूस्टिंग लाइब्रेरीज़ लाखों उपयोगकर्ताओं द्वारा इस्तेमाल की जाती हैं।
- ग्रेडिएंट बूस्टिंग जीतता है: 2015 से, पेशेवरों ने Kaggle जैसी प्लेटफ़ॉर्म पर सारणीबद्ध प्रतियोगिताएँ लगातार जीतने के लिए इसका उपयोग किया है।
यदि इनमें से कोई भी बात आपको थोड़ी भी आकर्षक लगती है, तो इस लेख को आगे पढ़ना सार्थक है।
तो चलिए शुरू करते हैं!
आप इस ट्यूटोरियल में क्या सीखेंगे?
इस लेख का सबसे महत्त्वपूर्ण उद्देश्य है कि आप बिना अधिक गणितीय सिरदर्द के ग्रेडिएंट बूस्टिंग की अंदरूनी कार्यप्रणाली को मज़बूती से समझें। आखिरकार, ग्रेडिएंट बूस्टिंग का मक़सद व्यावहारिक उपयोग है, न कि गहन गणितीय विश्लेषण।
ग्रेडिएंट बूस्टिंग सामान्य रूप में क्या है?
बूस्टिंग मशीन लर्निंग में एक शक्तिशाली एन्सेम्बल तकनीक है। पारंपरिक मॉडलों के विपरीत जो एक-दूसरे से स्वतंत्र होकर सीखते हैं, बूस्टिंग कई कमजोर शिक्षार्थियों (weak learners) की भविष्यवाणियों को मिलाकर एक अधिक सटीक, मजबूत शिक्षार्थी बनाता है।
मैंने अभी कुछ नए शब्द इस्तेमाल किए हैं, तो चलिए हर एक को समझते हैं, शुरुआत कमजोर शिक्षार्थियों से।
कमजोर शिक्षार्थी वह मशीन लर्निंग मॉडल है जो यादृच्छिक अनुमान लगाने वाले मॉडल से थोड़ा बेहतर होता है। उदाहरण के लिए, मान लीजिए हम मशरूम को खाद्य और अखाद्य में वर्गीकृत कर रहे हैं। यदि एक यादृच्छिक अनुमानित मॉडल 40% सटीक है, तो कमजोर शिक्षार्थी बस उससे थोड़ा ऊपर होगा: 50-60%।
बूस्टिंग दर्जनों या सैकड़ों ऐसे कमजोर शिक्षार्थियों को मिलाकर एक मजबूत शिक्षार्थी बनाता है जो उसी समस्या पर 95% से अधिक सटीकता हासिल करने की क्षमता रखता है।
सबसे लोकप्रिय कमजोर शिक्षार्थी निर्णय वृक्ष (decision tree) है, जिसे लगभग किसी भी डेटासेट पर काम करने की क्षमता के कारण चुना जाता है। यदि आप निर्णय वृक्षों से परिचित नहीं हैं, तो यह DataCamp का Decision Tree Classification ट्यूटोरियल देखें।
ग्रेडिएंट बूस्टिंग के वास्तविक-जीवन उपयोग
ग्रेडिएंट बूस्टिंग मशीन लर्निंग में इतना प्रभावशाली बन गया है कि इसके उपयोग अब ग्राहक चर्न की भविष्यवाणी से लेकर क्षुद्रग्रहों का पता लगाने तक अनेक उद्योगों में फैले हुए हैं। यहां Kaggle में इसकी सफलता की झलक और वास्तविक उपयोग मामलों पर नज़र डालते हैं:
Kaggle प्रतियोगिताओं में दबदबा:
- Otto Group Product Classification Challenge: शीर्ष 10 सभी स्थानों ने ग्रेडिएंट बूस्टिंग के XGBoost इम्प्लीमेंटेशन का उपयोग किया।
- Santander Customer Transaction Prediction: ग्राहक व्यवहार और वित्तीय लेनदेन की भविष्यवाणी के लिए XGBoost-आधारित समाधानों ने फिर से शीर्ष स्थान सुरक्षित किए।
- Netflix Movie Recommendation Challenge: Netflix जैसी बहु-अरब कंपनियों के लिए सिफारिश प्रणालियाँ बनाने में ग्रेडिएंट बूस्टिंग ने अहम भूमिका निभाई।
व्यवसाय और उद्योग में रूपांतरण:
- रिटेल और ई-कॉमर्स: निजीकरण सिफारिशें, इन्वेंट्री प्रबंधन, धोखाधड़ी का पता लगाना
- वित्त और बीमा: क्रेडिट जोखिम आकलन, चर्न भविष्यवाणी, एल्गोरिथमिक ट्रेडिंग
- स्वास्थ्य सेवा और चिकित्सा: रोग निदान, दवा खोज, निजीकरण चिकित्सा
- सर्च और ऑनलाइन विज्ञापन: सर्च रैंकिंग, विज्ञापन लक्ष्यीकरण, क्लिक-थ्रू रेट भविष्यवाणी
तो, अब अंततः इस दिग्गज एल्गोरिद्म के अंदर झांकते हैं!
ग्रेडिएंट बूस्टिंग एल्गोरिद्म: चरण-दर-चरण मार्गदर्शन
इनपुट
ग्रेडिएंट बूस्टिंग एल्गोरिद्म सारणीबद्ध डेटा पर काम करता है जिसमें फीचर्स (X) का सेट और एक लक्ष्य (y) होता है। अन्य मशीन लर्निंग एल्गोरिद्म की तरह, उद्देश्य प्रशिक्षण डेटा से इतना सीखना है कि अनदेखे डेटा बिंदुओं पर भी अच्छी तरह सामान्यीकरण हो सके।
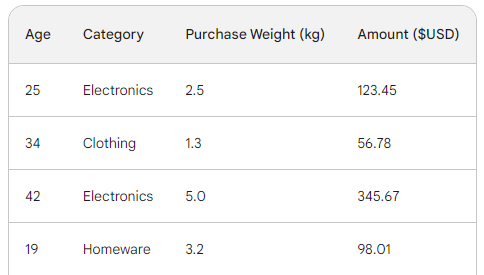
ग्रेडिएंट बूस्टिंग की अंतर्निहित प्रक्रिया को समझने के लिए, हम चार पंक्तियों वाले एक सरल बिक्री डेटासेट का उपयोग करेंगे। तीन फीचर्स— ग्राहक की आयु, खरीद श्रेणी और खरीद वज़न — का उपयोग करके, हम खरीद राशि की भविष्यवाणी करना चाहते हैं:
ग्रेडिएंट बूस्टिंग में लॉस फ़ंक्शन
मशीन लर्निंग में, लॉस फ़ंक्शन एक महत्वपूर्ण घटक है जो हमें मॉडल की भविष्यवाणियों और वास्तविक मानों के बीच अंतर को मापने देता है। सार में, यह बताता है कि मॉडल कैसा प्रदर्शन कर रहा है।
इसकी भूमिका का विवरण:
- त्रुटि की गणना: मॉडल के भविष्यवाणी किए गए आउटपुट को वास्तविक मानों (ग्राउंड ट्रुथ) से तुलना करता है। यह तुलना, यानी अंतर की गणना, अलग-अलग फ़ंक्शनों में भिन्न होती है।
- मॉडल प्रशिक्षण का मार्गदर्शन: किसी मॉडल का उद्देश्य लॉस फ़ंक्शन को न्यूनतम करना होता है। प्रशिक्षण के दौरान, मॉडल अपनी आंतरिक संरचना और विन्यास को लगातार अपडेट करता है ताकि लॉस जितना संभव हो उतना कम हो।
- मूल्यांकन मीट्रिक: प्रशिक्षण, मान्यकरण और परीक्षण डेटासेट पर लॉस की तुलना करके, आप अपने मॉडल की सामान्यीकरण क्षमता और ओवरफिटिंग से बचाव का आकलन कर सकते हैं।
दो सबसे आम लॉस फ़ंक्शन हैं:
- मीन स्क्वेयर्ड एरर (MSE): रिग्रेशन के लिए यह लोकप्रिय लॉस फ़ंक्शन पूर्वानुमानित और वास्तविक मानों के वर्गांतरों के योग को मापता है। ग्रेडिएंट बूस्टिंग अक्सर इसका यह रूप उपयोग करता है:
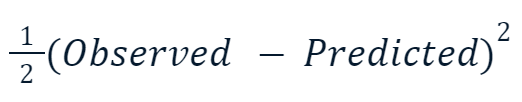
वर्गमान को एक-आध से गुणा करने का कारण अवकलन (differentiation) से जुड़ा है। जब हम इस लॉस फ़ंक्शन का अवकलज लेते हैं, तो पावर रूल के कारण एक-आध वर्ग के साथ कट जाता है। इसलिए अंतिम परिणाम बस -(Observed - Predicted) रह जाता है, जिससे गणित काफी आसान और संगणनात्मक रूप से कम महंगा हो जाता है।
- क्रॉस-एंट्रॉपी: यह फ़ंक्शन दो प्रायिकता वितरणों के बीच अंतर को मापता है। इसलिए, इसे आमतौर पर उन वर्गीकरण कार्यों में उपयोग किया जाता है जहां लक्ष्यों में विभेदित श्रेणियाँ होती हैं।
चूंकि हम रिग्रेशन कर रहे हैं, हम MSE का उपयोग करेंगे।
चरण 1: प्रारंभिक भविष्यवाणी करें
ग्रेडिएंट बूस्टिंग एक ऐसा एल्गोरिद्म है जो धीरे-धीरे अपनी सटीकता बढ़ाता है। प्रक्रिया शुरू करने के लिए हमें एक प्रारंभिक अनुमान या भविष्यवाणी चाहिए। प्रारंभिक अनुमान हमेशा लक्ष्य का औसत होता है। दूसरे शब्दों में, पहले राउंड में हमारा मॉडल यह भविष्यवाणी करता है कि सभी खरीदारी समान थीं — 156 डॉलर:

औसत चुनने का कारण हमारे चुने हुए लॉस फ़ंक्शन और उसके अवकलज से संबंधित है। हर चरण में, हम लॉस फ़ंक्शन का न्यूनतम खोजने के लिए एक मान ढूंढते हैं। यानी, हम ऐसा मान ढूंढ रहे हैं जो लॉस फ़ंक्शन के अवकलज (ग्रेडिएंट) को 0 बना दे।
और जब हम प्रत्येक अवलोकित मान के लिए भविष्यवाणी के सापेक्ष लॉस फ़ंक्शन का अवकलज लेते हैं और उन्हें जोड़ते हैं, तो हम लक्ष्य के औसत पर पहुंचते हैं।
तो, हमारी प्रारंभिक भविष्यवाणी औसत — 156 डॉलर है। इसे आगे के लिए स्मृति में रखें।
चरण 2: स्यूडो-रेज़िडुअल्स की गणना करें
अगला चरण है प्रत्येक अवलोकित मान और हमारी प्रारंभिक भविष्यवाणी के बीच अंतर निकालना: 156 - Observed। उदाहरण के लिए, हम इन अंतरों को एक नए कॉलम में रखेंगे:
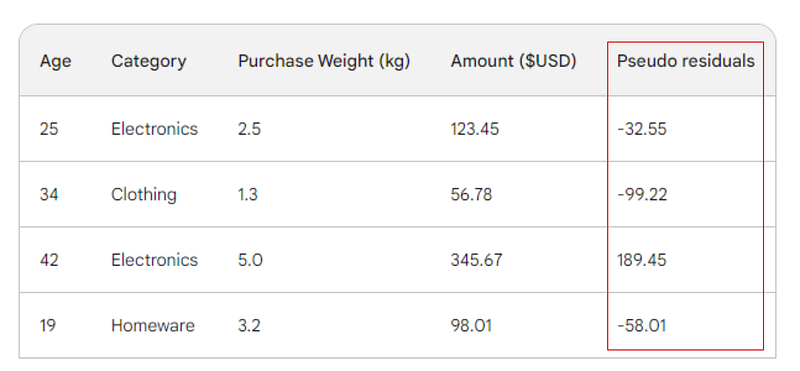
याद रखें कि रैखिक रिग्रेशन में, अवलोकित और पूर्वानुमानित मानों के बीच के अंतर को रेज़िडुअल्स कहते हैं। रैखिक रिग्रेशन और ग्रेडिएंट बूस्टिंग में अंतर करने के लिए, हम इन्हें स्यूडो-रेज़िडुअल्स कहते हैं (इसके अन्य कारण भी हैं, जिन पर हम इस लेख में नहीं जाएंगे)।
चरण 3: एक कमजोर शिक्षार्थी बनाएं
अगला, हम एक निर्णय वृक्ष (कमजोर शिक्षार्थी) बनाएंगे जो तीन फीचर्स (आयु, श्रेणी, खरीद वज़न) का उपयोग करके रेज़िडुअल्स की भविष्यवाणी करेगा। इस समस्या के लिए, हम निर्णय वृक्ष को सिर्फ चार पत्तियों (टर्मिनल नोड्स) तक सीमित रखेंगे, लेकिन व्यवहार में, लोग आमतौर पर 8 से 32 पत्तियाँ चुनते हैं।
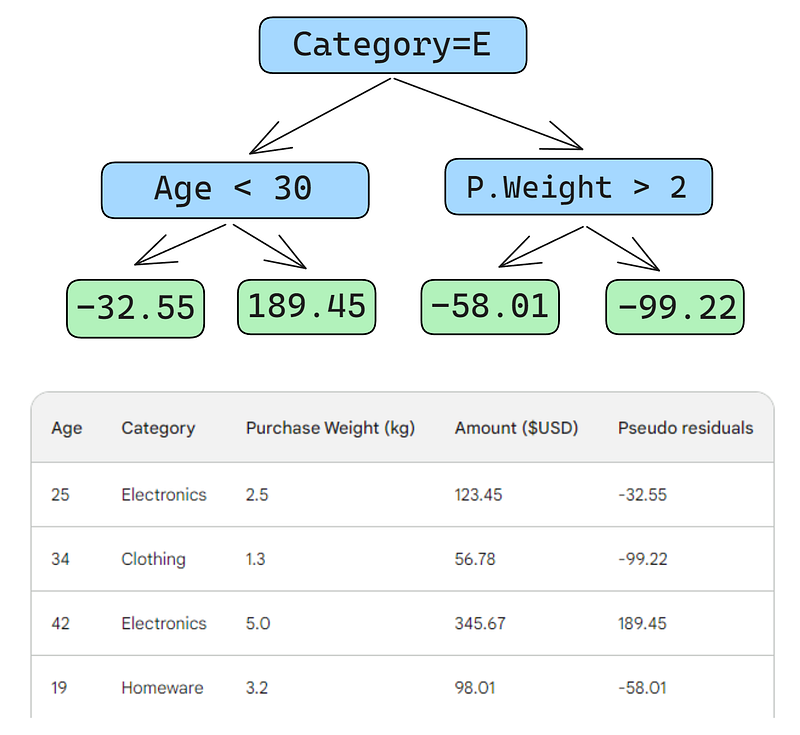
डेटा पर वृक्ष फिट हो जाने के बाद, हम डेटा की प्रत्येक पंक्ति के लिए भविष्यवाणी बनाते हैं। पहली पंक्ति के लिए ऐसा कैसे करें, यह यहां है:
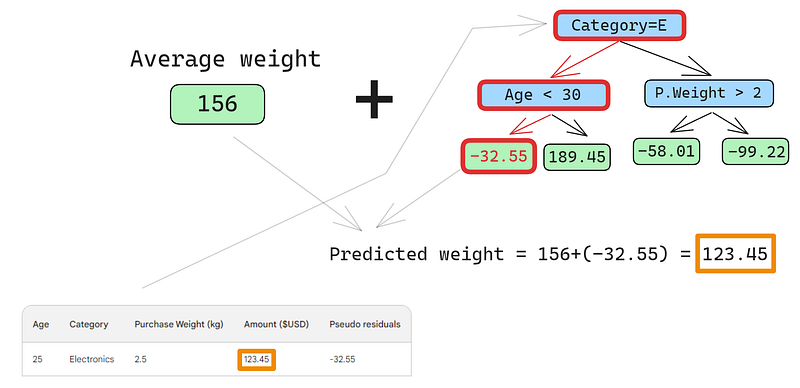
नीचे दी गई छवियों में एक छोटा त्रुटि: "Predicted weight" की जगह "Predicted purchase amount" लिखा होना चाहिए था
पहली पंक्ति में निम्न फीचर्स हैं: इलेक्ट्रॉनिक्स श्रेणी (रूट नोड के बाएँ) और ग्राहक आयु 30 से कम (चाइल्ड नोड के बाएँ)। इससे पत्ती नोड में -32.55 आता है। अंतिम भविष्यवाणी करने के लिए, हम -32.55 को अपनी पहली भविष्यवाणी में जोड़ते हैं, जो कि ठीक-ठीक अवलोकित मान के बराबर है — 123.45 डॉलर!
हमने अभी एक परफेक्ट भविष्यवाणी कर दी, तो और वृक्ष क्यों बनाएं? दरअसल, फिलहाल हम प्रशिक्षण डेटा पर भारी ओवरफिटिंग कर रहे हैं। हम चाहते हैं कि मॉडल सामान्यीकरण करे। इस समस्या को कम करने के लिए, ग्रेडिएंट बूस्टिंग में एक पैरामीटर होता है जिसे लर्निंग रेट कहते हैं।
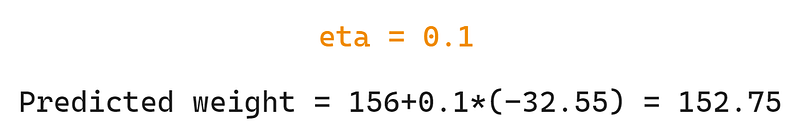
ग्रेडिएंट बूस्टिंग में लर्निंग रेट 0 और 1 के बीच का एक गुणक होता है जो प्रत्येक कमजोर शिक्षार्थी की भविष्यवाणी को स्केल करता है (लर्निंग रेट पर विवरण नीचे देखें)। जब हम 0.1 का एक मनमाना लर्निंग रेट जोड़ते हैं, तो हमारी भविष्यवाणी 123.45 की परफेक्ट वैल्यू के बजाय 152.75 बन जाती है।
आइए दूसरी पंक्ति पर भी भविष्यवाणी करते हैं:
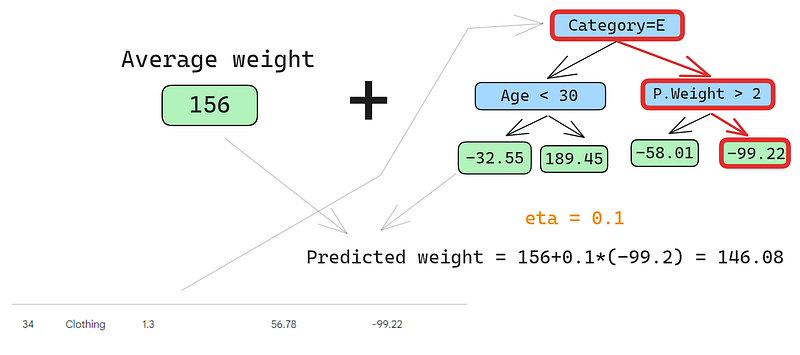
हम पंक्ति को वृक्ष से गुजारते हैं और 146.08 की भविष्यवाणी प्राप्त करते हैं। हम इसी तरह सभी पंक्तियों के लिए आगे बढ़ते हैं, जब तक कि चारों पंक्तियों के लिए चार भविष्यवाणियाँ न मिल जाएं: 152.75, 146.08, 174.945, 150.2। फिलहाल इन्हें एक नए कॉलम के रूप में जोड़ते हैं:
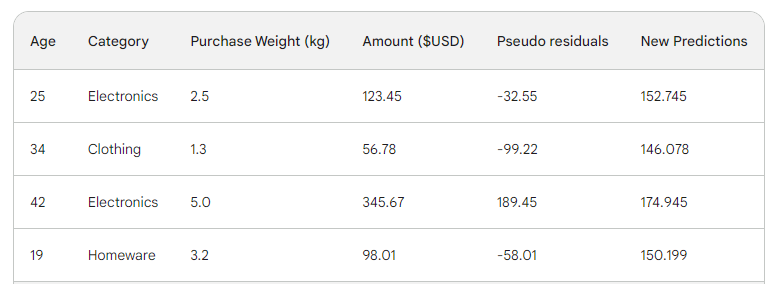
अगला, हम नई भविष्यवाणियों को खरीद राशि से घटाकर नए स्यूडो-रेज़िडुअल्स निकालते हैं। इन्हें तालिका में एक नए कॉलम के रूप में जोड़ते हैं और आखिरी दो को हटा देते हैं:
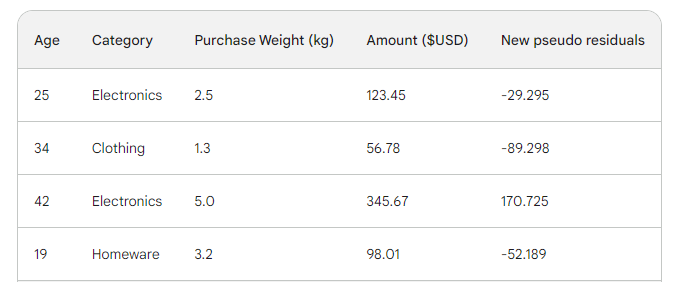
जैसा कि आप देख सकते हैं, हमारे नए स्यूडो रेज़िडुअल्स छोटे हैं, जिसका अर्थ है कि हमारा लॉस कम हो रहा है।
चरण 4: दोहराव
अगले चरणों में, हम चरण 3 को दोहराते हैं, यानी और अधिक कमजोर शिक्षार्थी बनाते हैं। केवल यह ध्यान रखना है कि प्रत्येक वृक्ष के रेज़िडुअल्स को प्रारंभिक भविष्यवाणी में जोड़ते रहना है ताकि अगली भविष्यवाणी बने।
उदाहरण के लिए, यदि हम 10 वृक्ष बनाते हैं और प्रत्येक वृक्ष के रेज़िडुअल्स r_i (1 <= i <= 10) से निरूपित हों, तो दसवें राउंड में अगली भविष्यवाणी p_10 = 156 + eta * (r_1 + r_2 + ... + r_10) बन जाएगी, जहां p_10 दसवें राउंड की भविष्यवाणी को दर्शाता है।
व्यवहार में, पेशेवर अक्सर 10 नहीं, 100 वृक्षों से शुरू करते हैं। इस स्थिति में, कहा जाता है कि एल्गोरिद्म 100 बूस्टिंग राउंड्स तक प्रशिक्षित हुआ।
यदि आपको अपने विशिष्ट समस्या के लिए आवश्यक वृक्षों की सटीक संख्या नहीं पता, तो आप अर्ली स्टॉपिंग नामक एक सरल तकनीक का उपयोग कर सकते हैं।
अर्ली स्टॉपिंग में, हम वृक्षों की एक बड़ी संख्या चुनते हैं, जैसे 1000 या 10000। फिर, एल्गोरिद्म के उन सभी वृक्षों को पूरा बनाने का इंतज़ार करने के बजाय, हम लॉस की निगरानी करते हैं। यदि लॉस कुछ निश्चित बूस्टिंग राउंड्स, जैसे 50, तक बेहतर नहीं होता, तो हम प्रशिक्षण को पहले ही रोक देते हैं, समय और संसाधन बचाते हैं।
ग्रेडिएंट बूस्टिंग मॉडलों का विन्यास
मशीन लर्निंग में किसी मॉडल की सेटिंग्स चुनने को "हाइपरपैरामीटर ट्यूनिंग" कहते हैं। ये सेटिंग्स, जिन्हें "हाइपरपैरामीटर" कहा जाता है, वे विकल्प हैं जिन्हें मशीन लर्निंग इंजीनियर को स्वयं चुनना होता है। अन्य पैरामीटरों के विपरीत, मॉडल केवल डेटा पर प्रशिक्षित होकर हाइपरपैरामीटर के सर्वोत्तम मान नहीं सीख सकता।
ग्रेडिएंट बूस्टिंग मॉडलों में कई हाइपरपैरामीटर होते हैं, जिनमें से कुछ का वर्णन मैं नीचे कर रहा हूँ।
उद्देश्य (Objective)
यह पैरामीटर एल्गोरिद्म की दिशा और लॉस फ़ंक्शन निर्धारित करता है। यदि उद्देश्य रिग्रेशन है, तो लॉस फ़ंक्शन के रूप में MSE चुना जाता है, जबकि क्लासिफिकेशन के लिए क्रॉस-एंट्रॉपी उपयुक्त है। Python लाइब्रेरीज़ जैसे XGBoost अन्य प्रकार के कार्यों के लिए रैंकिंग जैसे उद्देश्यों और उनके अनुरूप लॉस फ़ंक्शन भी प्रदान करती हैं।
लर्निंग रेट
ग्रेडिएंट बूस्टिंग का शायद सबसे महत्त्वपूर्ण हाइपरपैरामीटर लर्निंग रेट है। यह श्रिंकेंज फ़ैक्टर को समायोजित करके प्रत्येक कमजोर शिक्षार्थी के योगदान को नियंत्रित करता है। छोटे मान (0 की ओर) एन्सेम्बल में प्रत्येक कमजोर शिक्षार्थी के प्रभाव को कम करते हैं। इसके लिए अधिक वृक्ष बनाने पड़ते हैं और इस प्रकार प्रशिक्षण पूरा करने में अधिक समय लगता है। लेकिन अंतिम मजबूत शिक्षार्थी वास्तव में अधिक मज़बूत और ओवरफिटिंग के प्रति प्रतिरोधी होगा।
वृक्षों की संख्या
इस पैरामीटर को बूस्टिंग राउंड्स की संख्या या n_es timators भी कहते हैं, जो बनाए जाने वाले वृक्षों की संख्या नियंत्रित करता है। जितने अधिक वृक्ष आप बनाते हैं, एन्सेम्बल उतना ही अधिक मज़बूत और प्रदर्शनकारी बनता है। यह अधिक जटिल भी हो जाता है क्योंकि अधिक वृक्ष मॉडल को डेटा में और अधिक पैटर्न पकड़ने देते हैं। हालांकि, अधिक वृक्ष ओवरफिटिंग की संभावनाओं को काफी बढ़ा देते हैं। इसे कम करने के लिए, अर्ली स्टॉपिंग और कम लर्निंग रेट का संयोजन अपनाएँ।
अधिकतम गहराई (Max depth)
यह पैरामीटर प्रत्येक कमजोर शिक्षार्थी (निर्णय वृक्ष) के स्तरों की संख्या नियंत्रित करता है। अधिकतम गहराई 3 का मतलब है कि वृक्ष में तीन स्तर हैं, पत्ती स्तर सहित। वृक्ष जितना गहरा होगा, मॉडल उतना अधिक जटिल और संगणनात्मक रूप से महंगा होगा। ओवरफिटिंग से बचने के लिए 3 के आस-पास का मान चुनें। आपकी अधिकतम सीमा 10 की गहराई होनी चाहिए।
प्रति पत्ती न्यूनतम नमूने
यह पैरामीटर निर्णय वृक्षों में शाखाओं के विभाजन को नियंत्रित करता है। टर्मिनेशन नोड्स (पत्तियों) में नमूनों की संख्या के लिए कम मान रखने से संपूर्ण एल्गोरिद्म शोर के प्रति संवेदनशील हो जाता है। अधिक न्यूनतम नमूनों की संख्या वृक्षों के लिए बहुत कम डेटा बिंदुओं के आधार पर विभाजन बनाना कठिन बनाकर ओवरफिटिंग को रोकने में मदद करती है।
सबसैंपलिंग दर
यह पैरामीटर प्रत्येक वृक्ष को प्रशिक्षित करने के लिए उपयोग किए जाने वाले डेटा के अनुपात को नियंत्रित करता है। ऊपर दिए गए उदाहरणों में, हमने 100% पंक्तियों का उपयोग किया क्योंकि हमारे डेटासेट में केवल चार पंक्तियाँ थीं। लेकिन वास्तविक दुनिया के डेटासेट आमतौर पर कहीं अधिक बड़े होते हैं और सैंपलिंग की आवश्यकता होती है। इसलिए, यदि आप सबसैंपलिंग दर 1 से कम, जैसे 0.7 रखते हैं, तो प्रत्येक कमजोर शिक्षार्थी यादृच्छिक रूप से चुनी गई 70% पंक्तियों पर प्रशिक्षित होता है। छोटी सबसैंपल दर प्रशिक्षण को तेज कर सकती है लेकिन ओवरफिटिंग भी बढ़ा सकती है।
फीचर सैंपलिंग दर
यह पैरामीटर सबसैंपलिंग जैसा ही है, लेकिन यह पंक्तियों के बजाय फीचर्स का सैंपलिंग करता है। सैकड़ों फीचर्स वाले डेटासेट के लिए, ओवरफिटिंग की संभावना कम करने हेतु 0.5 और 1 के बीच की फीचर सैंपलिंग दर की सिफारिश की जाती है।
ग्रेडिएंट बूस्टिंग सारणीबद्ध सुपरवाइज़्ड लर्निंग कार्यों के लिए हमारे पास सबसे सक्षम मॉडल है। इसलिए, अधिकतर समय आपको इस बात की चिंता नहीं करनी होती कि यह किसी कार्य के लिए पर्याप्त अच्छा नहीं है। जब आप ग्रेडिएंट बूस्टिंग का उपयोग करते हैं, तो आपका समय प्रायः इसे रेग्युलराइज़ करने— इसकी शक्ति को वश में करने — में लगता है ताकि यह आपके डेटासेट को निगल न जाए और अनदेखे डेटा पर बेकार न हो जाए।
मैंने जिन हाइपरपैरामीटरों का परिचय कराया है, वे सभी इसी काम में आपकी मदद करते हैं और Python में ग्रेडिएंट बूस्टिंग के हर इम्प्लीमेंटेशन में शामिल होते हैं। इनका सही उपयोग करें।
Python में ग्रेडिएंट बूस्टिंग का इम्प्लीमेंटेशन
जैसा कि मैंने पहले उल्लेख किया, Python लाइब्रेरीज़ में ग्रेडिएंट बूस्टिंग अच्छी तरह स्थापित है। यहां मुख्य चार हैं:
- XGBoost: eXtreme Gradient Boosting
- LightGBM: Light Gradient Boosting Machine
- CatBoost: Categorical Boosting
- Scikit-learn: रिग्रेशन और क्लासिफिकेशन के लिए दो एस्टिमेटर हैं
पहली तीन लाइब्रेरीज़ एक-दूसरे से मिलती-जुलती हैं:
- उत्कृष्ट प्रदर्शन
- GPU-समर्थन
- हाइपरपैरामीटर का समृद्ध सेट (कन्फ़िगरेशन-अनुकूल)
- बहुत उच्च समुदाय समर्थन
- उद्योग में व्यापक उपयोग
इन तीनों लाइब्रेरीज़ का एक लोकप्रिय विकल्प Scikit-learn है, जिसकी कमी यह है कि यह केवल CPU पर चलती है। चूँकि ग्रेडिएंट बूस्टिंग संगणनात्मक रूप से भारी एल्गोरिद्म है, बड़े डेटासेट (हम सैकड़ों हज़ार पंक्तियों की बात कर रहे हैं) पर इसे CPU पर चलाना व्यवहार्य नहीं हो सकता।
हालाँकि, हमें यह याद रखना चाहिए कि Scikit-learn अपने आप में इन तीनों लाइब्रेरीज़ से अधिक लोकप्रिय है। क्लासिफिकेशन और रिग्रेशन के लिए दो ग्रेडिएंट बूस्टिंग एस्टिमेटर के अलावा, Scikit-learn असुपरवाइज़्ड और सुपरवाइज़्ड लर्निंग के असंख्य कार्यों के लिए दर्जनों अन्य मॉडल प्रदान करता है।
इसके अलावा, Scikit-learn से बने ग्रेडिएंट बूस्टिंग मॉडल्स को इसके समृद्ध इकोसिस्टम जैसे पाइपलाइन्स, क्रॉस-वैलिडेशन एस्टिमेटर, डेटा प्रोसेसर आदि में एकीकृत किया जा सकता है।
यहां GradientBoostingClassifier के साथ क्लासिफिकेशन करने की चरण-दर-चरण गाइड है। हम हीरों की कीमत और अन्य भौतिक मापों के आधार पर उनके कट क्वालिटी की भविष्यवाणी करेंगे। यह डेटासेट Seaborn लाइब्रेरी में अंतर्निहित है।
प्रो टिप: DataCamp कोड स्निपेट्स एडिटर के “Explain code” बटन का उपयोग करके पंक्ति-दर-पंक्ति विस्तृत व्याख्या प्राप्त करें।
1. लाइब्रेरीज़ इम्पोर्ट करें
import pandas as pd
import seaborn as sns
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.metrics import classification_report
from sklearn.model_selection import cross_val_score, train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler
2. डेटा लोड करें
# Load the diamonds dataset from Seaborn
diamonds = sns.load_dataset("diamonds")

# Split data into features and target
X = diamonds.drop("cut", axis=1)
y = diamonds["cut"]
3. डेटा विभाजित करें
# Split data into train and test sets
X_train, X_test, y_train, y_test = train_test_split(
   X, y, test_size=0.2, random_state=42
)
4. श्रेणीबद्ध और संख्यात्मक फीचर्स परिभाषित करें
# Define categorical and numerical features
categorical_features = X.select_dtypes(
   include=["object"]
).columns.tolist()

numerical_features = X.select_dtypes(
   include=["float64", "int64"]
).columns.tolist()
5. श्रेणीबद्ध और संख्यात्मक फीचर्स के लिए प्रीप्रोसेसिंग चरण परिभाषित करें
preprocessor = ColumnTransformer(
   transformers=[
       ("cat", OneHotEncoder(), categorical_features),
       ("num", StandardScaler(), numerical_features),
   ]
)
6. ग्रेडिएंट बूस्टिंग क्लासिफायर पाइपलाइन बनाएं
pipeline = Pipeline(
   [
       ("preprocessor", preprocessor),
       ("classifier", GradientBoostingClassifier(random_state=42)),
   ]
)
7. CV और प्रशिक्षण
# Perform 5-fold cross-validation
cv_scores = cross_val_score(pipeline, X_train, y_train, cv=5)

# Fit the model on the training data
pipeline.fit(X_train, y_train)

# Predict on the test set
y_pred = pipeline.predict(X_test)

# Generate classification report
report = classification_report(y_test, y_pred)
8. अंतिम परिणाम रिपोर्ट करें
print(f"Mean Cross-Validation Accuracy: {cv_scores.mean():.4f}")
print("\nClassification Report:")
print(report)

Mean Cross-Validation Accuracy: 0.7621

Classification Report:
             precision    recall  f1-score   support

       Fair       0.90      0.91      0.91       335
       Good       0.81      0.63      0.71      1004
      Ideal       0.82      0.91      0.86      4292
    Premium       0.70      0.86      0.77      2775
  Very Good       0.66      0.41      0.51      2382

   accuracy                           0.76     10788
  macro avg       0.78      0.74      0.75     10788
weighted avg       0.75      0.76      0.75     10788
वेटेड सटीकता 75% है, जो डिफ़ॉल्ट पैरामीटर वाले बेसलाइन मॉडल के लिए बुरा नहीं है। तो, एक चुनौती के रूप में, मैं इसे आपके लिए छोड़ता हूँ कि आप GradientBoostingClassifier के हाइपरपैरामीटर ट्यून करके 95% से अधिक प्रदर्शन हासिल करें। हाँ, यह संभव है! (संकेत: आखिरी अनुभाग ध्यान से पढ़ें और क्लासिफायर के लिए Scikit-learn दस्तावेज़ देखें)।
निष्कर्ष और आगे की सीख
हालाँकि हमने बहुत कुछ सीखा, इस लेख का मुख्य ध्यान ग्रेडिएंट बूस्टिंग एल्गोरिद्म की अंदरूनी कार्यप्रणाली पर था। यह समझना कि यह कैसे काम करता है, अपने-आप में इसे व्यवहार में अच्छी तरह उपयोग करने में परिवर्तित नहीं होता। फिर भी, सहज समझ हमेशा बहुत मददगार होती है।
आगे की सीख के लिए, मैं निम्न संसाधनों की सिफारिश करता हूँ:
- DataCamp द्वारा XGBoost के साथ ग्रेडिएंट बूस्टिंग का उपयोग: Google पर XGBoost पर #1 रैंक वाला लेख
- Extreme Gradient Boosting With XGBoost कोर्स: XGBoost पर एक व्यापक कोर्स
पढ़ने के लिए धन्यवाद!
