

न्यूरल नेटवर्क्स का परिचय
न्यूरल नेटवर्क्स या सिम्युलेटेड न्यूरल नेटवर्क्स मशीन लर्निंग का एक उपसमूह हैं, जो मानव मस्तिष्क से प्रेरित हैं। ये इस बात की नकल करते हैं कि जैविक न्यूरॉन्स आपस में कैसे संवाद करते हैं और निर्णय तक पहुँचते हैं।
एक न्यूरल नेटवर्क में इनपुट लेयर, हिडन लेयर और आउटपुट लेयर होती है। पहली लेयर कच्चा इनपुट प्राप्त करती है, उसे कई हिडन लेयर्स द्वारा प्रोसेस किया जाता है, और आखिरी लेयर परिणाम देती है।
नीचे के उदाहरण में, हमने टैब्युलर डेटा को वर्गीकृत करने के लिए न्यूरल नेटवर्क्स के प्रशिक्षण प्रक्रिया का सिम्युलेशन किया है। हमारे पास X1 और X2 पैरामीटर हैं जिन्हें 4 और 2 न्यूरॉन्स वाली 2 हिडन लेयर्स से गुजारा जाता है ताकि आउटपुट मिले। कई बार के इटरेशन के साथ, मॉडल लक्ष्य वर्गों को बेहतर ढंग से पहचानना सीखता जाता है।

चित्र बनाया गया TF Playground के साथ
डीप लर्निंग एल्गोरिद्म या डीप न्यूरल नेटवर्क्स में कई हिडन लेयर्स और नोड्स होते हैं। “डीप” से तात्पर्य न्यूरल नेटवर्क की गहराई से है। इनका उपयोग सामान्यतः जटिल समस्याओं जैसे इमेज क्लासिफिकेशन, स्पीच रिकग्निशन और टेक्स्ट जेनरेशन के लिए किया जाता है।
हमारे Deep Learning Tutorial को पढ़कर न्यूरल नेटवर्क्स के बारे में अधिक जानें। आप सीखेंगे कि सटीक परिणाम देने के लिए Activation Function, Loss Function और Backpropagation कैसे काम करते हैं।
न्यूरल नेटवर्क्स के प्रकार
एडवांस्ड मशीन-लर्निंग अनुप्रयोगों के लिए कई प्रकार के न्यूरल नेटवर्क्स उपयोग होते हैं। एक ही मॉडल आर्किटेक्चर सभी पर लागू नहीं होता। न्यूरल नेटवर्क का सबसे पुराना प्रकार Perceptron कहलाता है, जिसे Frank Rosenblatt ने 1958 में बनाया था।
इस सेक्शन में, हम टेक इंडस्ट्री में उपयोग होने वाले 5 सबसे लोकप्रिय न्यूरल नेटवर्क प्रकारों को कवर करेंगे।
फीडफॉरवर्ड न्यूरल नेटवर्क्स
फीडफॉरवर्ड न्यूरल नेटवर्क्स में इनपुट लेयर, हिडन लेयर्स और आउटपुट लेयर शामिल होती हैं। इसे फीडफॉरवर्ड इसलिए कहते हैं क्योंकि डेटा आगे की दिशा में बहता है और बैकप्रोपेगेशन नहीं होता। इसका उपयोग मुख्यतः क्लासिफिकेशन, स्पीच रिकग्निशन, फेस रिकग्निशन और पैटर्न रिकग्निशन में होता है।
मल्टी-लेयर परसेप्ट्रॉन
मल्टी-लेयर परसेप्ट्रॉन्स (MLPs) फीडफॉरवर्ड न्यूरल नेटवर्क की कमी—बैकप्रोपेगेशन से न सीख पाने—को दूर करते हैं। यह बिडायरेक्शनल होते हैं और इनमें कई हिडन लेयर्स और एक्टिवेशन फंक्शंस होते हैं। MLPs इनपुट्स के लिए फॉरवर्ड प्रोपेगेशन और वेट्स को अपडेट करने के लिए बैकप्रोपेगेशन का उपयोग करते हैं। ये बुनियादी न्यूरल नेटवर्क्स हैं जिन्होंने कंप्यूटर विज़न, भाषा प्रौद्योगिकी और अन्य न्यूरल नेटवर्क्स की नींव रखी है।
नोट: वास्तविक दुनिया की समस्याएँ नॉन-लीनियर होती हैं, इसलिए MLPs में परसेप्ट्रॉन नहीं बल्कि सिग्मॉइड न्यूरॉन्स होते हैं।
कन्वोल्यूशनल न्यूरल नेटवर्क्स (CNNs)
कन्वोल्यूशनल न्यूरल नेटवर्क्स (CNN) का उपयोग सामान्यतः कंप्यूटर विज़न, इमेज रिकग्निशन और पैटर्न रिकग्निशन में होता है। यह कई कन्वोल्यूशनल लेयर्स की मदद से इमेज से महत्वपूर्ण फीचर्स निकालने के लिए इस्तेमाल होता है। CNN की कन्वोल्यूशनल लेयर एक कस्टम मैट्रिक्स (फिल्टर) का उपयोग करके इमेज पर कॉन्वॉल्व करती है और मैप बनाती है।
आमतौर पर कन्वोल्यूशनल न्यूरल नेटवर्क्स में इनपुट लेयर, कन्वोल्यूशन लेयर, पूलिंग लेयर, फुली कनेक्टेड लेयर और आउटपुट लेयर होती है। CNN कैसे काम करता है, यह जानने के लिए हमारा Python Convolutional Neural Networks (CNN) with TensorFlow ट्यूटोरियल पढ़ें।
रिकरेंट न्यूरल नेटवर्क्स (RNNs)
रिकरेंट न्यूरल नेटवर्क्स (RNNs) का उपयोग आम तौर पर अनुक्रमिक डेटा के लिए होता है, जैसे टेक्स्ट, इमेज सीक्वेंसेज़ और टाइम सीरीज़। ये फीड-फॉरवर्ड नेटवर्क्स जैसे ही होते हैं, सिवाय इसके कि ये फीडबैक लूप के जरिए पिछले अनुक्रमों से इनपुट लेते हैं। RNNs का उपयोग NLP, बिक्री पूर्वानुमान और मौसम पूर्वानुमान में किया जाता है।
RNNs में वैनिशिंग ग्रेडिएंट की समस्या आती है, जिसे RNNs के उन्नत संस्करणों—Long Short-Term Memory Networks (LSTMs) और Gated Recurrent Unit Networks (GRUs)—द्वारा हल किया जाता है। LSTMs और GRUs के बारे में अधिक जानने के लिए Recurrent Neural Network Tutorial (RNN) पढ़ें।
R में न्यूरल नेटवर्क्स का इम्प्लीमेंटेशन
हम लोकप्रिय R पैकेज neuralnet और Keras के साथ न्यूरल नेटवर्क्स बनाना सीखेंगे।
पहले उदाहरण में, हम बहुत कम प्रयास में एक सरल न्यूरल नेटवर्क बनाएँगे, और दूसरे उदाहरण में, हम Keras पैकेज का उपयोग करके अधिक उन्नत समस्या हल करेंगे।
आइए आवश्यक लाइब्रेरी और डिपेंडेंसी डाउनलोड करके R वातावरण सेट करें।
install.packages(c('neuralnet','keras','tensorflow'),dependencies = T)R में सरल न्यूरल नेटवर्क का इम्प्लीमेंटेशन
इस पहले उदाहरण में, हम बिल्ट-इन R डेटा iris का उपयोग करेंगे और एक सरल न्यूरल नेटवर्क से मल्टी-क्लासिफिकेशन समस्या हल करेंगे।
हम डेटा मैनिपुलेशन और मॉडल प्रशिक्षण के लिए आवश्यक R पैकेज आयात करके शुरू करेंगे।
library(tidyverse)
library(neuralnet)डेटा विश्लेषण
आप R कंसोल में `iris` टाइप करके और रन करके डेटा देख सकते हैं। डेटा को ट्रेन करने से पहले, हमें character प्रकार के कॉलम्स को factors में बदलना होगा।
नोट: हम उदाहरण चलाने के लिए DataCamp R workspace का उपयोग कर रहे हैं।
iris <- iris %>% mutate_if(is.character, as.factor)`summary` फ़ंक्शन का उपयोग सांख्यिकीय विश्लेषण और डेटा वितरण के लिए किया जाता है।
summary(iris)जैसा कि हम देख सकते हैं, हमारे पास बैलेंस्ड डेटा है। सभी तीन लक्ष्य वर्गों में 50-50 सैंपल हैं।
Sepal.Length Sepal.Width Petal.Length Petal.Width
Min. :4.300 Min. :2.000 Min. :1.000 Min. :0.100
1st Qu.:5.100 1st Qu.:2.800 1st Qu.:1.600 1st Qu.:0.300
Median :5.800 Median :3.000 Median :4.350 Median :1.300
Mean :5.843 Mean :3.057 Mean :3.758 Mean :1.199
3rd Qu.:6.400 3rd Qu.:3.300 3rd Qu.:5.100 3rd Qu.:1.800
Max. :7.900 Max. :4.400 Max. :6.900 Max. :2.500
Species
setosa :50
versicolor:50
virginica :50 ट्रेन और टेस्ट विभाजन
हम पुनरुत्पादनशीलता के लिए सीड सेट करेंगे और मॉडल प्रशिक्षण व मूल्यांकन के लिए डेटा को ट्रेन और टेस्ट डेटासेट्स में बाँटेंगे। हम 80:20 का विभाजन करेंगे।
set.seed(245)
data_rows <- floor(0.80 * nrow(iris))
train_indices <- sample(c(1:nrow(iris)), data_rows)
train_data <- iris[train_indices,]
test_data <- iris[-train_indices,]न्यूरल नेटवर्क का प्रशिक्षण
neuralnet पैकेज पुराना है, लेकिन R समुदाय में अभी भी लोकप्रिय है।
`neuralnet` फ़ंक्शन सरल है। यह हमें पूरी तरह से कस्टमाइज़ेबल मॉडल आर्किटेक्चर बनाने की स्वतंत्रता नहीं देता।
हमारे मामले में, हम इसे GLM की तरह एक मशीन-लर्निंग फ़ॉर्मूला और डेटा दे रहे हैं। फ़ॉर्मूला में लक्ष्य वेरिएबल्स और फीचर्स शामिल हैं।
इसके बाद, हम दो हिडन लेयर्स बनाते हैं—पहली में चार न्यूरॉन्स और दूसरी में दो न्यूरॉन्स।
model = neuralnet(
Species~Sepal.Length+Sepal.Width+Petal.Length+Petal.Width,
data=train_data,
hidden=c(4,2),
linear.output = FALSE
)मॉडल आर्किटेक्चर देखने के लिए हम `plot` फ़ंक्शन का उपयोग करेंगे। इसे मॉडल ऑब्जेक्ट और `rep` आर्ग्युमेंट की आवश्यकता होती है।
plot(model,rep = "best")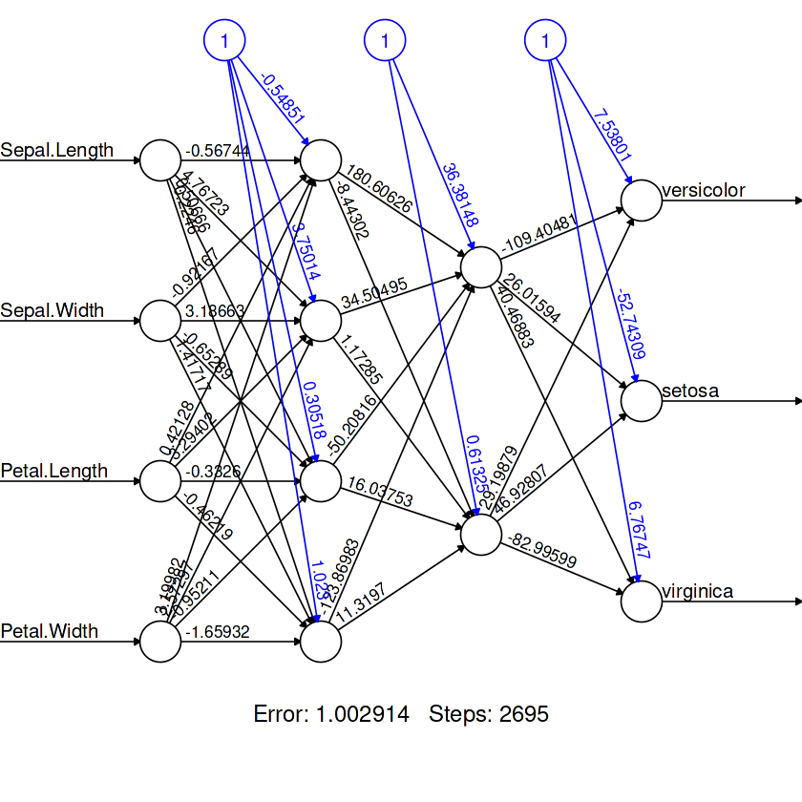
मॉडल मूल्यांकन
कन्फ्यूजन मैट्रिक्स के लिए:
- हम टेस्ट डेटासेट का उपयोग करके श्रेणियों की भविष्यवाणी करेंगे।
- श्रेणी नामों की एक सूची बनाएँ।
- एक प्रेडिक्शन डेटा फ्रेम बनाएँ और संख्यात्मक आउटपुट्स को लेबल्स से बदलें।
- ‘actual’ और ‘predicted’ मानों को साथ में दिखाने के लिए टेबल्स का उपयोग करें।
pred <- predict(model, test_data)
labels <- c("setosa", "versicolor", "virginca")
prediction_label <- data.frame(max.col(pred)) %>%
mutate(pred=labels[max.col.pred.]) %>%
select(2) %>%
unlist()
table(test_data$Species, prediction_label)हमें लगभग परफेक्ट परिणाम मिले। लगता है कि हमारे मॉडल ने तीन सैंपल्स को गलत वर्गीकृत किया। प्रत्येक लेयर में और अधिक न्यूरॉन्स जोड़कर हम परिणाम में सुधार कर सकते हैं।
prediction_label
setosa versicolor virginica
setosa 8 0 0
versicolor 0 13 0
virginica 0 3 6 एक्युरेसी जाँचने के लिए, हमें पहले वास्तविक श्रेणीमानों को संख्यात्मक मानों में बदलना होगा और उन्हें प्रेडिक्टेड मानों से तुलना करनी होगी। परिणामस्वरूप, हमें बूलियन मानों की सूची मिलेगी।
हम `sum` फ़ंक्शन का उपयोग करके `TRUE` मानों की संख्या निकाल सकते हैं और उसे कुल सैंपल्स की संख्या से भाग देकर एक्युरेसी प्राप्त कर सकते हैं।
check = as.numeric(test_data$Species) == max.col(pred)
accuracy = (sum(check)/nrow(test_data))*100
print(accuracy)मॉडल ने 90% एक्युरेसी के साथ मानों की भविष्यवाणी की है।
90नोट: इस उदाहरण का कोड स्रोत R workspace पर उपलब्ध है: Building Neural Network (NN) Models in R।
Keras के साथ R में कन्वोल्यूशनल न्यूरल नेटवर्क
इस उदाहरण में, हम Keras और TensorFlow का उपयोग इमेज क्लासिफिकेशन कार्य हेतु कन्वोल्यूशनल न्यूरल नेटवर्क मॉडल बनाने और प्रशिक्षित करने के लिए करेंगे। इसके लिए, हम cifar10 इमेज डेटासेट का उपयोग करेंगे, जिसमें 60,000 32x32 रंगीन छवियाँ हैं, जिन्हें दस श्रेणियों में लेबल किया गया है।
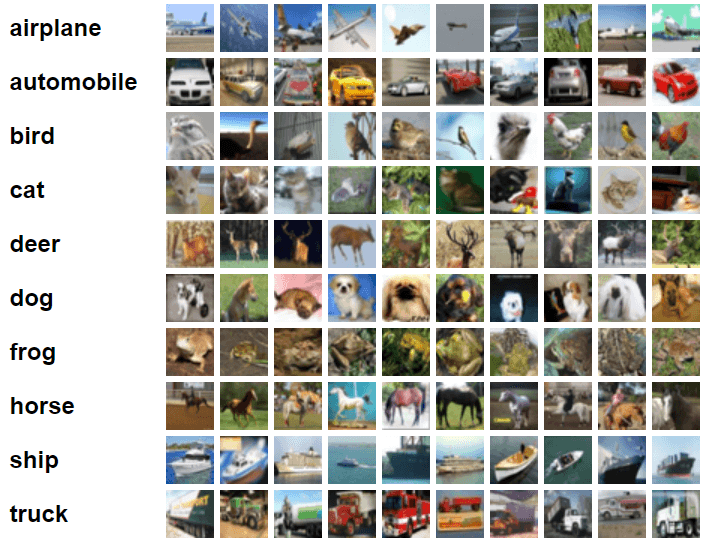
चित्र स्रोत CIFAR-10
आवश्यक R पैकेज इम्पोर्ट करें।
library(keras)
library(tensorflow)डेटा तैयार करना
हम Keras का बिल्ट-इन डेटासेट इम्पोर्ट करेंगे और उसे ट्रेन और टेस्ट सेट्स में बाँटेंगे।
c(c(x_train, y_train), c(x_test, y_test)) %<-% dataset_cifar10()डेटा को नॉर्मलाइज़ करने के लिए ट्रेन और टेस्ट फीचर्स को 255 से भाग दें।
x_train <- x_train / 255
x_test <- x_test / 255मॉडल बनाना
Keras API हमें पूरी तरह से कस्टमाइज़ेबल, जटिल न्यूरल नेटवर्क आर्किटेक्चर बनाने की लचीलापन देती है।
हमारे मामले में, हम कई कन्वोल्यूशन लेयर्स बनाएँगे, जिनके बाद मैक्स पूलिंग लेयर, ड्रॉपआउट लेयर, डेंस लेयर और आउटपुट लेयर होगी।
हम सभी लेयर्स के लिए ‘Leaky ReLU’ को एक्टिवेशन फंक्शन के रूप में, और केवल आउटपुट लेयर के लिए ‘softmax’ का उपयोग कर रहे हैं।
हमें पहली 2D कन्वोल्यूशनल लेयर के इनपुट शेप को ट्रेनिंग डेटासेट की इमेज शेप (32,32,3) पर सेट करना होगा।
model <- keras_model_sequential()%>%
# Start with a hidden 2D convolutional layer
layer_conv_2d(
filter = 16, kernel_size = c(3,3), padding = "same",
input_shape = c(32, 32, 3), activation = 'leaky_relu'
) %>%
# 2nd hidden layer
layer_conv_2d(filter = 32, kernel_size = c(3,3), activation = 'leaky_relu') %>%
# Use max pooling
layer_max_pooling_2d(pool_size = c(2,2)) %>%
layer_dropout(0.25) %>%
# 3rd and 4th hidden 2D convolutional layers
layer_conv_2d(filter = 32, kernel_size = c(3,3), padding = "same", activation = 'leaky_relu') %>%
layer_conv_2d(filter = 64, kernel_size = c(3,3), activation = 'leaky_relu') %>%
# Use max pooling
layer_max_pooling_2d(pool_size = c(2,2)) %>%
layer_dropout(0.25) %>%
# Flatten max filtered output into feature vector
# and feed into dense layer
layer_flatten() %>%
layer_dense(256, activation = 'leaky_relu') %>%
layer_dropout(0.5) %>%
# Outputs from dense layer
layer_dense(10, activation = 'softmax')मॉडल आर्किटेक्चर देखने के लिए, हम `summary` फ़ंक्शन का उपयोग करेंगे।
summary(model)हमारे पास दो कन्वोल्यूशनल लेयर्स हैं, जिनके बाद एक मैक्स पूलिंग लेयर है, फिर दो और कन्वोल्यूशनल लेयर्स, एक मैक्स पूलिंग लेयर, एक फ्लैटन लेयर जो मैक्स-फिल्टर्ड आउटपुट को वेक्टर्स में बदलती है, और फिर दो डेंस लेयर्स हैं।
Model: "sequential"
________________________________________________________________________________
Layer (type) Output Shape Param #
================================================================================
conv2d_3 (Conv2D) (None, 32, 32, 16) 448
________________________________________________________________________________
conv2d_2 (Conv2D) (None, 30, 30, 32) 4640
________________________________________________________________________________
max_pooling2d_1 (MaxPooling2D) (None, 15, 15, 32) 0
________________________________________________________________________________
dropout_2 (Dropout) (None, 15, 15, 32) 0
________________________________________________________________________________
conv2d_1 (Conv2D) (None, 15, 15, 32) 9248
________________________________________________________________________________
conv2d (Conv2D) (None, 13, 13, 64) 18496
________________________________________________________________________________
max_pooling2d (MaxPooling2D) (None, 6, 6, 64) 0
________________________________________________________________________________
dropout_1 (Dropout) (None, 6, 6, 64) 0
________________________________________________________________________________
flatten (Flatten) (None, 2304) 0
________________________________________________________________________________
dense_1 (Dense) (None, 256) 590080
________________________________________________________________________________
dropout (Dropout) (None, 256) 0
________________________________________________________________________________
dense (Dense) (None, 10) 2570
================================================================================
Total params: 625,482
Trainable params: 625,482
Non-trainable params: 0
________________________________________________________________________________मॉडल को कम्पाइल करना
- हम शेड्यूल एक्स्पोनेंशियल डिके फ़ंक्शन से लर्निंग रेट सेट करेंगे। यह 1500 स्टेप्स के बाद लर्निंग रेट को 0.98 से घटाता है।
- लर्निंग रेट ऑब्जेक्ट को Adamax ऑप्टिमाइज़र में फीड करें।
- हमारा लॉस फ़ंक्शन sparse categorical cross-entropy होगा।
- लॉस और ऑप्टिमाइज़र फ़ंक्शन तथा परफॉर्मेंस मेट्रिक का उपयोग करके मॉडल को कम्पाइल करें।
learning_rate <- learning_rate_schedule_exponential_decay(
initial_learning_rate = 5e-3,
decay_rate = 0.96,
decay_steps = 1500,
staircase = TRUE
)
opt <- optimizer_adamax(learning_rate = learning_rate)
loss <- loss_sparse_categorical_crossentropy(from_logits = TRUE)
model %>% compile(
loss = loss,
optimizer = opt,
metrics = "accuracy"
)मॉडल को ट्रेन करना
हम अपने मॉडल को फिट करेंगे और मूल्यांकन मेट्रिक को `history` में स्टोर करेंगे।
- हम 10 epochs के लिए मॉडल ट्रेन करेंगे और batch size 32 सेट करेंगे।
- वैलिडेशन के लिए टेस्ट डेटासेट जोड़ना।
- `shuffle` आर्ग्युमेंट प्रत्येक epoch की शुरुआत में ट्रेनिंग डेटा को शफल करेगा।
history <- model %>% fit(
x_train, y_train,
batch_size = 32,
epochs = 10,
validation_data = list(x_test, y_test),
shuffle = TRUE
)मॉडल का मूल्यांकन
आप `evaluate` फ़ंक्शन का उपयोग करके टेस्ट डेटासेट पर मॉडल का मूल्यांकन कर सकते हैं, और यह फ़ाइनल लॉस और एक्युरेसी लौटाएगा।
model %>% evaluate(x_test, y_test)मॉडल को 50 epochs पर पुनः प्रशिक्षण देने से एक्युरेसी बेहतर होगी।
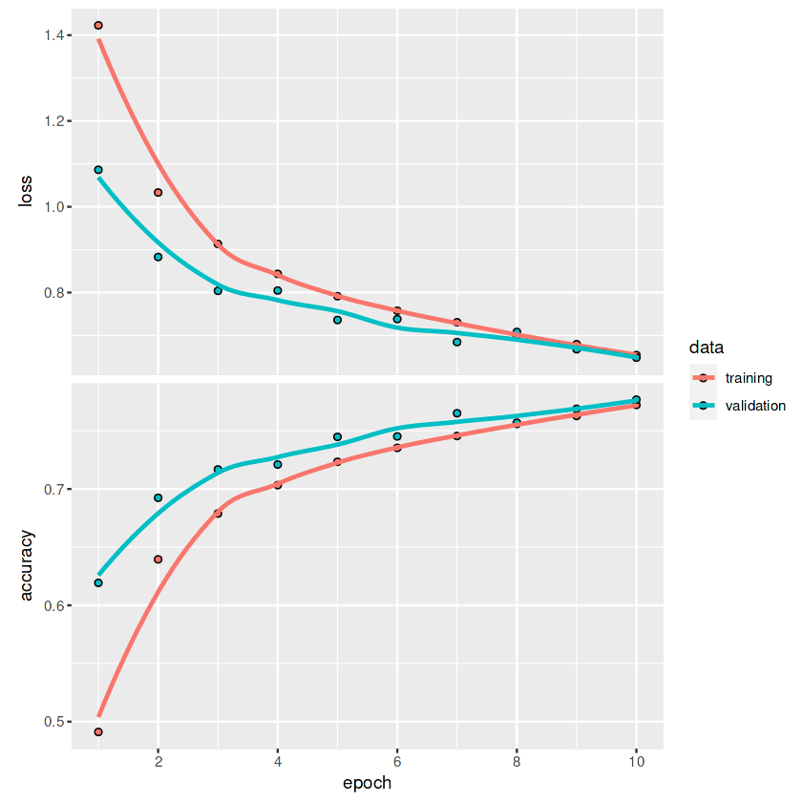
Loss 0.648191571235657 Accuracy 0.776799976825714हर epoch के लिए लॉस और एक्युरेसी की लाइन ग्राफ़ प्लॉट करने हेतु हम `plot` फ़ंक्शन का उपयोग करेंगे।
plot(history)ग्राफ़ देखकर हम देख सकते हैं कि रेखा अभी सपाट नहीं हुई है। इसका अर्थ है कि अधिक epochs के साथ हम मॉडल मेट्रिक्स में सुधार कर सकते हैं।
यदि आप Keras API के बारे में और सीखना चाहते हैं और इसे डीप न्यूरल नेटवर्क बनाने में कैसे उपयोग किया जा सकता है, तो keras: Deep Learning in R ट्यूटोरियल देखें।
न्यूरल नेटवर्क्स के अनुप्रयोग
मोबाइल एप्लिकेशंस से लेकर इंजीनियरिंग तक, वास्तविक जीवन में न्यूरल नेटवर्क्स के उदाहरण हर जगह मिलते हैं। भाषा और बड़े विज़ुअल मॉडलों में हालिया उछाल के कारण, अधिक कंपनियाँ मुनाफ़ा और ग्राहक संतुष्टि बढ़ाने के लिए डीप न्यूरल नेटवर्क्स को अपनाने में रुचि ले रही हैं।
इस सेक्शन में, हम उन शीर्ष 10 अनुप्रयोगों के बारे में जानेंगे जो आधुनिक दुनिया को आकार दे रहे हैं।
1. टैब्युलर प्रेडिक्शन
सरल न्यूरल नेटवर्क्स बड़े टैब्युलर डेटा पर काफ़ी प्रभावी होते हैं। इन्हें क्लासिफिकेशन, क्लस्टरिंग और रिग्रेशन समस्याओं में उपयोग किया जा सकता है।
2. स्टॉक प्राइस फोरकास्टिंग
कई कंपनियाँ वित्तीय पूर्वानुमान के लिए LSTM, GRU और RNN का उपयोग कर रही हैं। यह उन्हें बेहतर निर्णय लेने में मदद करता है।
3. मेडिकल इमेजिंग
स्तन कैंसर का पता लगाना, विसंगति पहचान और इमेज सेगमेंटेशन—ये कन्वोल्यूशनल न्यूरल नेटवर्क्स के कुछ अनुप्रयोग हैं। प्री-ट्रेंड ट्रांसफॉर्मर्स के कारण रोग-निवारण और घातक बीमारियों का जल्द पता लगाने में उन्नत शोध देखने को मिला है।
4. ई-कॉमर्स
प्रोडक्ट रिकमेंडेशंस, पर्सनलाइज़्ड अनुभव और चैटबॉट्स—ये ई-कॉमर्स में न्यूरल नेटवर्क्स के कुछ उपयोग हैं। ये मॉडल मुख्यतः क्लस्टरिंग, नैचुरल लैंग्वेज प्रोसेसिंग और कंप्यूटर विज़न के लिए उपयोग होते हैं ताकि प्लेटफ़ॉर्म पर ग्राहकों का अनुभव बेहतर हो सके।
5. जेनरेटिव इमेज
DALL·E 2 और Stable Diffusion की लोकप्रियता के कारण यह क्षेत्र मुख्यधारा में आ गया है। Canva और Adobe जैसी कंपनियाँ पहले ही जेनरेटिव इमेज क्षमता लागू कर चुकी हैं ताकि उपयोगकर्ताओं की संख्या बढ़े। मुख्यधारा के हाइप से इतर, जेनरेटिव इमेज का उपयोग हर उद्योग में सिंथेटिक डेटा बनाने के लिए होता है, जिससे मॉडल के प्रदर्शन, स्थिरता और बायस में सुधार हो सके।
6. जेनरेटिव टेक्स्ट
ChatGPT, GPT-3, और GPT-NEO इस क्षेत्र पर हावी डीप न्यूरल नेटवर्क मॉडल हैं। इनका उपयोग प्रोग्रामिंग सहायता, चैटबॉट्स, अनुवाद, प्रश्न/उत्तर, आदि के लिए होता है। यह हर जगह मौजूद हैं और कंपनियों को इन्हें अपने मौजूदा सिस्टम्स में एकीकृत करना आसान लग रहा है।
7. कस्टमर सर्विस चैट बॉट
DailoGPT और Blenderbot लोकप्रिय संवादात्मक मॉडल हैं जो आपके चैटबॉट अनुभव को बेहतर बनाते हैं। ये अनुकूली हैं और किसी विशिष्ट उद्देश्य हेतु फाइन-ट्यून किए जा सकते हैं। भविष्य में, लंबा इंतज़ार नहीं दिखेगा; ये चैटबॉट्स आपकी समस्याएँ समझकर रीयल-टाइम में समाधान प्रदान कर पाएँगे।
8. रोबोटिक्स
रिइन्फोर्समेंट लर्निंग और कंप्यूटर विज़न आधारित न्यूरल नेटवर्क मॉडल्स उद्योगों के रूपांतरण में बड़ी भूमिका निभा रहे हैं। उदाहरण के लिए, पूर्णतः स्वचालित वेयरहाउस प्रबंधन, फैक्ट्रियाँ और शॉपिंग अनुभव।
9. स्पीच रिकग्निशन
स्पीच रिकग्निशन, टेक्स्ट-टू-स्पीच और ऑडियो एक्टिविटी डिटेक्शन जैसे न्यूरल नेटवर्क मॉडल्स का उपयोग स्पीच असिस्टेंस, स्वचालित ट्रांसक्रिप्शन और उन्नत संचार अनुप्रयोगों में होता है।
10. मल्टीमॉडल
टेक्स्ट टू इमेज (DALLE-2), इमेज टेक्स्ट, विज़ुअल क्वेश्चन आंसरिंग और फीचर एक्सट्रैक्शंस—ये मल्टीमॉडल न्यूरल नेटवर्क्स में उपयोग होने वाले कुछ अनुप्रयोग हैं। भविष्य में, आप टेक्स्ट-टू-वीडियो विद ऑडियो देखेंगे। आप केवल स्क्रिप्ट देकर पूरी फ़िल्म बना पाएँगे।
निष्कर्ष
Keras और TensorFlow के R पैकेज हमें विशिष्ट कार्यों के लिए जटिल मॉडल आर्किटेक्चर बनाने हेतु संपूर्ण टूलकिट प्रदान करते हैं। आप कुछ पंक्तियों के कोड में डेटासेट लोड कर सकते हैं, प्री-प्रोसेसिंग कर सकते हैं, मॉडल बना और ऑप्टिमाइज़ कर सकते हैं, और मॉडल का मूल्यांकन कर सकते हैं। इसके अलावा, TensorFlow के साथ आप अपने प्रयोगों की निगरानी, GPUs कॉन्फ़िगर और मॉडल को प्रोडक्शन में डिप्लॉय कर सकते हैं।
इस ट्यूटोरियल में, हमने न्यूरल नेटवर्क्स की बुनियाद, मॉडल आर्किटेक्चर के प्रकार और उनके अनुप्रयोगों के बारे में जाना। साथ ही, हमने `neuralnet` का उपयोग करके एक सरल न्यूरल नेटवर्क और `keras` का उपयोग करके एक कन्वोल्यूशनल न्यूरल नेटवर्क ट्रेन करना सीखा। ट्यूटोरियल में मॉडल बिल्डिंग, कम्पाइलिंग, ट्रेनिंग और इवैल्यूएशन शामिल हैं।
Introduction to TensorFlow in R कोर्स करके TensorFlow और Keras API के बारे में और जानें। आप TensorBoard और अन्य TensorFlow APIs के बारे में सीखेंगे, डीप न्यूरल नेटवर्क्स बनाएँगे, और रेग्युलराइज़ेशन, ड्रॉपआउट और हाइपरपैरामीटर ऑप्टिमाइज़ेशन का उपयोग करके मॉडल प्रदर्शन में सुधार करेंगे।