
Kursus
Analisis Klaster di Python
4 jam
65.9K
Dalam machine learning, ada dua teknik yang tersedia untuk memisahkan objek ke dalam kelompok yang berbeda: klasifikasi dan klasterisasi. Hal ini sering menimbulkan banyak kebingungan di kalangan praktisi awal.
Sekilas, klasifikasi dan klasterisasi tampak serupa. Keduanya menggunakan algoritme yang memanfaatkan fitur dari suatu dataset untuk menemukan pola dan memisahkan instance ke dalam kelompok yang berbeda. Namun dari sudut pandang praktis, keduanya cukup berbeda.
Pada artikel ini, kita akan membahas masing-masing teknik, berbagai algoritme yang terkait, penerapannya, dan yang terpenting, bagaimana perbedaannya.
Tugas klasifikasi termasuk dalam kategori masalah yang disebut "pembelajaran terawasi" (supervised learning). Masalah seperti ini melibatkan pengembangan model yang belajar dari data historis untuk membuat prediksi pada instance baru.
Secara lebih formal, tugas pembelajaran terawasi adalah masalah di mana suatu fungsi dipelajari untuk memetakan masukan ke keluaran berdasarkan pasangan contoh input-output. Dengan demikian, tujuannya adalah mendekati fungsi pemetaan (f) dari masukan (X) ke keluaran (y) — jika Anda berlatar belakang matematika, Anda mungkin mengenalnya sebagai masalah pendekatan fungsi.
Perlu dicatat bahwa pembelajaran terawasi hadir dalam dua bentuk: regresi dan klasifikasi.
Dalam masalah klasifikasi, tujuan algoritme pembelajaran adalah mendekati fungsi pemetaan dari sekumpulan fitur untuk memprediksi keluaran diskret (misalnya, memprediksi apakah gambar adalah kucing atau anjing) — lihat tutorial Memahami klasifikasi teks di Python kami untuk demonstrasi praktik.
Ada beberapa masalah yang melibatkan penerapan algoritme klasifikasi, seperti:
Mari kita lihat beberapa algoritme klasifikasi.
Sering kali, orang keliru mengira regresi logistik sebagai algoritme regresi, dan itu dapat dipahami. Secara teknis, mereka tidak salah. Regresi logistik tidak melakukan klasifikasi statistik. Yang dilakukannya adalah mengestimasi parameter dari model logistik.
Alasan kita dapat menggunakan regresi logistik untuk klasifikasi adalah adanya batas keputusan yang disisipkan untuk memisahkan kelas. Jadi, dalam bentuk paling sederhana, regresi logistik menggunakan fungsi logistik untuk memodelkan variabel dependen biner.
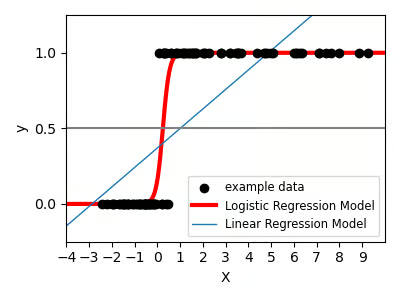
Sumber: Logistic Function by Scikit-Learn
KNN adalah salah satu algoritme machine learning yang paling sederhana dan berbeda dari regresi logistik karena dapat digunakan untuk tugas klasifikasi dan regresi.
Lebih tepatnya, ini adalah algoritme non-parametrik dan lazy learning. Artinya, KNN tidak membuat asumsi tentang karakteristik sampel atau apakah data yang diamati bersifat kuantitatif atau kualitatif (non-parametrik), dan seluruh komputasi ditunda hingga evaluasi fungsi (lazy learner).
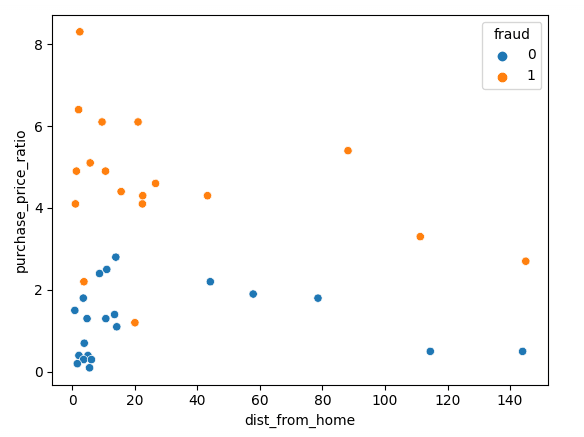
Sumber: Nearest Neighbors with Scikit-learn
Algoritme decision tree adalah algoritme non-parametrik populer yang juga mampu melakukan regresi dan klasifikasi. Popularitasnya banyak disebabkan oleh keterbacaan dan kesederhanaannya — karena ini salah satu algoritme yang paling mudah divisualisasikan dan ditafsirkan.
Secara konseptual, Anda dapat membayangkan decision tree mengalir dari akar ke daun. Jalur dari akar ke daun mendefinisikan aturan keputusan yang dibuat pada fitur.
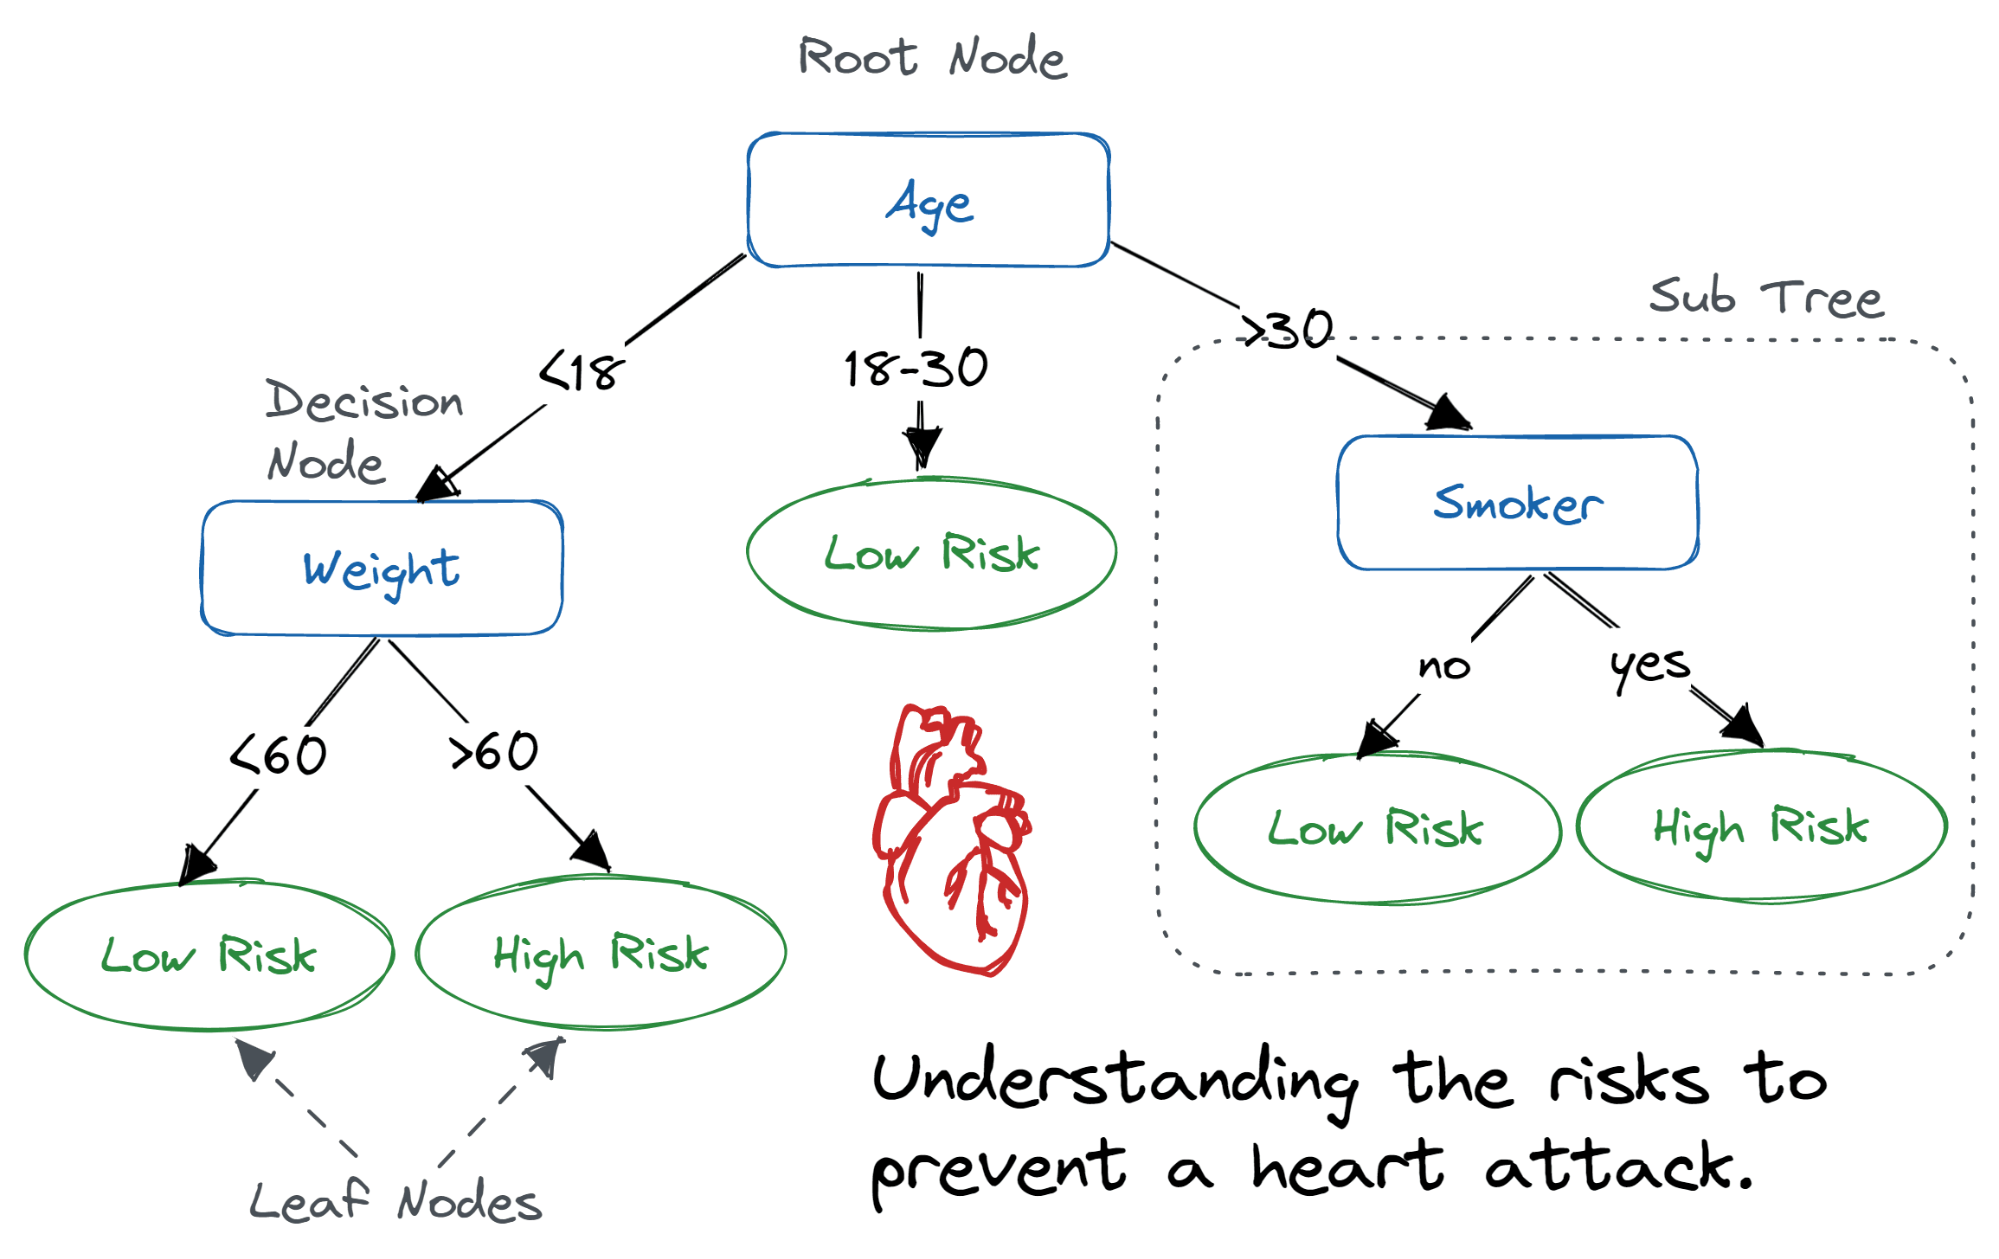
Sumber: Decision Tree Classification in Python Tutorial
Random forest adalah model ansambel yang terdiri dari dua atau lebih decision tree. Teknik ini memanfaatkan bootstrap aggregation dan metode random subspace untuk menumbuhkan pohon-pohon individual guna menghasilkan prediktor agregat yang kuat yang mampu melakukan klasifikasi dan regresi.
Perlu dicatat, bootstrap aggregation, atau bagging, hanyalah teknik untuk menghasilkan beberapa versi prediktor yang dapat dimanfaatkan untuk membangun prediktor agregat. Tujuannya adalah mengurangi korelasi antarprediktor agar model agregat lebih mampu melakukan generalisasi.
Kebaruan (randomness) diperkenalkan ke setiap prediktor dengan mengambil sampel instance secara acak dari set pelatihan dengan pengembalian (with replacement) dan menggunakan data bootstrap tersebut untuk pelatihan.
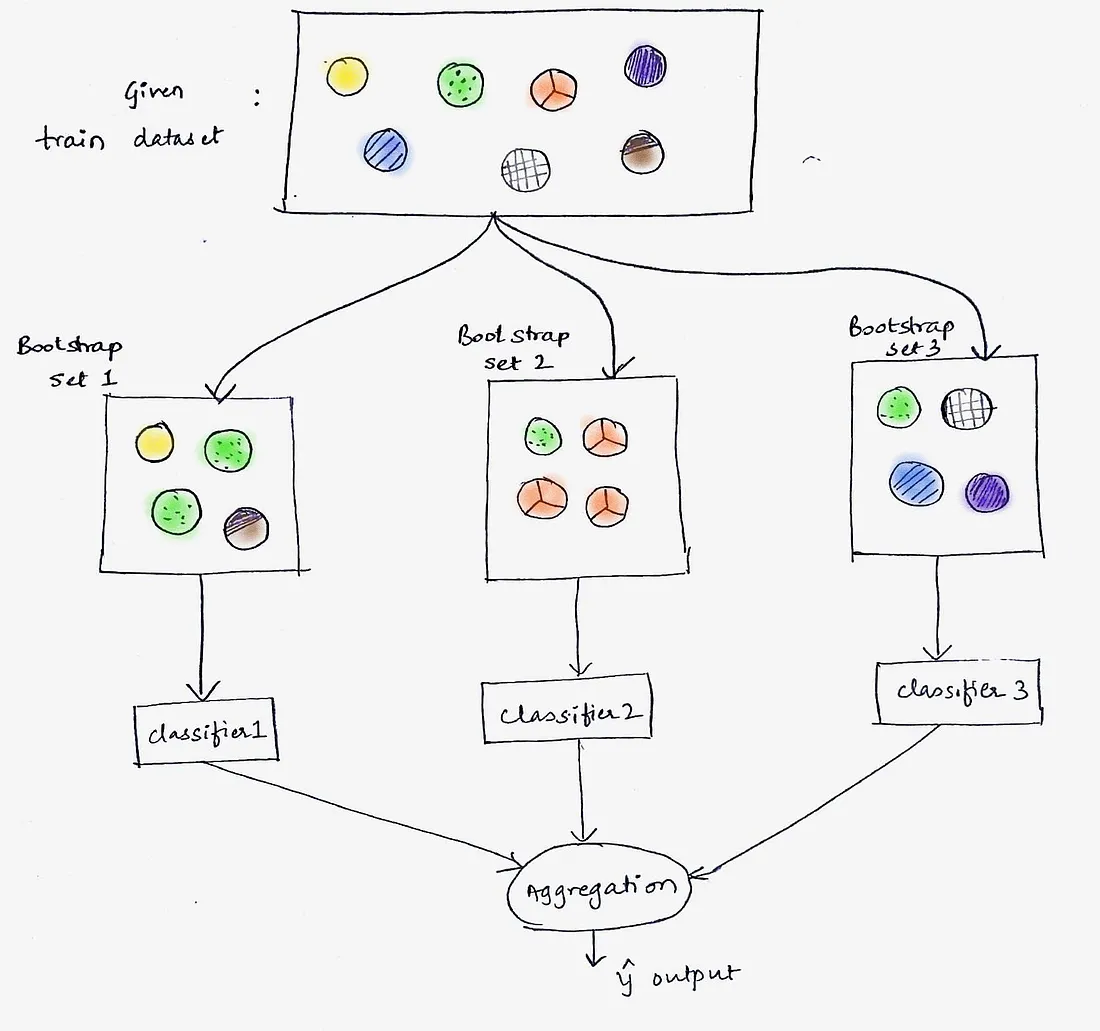
Sumber: Bagging: Machine Learning through visuals. #1: What is "Bagging" ensemble learning?
Metode random subspace juga digunakan untuk mengurangi korelasi antar prediktor dalam ansambel. Ini sering disebut sebagai "feature bagging" karena pendekatannya sama seperti bagging tetapi pada fitur. Artinya: metode random subspace mengurangi korelasi dengan membangun setiap prediktor dalam ansambel pada sampel acak fitur dengan pengembalian.
Klasifikator Naive Bayes adalah algoritme probabilistik berdasarkan teorema Bayes, yaitu aturan matematis untuk memperbarui probabilitas berdasarkan data baru.
Dalam konteks Naive Bayes, asumsi "naif" adalah bahwa semua fitur (atau variabel) dalam dataset saling independen saat memprediksi hasil. Ini merupakan penyederhanaan karena pada kenyataannya fitur bisa saling bergantung. Namun, meskipun ada asumsi naif ini, algoritme tersebut sering kali berkinerja sangat baik pada banyak tugas klasifikasi.
Jadi, teorema Bayes sendiri tidak membuat asumsi apa pun tentang independensi variabel. Klasifikator Naive Bayes-lah yang membuat asumsi ini demi kesederhanaan dan efisiensi komputasi.
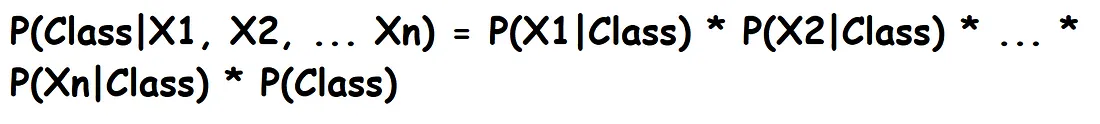
Untuk memahami klasterisasi, kita harus mulai dari definisi pembelajaran tanpa pengawasan (unsupervised learning). Unsupervised learning adalah pendekatan yang digunakan untuk menemukan struktur dasar data, hanya saja algoritme unsupervised learning tidak memerlukan pemetaan input ke output untuk mencapai hal tersebut.
Unsupervised learning biasanya dimanfaatkan untuk mengungkap pola yang ada dalam data sehingga instance dikelompokkan tanpa perlu label. Ia berasumsi bahwa instance yang berada dalam kelompok yang sama memiliki fitur serupa. Dengan demikian, klasterisasi adalah teknik unsupervised learning yang digunakan untuk mengelompokkan data tanpa label berdasarkan kesamaan atau perbedaannya.
Contoh penggunaan klasterisasi meliputi:
Berikut beberapa jenis algoritme klasterisasi:
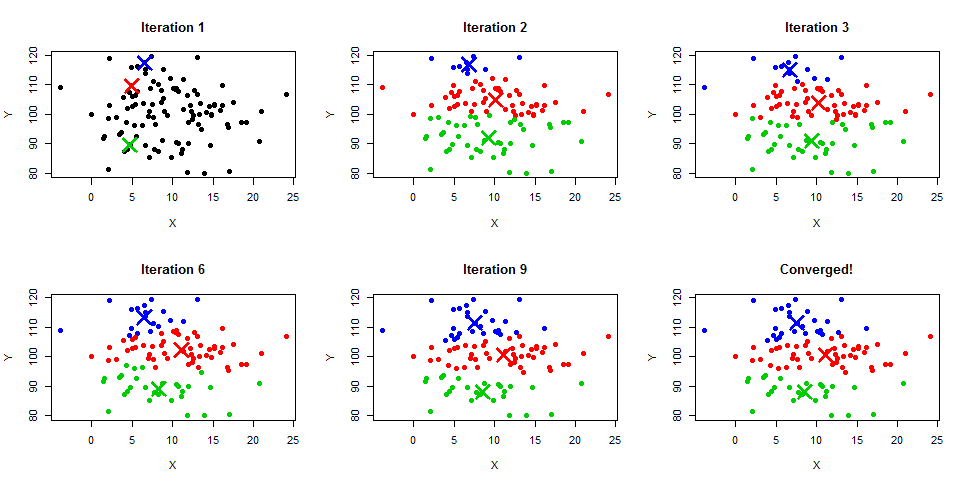
Salah satu algoritme yang paling populer dan paling banyak digunakan untuk tugas klasterisasi adalah k-means. Ini adalah algoritme berbasis centroid yang iteratif dan membuat klaster yang tidak tumpang tindih.
Cara lain untuk membentuk klaster adalah dengan membangun hierarki klaster, karenanya disebut "klasterisasi hierarkis." Ada dua cara untuk membangun hierarki klaster: .
Aglomeratif
Ini adalah pendekatan bottom-up di mana setiap observasi diperlakukan sebagai klaster tersendiri pada tahap awal. Saat hierarki dibangun dari bawah ke atas, setiap observasi digabungkan menjadi pasangan, dan pasangan digabungkan menjadi klaster.
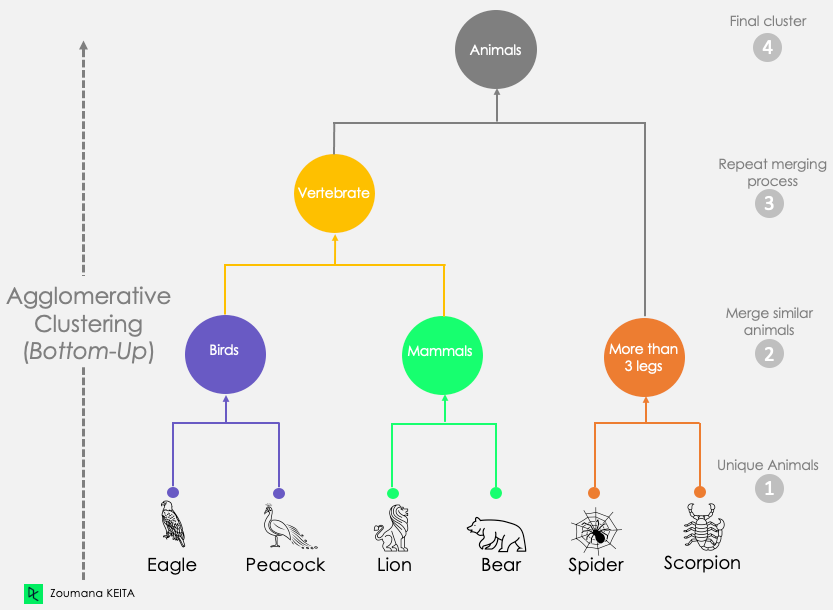
Sumber: An introduction to Hierarchical clustering in Python
Divisif
Klasterisasi divisif adalah pendekatan top-down di mana semua observasi dimulai dalam satu klaster, dan pemisahan dilakukan secara rekursif untuk membangun hierarki dari atas ke bawah.
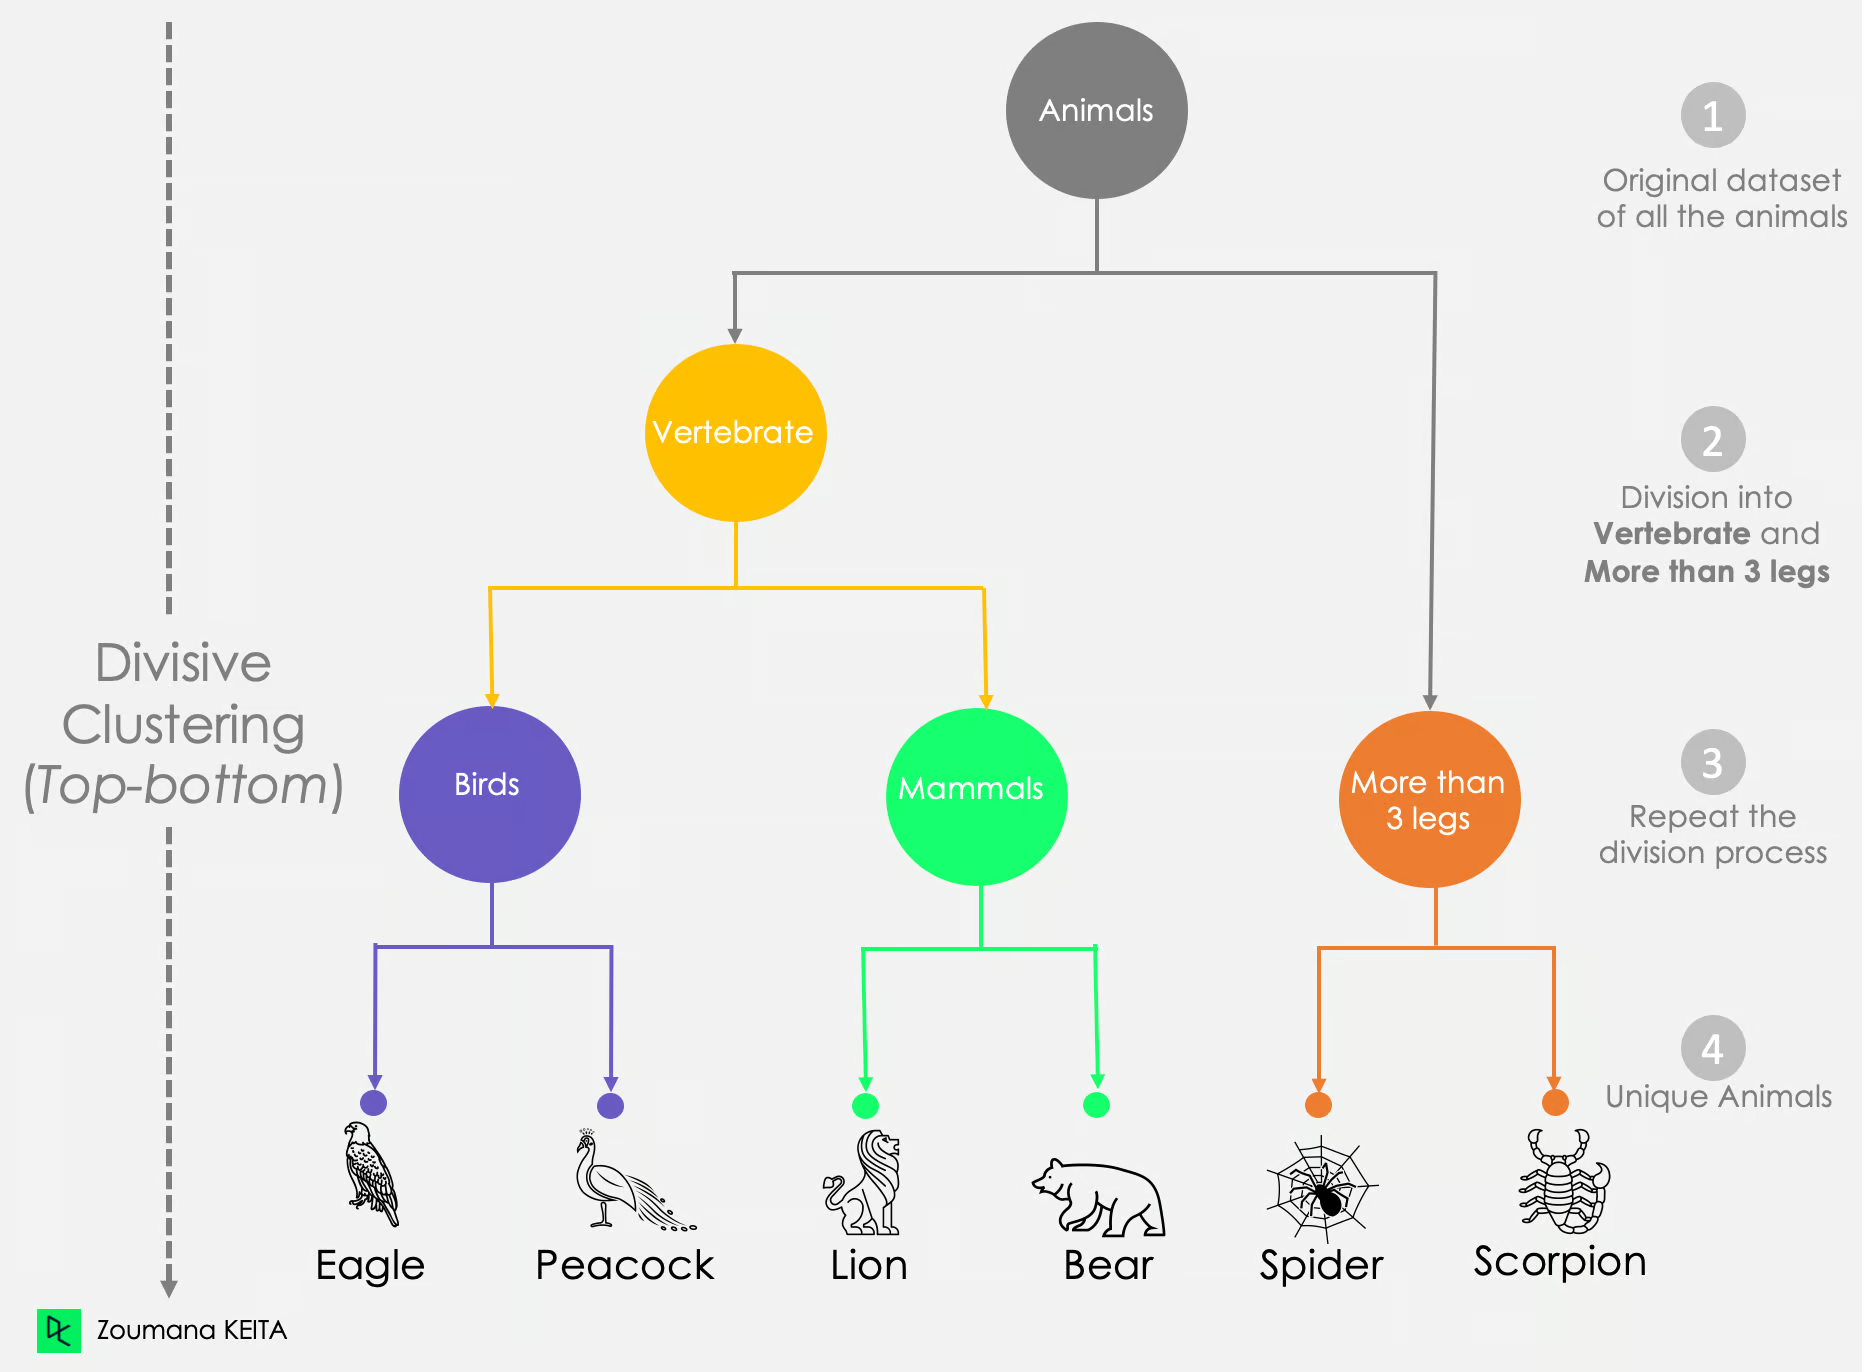
Sumber: An introduction to Hierarchical clustering in Python
Salah satu daya tarik besar dari Density-Based Spatial Clustering of Applications with Noise, atau disingkat DBSCAN, adalah ketahanannya terhadap outlier — ini juga merupakan algoritme klasterisasi berbasis densitas yang paling dikenal.
DBSCAN mengasumsikan klaster adalah wilayah padat dalam ruang yang dipisahkan oleh wilayah berdensitas lebih rendah. Berbeda dengan K-Means, DBSCAN menyimpulkan jumlah klaster berdasarkan data, dan dapat menemukan klaster dengan bentuk sewenang-wenang sehingga jumlah klaster tidak perlu diberikan sebagai parameter.
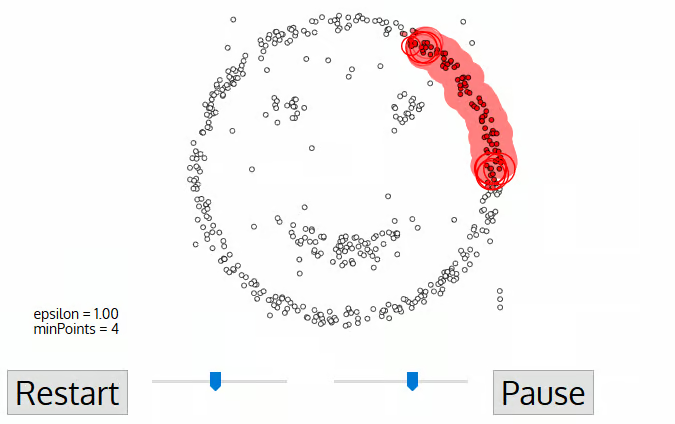
Akronim OPTICS adalah singkatan dari Ordering Points to Identify the Clustering Structure. Seperti DBSCAN, ini adalah algoritme berbasis densitas yang dikembangkan oleh kelompok riset yang sama. Namun, OPTICS berupaya mengatasi salah satu kelemahan utama DBSCAN — mengidentifikasi klaster dalam data dengan densitas yang bervariasi — dengan mengabaikan asumsi bahwa densitas data konsisten.
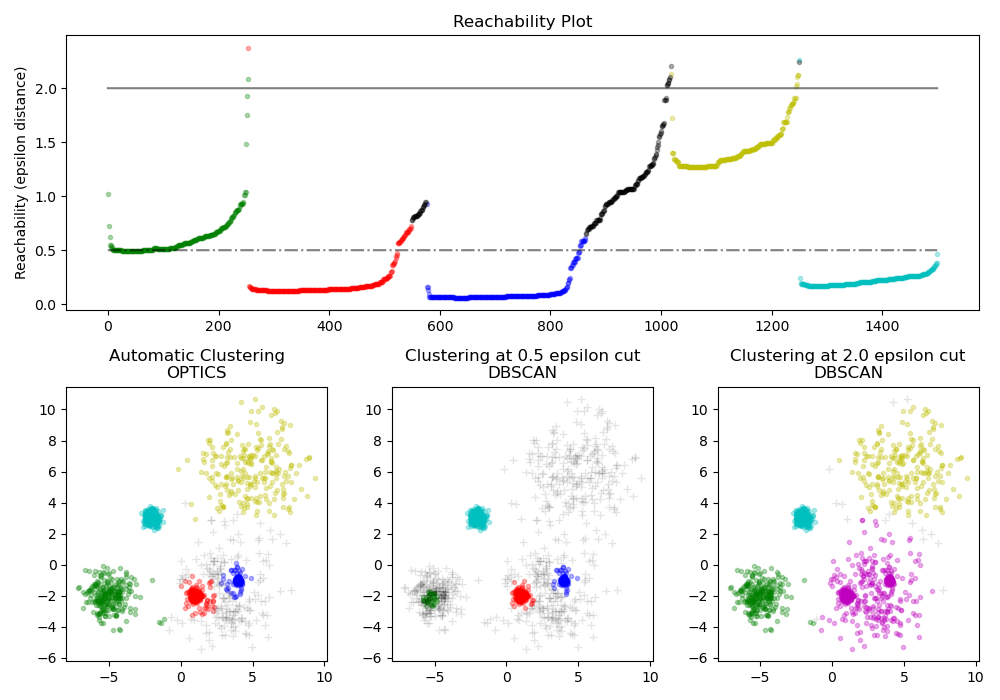
Sumber: Scikit-learn Demo of OPTICS clustering algorithm
Klasifikasi adalah bentuk pembelajaran terawasi. Masalah pembelajaran terawasi melibatkan pembelajaran sebuah fungsi yang memetakan masukan ke keluaran berdasarkan pasangan input-output. Sebaliknya, tugas pembelajaran tidak terawasi menggunakan metode, seperti klasterisasi, untuk menemukan pola tersembunyi dalam data tanpa label.
Baik tugas klasifikasi maupun klasterisasi memerlukan data pelatihan untuk mempelajari pola. Namun, praktik yang baik untuk tugas klasifikasi adalah memiliki data pengujian guna mengevaluasi kinerja prediksi model machine learning.
Algoritme klasterisasi bergantung pada data masukan untuk memodelkan struktur dasar data guna menemukan wawasan. Dengan kata lain, tidak ada "guru" yang memberi tahu algoritme jawaban yang benar — hanya apa yang dipelajari algoritme. Sebaliknya, algoritme klasifikasi memerlukan data input dan output untuk mempelajari fungsi pemetaan, sehingga dapat digunakan untuk memprediksi keluaran dari data input baru.
|
Klasifikasi |
Klasterisasi |
|
|
Terawasi |
Ya |
Tidak |
|
Berlabel |
Ya |
Tidak |
|
Tujuan |
Mendekati fungsi pemetaan (f) dari sekumpulan input (X) ke keluaran diskret (y) sehingga dapat digunakan untuk memprediksi keluaran dari input baru. |
Mempelajari pola dasar dalam input (X) untuk menyarankan kelompok tempat instance dapat dipisahkan. |
|
Algoritme |
Regresi logistik, K-nearest neighbors, Decision Tree, Random Forest, Naive Bayes |
K-means, klasterisasi aglomeratif, klasterisasi divisif, DBSCAN, OPTICS |
|
Kasus penggunaan |
Churn pelanggan, persetujuan pinjaman, pemfilteran spam, pengenalan wajah |
Segmentasi pasar, segmentasi citra, analisis jejaring sosial, mesin rekomendasi. |
Meskipun klasifikasi dan klasterisasi sama-sama bertujuan memisahkan instance ke dalam kelompok diskret, pendekatannya sangat berbeda. Klasifikasi bergantung pada label yang telah ditentukan dan seorang supervisor untuk memandu proses pembelajaran, sehingga ideal untuk tugas seperti prediksi churn pelanggan atau pemfilteran spam. Di sisi lain, klasterisasi beroperasi tanpa supervisor dan lebih bersifat eksploratif, dengan penerapan pada segmentasi pasar atau sistem rekomendasi. Memahami nuansa ini dapat sangat memengaruhi efektivitas proyek machine learning Anda.
Ingin menyelami lebih dalam? Lihat kursus DataCamp berikut untuk meningkatkan pemahaman dan keterampilan Anda:
Telusuri Lebih Dalam Pengantar Klasifikasi & Klasterisasi
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



