
Curso
Análisis de clústeres en Python
4 h
65.8K
En machine learning, hay dos técnicas para separar objetos en grupos distintos: la clasificación y el clustering. Esto suele generar bastante confusión entre quienes empiezan.
A simple vista, clasificación y clustering parecen similares. Ambas usan algoritmos que aprovechan las características de un conjunto de datos para descubrir patrones y separar instancias en grupos. Pero, en la práctica, son bastante diferentes.
En este artículo veremos cada técnica, los distintos algoritmos asociados, sus aplicaciones y, sobre todo, en qué se diferencian.
Las tareas de clasificación pertenecen a una categoría de problemas llamada «aprendizaje supervisado». Estos problemas implican desarrollar modelos que aprenden de datos históricos para hacer predicciones sobre nuevos casos.
De forma más formal, las tareas de aprendizaje supervisado buscan aprender una función que mapee una entrada a una salida a partir de pares de ejemplo entrada-salida. El objetivo es aproximar la función de mapeo (f) desde las entradas (X) a la salida (y); si vienes del mundo de las matemáticas, esto te sonará al problema de la aproximación de funciones.
Es importante señalar que el aprendizaje supervisado tiene dos formas: regresión y clasificación.
En problemas de clasificación, el objetivo del algoritmo es aproximar la función de mapeo desde un conjunto de características para predecir una salida discreta (por ejemplo, predecir si una imagen es de un gato o un perro). Échale un vistazo a nuestro tutorial Understanding text classification in Python para una demostración práctica.
Hay muchos problemas donde se aplican algoritmos de clasificación, como:
Veamos algunos algoritmos de clasificación.
A menudo, y con razón, se confunde la regresión logística con un algoritmo de regresión. Técnicamente no es incorrecto. La regresión logística no realiza clasificación estadística; lo que hace es estimar los parámetros de un modelo logístico.
Podemos usar la regresión logística para clasificar gracias a una frontera de decisión que separa las clases. En su forma más simple, la regresión logística usa una función logística para modelar variables dependientes binarias.
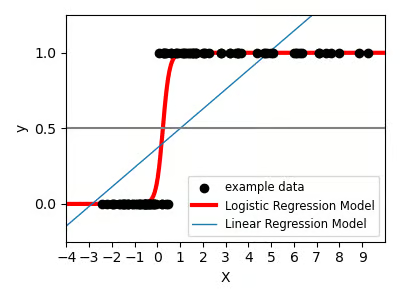
Fuente: Logistic Function by Scikit-Learn
KNN es uno de los algoritmos de machine learning más sencillos y, a diferencia de la regresión logística, puede usarse tanto para clasificación como para regresión.
Es un algoritmo no paramétrico y de aprendizaje perezoso. Esto significa que KNN no hace suposiciones sobre las características de la muestra ni sobre si los datos son cuantitativos o cualitativos (no paramétrico), y que difiere el cómputo hasta la evaluación de la función (aprendizaje perezoso).
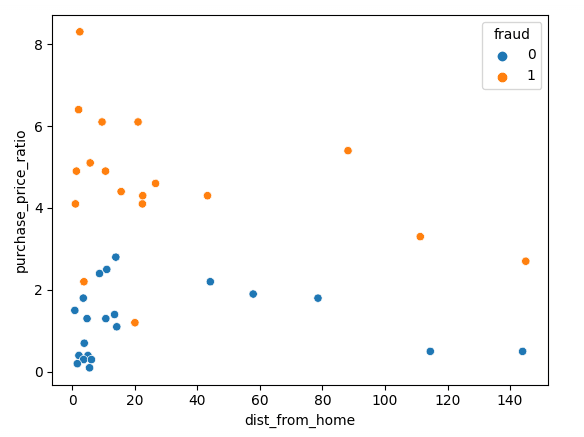
Fuente: Nearest Neighbors with Scikit-learn
El algoritmo de árbol de decisión es un popular algoritmo no paramétrico que también puede realizar regresión y clasificación. Su popularidad se debe a su interpretabilidad y sencillez: es de los más fáciles de visualizar e interpretar.
Conceptualmente, puedes imaginar un árbol de decisión como un flujo que va de la raíz a las hojas. El camino desde la raíz hasta una hoja define una regla de decisión basada en las características.
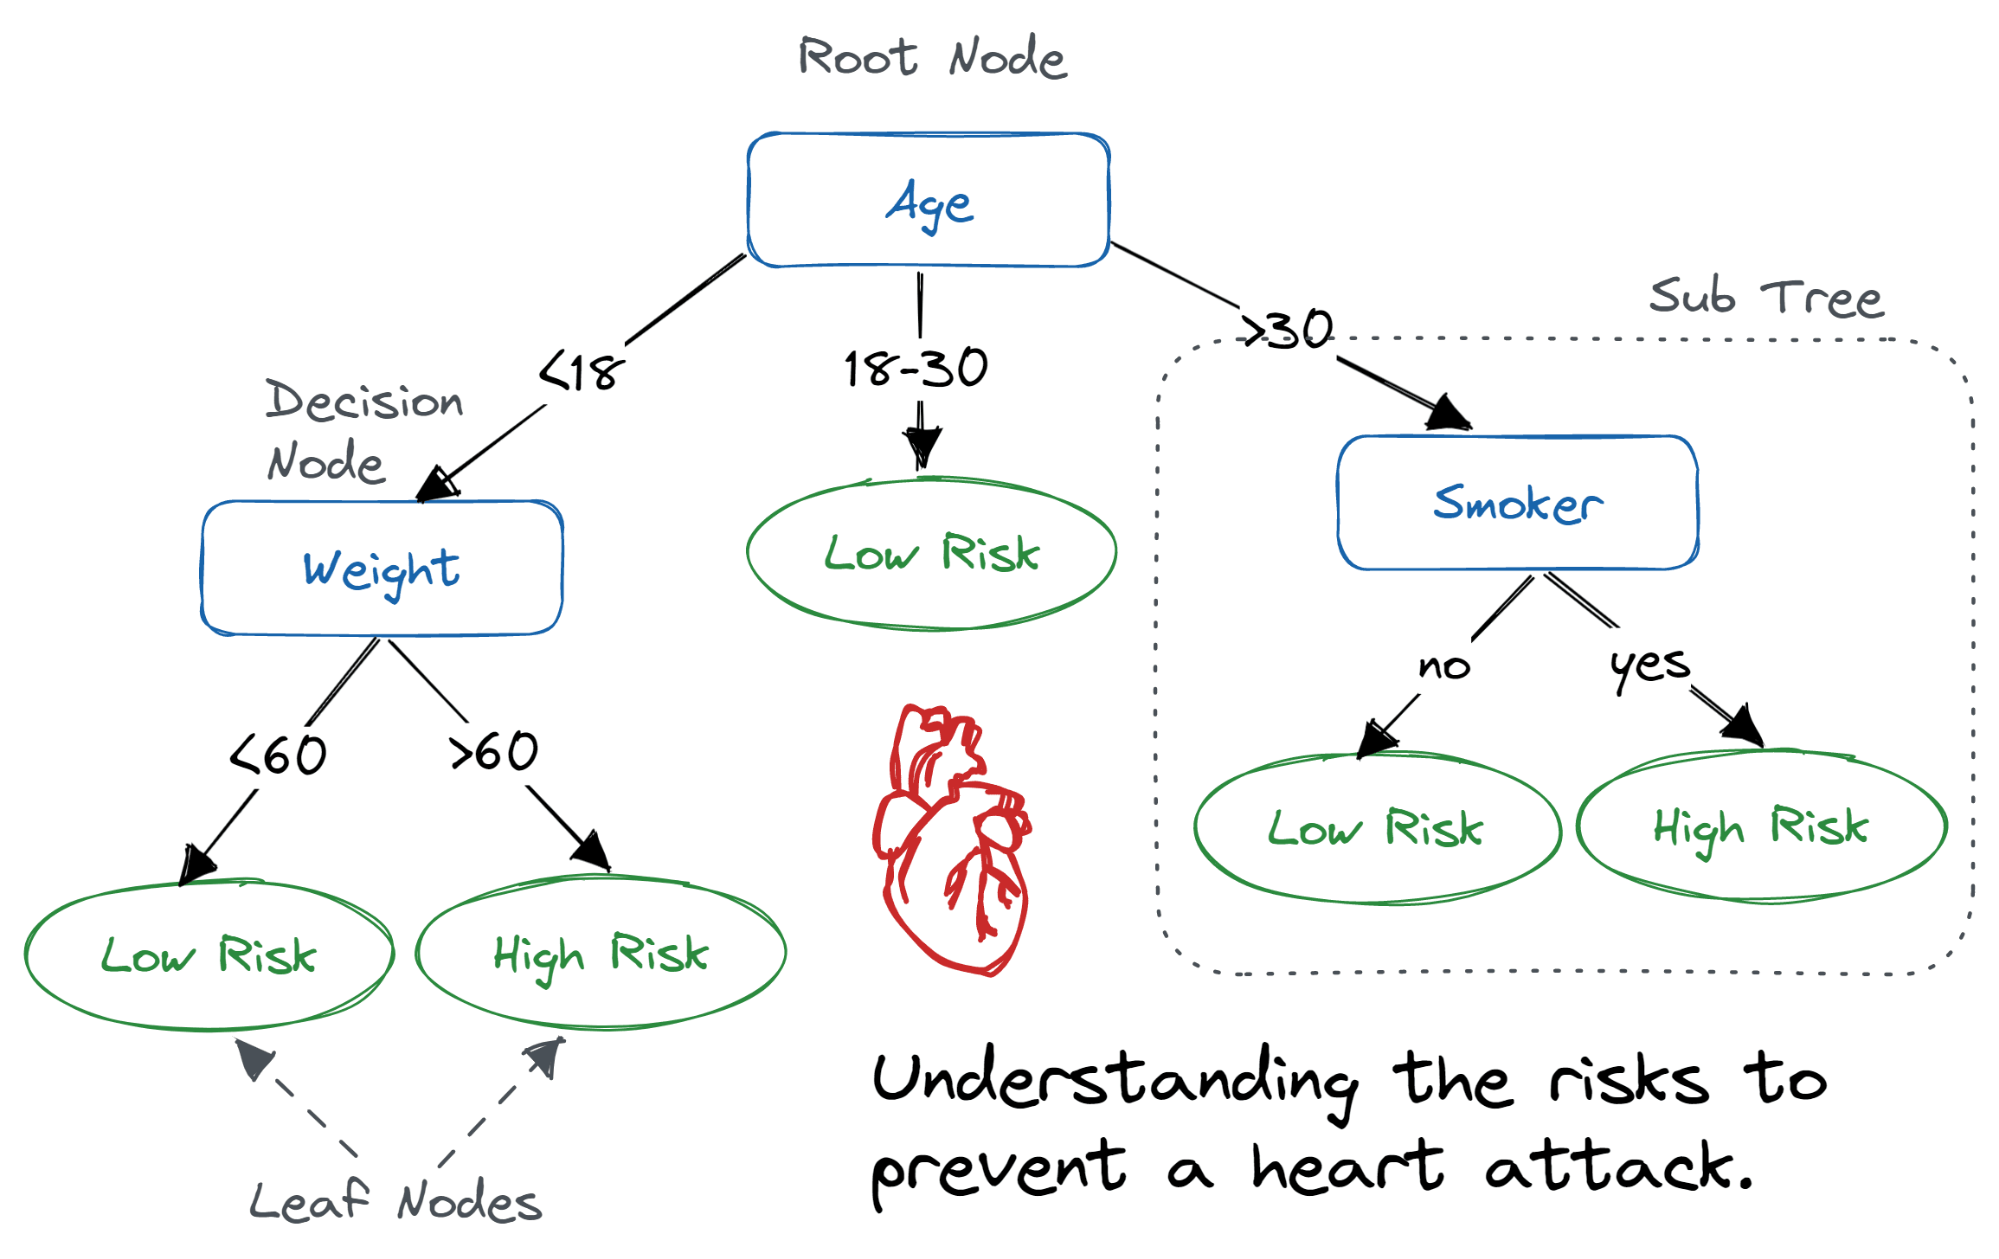
Fuente: Decision Tree Classification in Python Tutorial
El random forest es un modelo por conjuntos formado por dos o más árboles de decisión. Emplea bootstrap aggregation y el método de subespacios aleatorios para hacer crecer árboles individuales y obtener un predictor agregado potente, capaz de clasificación y regresión.
El bootstrap aggregation, o bagging, es una técnica para generar múltiples versiones de un predictor que se combinan en un predictor agregado. El objetivo es reducir la correlación entre predictores para que el modelo agregado generalice mejor.
Se introduce aleatoriedad en cada predictor muestreando instancias del conjunto de entrenamiento con reemplazo y usando esos datos bootstrap para el entrenamiento.
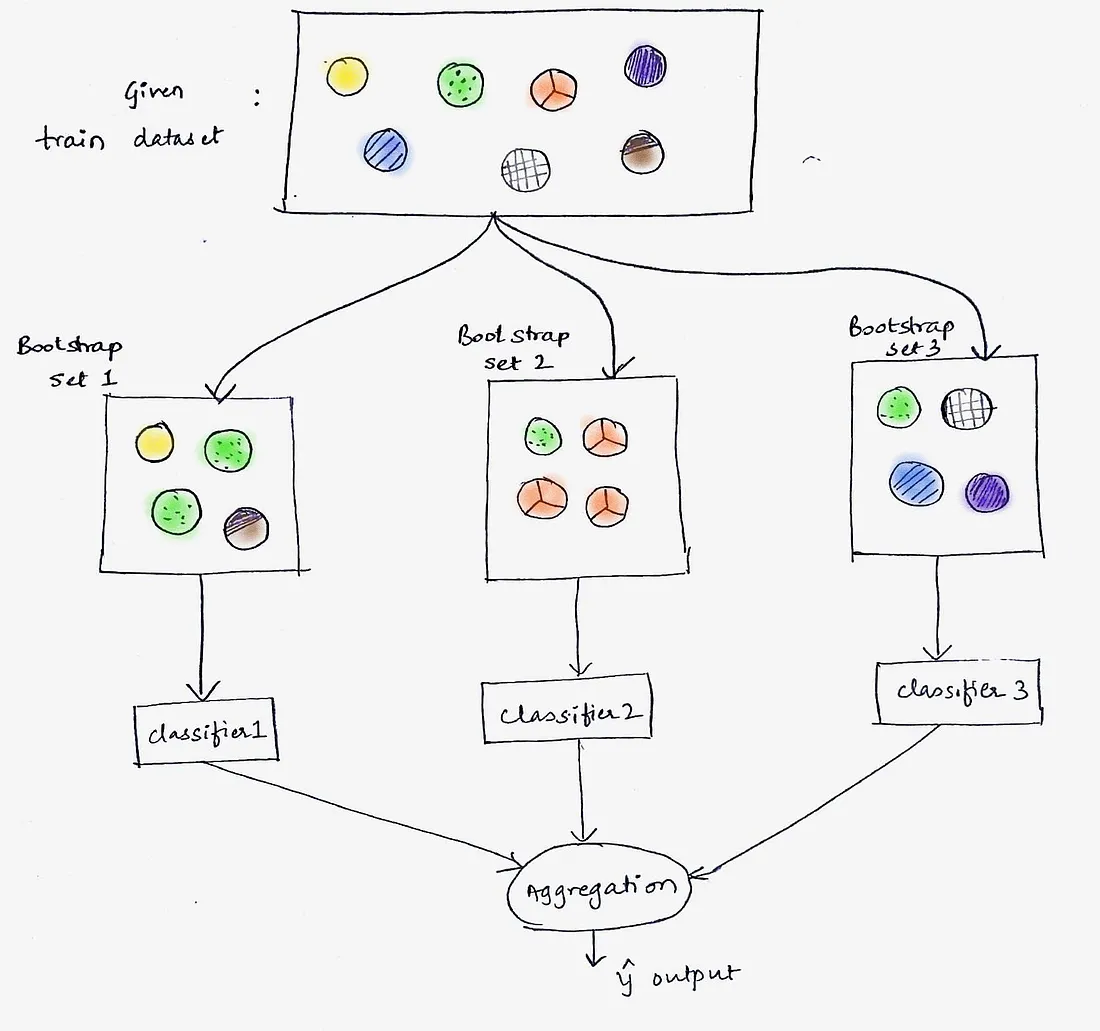
Fuente: Bagging: Machine Learning through visuals. #1: What is “Bagging” ensemble learning?
El método de subespacios aleatorios también se usa para reducir la correlación entre los predictores del conjunto. A menudo se le llama «bagging de características» porque adopta el mismo enfoque que el bagging, pero con las variables. Es decir, construye cada predictor del conjunto sobre una muestra aleatoria de las características con reemplazo.
El clasificador Naive Bayes es un algoritmo probabilístico basado en el teorema de Bayes, una regla matemática para actualizar probabilidades con nuevos datos.
En Naive Bayes, la suposición «ingenua» es que todas las características (o variables) del conjunto de datos son independientes entre sí al predecir el resultado. Es una simplificación porque, en la realidad, las características pueden depender unas de otras. Aun así, este algoritmo suele rendir sorprendentemente bien en muchas tareas de clasificación.
El teorema de Bayes en sí no asume independencia entre variables. Es el clasificador Naive Bayes el que hace esta suposición por simplicidad y eficiencia computacional.
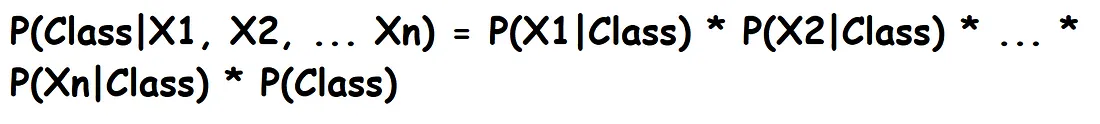
Para entender el clustering, empecemos por la definición de aprendizaje no supervisado. El aprendizaje no supervisado se usa para descubrir la estructura subyacente de los datos, pero sin requerir mapeos de entrada a salida para lograrlo.
Suele emplearse para destapar patrones existentes en los datos de modo que las instancias se agrupen sin necesidad de etiquetas. Asume que las instancias dentro de un mismo grupo comparten rasgos similares. Así, el clustering es una técnica no supervisada para agrupar datos sin etiquetar según sus similitudes o diferencias.
Algunos casos de uso de clustering:
Estos son algunos algoritmos de clustering:
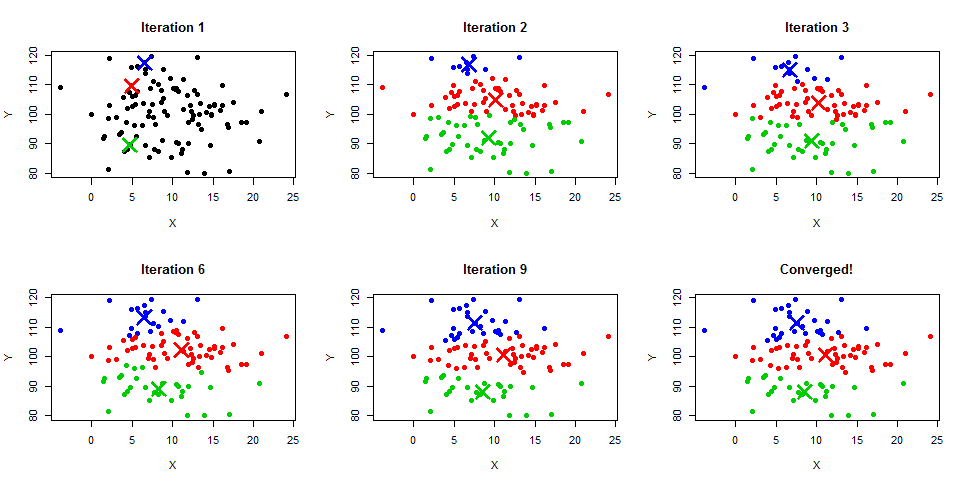
Uno de los algoritmos más populares y utilizados para tareas de clustering es k-means. Es un algoritmo basado en centroides e iterativo que crea clústeres no solapados.
Otra forma de construir clústeres es creando una jerarquía de clústeres, de ahí su nombre, «clustering jerárquico». Hay dos maneras de construir una jerarquía de clústeres:
Aglomerativo
Es un enfoque ascendente donde cada observación se trata como su propio clúster al inicio. A medida que se construye la jerarquía desde abajo, las observaciones se van uniendo por pares y los pares se fusionan en clústeres.
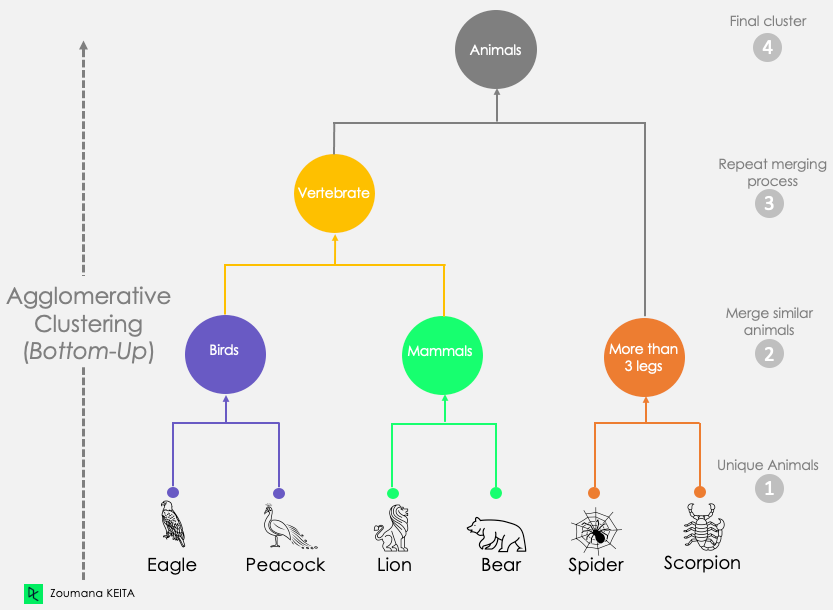
Fuente: An introduction to Hierarchical clustering in Python
Divisivo
El clustering divisivo es un enfoque descendente: todas las observaciones comienzan en un único clúster y se van dividiendo de forma recursiva para construir la jerarquía de arriba abajo.
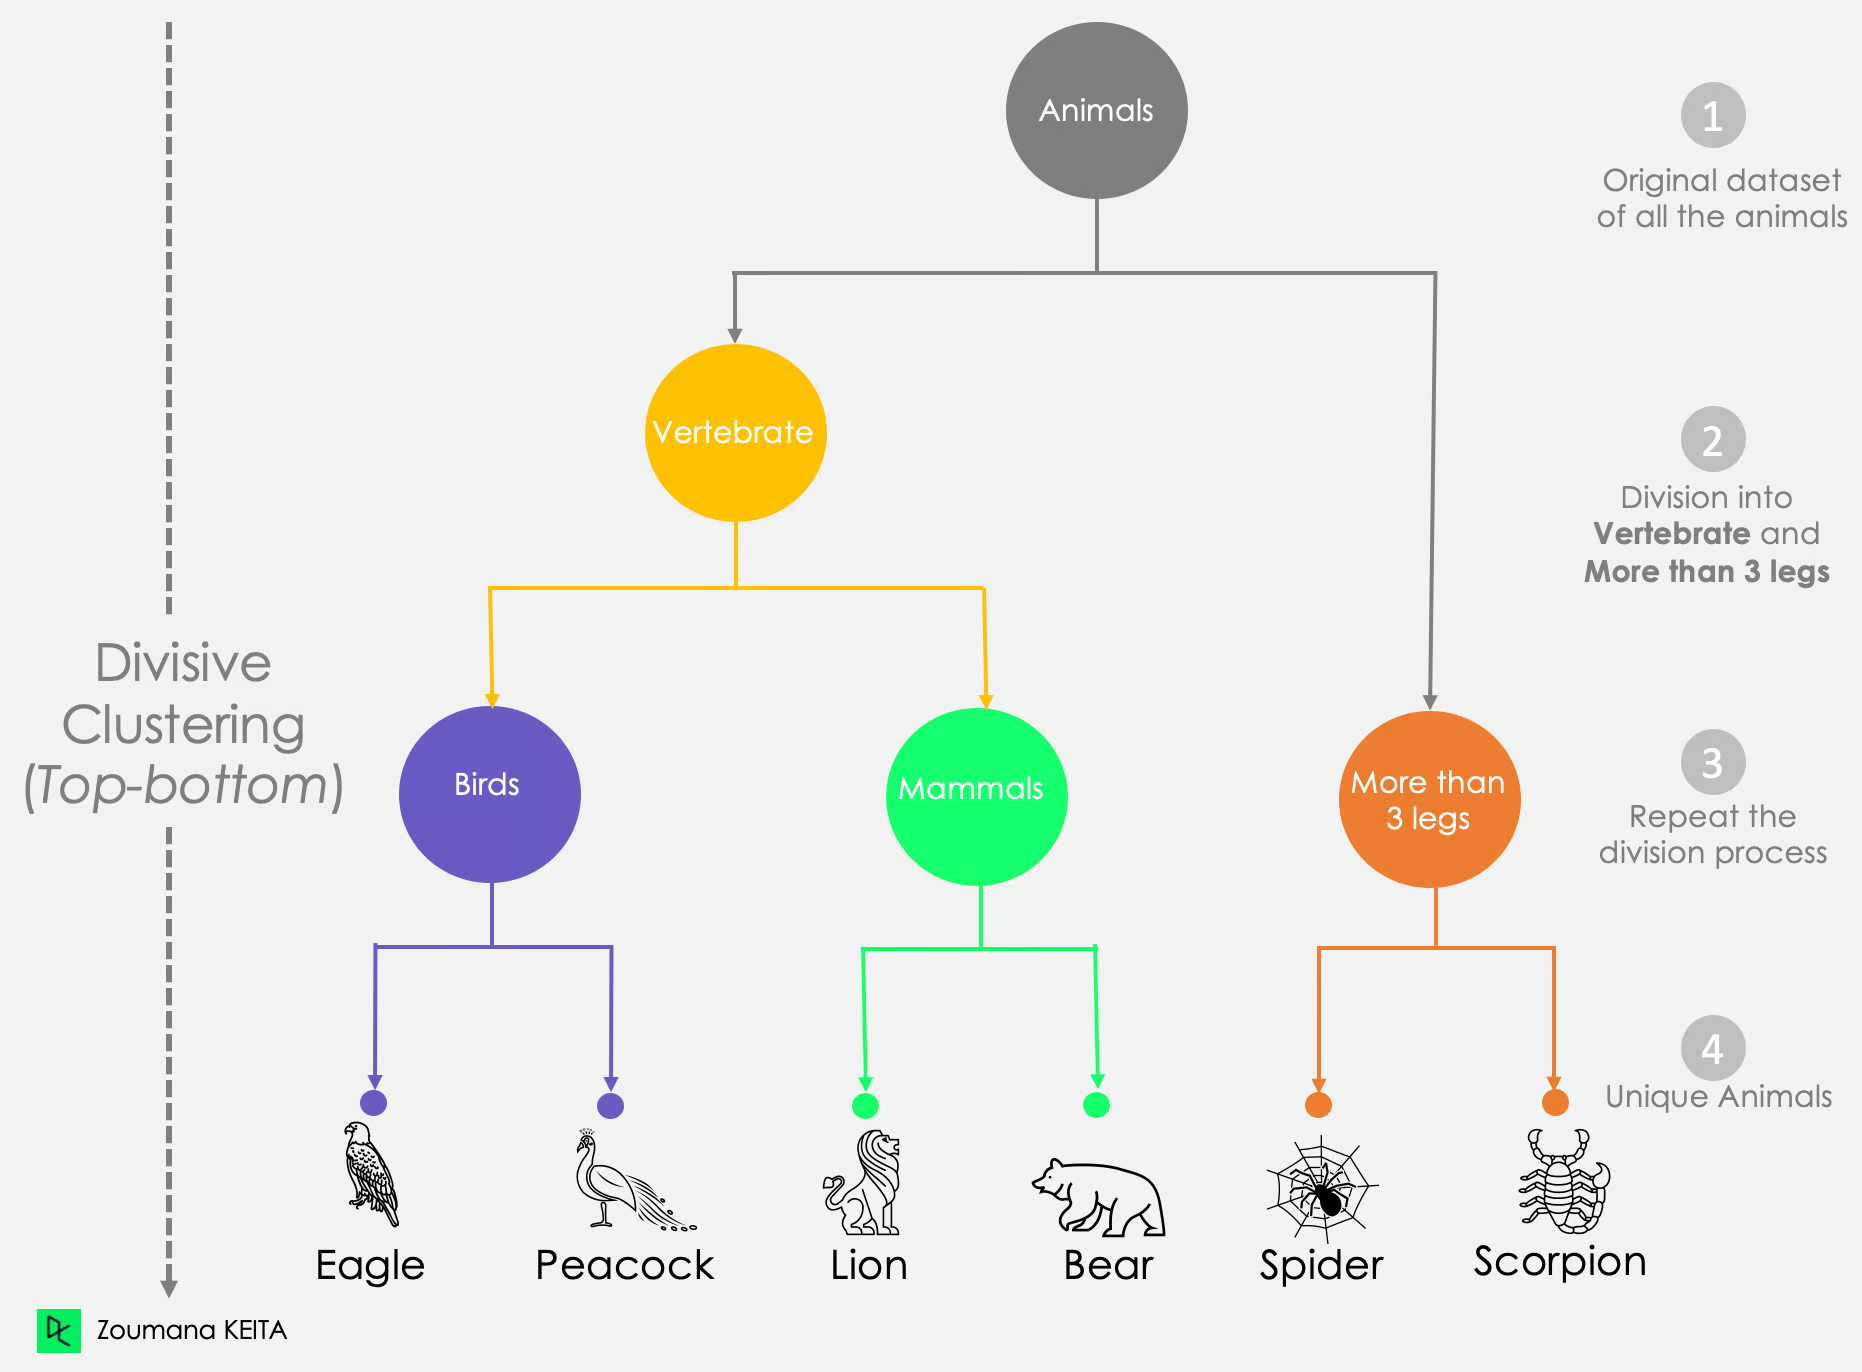
Fuente: An introduction to Hierarchical clustering in Python
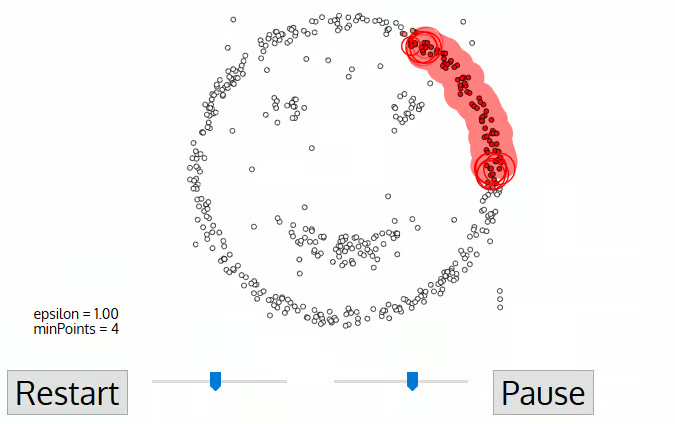
Uno de los grandes atractivos de Density-Based Spatial Clustering of Applications with Noise, o DBSCAN, es su robustez ante valores atípicos; también es el algoritmo de clustering basado en densidad más conocido.
DBSCAN asume que los clústeres son regiones densas en el espacio separadas por zonas de menor densidad. A diferencia de K-Means, DBSCAN infiere el número de clústeres a partir de los datos y puede descubrir clústeres de forma arbitraria, por lo que no es necesario pasar el número de clústeres como parámetro.
OPTICS significa Ordering Points to Identify the Clustering Structure. Al igual que DBSCAN, es un algoritmo basado en densidad desarrollado por el mismo grupo de investigación. Sin embargo, OPTICS busca superar una de las grandes limitaciones de DBSCAN —identificar clústeres en datos con densidades variables— al desechar la suposición de densidad consistente.
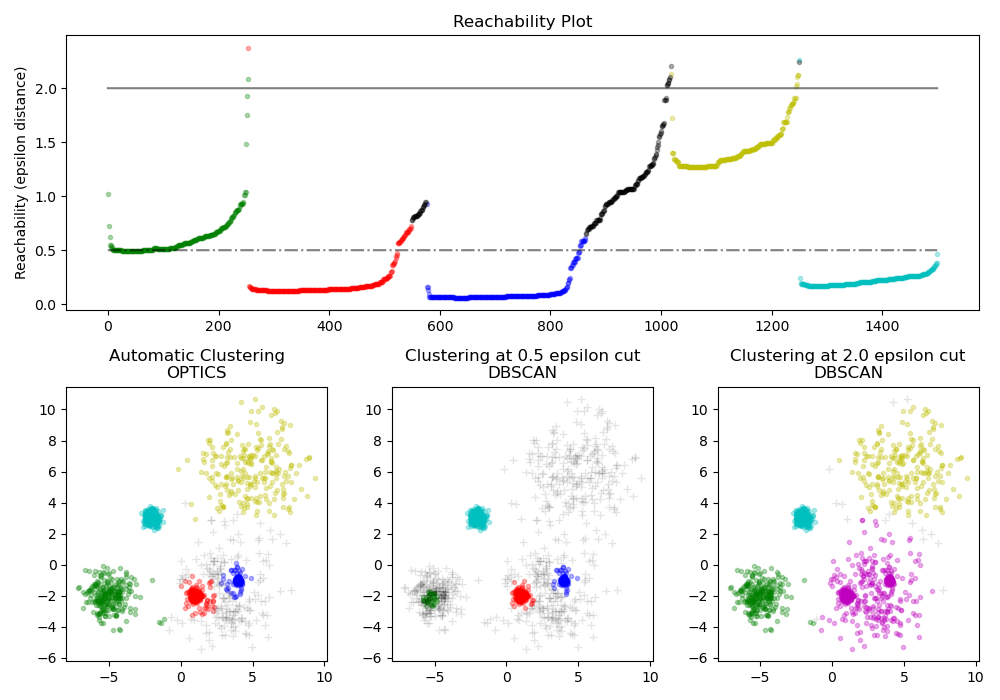
Fuente: Scikit-learn Demo of OPTICS clustering algorithm
La clasificación es una forma de aprendizaje supervisado. Los problemas supervisados buscan aprender una función que mapee una entrada a una salida a partir de pares entrada-salida. En cambio, las tareas no supervisadas emplean métodos, como el clustering, para descubrir patrones ocultos en datos sin etiquetar.
Tanto la clasificación como el clustering requieren datos de entrenamiento para aprender patrones. Sin embargo, es buena práctica disponer de datos de prueba en clasificación para evaluar el rendimiento de las predicciones del modelo.
Los algoritmos de clustering dependen de los datos de entrada para modelar la estructura subyacente y extraer información. Es decir, no hay un «profesor» que indique las respuestas correctas: el algoritmo aprende por sí mismo. En cambio, los algoritmos de clasificación requieren datos de entrada y salida para aprender la función de mapeo y poder predecir la salida de nuevas entradas.
|
Clasificación |
Clustering |
|
|
Supervisado |
Sí |
No |
|
Etiquetado |
Sí |
No |
|
Propósito |
Aproximar la función de mapeo (f) desde un conjunto de entradas (X) a una salida discreta (y) para poder predecir la salida de nuevas entradas. |
Aprender los patrones subyacentes en las entradas (X) para sugerir los grupos en los que pueden separarse las instancias. |
|
Algoritmos |
Regresión logística, K-nearest neighbors, árbol de decisión, random forest, Naive Bayes |
K-means, clustering aglomerativo, clustering divisivo, DBSCAN, OPTICS |
|
Casos de uso |
Churn de clientes, aprobación de préstamos, filtrado de spam, reconocimiento facial |
Segmentación de mercado, segmentación de imágenes, análisis de redes sociales, motores de recomendación |
Aunque tanto la clasificación como el clustering buscan separar instancias en grupos, sus enfoques son distintos. La clasificación se apoya en etiquetas predefinidas y en un supervisor que guía el aprendizaje, lo que la hace ideal para tareas como predecir el churn o filtrar spam. El clustering, en cambio, opera sin supervisor y es más exploratorio, con aplicaciones en segmentación de mercado o sistemas de recomendación. Entender estas diferencias puede marcar la diferencia en la eficacia de tu proyecto de machine learning.
¿Quieres profundizar? Echa un vistazo a estos cursos de DataCamp para mejorar tu comprensión y habilidades:
Profundiza: introducción a clasificación y clustering
Curso
Curso
Curso
blog
Zoumana Keita
14 min
blog
Moez Ali
8 min
blog
Matt Crabtree
14 min
blog
Natassha Selvaraj
15 min
blog
Arun Nanda
15 min
Tutorial
Eugenia Anello
8 min





